Google이 이번에 문서로 못 박은 규칙
2026년 10월 26일, Google은 사용자 생성 스팸 방지 가이드에 두 문단짜리 섹션을 추가했습니다. 페이지 전체에서 가장 짧은 부분이지만, 아마 가장 많은 제품 로드맵을 바꿀 부분입니다. 대부분의 팀이 슬라이드에 올린 적 없는 질문을 던지기 때문입니다. 이 URL이 애초에 Google 색인에 들어가야 하는가?
섹션 제목은 "Only index content meant for Search(검색을 위해 만들어진 콘텐츠만 색인하라)"입니다. 전문은 다음과 같습니다.
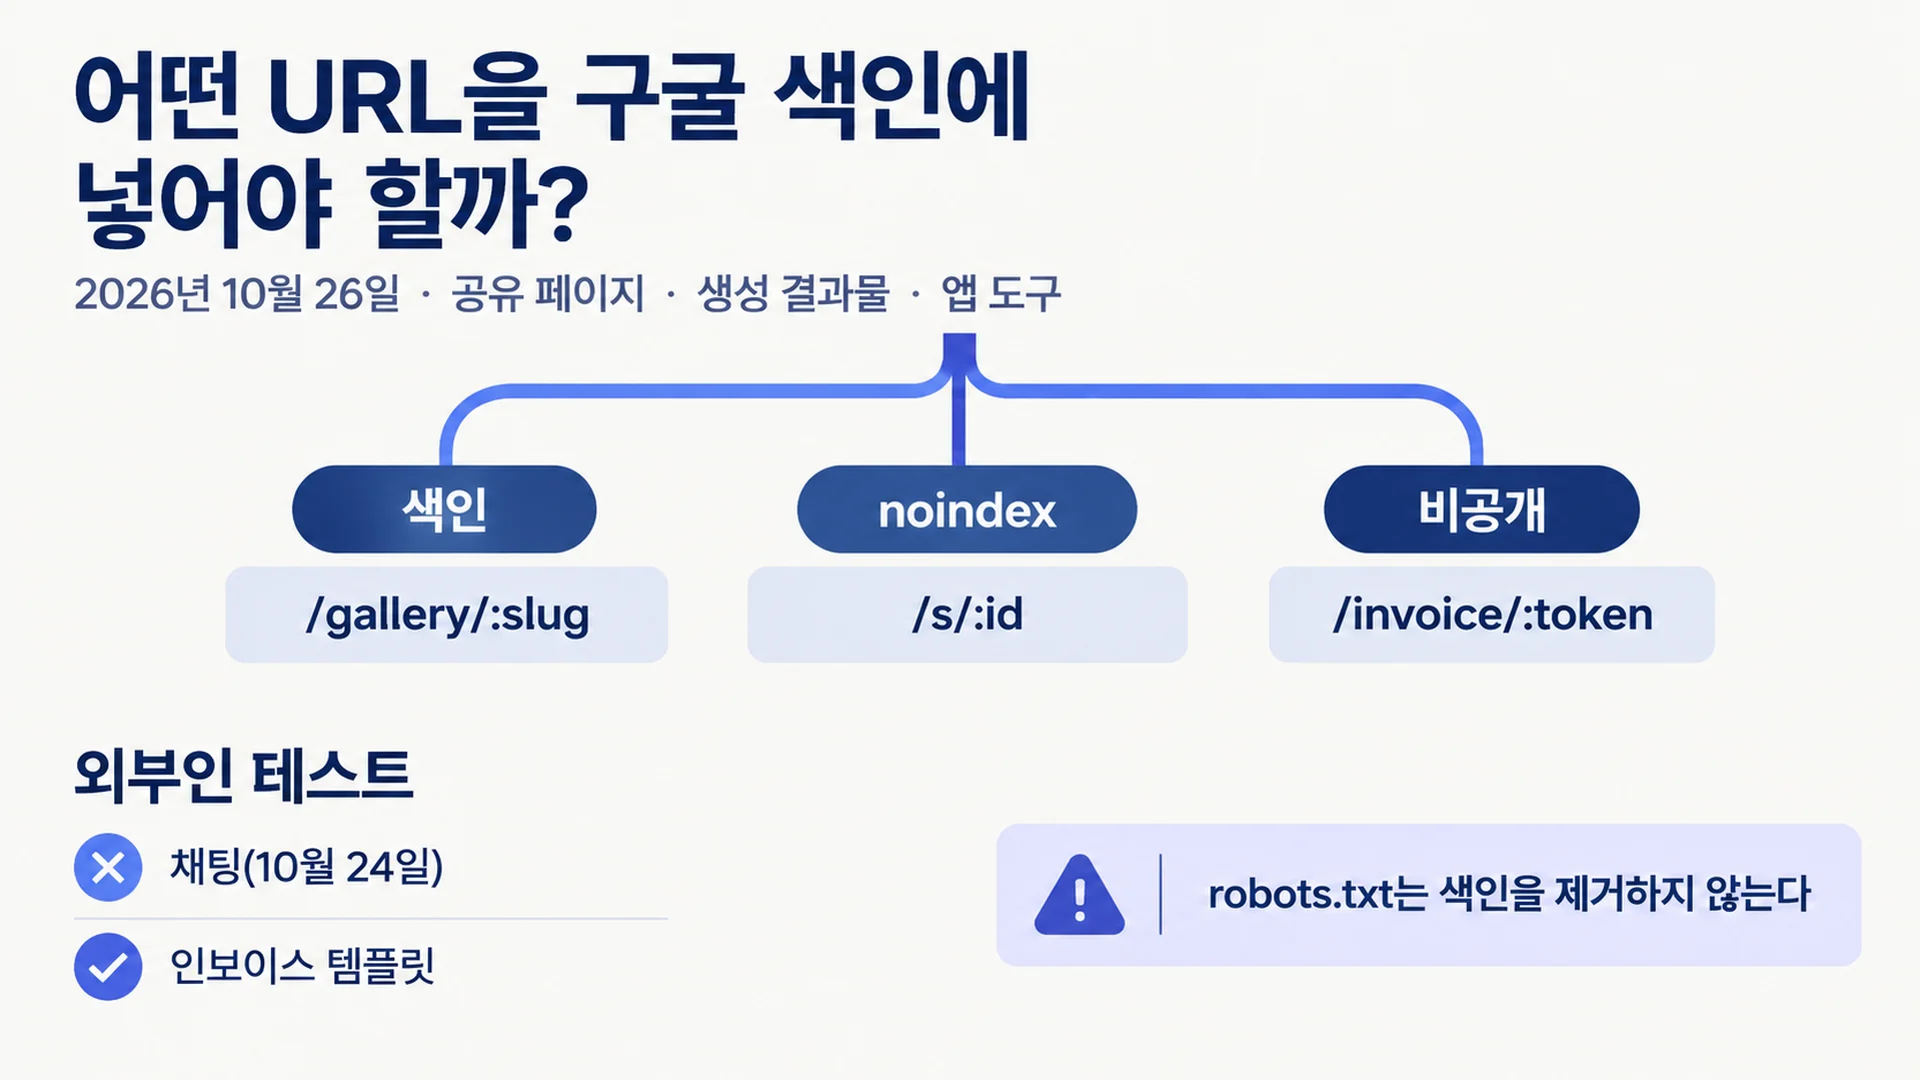
서비스가 사용자가 공유 가능한 페이지, 생성된 결과물, 대화형 도구를 만들도록 허용한다면, 그 콘텐츠가 검색엔진을 통해 발견되도록 의도된 것인지, 아니면 링크를 가진 사람이 직접 접근하는 것인지 검토하세요.
페이지가 공개 검색에서의 발견이 아니라 직접 공유, 협업, 실용적 사용을 위해 만들어진 경우에는 robots 메타 태그나 X-Robots-Tag HTTP 응답 헤더를 사용해 noindex 규칙을 적용하거나, robots.txt에서 기본적으로 크롤링을 차단하세요.
같은 날 올라온 Google의 변경 이력은 의도를 더 직접적으로 밝힙니다. 가이드가 "링크로 공유된 콘텐츠의 색인 차단과 Search Console에서의 남용 모니터링에 관한 지침"으로 업데이트되었다는 것입니다. 이를 통해 플랫폼이 "검색을 위한 것이 아닌 사용자 생성 페이지를 색인에서 제외하고 스팸을 더 일찍 탐지"할 수 있게 한다고 설명합니다.
그게 전부입니다. 새로운 수동 조치 공지도, 순위 시스템 발표도, 처벌 목록도 없습니다. 권고된 것은 '기본값'이고, 색인 사고의 대부분은 기본값에서 나옵니다.
대상 독자. 사용자가 생성할 수 있는 URL을 출시하는 모든 팀입니다. 공유 링크, 저장된 채팅, 공개 대시보드, 템플릿 미리보기, 앱 빌드, 생성 리포트, 포럼 스레드, 프로필 페이지, 리뷰 페이지, 목록 페이지가 여기에 해당합니다.
끝났을 때 손에 남는 것. 생성 URL 유형별 라우트 단위 판정, 실제로 색인에서 제거하는 제어, 그리고 Google이 설명한 남용 패턴을 잡아내는 모니터링 규칙입니다.
소요 시간. 제품 하나를 처음 훑는 데 45~90분. URL 생성 기능이 여러 개인데 라우트 목록이 없다면 하루.
완료의 정의. 모든 생성 라우트가 index, noindex, private 중 하나로 분류되어 있습니다. noindex 라우트는 JavaScript 실행 이후가 아니라 서버 사이드에서 지시자를 반환합니다. Search Console에서 해당 URL이 "robots.txt에 의해 차단되었지만 색인이 생성됨"이 아니라 "noindex 태그에 의해 제외됨"으로 표시됩니다.
무엇이 바뀌었고, 무엇이 그저 새로워 보일 뿐인가
중요한 편집은 네 가지입니다. 페이지의 나머지는 그대로이고, 2025년 12월의 조언도 여전히 유효합니다.
Google이 바꾼 것 | 실제 문구 | 왜 중요한가 |
|---|---|---|
가이드의 적용 범위 | "공유 페이지, 생성 콘텐츠, 웹 앱을 사용자가 게시할 수 있게 하는 호스팅 플랫폼과 도구"가 명시됨 | 문자 그대로 읽으면 포럼과 댓글만이 아니라 AI 채팅 내보내기, 아티팩트 페이지, 앱 빌더, 노코드 도구까지 포함됩니다 |
남용의 단위 | 스패머가 "대량의 페이지 또는 사이트"를 만들 수 있음 | Google이 말하는 것은 교묘함이 아니라 물량입니다. 악성 계정 하나가 수천 개의 URL을 찍어낼 수 있습니다 |
새 섹션 | "Only index content meant for Search" | 링크 전용 콘텐츠에서 noindex가 합리적인 기본값이라는 가장 분명한 선언 |
모니터링 | Search Console에서 사이트 또는 하위 도메인을 확인하고 페이지 색인 생성과 검색 실적의 급증을 관찰. "소수의 사용자"가 "색인 가능한 URL의 상당 부분"을 만들면 알림 | 색인 비대화에 탐지 방법의 이름이 붙었습니다. 보통 이름이 붙은 뒤에 검토 절차가 따라옵니다 |
바뀌지 않은 것. 평판이 쌓이기 전 신규 사용자의 게시물에 대한 noindex, 그리고 신뢰할 수 없는 콘텐츠 내 링크에 nofollow 또는 ugc를 붙이는 것입니다. 두 가지를 이미 하고 있다면 이번 업데이트보다 앞서 있습니다.
분명히 짚어둘 점이 있습니다. X에서의 반응은 문서보다 앞서 달렸지만, 이것은 플랫폼 자신의 URL 공급에 관한 가이드입니다. 일반 마케팅 사이트에 새로운 위반을 만들지 않고, 어떤 페이지의 순위도 바꾸지 않습니다. 바뀌는 것은 색인에 무엇이 존재해야 하는가입니다.
시점을 설명하는 맥락이 하나 더 있습니다. 2026년 7월 말, Claude 공유 링크와 아티팩트 페이지가 Google 색인에 나타났고, 당시 보도는 Anthropic이 며칠 만에 막기 전까지 의료 기록, API 키 등 비공개 자료가 노출되었다고 전했습니다. 같은 보도는 Replit, Lovable 같은 빌더의 공개 앱 URL도 지적했습니다. Google이 가상의 상황을 위해 새 섹션을 쓰는 일은 거의 없습니다. 이건 이미 출시된 뒤의 일이었습니다.
모든 생성 URL을 결정하는 하나의 질문
Google의 테스트는 한 문장으로 제시되며, 의도를 추측하지 않고 적용할 수 있습니다. 이 콘텐츠는 검색엔진을 통해 발견되도록 의도된 것인가, 아니면 링크를 가진 사람만 접근하는 것인가.
실무에서는 네 가지 신호가 답을 냅니다. 점수를 매길 대상은 개별 페이지가 아니라 라우트입니다.
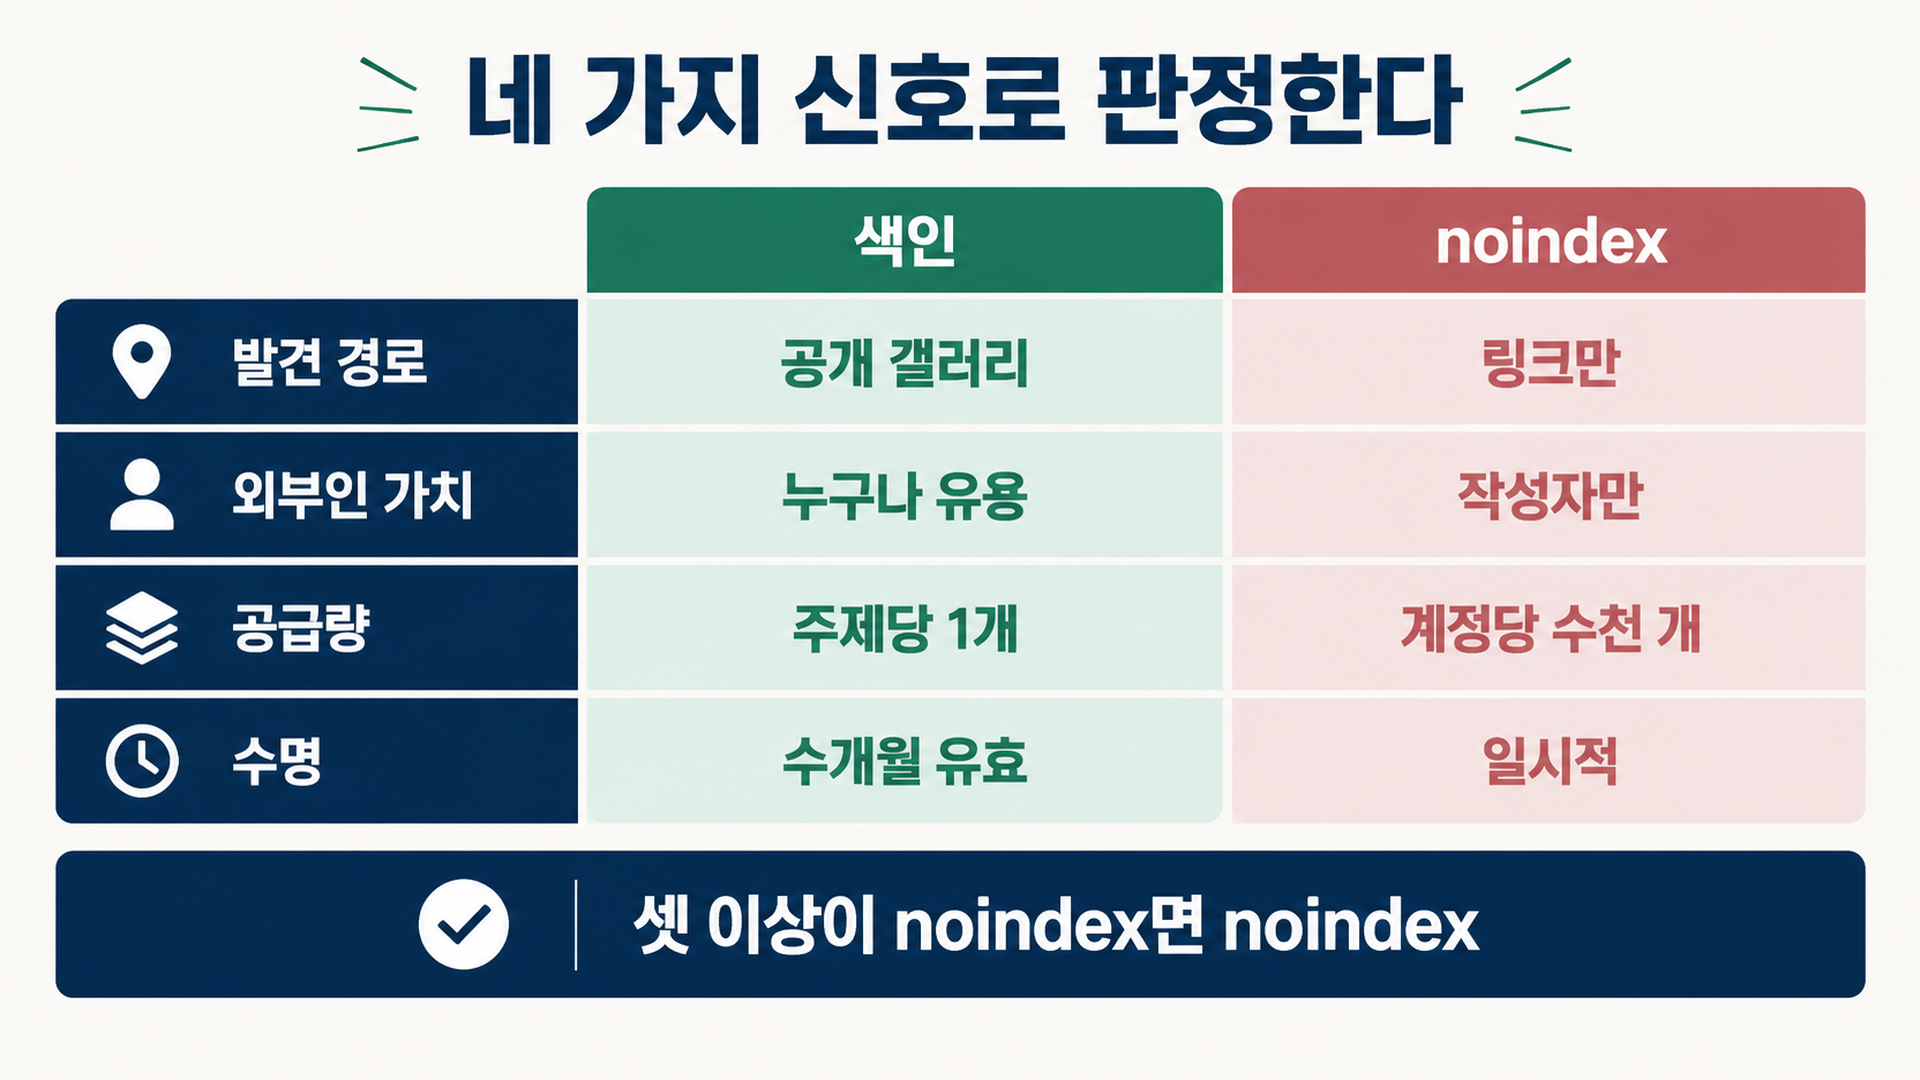
신호 | 색인 쪽 | noindex 쪽 |
|---|---|---|
발견 경로 | 공개 갤러리, 사이트맵, 카테고리 페이지, 프로필에서 링크됨 | 복사한 링크나 공유 버튼으로만 도달 가능 |
외부인 가치 | 만든 사람을 몰라도 쓸모가 있음 | 창작자 본인, 그 팀, 또는 받은 사람에게만 의미가 있음 |
공급량 | 주제당 한 페이지, 또는 선별된 세트 | 계정 하나에서 수천 개의 URL, 대부분 거의 중복 |
수명 | 몇 달 동안 정확하게 유지됨 | 일시적. 채팅, 빌드, 초안, 임시 내보내기 |
네 개 중 셋이 noindex를 가리키면 명확합니다. 결과가 갈리면 보통 라우트를 쪼개야 한다는 뜻입니다. 색인 가능한 공개 갤러리와, 그렇지 않은 개별 결과물을 분리하는 것입니다. 이 분리가 가장 흔한 정답이면서, 동시에 가장 많이 건너뛰는 답입니다. 플래그 하나가 아니라 템플릿 두 개가 필요하기 때문입니다.
유용한 거절 테스트가 있습니다. 외부인이 검색 결과에서 이 URL을 맥락 없이 봤을 때 제목과 스니펫이 말이 되는가? "Sam과의 채팅, 10월 24일"은 탈락입니다. "프리랜서 디자이너용 인보이스 템플릿"은 통과입니다. 탈락의 이유는 품질이 아닙니다. 그 페이지가 발견되도록 만들어졌는지, 보내지도록 만들어졌는지의 문제입니다.
실제로 URL을 제거하는 제어를 고르기
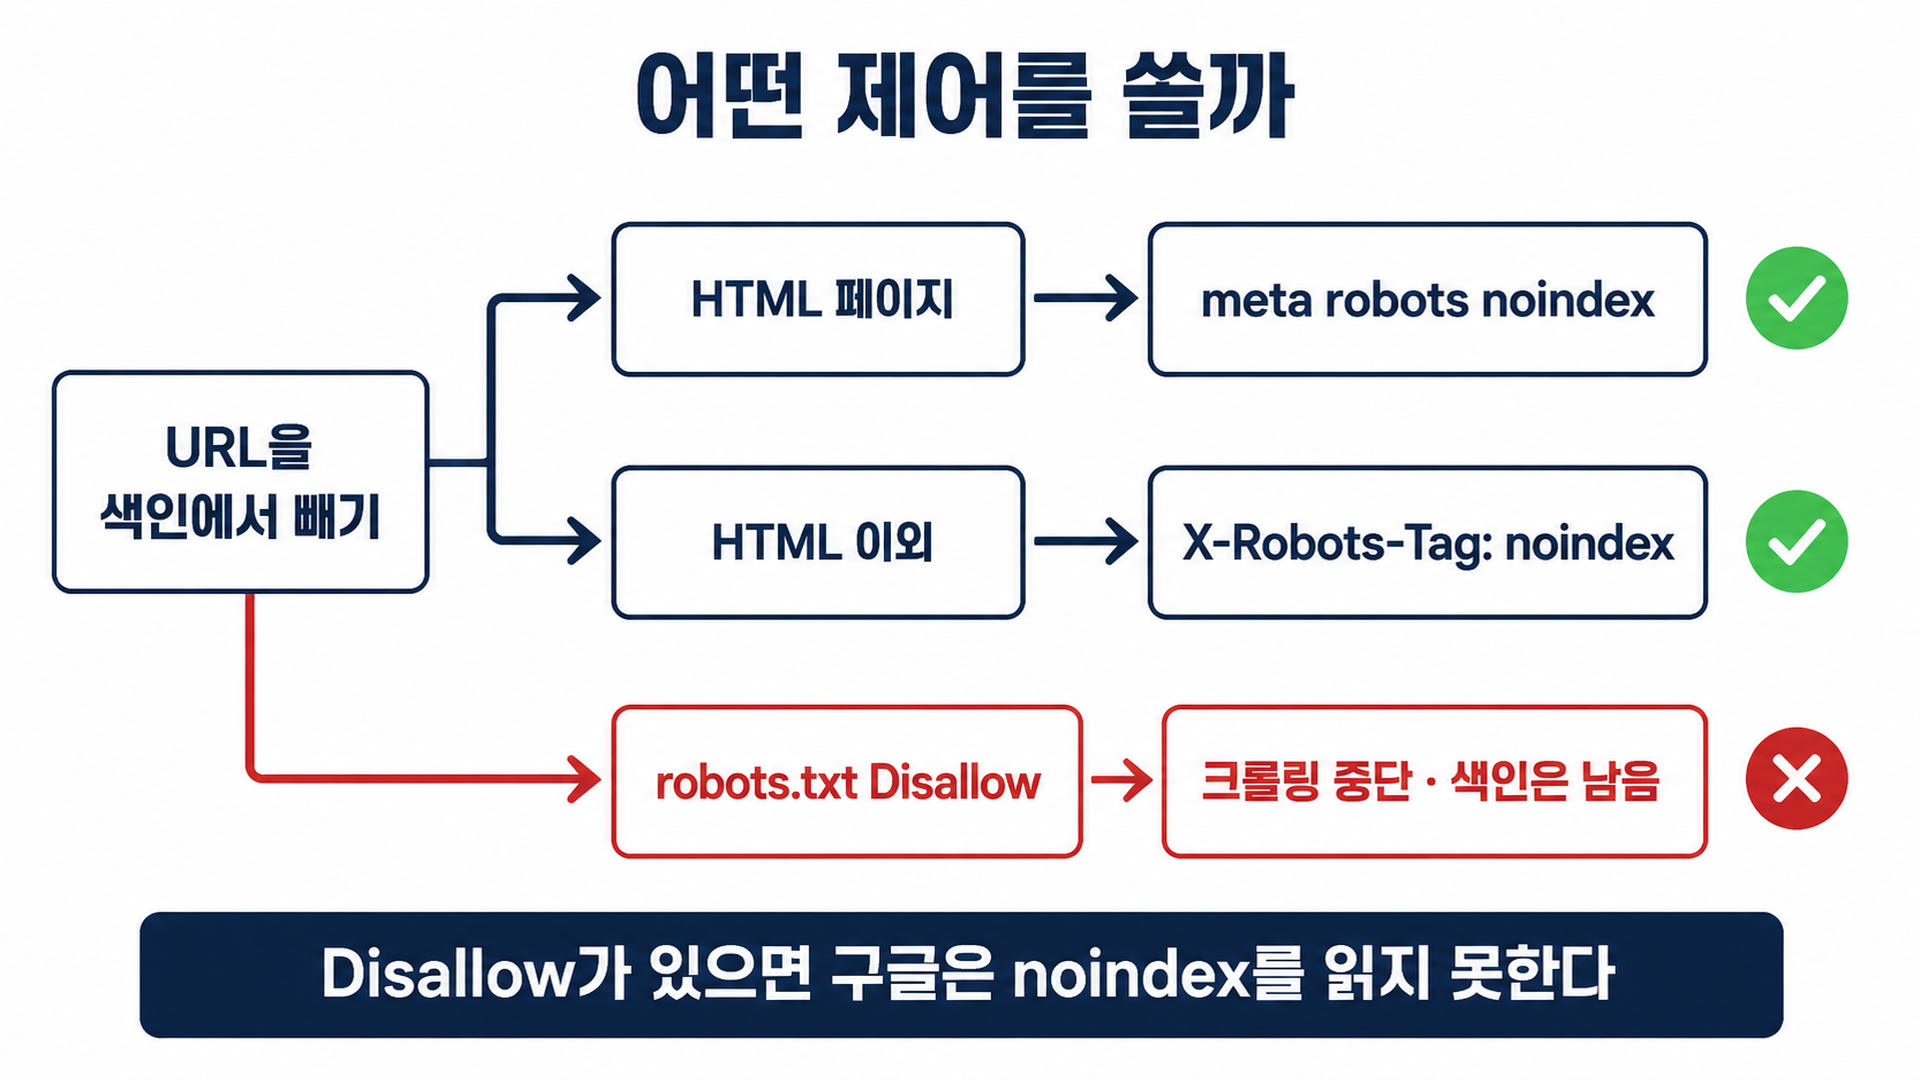
여기가 새 가이드를 문자 그대로 따라도 실패할 수 있는 지점입니다. Google은 같은 문장에서 두 가지 선택지를 제시하지만, 둘은 동등하지 않습니다.
robots.txt는 크롤링을 제어합니다. URL을 색인에서 제거하지는 못하며, Google도 robots.txt 소개 문서에서 그렇게 말합니다. 거기서 차단된 페이지도 "다른 사이트에서 링크되면 색인이 생성될 수 있다"고요. 이 경우 URL과 그 URL을 가리키는 앵커 텍스트가 설명 없이 검색 결과에 나타날 수 있습니다.
noindex는 색인 생성을 제어하지만, Google이 페이지를 가져와 지시자를 읽을 수 있을 때만 작동합니다. Google의 noindex 문서는 명확합니다. 규칙이 유효하려면 페이지가 robots.txt로 차단되어 있으면 안 됩니다. 그렇지 않으면 "크롤러가 noindex 규칙을 절대 보지 못하기" 때문입니다.
이 두 사실을 합치면 순서가 중요해집니다.
제어 | 색인에서 URL 제거 | 실패하는 지점 | 사용할 곳 |
|---|---|---|---|
| 예. Google이 크롤링해 읽은 뒤 | robots.txt로 차단된 대상, 로그인 뒤에 있는 대상 | 비 HTML 응답(PDF, JSON, 이미지), 그리고 여러 라우트에 걸친 엣지·CDN 규칙 |
HTML head의 | 예. Google이 크롤링해 읽은 뒤 | 로드 후 JavaScript로 삽입되는 태그, robots.txt로 차단된 페이지 | 서버 사이드 렌더링된 HTML 공유 페이지 |
| 아니요 | 링크된 URL은 스니펫 없이 색인에 남을 수 있음 | 크롤링 부하 감소. 프라이버시 보호가 아님 |
로그인 또는 서명된 URL | 예. 접근 자체를 막아서 | 페이지가 실제로 비공개여야 함 | 다른 사람의 데이터가 들어간 모든 것 |
만료 후 410 | 예. 시간이 지나면서 | 404보다 느림. URL이 살아 있는 동안은 아무것도 하지 않음 | 일시적 공유와 빌드 |
피해야 할 지름길 하나. X-Robots-Tag: none은 중립적인 값이 아닙니다. Google은 이를 noindex에 nofollow를 더한 것으로 취급합니다. 가끔 원하는 값이지만, 팀들은 그걸 모른 채 프록시 설정에서 복사해 옵니다.
피해야 할 지름길 둘. canonical 태그입니다. canonical은 힌트입니다. 그 페이지가 색인에 들어가면 안 된다면 noindex라고 쓰세요.
1단계: URL을 만들어내는 라우트 목록화하기
나열하지 않은 것은 분류할 수 없습니다. 그리고 대부분의 팀은 기능 단위로 생각하기 때문에 라우트 패턴 단위로 세지 않아 개수를 과소평가합니다.
라우터나 URL 맵을 열고 모든 동적 세그먼트를 나열하세요. 전형적인 해당 항목은 이렇습니다.
/s/:id,/share/:id,/p/:token/chat/:id,/conversation/:id,/thread/:id/u/:handle,/profile/:handle/app/:id,/build/:id,/project/:id/r/:slug,/preview/:token,/report/:id
그다음 Google이 이미 알고 있는 것과 대조하세요. 코드와 색인은 서로 어긋나기 때문입니다.
사이트맵에서. 가져와서 개수를 세세요.
curl -s https://example.com/sitemap.xml | grep -c "<loc>"
curl -s https://example.com/sitemap.xml | grep -oE "https://[^<]+" | sed -E 's#https://[^/]+##' | cut -d/ -f2 | sort | uniq -c | sort -rn
두 번째 명령은 경로 접두사별 대략적인 히스토그램을 줍니다. 생성 라우트가 사이트맵에 나타난다면 그 자체가 버그입니다. 사이트맵은 Google에 색인해 달라고 요청하는 페이지 목록이니까요.
Search Console에서. [페이지 색인 생성] 보고서를 열고 후보 라우트마다 URL 접두사로 필터링해 건수를 기록하세요. Google이 그 URL들을 실제로 어떻게 처리했는지 알려주는 유일한 출처입니다.
서버 로그에서. Googlebot 요청을 접두사별로 묶으세요.
grep -i "Googlebot" access.log | awk '{print $7}' | cut -d/ -f2 | sort | uniq -c | sort -rn | head -20기대 산출물. 라우트 패턴 목록과 그 옆의 URL 건수. 최소 두 개 출처에서 얻은 것.
품질 점검. 직원이 아닌 방문자에게 200을 반환할 수 있는 모든 라우트가 목록에 있어야 합니다. 같은 접두사에서 사이트맵 건수와 Search Console 건수가 몇 퍼센트 이상 차이 난다면, 무엇이든 바꾸기 전에 이유를 찾으세요.
아무것도 찾지 못했다면. 클라이언트 사이드 라우터일 가능성이 큽니다. 백엔드가 아니라 프런트엔드에서 라우트 정의를 검색하고, 실제 공유 링크에서 네트워크 탭을 확인하세요.
2단계: 회의가 아니라 표에서 라우트 분류하기
판정은 검토할 수 있는 곳에 적으세요. 라우트 패턴당 한 행이면 충분합니다.
라우트 | 생성 주체 | 발견 경로 | 외부인 가치 | 판정 | 제어 | 담당 |
|---|---|---|---|---|---|---|
| 모든 사용자 | 링크만 | 없음 | noindex | 헤더 | 플랫폼 |
| 선별 | 내부 링크, 사이트맵 | 높음 | index | 없음 | 콘텐츠 |
| 모든 사용자 | 프로필 링크 | 활성화 전까지 낮음 | 평판 쌓일 때까지 noindex | 메타 태그 | 신뢰·안전 |
| 모든 사용자 | 링크만 | 없음 | noindex | 헤더 | 플랫폼 |
| 편집자 | 사이트맵 | 높음 | index | 없음 | 콘텐츠 |
이 표는 세 가지가 참일 때만 작동합니다.
행마다 담당자를 한 명씩 지정하세요. 소유권이 모호한 것이 생성 라우트가 몇 년씩 색인 가능한 상태로 남는 이유입니다.
제어를 나중이 아니라 판정 옆에 쓰세요. "noindex"는 그것이 헤더인지, 템플릿 변경인지, CDN 규칙인지 누군가 알기 전까지는 결정이 아닙니다.
예외를 기록하세요. 라우트가 noindex인데 아주 일부만 공개해야 한다면, 그 부분집합 조건을 지금 쓰세요. 6개월 뒤에 예외를 덧붙이는 것이 noindex 규칙이 조용히 전부 제거되는 전형적인 경로입니다.
3단계: 템플릿 계층에서 제어 배포하기
페이지별 수정은 다음 배포에서 살아남지 못합니다. 제어는 라우트가 렌더링되는 곳에 적용하세요.
HTML 페이지라면 태그를 서버 사이드 렌더링된 head에 넣습니다. Next.js App Router에서는 메타데이터, Astro에서는 레이아웃의 head, Rails나 Django에서는 레이아웃 템플릿입니다. 정확한 문법보다 위치가 중요합니다. Google이 받는 HTML에 있어야 하고, 클라이언트 사이드 이펙트로 추가되어서는 안 됩니다.
<meta name="robots" content="noindex">HTML이 아닌 것에는 메타 태그가 존재하지 않으므로 헤더를 씁니다.
X-Robots-Tag: noindex이것으로 PDF 내보내기, JSON 응답, 생성 이미지, CSV 다운로드가 커버됩니다. 그 파일들이 CDN에서 제공된다면 새 라우트가 자동으로 상속하도록 엣지에서 헤더를 설정하세요.
라우트 패밀리 전체에는 보통 모든 템플릿을 건드리는 것보다 미들웨어 규칙이 깔끔합니다.
// Express 예시: 생성된 모든 공유 URL을 noindex로
app.use(['/s', '/share', '/report'], (req, res, next) => {
  res.set('X-Robots-Tag', 'noindex');
  next();
});
기대 산출물. noindex로 표시한 모든 라우트가 익명 요청에 대해 첫 바이트에서 지시자를 반환하는 배포.
품질 점검. 라이브 URL에 curl -sI를 실행하세요. 응답 헤더에 x-robots-tag: noindex가 보여야 하고, curl -s로는 스크립트가 실행되기 전 소스에 메타 태그가 보여야 합니다.
복구 경로. 태그가 JavaScript 실행 후에만 나타난다면 서버 렌더링으로 옮기세요. 프레임워크가 라우트별 head 태그 렌더링을 지원하지 않는다면 대신 헤더를 쓰세요. JS로 주입한 noindex를 배포하고 작동한다고 가정하지 마세요. Google은 렌더링된 noindex의 동작을 명확히 정의되지 않았다고 설명합니다.
같은 풀 리퀘스트에 두 가지가 더 들어가야 합니다. noindex 라우트를 사이트맵에서 제거하는 것. 색인되길 원하지 않는 URL을 제출하는 것은 모순이고, Google은 그 모순을 자기에게 유리하게 해결합니다. 그리고 만료 규칙을 추가하는 것. 공유 링크가 죽으면 빈 상태의 200 페이지를 남기는 대신 410을 반환하세요.
4단계: Googlebot이 지시자를 볼 수 있는지 검증하기
위의 모든 것은 Google과 같은 방식으로 확인하기 전까지 검증되지 않은 것입니다.
먼저 응답 헤더를 확인합니다.
curl -sI https://example.com/s/abc123 | grep -i x-robots-tag다음으로 스크립트가 실행되기 전의 초기 HTML을 확인합니다.
curl -s https://example.com/s/abc123 | grep -i 'name="robots"'마지막으로 robots.txt가 그 경로를 차단하지 않는지 확인합니다. 차단한다면 Google은 페이지를 가져오지 않고 지시자도 읽지 않습니다.
curl -s https://example.com/robots.txt최종 확인은 Search Console입니다. [URL 검사]에서 그 URL을 요청하고 판정을 읽으세요.
올바른 결과는 "페이지가 색인 생성되지 않음: 'noindex' 태그에 의해 제외됨"입니다. 함정에 빠졌다는 뜻의 결과는 "robots.txt에 의해 차단되었지만 색인이 생성됨"입니다. Google은 URL을 가지고 있지만 지시자를 읽지 못해 계속 제공할 수 있습니다. 이게 보인다면 robots.txt 규칙을 제거하고 noindex가 일하게 하세요.
크롤러 시뮬레이터로 Googlebot이 보는 페이지를 가져올 수도 있습니다. 라우트 스무 개를 확인할 때 재크롤링을 기다리는 것보다 빠릅니다. Googlebot Spider Simulator.
기대 산출물. 다음 크롤링 후 며칠 안에 noindex 라우트 전부가 noindex에 의한 제외 상태를 보입니다. 변경 후에 만들어진 라우트는 애초에 색인에 나타나지 않습니다.
복구 경로. 2주가 지나도 URL이 색인에 남아 있다면, Google이 그 URL을 가져올 수 있는지, Googlebot에 200을 반환하는지, canonical이나 hreflang 태그가 검색엔진을 다른 곳으로 보내고 있지 않은지 확인하세요. 삭제 도구는 원인을 고치는 동안의 임시 차단에만 쓰고, 지시자를 대체하지 않습니다.
공유 페이지가 성장 채널인 경우
색인되어야 하는 생성 페이지도 있고, 일괄 noindex는 자해입니다. 지킬 가치가 있는 것은 다음과 같습니다.
패턴 | 색인에 값하는 이유 | 가드레일 |
|---|---|---|
공개 템플릿 갤러리 | 사용자가 디자인을 공개하고 다른 사람이 재사용함. 결과물이 독특하고 오래감 | 신규 제출을 검수 |
공개 쇼케이스 페이지가 있는 빌더 | "built with" 크레딧이 붙은 실제 결과물은 유통 채널이 됨 | 쇼케이스 템플릿을 마케팅 페이지와 분리 |
사용자 스레드에서 자라난 문서 | 반복되는 질문에는 영구적이고 편집된 답이 어울림 | 선별된 답을 색인하고 원본 대화는 색인하지 않음 |
이 범주 중 하나에 속한다면 Google의 이전 조언이 여전히 유효하고 더 나은 지렛대입니다. 평판이 없는 사용자의 콘텐츠를 noindex로 두고, 계정에 이력이 쌓이면 해제하는 것입니다. 획득 루프를 포기하지 않고 스팸 저항력을 얻습니다. 이번 업데이트 전부터 가이드가 권하던 패턴입니다.
세 가지 모두에 적용되는 테스트는 같습니다. 외부인이 입력할 법한 쿼리로 검색 실적에 노출이 발생한다면 색인에 속합니다. 자기 URL 문자열로만 노출이 발생한다면 속하지 않습니다.
이차 효과도 짚어둘 만합니다. 공개 공유 URL은 오랫동안 값싼 링크 표면이었습니다. 도메인 파워가 강한 플랫폼에 페이지를 만들고, 자기 사이트로 링크를 걸고, 스무 개 부동산에서 반복하는 방식입니다. Patrick Stox는 같은 스레드에서 서로 다른 플랫폼에서 온 링크를 20개 이상으로 셌습니다. 플랫폼이 가이드를 따르면 이 표면은 좁아집니다. 따르지 않으면 Google은 다음에 그 페이지들을 스팸으로 판단할 때 인용할 문서를 갖게 된 것입니다.
5단계: Google이 설명한 패턴을 계측하기
모니터링 섹션은 대부분의 팀이 건너뛸 부분이고, 동시에 실제 사고가 수동 조치가 되기 전에 잡아내는 부분입니다.
네 가지 점검과 각각의 확인 장소입니다.
Search Console 소유권 확인. 사이트 또는 하위 도메인을 확인해 수동 조치와 보안 알림이 이메일로 도착하게 하세요. 테넌트별 하위 도메인을 발급하는 플랫폼을 운영한다면 상위 속성과 최소 일부 하위 속성을 확인하세요. 아무 데도 도착하지 않는 알림은 모니터링이 아닙니다.
페이지 색인 생성 추이. 생성 라우트별 색인된 URL 수를 오늘 기준선으로 잡고, 노이즈가 아니라 계단식 변화를 관찰하세요. 정적이어야 할 라우트에서 일주일에 색인 URL이 두 배가 되면 그게 신호입니다.
검색 실적 이상. 제품과 무관한 쿼리로 필터링하세요. 스팸 페이지는 누군가 신고하기 훨씬 전부터 스팸 쿼리를 끌어들입니다.
생성 대비 색인 비율. Google이 이름을 붙인 지표이고, 거의 아무도 추적하지 않는 지표입니다. 계정 하나가 하루에 만들 수 있는 색인 가능 URL은 몇 개인지, 새 색인 가능 URL 중 상위 1% 계정이 차지하는 비중은 얼마인지. 단일 계정에 대해 최근 7일 중앙값의 3배로 알림을 거는 출발점은 임의적이지만 실용적입니다. 자사 트래픽에 맞춰 조정하세요.
같은 비율은 제품 가드레일로도 작동합니다. 어떤 기능이 사용자 한 명에게 하루 천 개의 색인 가능 URL을 만들게 한다면, 아직 아무도 악용하지 않았더라도 그건 색인 비대화 기능입니다.
이번 업데이트가 실제로 말하는 것
문구를 벗기면 Google은 공급에 관한 논증을 하고 있습니다.
20년 동안 스팸 정책은 페이지를 서술했습니다. 얇은, 긁어온, 위장한, 키워드를 채운. 그 범주들은 사람이나 스크립트가 페이지를 만들기로 결정하고 Google이 순위에 값하는지 판단한다는 전제에 서 있습니다. 생성 결과물은 그 모델을 깹니다. 제품 결정 하나가 백만 개의 URL을 만들고, 모두 기술적으로 고유하며, 모두 기술적으로 200을 반환하고, 대부분은 만든 사람이 아닌 이에게 무가치합니다. Google은 그것들을 하나씩 평가할 수 없고, 평가할 수 있는 척하기를 그만두었습니다.
반응은 두 진영으로 정리되었습니다. 한쪽은 경고 사격으로 읽었습니다. Marie Haynes는 AI 도구와 앱 빌더에 대한 새로운 수동 조치가 뒤따르는지 물었고, Lily Ray는 이 섹션을 Google이 이미 대규모로 싸우고 있는 것에 대한 신호로 다루며 Claude 아티팩트, ChatGPT 공유 페이지, 소셜 게시물을 지목했습니다. 다른 쪽은 어깨를 으쓱했습니다. 신중한 팀은 수년 전부터 사용자 생성 리포트를 noindex로 처리해 왔다는 답글이 여럿 있었고, Google 자신의 생성 페이지가 더 큰 문제라는 지적도 있었습니다. 둘 다 참일 수 있습니다. 이 가이드가 중요한 이유는 조언이 새로워서가 아니라, 이제 집행이 가리킬 수 있는 곳에 문서로 적혔기 때문입니다.
즉 가이드는 판단을 상류로 옮깁니다. 플랫폼은 이제 URL 부류가 색인에 속하는지를 템플릿 계층에서 결정할 것을 기대받습니다. 그것은 거버넌스 질문이지 SEO 질문이 아니며, 조언이 색인 문서가 아니라 스팸 가이드에 놓인 이유입니다.
AI 검색에도 같은 논리가 양방향으로 적용됩니다. Google의 AI 기능은 Google 색인을 끌어오므로, noindex 지시자는 파란 링크에서뿐 아니라 그 풀에서도 페이지를 제거합니다. 생성 페이지가 AI Overview에서 인용을 얻고 있었다면 그것은 멈출 것으로 보세요. 공유 링크에는 대개 옳고 템플릿 페이지에는 대개 틀립니다. 다른 AI 크롤러는 자기 규칙을 따르므로, 그들이 그 페이지를 가져올 수 있게 할지는 따로 결정하세요.
실무적 결론은 디자인 리뷰에 그대로 올릴 수 있는 한 문장입니다. 사용자가 만들 수 있는 모든 URL은 제품 표면이거나 색인 부채이며, 어느 쪽인지는 템플릿이 결정한다.
FAQ
일반 마케팅 사이트에도 적용되나요?
사용자 입력으로 URL을 만들어내지 않는다면 아닙니다. 마케팅 사이트는 사람이 존재해야 한다고 결정한 페이지 집합을 게시하는 것으로, 가이드가 설명하는 문제와 정반대입니다. 적용 범위 문장은 공유 페이지, 생성 콘텐츠, 웹 앱을 사용자가 게시할 수 있게 하는 호스팅 플랫폼과 도구를 지목합니다. 댓글, 포럼, 회원 프로필을 운영한다면 이전 조언이 적용됩니다. 신뢰할 수 없는 계정의 링크에 nofollow 또는 ugc를 붙이고, 평판이 쌓일 때까지 신규 사용자는 noindex로 두는 것입니다.
robots.txt와 noindex 태그 중 무엇을 써야 하나요?
noindex입니다. 그리고 한 라우트에는 둘 중 하나만 쓰세요. Google의 문장은 두 선택지를 나열하지만 역할이 다릅니다. robots.txt Disallow는 크롤링을 멈추고, 차단되었지만 다른 곳에서 링크된 URL은 스니펫 없이 결과에 남을 수 있습니다. noindex는 Google이 페이지를 가져와 읽을 수 있을 때만 작동합니다. 실무적으로는 메타 태그나 응답 헤더이고, 같은 경로에 robots.txt 규칙을 두어서는 안 됩니다.
공유 페이지를 noindex로 하면 트래픽을 잃나요?
결정한 뒤가 아니라 결정하기 전에 라우트를 확인하세요. 페이지가 자기 URL 문자열로만 노출을 얻는다면 오가닉 트래픽을 만들고 있지 않으므로 제거해도 잃을 것이 없습니다. 트래픽을 잃는 패턴은 공개 갤러리를 그 안의 결과물과 함께 내리는 경우입니다. 갤러리는 색인 가능하게 두고 그 뒤에 있는 것을 noindex로 하며, 갤러리 쿼리에 대해 변경 전후 검색 실적을 확인하세요.
AI 검색엔진은 noindex를 존중하나요?
Google의 AI 기능은 존중합니다. AI Overview와 AI 모드는 같은 색인을 끌어오므로, 지시자는 파란 링크와 AI 답변 양쪽에서 페이지를 제거합니다. 다른 AI 크롤러는 별개의 결정입니다. 벤더 행동은 다르고 변경 이력 없이 바뀌므로, 각 크롤러의 문서를 읽고 하나의 지시자가 전부를 커버한다고 가정하지 말고 그 크롤러의 사용자 에이전트로 페이지를 가져와 확인하세요.
저자: Grace Miller, Auspia의 AI 검색 리스크 분석가. 200건 이상의 정책 변화를 추적합니다. 플랫폼 규칙, 콘텐츠 리스크, 정책을 고려한 최적화에 대해 씁니다.