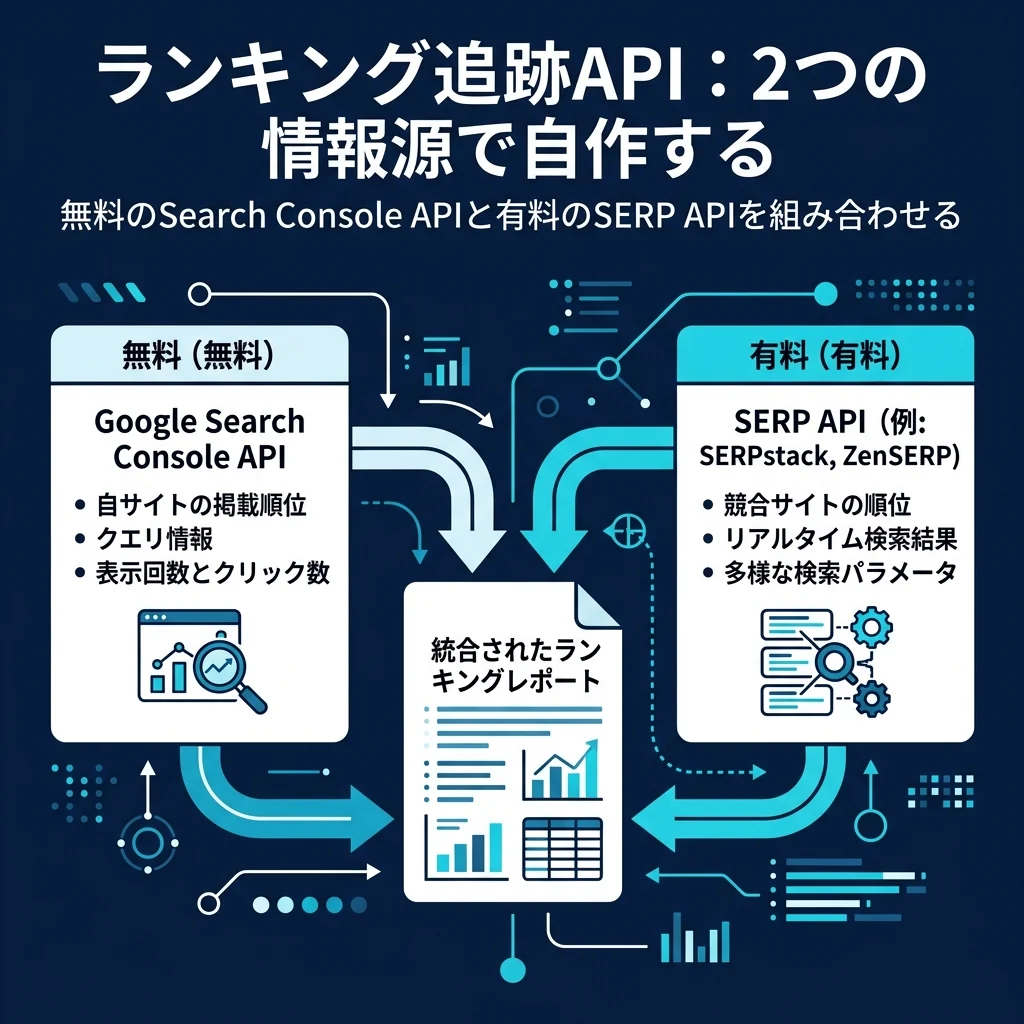
「ランクトラッキングAPI」はひとつのものではありません。開発者が「rank tracking API」で検索するとき、たいてい欲しいのは順位を返す単一のエンドポイントで、市場はベンダーのまとめ記事で応えます。正直な答えはこうです。必要なのは2つの情報源であり、それぞれ別の問いに答えます。
Search Console API は無料で公式で、検証済みのプロパティに恒久的に限定されます。SERP API は有料で非公式で、まだランクインしたことのないキーワードを含め、どのキーワードでもどの地域でも調べられます。どちらか片方だけではランクトラッカーになりません。両方を組み合わせると、およそ120行のPythonとcronの1行になります。
これがその構築手順です。スクリプトを実行してファイルを保存できることを前提とします。製品を作りたいわけではないという前提です。
完成すると手に入るもの
対象読者: Search Console へのアクセスがすでにあり、席あたりの料金を払わずに定期的に順位を取得したい開発者、または技術系マーケター。
完成時に手元にあるもの: 動作する2つの取得関数、1回の実行につき1つのマージ済み出力ファイル、そして数値が嘘をつくのを止める比較ルール。
所要時間: 初回の構築でおよそ90分、その後は1回の実行あたりおよそ10分のレビュー。
完成の形: クエリ別・デバイス別の自社順位と、固定したキーワードリストのライブSERPスナップショット、そして前回実行との短い差分を含む、日付入りのJSONファイル。
はじめる前に:各情報源にできること、できないこと
この切り分けを正しくやれば、残りの構築は機械的です。間違えれば、役に立たないか高くつくものを作るのに1か月を費やします。
Search Console API | SERP API | |
|---|---|---|
誰の順位か | 検証済みの自分のプロパティのみ | 競合を含む誰でも |
キーワード | すでに表示されているクエリ | 入力した任意のキーワード |
コスト | 無料 | リクエストごとの課金 |
デバイス分割 | 可能(ディメンションとして) | 可能(リクエストごと) |
地域 | ランクインしている国 | ベンダーが対応する任意の地域 |
データ種別 | クリック・表示回数・平均掲載順位の集計 | ある時点の検索結果ページ |
履歴の深さ | 指定した期間 | 保存を始めた日以降のみ |
公式性 | Google自身のデータ | 第三者が公開ページを読んだもの |
2つの情報源は食い違い、その食い違いはバグではなく情報です。Search Console は期間内のすべての表示回数とすべてのデバイスを平均します。SERPの取得は、ある瞬間の1つの検索結果ページです。両者を直接比べると存在しない下落を追いかけることになります。だからこそ手順5で比較ルールを定義します。
コードを書く前に知っておくべき3つの数値。 Search Console API は1リクエストあたり1〜25,000行の上限を受け付け、既定は1,000行です。つまり中規模サイトなら、クエリとデバイスの3か月分を1回の呼び出しで取得できます。サイトあたり・ユーザーあたり毎分1,200クエリを許可します。そして10分単位で計測される負荷割り当てを課し、長い期間は短い期間より高くつきます。だからこそGoogle自身のガイダンスが、同じデータを再取得しないよう求めています。
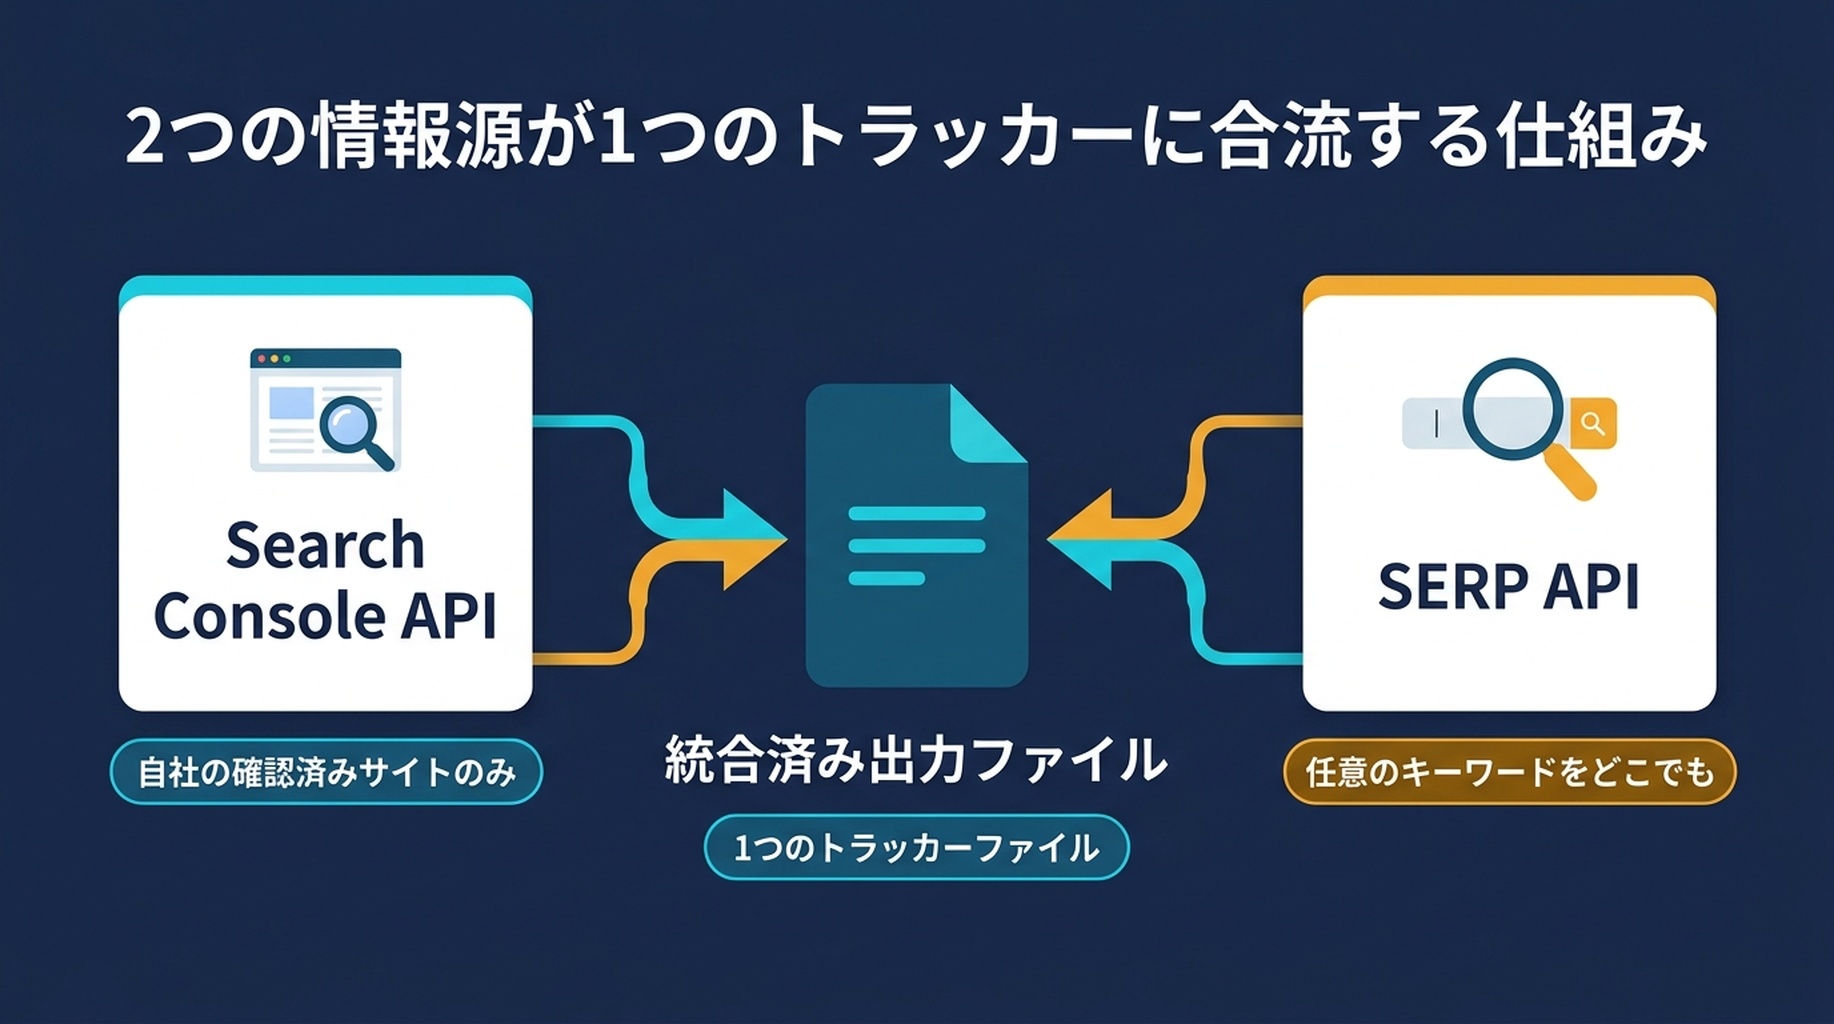
2つの情報源、1つの出力。Search Console は「どこに表示されているか」に答え、SERP API は「ページがどう見えるか」に答えます。
手順1:コードを書く前にキーワードセットを固定する
実行のたびに違うキーワードリストを取得するトラッカーは、何かが変わったのかどうかに答えられません。まずリストを選び、四半期のあいだ維持します。
3つのグループがあり、それぞれ出所が違います。
- Search Console から: 直近90日で表示回数が20以上あるすべてのクエリ。これは自分で選ぶものではなく、表示回数が選びます。すでに需要が紐づいているため、変動が意味を持つのはこのグループです。
- ビジネス側から: 収益に対応する10〜20件のクエリ。まだランクインしていなくても構いません。
- 競合から: 競合がランクインしていて自分がしていないクエリ。Search Console は決して表示しないので、これには SERP API が必要です。
リストをファイルに書き出し、バージョン管理し、追加は意図的な変更として扱い、いつのまにかずれていくものとは区別します。
手順2:自分の順位を無料で取得する
この半分は公式で無料で、どの SERP API にもないデバイス分割とクリックデータを返します。
from google.oauth2 import service_account
from googleapiclient.discovery import build

service = build(
    "searchconsole", "v1",
    credentials=service_account.Credentials.from_service_account_file(
        "gsc-key.json",
        scopes=["https://www.googleapis.com/auth/webmasters.readonly"],
    ),
)

body = {
    "startDate": "2026-06-14",
    "endDate": "2026-09-11",
    "dimensions": ["query", "device"],
    "type": "web",
    "dataState": "final",
    "rowLimit": 25000,
}

rows = service.searchanalytics().query(
    siteUrl="sc-domain:example.com", body=body
).execute().get("rows", [])
このリクエストの2つの細部が仕事の大半を担います。
dataState: "final" は、Google がまだ改訂する可能性のある新しいデータを除外します。これがないと、直近2〜3日分が実行のたびに動き、実際には起きていない変動が差分に現れます。
dimensions: ["query", "device"] が、あとで出力を使い物にする部分です。今デバイスを足すのは無料です。あとから3か月分の履歴を取り直すのは、1回分のフル実行のコストがかかり、すでに飛ばした日については何も得られません。
期待される出力: クエリとデバイスの組み合わせごとに1行、クリック数・表示回数・CTR・平均掲載順位を含みます。
品質チェック: 行数は25,000未満であるべきです。ちょうど25,000なら打ち切られており、startRow: 25000 を付けた2回目の呼び出しが必要です。
失敗した場合: 403 はたいてい、サービスアカウントのメールがプロパティのユーザーとして追加されていないことを意味します。Search Console で追加し、数分待って再試行します。
手順3:自社データでは見えないSERPを取得する
後半は、Search Console が構造上できないことすべてをカバーします。これは最小構成の実動作する呼び出しです。
import base64, json, urllib.request

LOGIN, PASSWORD = "your-login", "your-password"

def serp(keyword, depth=100):
    token = base64.b64encode(f"{LOGIN}:{PASSWORD}".encode()).decode()
    payload = json.dumps([{
        "keyword": keyword,
        "location_name": "United States",
        "language_name": "English",
        "depth": depth,
    }]).encode()
    request = urllib.request.Request(
        "https://api.dataforseo.com/v3/serp/google/organic/live/advanced",
        data=payload,
        headers={"Authorization": f"Basic {token}",
                 "Content-Type": "application/json"},
        method="POST",
    )
    return json.loads(urllib.request.urlopen(request, timeout=120).read())
`depth` は200ではなく100に設定してください。 私たちは2026年9月、6つのクエリで200件を要求してこれを検証しました。Google は83〜128件のオーガニック結果を返して止まり、テスト全体で最も深い順位は142でした。検証の全文はこちら。200を要求しても200件は得られず、ベンダーによっては要求した深さに対して請求され続けます。100を要求すれば、存在するものはほぼ常にすべて受け取れます。
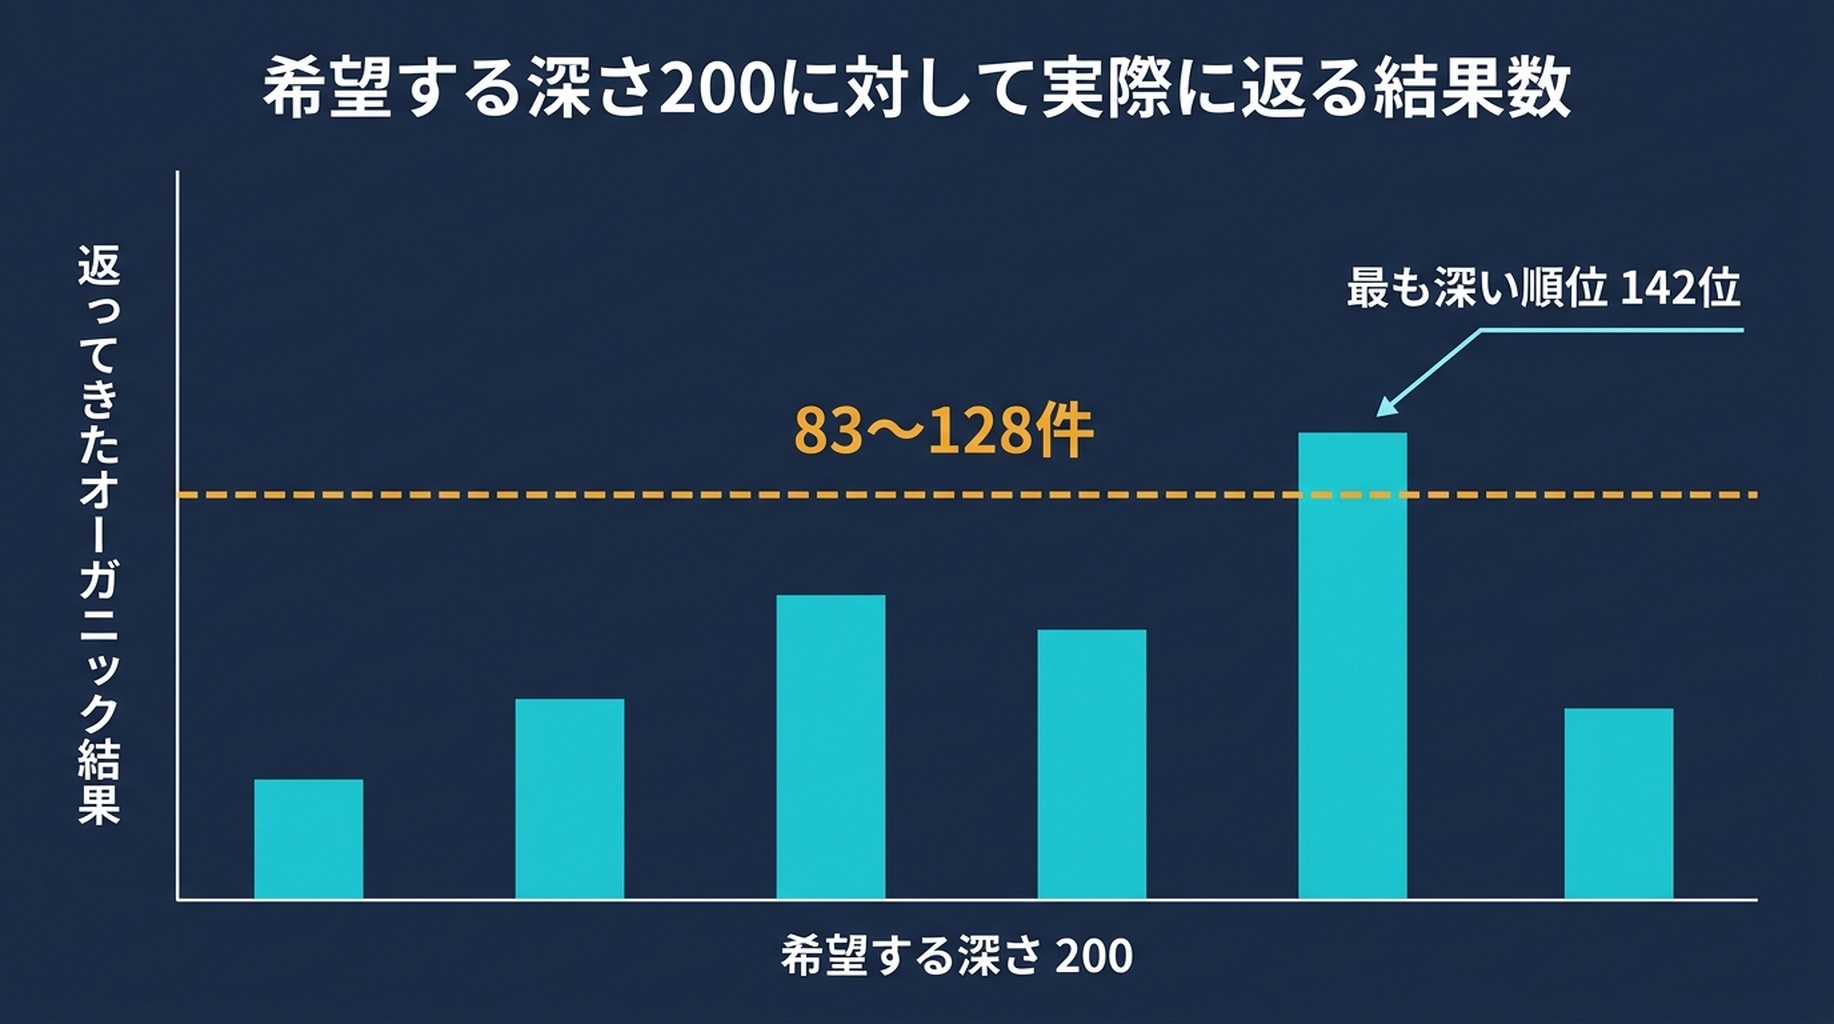
200件を要求して83〜128件しか返らない。おおよそ140を超える深さは、多くの商用クエリでは何も買いません。
期待される出力: 順位・URL・タイトル・ドメインを持つオーガニック項目を含むJSONペイロード。
品質チェック: AI Overview が存在する場合、ペイロードに ai_overview 項目タイプが含まれることを確認します。organic 項目だけを抽出すると、順位を保ったままクリックを失った理由を見落とします。
失敗した場合: 401 は base64 か認証情報のエラーです。40200 系のコードはアカウント残高が空であることを意味し、最初の1か月で最もよくある失敗です。
手順4:要約ではなく生のペイロードを保存する
これは飛ばすと後悔する判断です。
順位の表を保存するやり方は、想定していなかった問いを立てる必要が出るまで機能します。SERPは長くなったか、動画が席巻したか、競合が参入したか、AI Overview がファーストビューの上に出たか。要約はこれらに答えられません。生のペイロードは、追加コストゼロで答えられます。
実務的な形はこうです。1回の実行につき1ファイル、日時を名前にした、マージ済み出力を含むファイルを書き出します。直近90日分を保持します。リポジトリに置ける程度に小さく、古い問いに再回答できる程度に完全です。
手順5:何かをスケジュールする前に比較ルールを書く
前回実行と今回実行を比べるトラッカーは、ほとんどの日にもっともらしくない警報を出します。私たち自身の数値がその理由を示しています。表示回数30以上の124クエリで、平均的なクエリはある日から翌日へ4.57順位動きました。4順位の下落は火曜日のことです。
つまりルールにはしきい値と方向が必要です。
次の条件をすべて満たすクエリだけを報告する:
  - 前回実行との順位差の絶対値が5以上、かつ
  - 比較ウィンドウ内で表示回数が20以上、かつ
  - 変化がデバイス構成の変化では説明できない

出力はクエリ種別ごとにまとめる:money、comparison、brand、informational。
修正案は出すな。デバイスの条件は飾りではありません。同じクエリがモバイルとデスクトップで11順位離れることがあり、実行間でデバイス構成が動けばブレンドされた数値も動きます。私たちはそれを別途計測しましたが、傾向を偽装できるほど大きいものです。
コスト
ベンダーの価格は変わるので、見積もりを追うのではなくモデルを組み立てます。
- 1つのキーワードを30日間毎日チェックすると、月30リクエスト。
- 200キーワードのセットを毎日チェックすると、月6,000リクエスト。
- 同じセットを週次でチェックすると、月およそ860リクエスト。
- Search Console 側は無料で、中に何件のキーワードが入っていても1ビューにつき1リクエストです。
この掛け算が判断のすべてです。「ツールを買うべきか」という問いはほぼすべてこれに帰着します。月あたりのリクエスト数を出し、1リクエスト単価を掛け、席あたりのライセンスと比べます。大きなキーワードセットの毎日追跡はたいていサブスクのほうが安く、小さなセットの週次追跡はたいていAPIのほうが安くなります。固定したリストを追えば、API側は小さく収まります。
作らずに買うべきとき
自分のパイプラインに順位が欲しい、すでに SERP API の認証情報を持っている、順位以外の理由で生の検索結果ページが必要 — これらなら作りましょう。
今日より前の過去の順位が必要、同じキーワードについて10地域と5デバイスが必要、あるいはチームの誰もcronジョブを保守しない — これらなら買いましょう。ベンダーのまとめ記事はまさにこの理由で読む価値があり、作った人がチームを移ると止まるインフラを抱えることには実際のコストがあります。
本当に必要な出力がJSONファイルではなく書かれた週次レポートなら、Codexのレポートワークフローが同じ2つの情報源から始まり文書で終わります。ファイルの上に警報を載せるなら、モニター設計ガイドがしきい値を扱っています。
Auspiaの見解:ランクトラッキングAPIの問いは、実はデータ所有権の問いです。Search Console は自社プロパティについて公式データを無料で与え、それはこれからも変わりません。それ以外はすべて、金を払って手に入れるスナップショットです。無料の半分を先に作り、有料の半分は実際に抱えている問いに答える場所にだけ足してください。
FAQ
GoogleはランクトラッキングAPIを提供していますか? 公開されているものはありません。Search Console API はすでに表示されているクエリの平均掲載順位を返しますが、近いだけで同じものではありません。ランクインしていないキーワードは調べられず、競合も調べられません。
SERP API はどこまで深く取得できますか? ベンダーは200を大きく超える深さの値を受け付けますが、Google は多くの商用クエリでおよそ100〜140あたりで結果を返すのを止めます。多く要求しても多くは返りません。
毎日チェックと週次チェックのどちらを使うべきですか? 通常のキーワードセットなら週次です。毎日にするのは収益クエリの短いリストだけです。大きなセットを毎日チェックするとコストが7倍になり、ほとんどノイズを測ることになります。私たちのデータでは1日の平均変動が4.57順位でした。
APIの数値が使っているランクトラッカーと違うのはなぜですか? デバイスが違い、地域が違い、時点が違い、たいていはデータ源も違います。その数値は標本です。何かが変わったと結論づける前に、リクエストの地域とデバイスを固定して取得し直してください。
エージェントにこれを実行させられますか? はい、毎回同じ形の作業なので相性が良いです。ランキング業務でエージェントに任せられる範囲の全体像はSEOエージェント実践ガイドをご覧ください。比較ルールは書き下した指示ファイルに置き、差分はエージェントに作らせ、作るか買うかの判断は人に残してください。
著者:Rowan Blake、Auspia の100以上の出版パイプラインを担うコンテンツ自動化アナリスト。自動化されたデータパイプライン、定時レポート、そして自分がいなくても動くシステムの保守コストについて書いています。