वह नियम जो Google ने अभी लिखा है
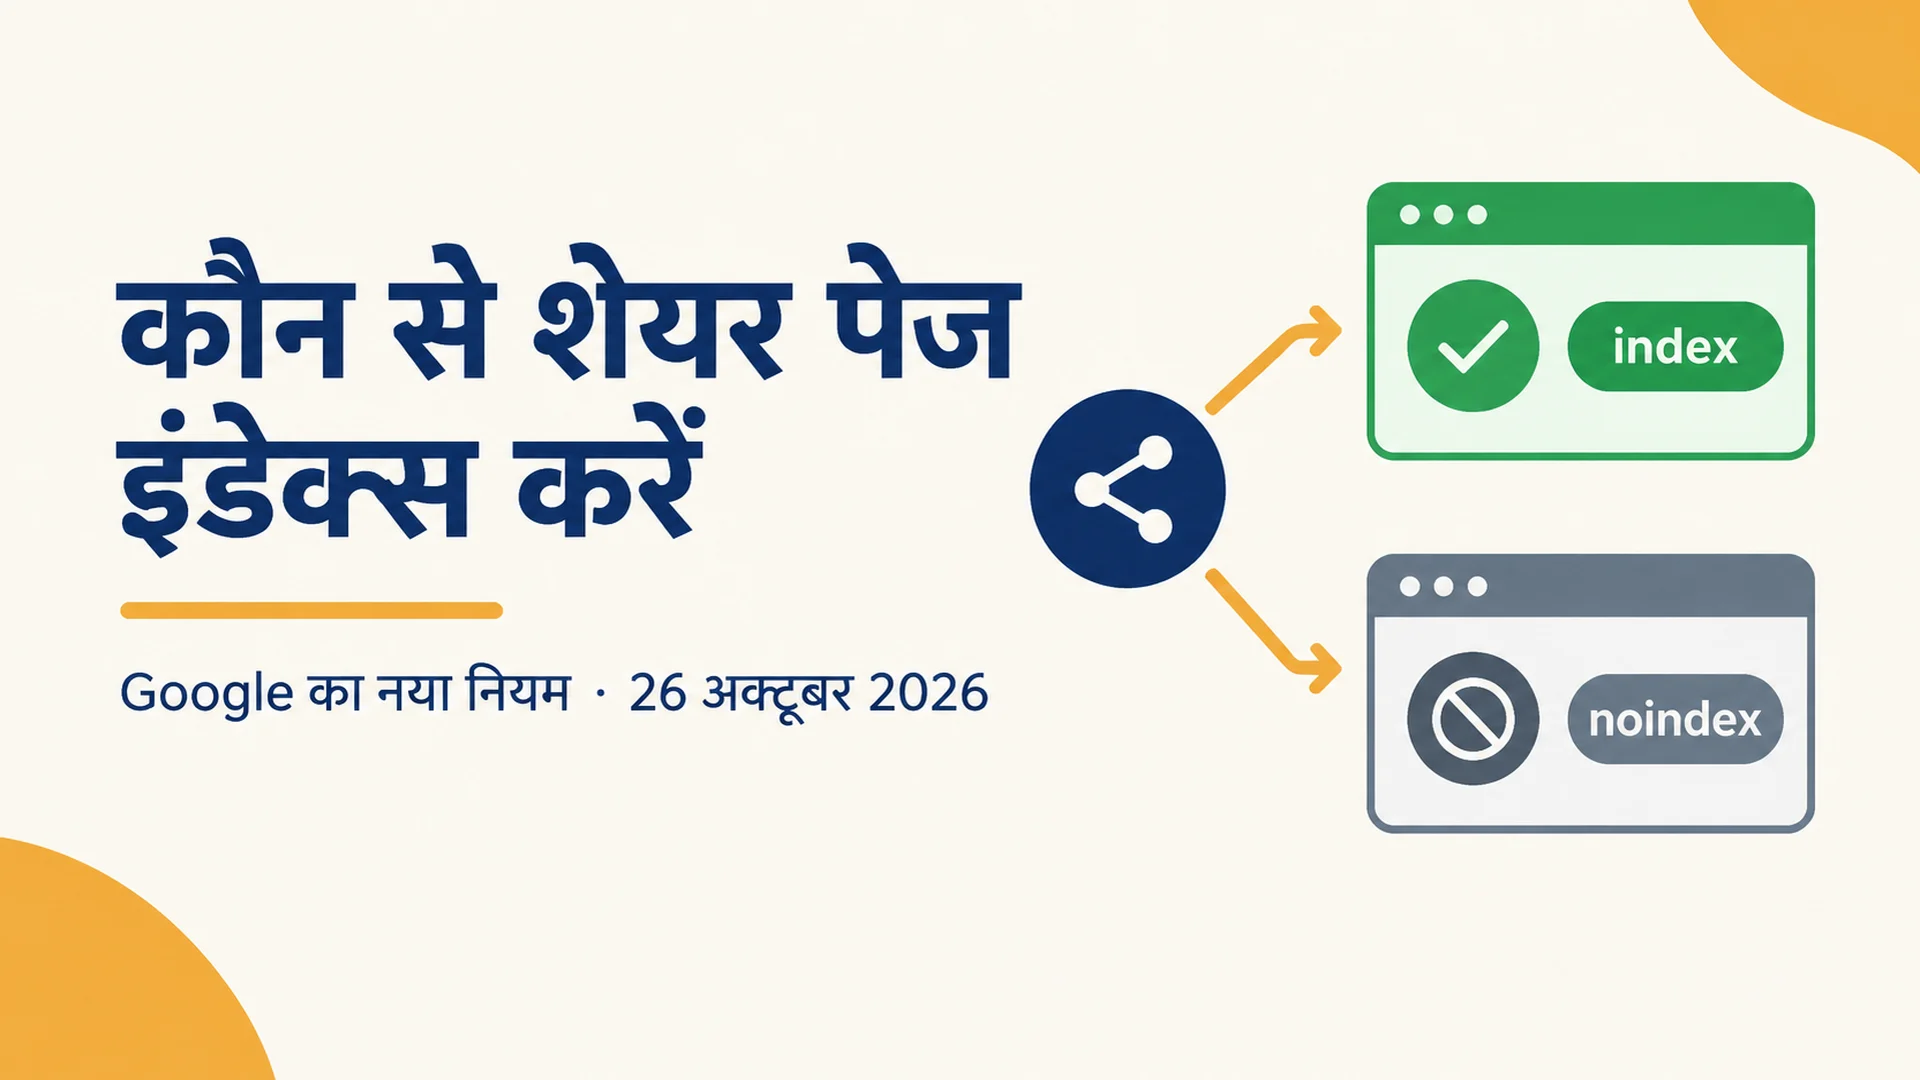
26 अक्टूबर 2026 को Google ने उपयोगकर्ताओं द्वारा बनाए गए स्पैम को रोकने की अपनी गाइड में दो पैराग्राफ़ का एक सेक्शन जोड़ा। पेज का यह सबसे छोटा हिस्सा है और शायद वही जो सबसे ज़्यादा प्रोडक्ट रोडमैप बदलेगा, क्योंकि यह वह सवाल उठाता है जो ज़्यादातर टीमों ने कभी स्लाइड पर नहीं रखा: क्या इस URL को Google के इंडेक्स में होना चाहिए ही?
सेक्शन का शीर्षक है "Only index content meant for Search" — सिर्फ़ वही कंटेंट इंडेक्स करो जो Search के लिए बना है। अनुवाद में यह ऐसा पढ़ता है:
अगर आपकी सेवा उपयोगकर्ताओं को शेयर करने के लिए पेज, जनरेट किए गए नतीजे या इंटरैक्टिव टूल बनाने देती है, तो सोचिए कि यह कंटेंट सर्च इंजन को मिलने के लिए बना है या सिर्फ़ इसलिए कि कोई इंसान लिंक से सीधे खोले।
जब पेज सीधे शेयर करने, साथ मिलकर काम करने या व्यावहारिक काम के लिए बनाए जाते हैं, सार्वजनिक सर्च में मिलने के लिए नहीं, तो डिफ़ॉल्ट रूप से noindex लगाइए (robots मेटा टैग या HTTP हेडर X-Robots-Tag के ज़रिए) या robots.txt में डिफ़ॉल्ट रूप से क्रॉलिंग रोकिए।
उसी दिन का Google चेंजलॉग मंशा साफ़ बताता है: गाइड को "लिंक से शेयर किए गए कंटेंट की इंडेक्सिंग रोकने और Search Console में दुरुपयोग की निगरानी करने की सलाह" के साथ अपडेट किया गया, ताकि प्लेटफ़ॉर्म "उपयोगकर्ताओं द्वारा बनाए उन पेजों को इंडेक्स से बाहर रख सकें जो Search के लिए नहीं हैं, और स्पैम को पहले पकड़ सकें।"
बस इतना ही। कोई नई मैन्युअल कार्रवाई नहीं, रैंकिंग सिस्टम का कोई ऐलान नहीं, सज़ाओं की कोई सूची नहीं। एक डिफ़ॉल्ट की सिफ़ारिश — और लगभग हर इंडेक्सिंग घटना डिफ़ॉल्ट से ही पैदा होती है।
यह किसके लिए है। उन टीमों के लिए जो कोई भी उपयोगकर्ता-निर्मित URL पब्लिश करती हैं: शेयर लिंक, सेव किए गए चैट, सार्वजनिक डैशबोर्ड, मॉडल प्रीव्यू, ऐप बिल्ड, जनरेट की गई रिपोर्ट, फ़ोरम थ्रेड, प्रोफ़ाइल पेज, रिव्यू पेज, लिस्टिंग पेज।
आपको क्या मिलेगा। हर जनरेट किए गए URL टाइप के लिए हर रूट पर एक फ़ैसला, वह कंट्रोल जो पेज को सचमुच इंडेक्स से हटाता है, और एक मॉनिटरिंग नियम जो Google द्वारा बताए गए दुरुपयोग पैटर्न को पकड़ता है।
समय। एक प्रोडक्ट में पहले दौर के लिए 45 से 90 मिनट। अगर कई URL जनरेटर हैं और रूट्स की इन्वेंटरी नहीं है तो एक दिन।
"हो गया" कैसा दिखता है। हर जनरेट किया गया रूट index, noindex या निजी के रूप में चिह्नित है। noindex वाले रूट सर्वर से निर्देश लौटाते हैं, JavaScript चलने के बाद नहीं। Search Console इन URL को "noindex के कारण बाहर रखा गया" बताता है, "इंडेक्स किया गया, लेकिन robots.txt ने ब्लॉक किया" नहीं।
क्या बदला और क्या सिर्फ़ नया दिखता है
चार बदलाव मायने रखते हैं। पेज का बाकी हिस्सा हिला नहीं, दिसंबर 2025 की सलाह भी शामिल है, जो अब भी लागू है।
Google ने क्या बदला | असल पाठ | आपके लिए क्यों मायने रखता है |
|---|---|---|
गाइड का दायरा | अब होस्टिंग प्लेटफ़ॉर्म और "वे टूल जो उपयोगकर्ताओं को शेयर करने के लिए पेज, जनरेट किया गया कंटेंट या वेब ऐप पब्लिश करने देते हैं" का ज़िक्र करता है | शब्दशः यह AI चैट एक्सपोर्ट, आर्टिफ़ैक्ट पेज, ऐप बिल्डर और नो-कोड टूल को कवर करता है, सिर्फ़ फ़ोरम और कमेंट तक सीमित नहीं |
दुरुपयोग की इकाई | स्पैमर "बड़ी संख्या में पेज या साइट" बना सकते हैं | Google पैमाने की बात कर रहा है, चालाकी की नहीं। एक दुरुपयोग किया गया अकाउंट हज़ारों URL बना सकता है |
नया सेक्शन | "Only index content meant for Search" | अब तक का सबसे साफ़ बयान कि सिर्फ़ लिंक से मिलने वाले कंटेंट के लिए noindex समझदारी वाला डिफ़ॉल्ट है |
मॉनिटरिंग | Search Console में साइट या सबडोमेन जाँचिए, पेज इंडेक्सिंग और Search performance के ग्राफ़ में उछाल देखिए, चेताइए जब "कुछ उपयोगकर्ता" "इंडेक्स हो सकने वाले URL का बड़ा हिस्सा" बनाते हैं | इंडेक्स का फूलना अब नामित पहचान-तरीके वाला है — और आम तौर पर किसी तरह की कार्रवाई से पहले यही दिखता है |
क्या नहीं बदला: नए उपयोगकर्ताओं की पोस्ट पर noindex, जब तक उनकी प्रतिष्ठा न बने, और अविश्वसनीय कंटेंट के लिंक पर nofollow या ugc। अगर आप दोनों पहले से कर रहे हैं, तो आप इस अपडेट से आगे हैं।
सीधे कहना ज़रूरी है, क्योंकि X पर प्रतिक्रियाएँ दस्तावेज़ से आगे निकल गईं: यह प्लेटफ़ॉर्म के लिए उनके अपने URL भंडार के बारे में सलाह है। यह आम मार्केटिंग साइट के लिए कोई नया उल्लंघन नहीं बनाती और किसी पेज की रैंकिंग नहीं बदलती। यह बदलती है कि इंडेक्स में क्या होना चाहिए।
एक संदर्भ टाइमिंग समझाता है। जुलाई 2026 के अंत में Claude के शेयर लिंक और आर्टिफ़ैक्ट पेज Google के इंडेक्स में दिखने लगे, और तब की रिपोर्टों ने मेडिकल रिकॉर्ड, API कुंजियाँ और दूसरे निजी सामान सार्वजनिक रूप से खुले पाए जाने का ज़िक्र किया, इससे पहले कि Anthropic कुछ दिनों में खाई भरे। उन्हीं रिपोर्टों में Replit और Lovable जैसे बिल्डरों के सार्वजनिक ऐप URL का भी ज़िक्र था। Google किसी परिकल्पना पर गाइड का नया सेक्शन कम ही लिखता है। यह पहले ही हो चुका है।
वह सवाल जो हर जनरेट किए गए URL का फ़ैसला करता है
Google का परीक्षण एक वाक्य में आ जाता है, और मंशा का अंदाज़ा लगाए बिना लगाया जा सकता है: यह कंटेंट सर्च इंजन को मिलने के लिए बना है या सिर्फ़ इसलिए कि कोई इंसान लिंक से इसे खोले?
व्यवहार में चार संकेत जवाब देते हैं। आकलन रूट का कीजिए, किसी एक पेज का नहीं।
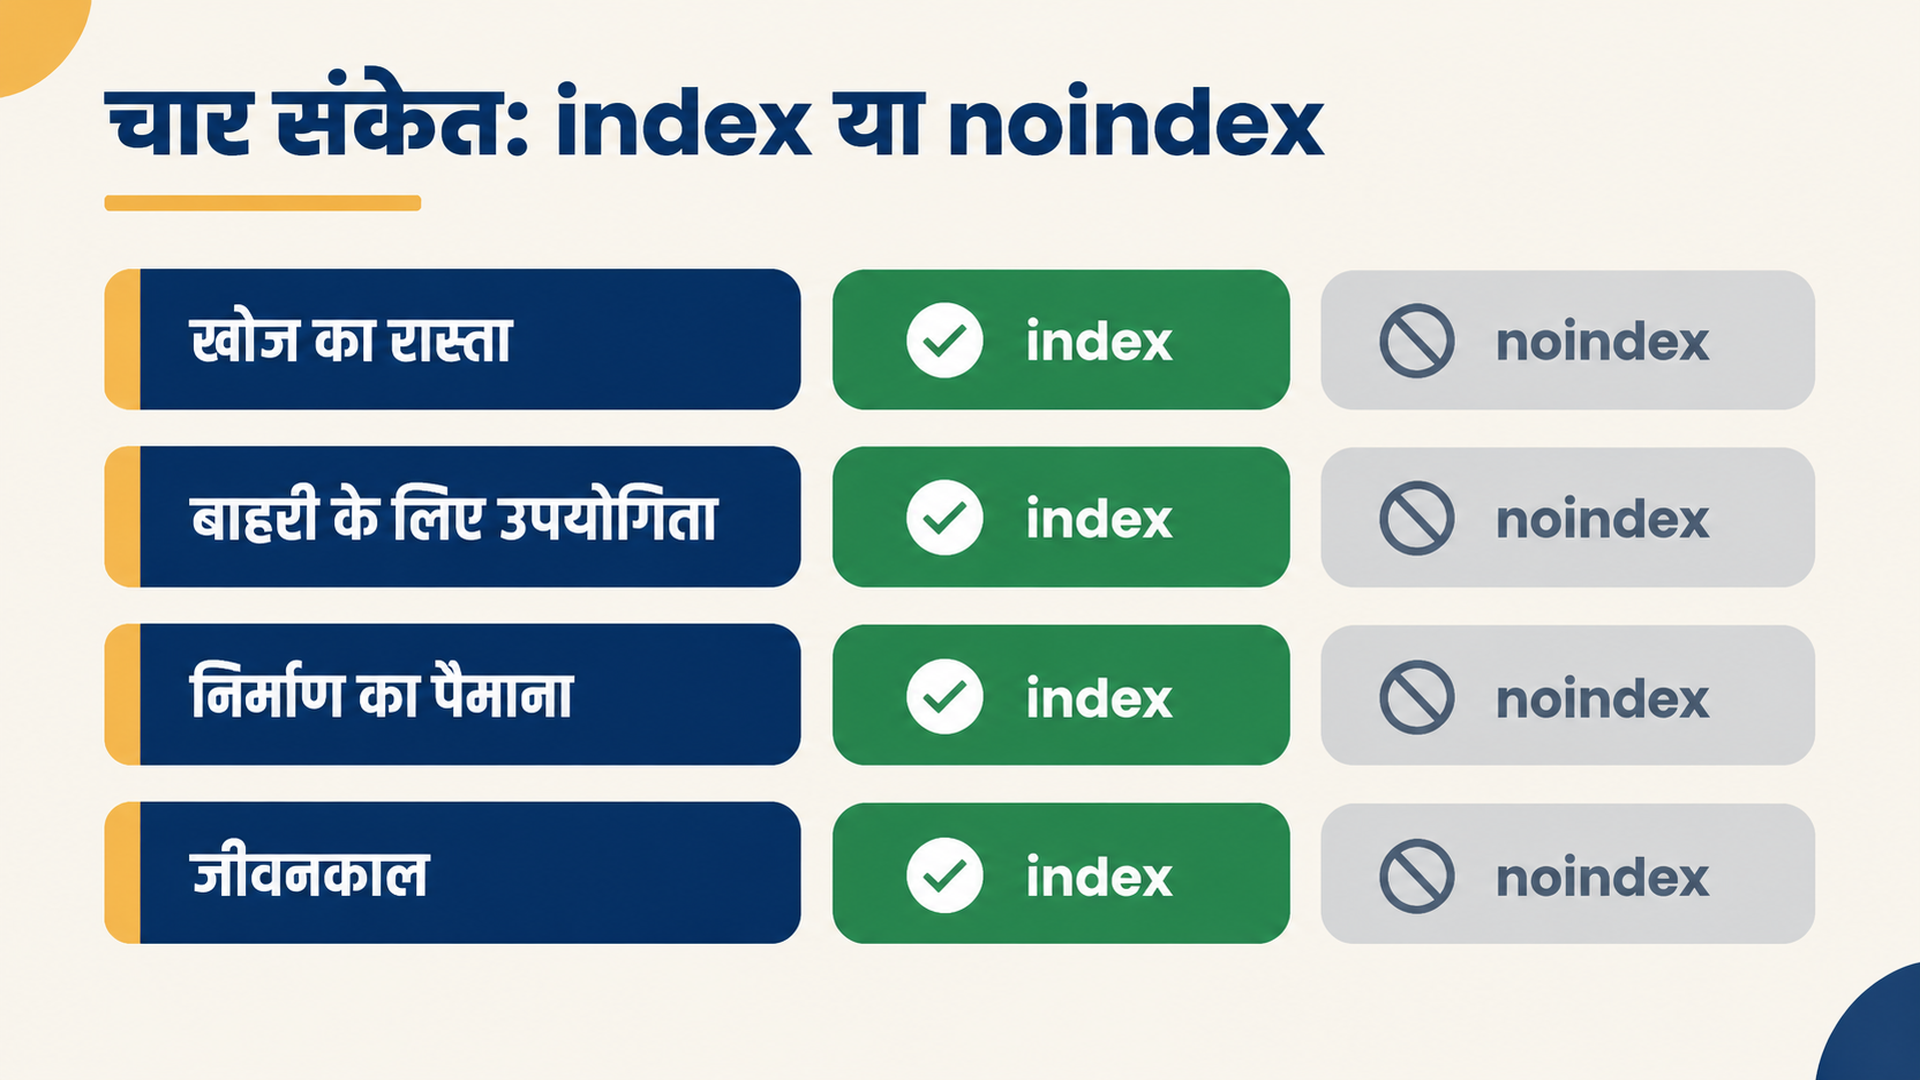
संकेत | index की ओर झुकाता है | noindex की ओर झुकाता है |
|---|---|---|
खोज का रास्ता | सार्वजनिक गैलरी, sitemap, कैटेगरी या प्रोफ़ाइल पेज से लिंक | सिर्फ़ कॉपी किए लिंक या "शेयर" बटन से पहुँच |
बाहरी व्यक्ति के लिए उपयोगिता | लेखक को जाने बिना भी काम की | सिर्फ़ लेखक, उसकी टीम या प्राप्तकर्ता के लिए मायने रखता है |
निर्माण का पैमाना | विषय पर एक पेज या चुना हुआ संग्रह | एक अकाउंट से हज़ारों URL, ज़्यादातर लगभग एक जैसे |
जीवनकाल | महीनों तक सही बना रहता है | पल भर का: चैट, बिल्ड, ड्राफ़्ट, अस्थायी एक्सपोर्ट |
चार में से तीन noindex की ओर — फ़ैसला साफ़ है। मिला-जुला नतीजा आम तौर पर मतलब है कि रूट को बाँटना होगा: एक इंडेक्स होने लायक सार्वजनिक गैलरी और उसके नीचे अलग नतीजे, जो इंडेक्स नहीं होंगे। यह बँटवारा सबसे आम सही जवाब है और साथ ही सबसे ज़्यादा छूटने वाला कदम, क्योंकि इसमें एक फ़्लैग की जगह दो टेम्पलेट चाहिए।
इनकार का एक काम का परीक्षण: अगर किसी बाहरी व्यक्ति को यह URL बिना संदर्भ के सर्च नतीजे में दिखे, तो क्या शीर्षक और स्निपेट उसके लिए समझ में आएँगे? "सम के साथ चैट, 24 अक्टू" — नहीं। "फ़्रीलांस डिज़ाइनरों के लिए इनवॉइस टेम्पलेट" — हाँ। इनकार गुणवत्ता के बारे में नहीं है। यह इस बारे में है कि पेज मिलने के लिए बना है या भेजे जाने के लिए।
वह कंट्रोल चुनिए जो सचमुच URL हटाता है
यहीं नई सलाह को शब्दशः मानकर भी असफल हुआ जा सकता है। Google एक ही वाक्य में दो विकल्प देता है, और वे बराबर नहीं हैं।
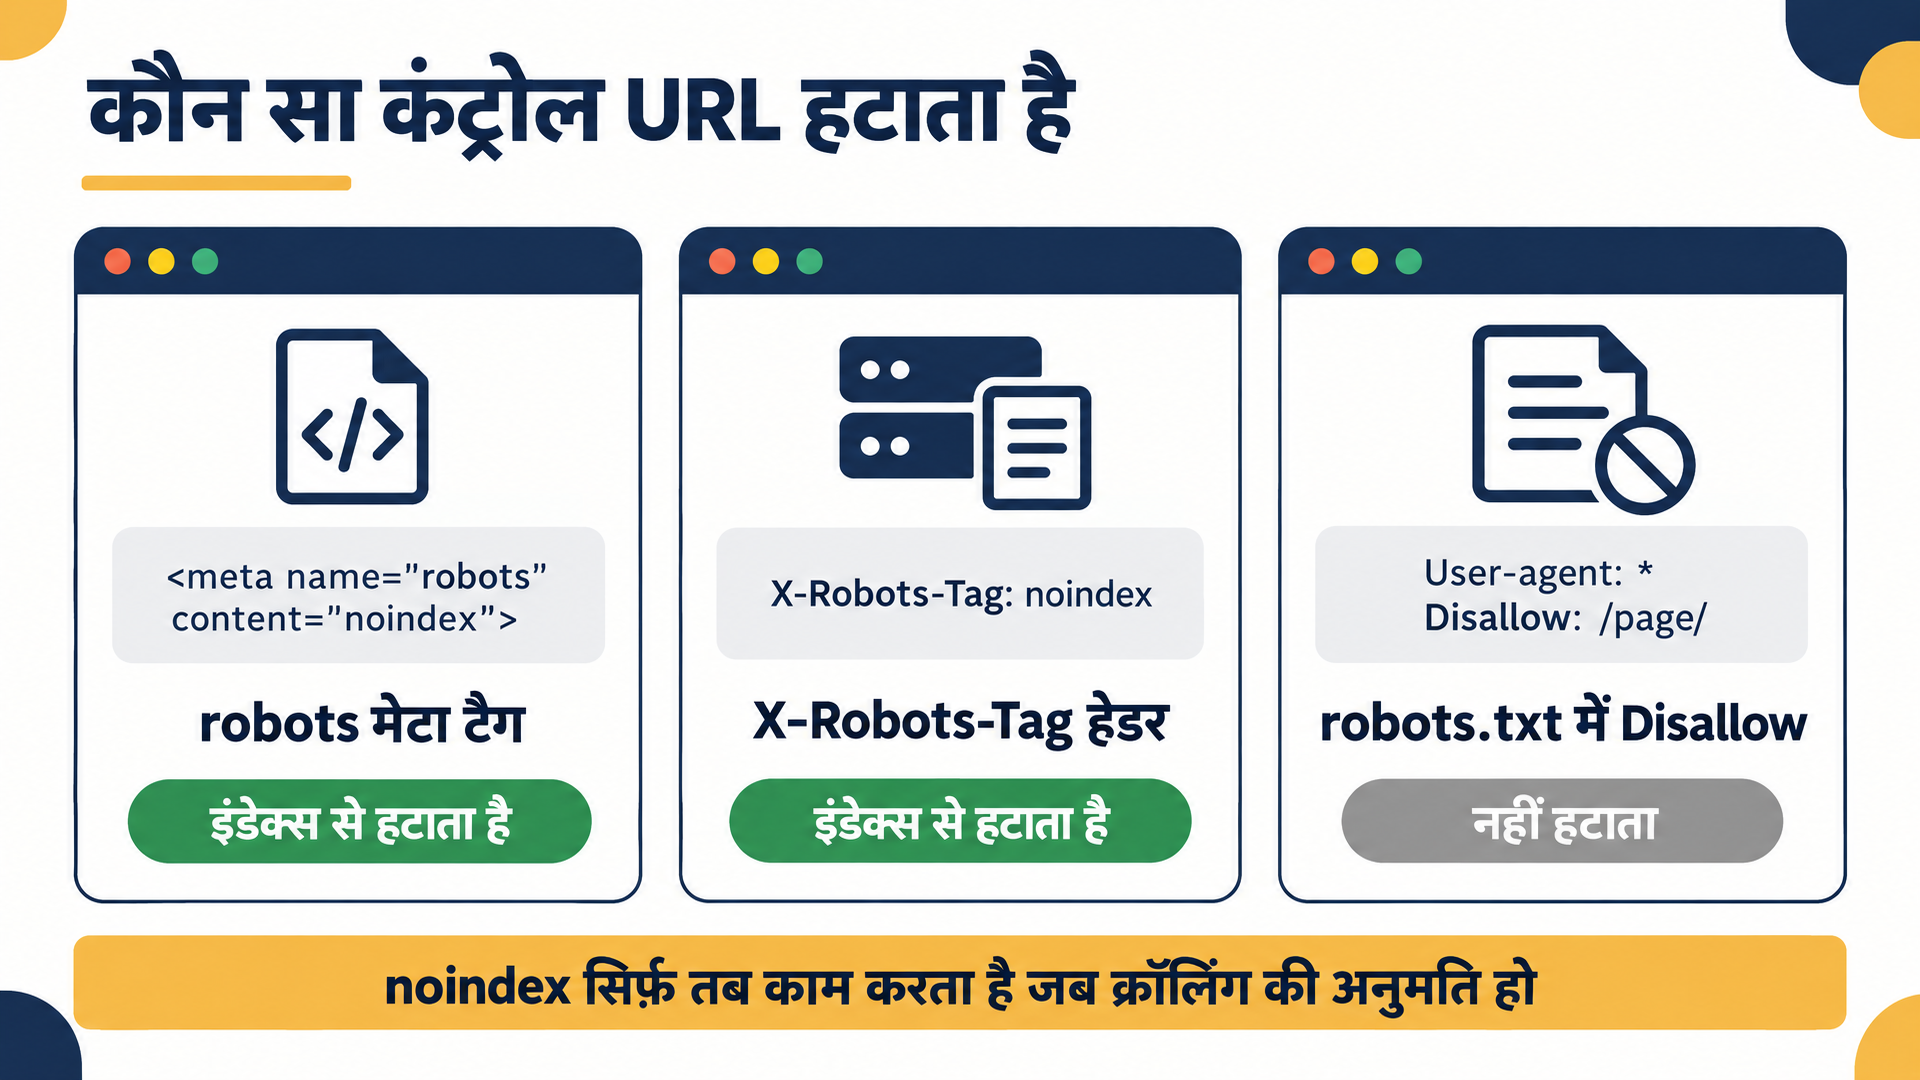
robots.txt क्रॉलिंग नियंत्रित करता है। यह URL को इंडेक्स से नहीं हटाता, और Google यह खुद robots.txt की भूमिका में कहता है: वहाँ ब्लॉक किया पेज "इंडेक्स रह सकता है अगर दूसरी साइटें उससे लिंक करती हैं" — और ऐसे में URL, और संभवतः लिंक टेक्स्ट, बिना विवरण के नतीजों में दिख सकता है।
noindex इंडेक्सिंग नियंत्रित करता है, लेकिन सिर्फ़ तब जब Google पेज को क्रॉल कर सके और निर्देश पढ़ सके। noindex पर Google का दस्तावेज़ साफ़ है: नियम काम करे, इसके लिए पेज robots.txt में ब्लॉक नहीं होना चाहिए, वरना "क्रॉलर noindex नियम कभी नहीं देखेगा"।
दोनों तथ्य जोड़िए — और क्रम मायने रखने लगता है।
कंट्रोल | URL को इंडेक्स से हटाता है | कहाँ विफल होता है | किसके लिए इस्तेमाल करें |
|---|---|---|---|
रिस्पॉन्स हेडर | हाँ, Google के क्रॉल और पढ़ने के बाद | जो कुछ robots.txt में ब्लॉक है या लॉगिन के पीछे है | गैर-HTML रिस्पॉन्स (PDF, JSON, तस्वीरें) और कई रूट के लिए एज या CDN नियम |
HTML head में | हाँ, Google के क्रॉल और पढ़ने के बाद | लोड होने के बाद JavaScript से डाले गए टैग; robots.txt में ब्लॉक पेज | सर्वर-साइड रेंडर होने वाले HTML शेयर पेज |
| नहीं | लिंक मिले URL बिना स्निपेट के इंडेक्स में रह सकता है | क्रॉल लोड घटाने के लिए, निजता के लिए नहीं |
लॉगिन या साइन किया URL | हाँ, पहुँच असंभव बनाकर | ज़रूरी है कि पेज सचमुच निजी हो | वह सब कुछ जिसमें दूसरों का डेटा है |
समय खत्म होने पर 410 | हाँ, समय के साथ | 404 से धीमा; जब तक URL जवाब देता है, काम नहीं करता | क्षणिक शेयर और बिल्ड |
एक छोटा रास्ता जिससे बचना चाहिए: X-Robots-Tag: none कोई तटस्थ मान नहीं है। Google इसे noindex और nofollow दोनों मानता है। कभी-कभी यही चाहिए भी होता है, लेकिन टीमें इसे प्रॉक्सी कॉन्फ़िग से कॉपी कर लेती हैं, यह जाने बिना।
दूसरा छोटा रास्ता जिससे बचना चाहिए: canonical टैग। Canonical एक संकेत है। अगर पेज इंडेक्स में नहीं होना चाहिए, तो noindex लिखिए।
कदम 1: उन रूट की सूची बनाइए जो URL बनाते हैं
जो सूची में नहीं है उसे वर्गीकृत नहीं किया जा सकता, और ज़्यादातर टीमें संख्या कम आँकती हैं क्योंकि वे फ़ीचर सोचती हैं, रूट पैटर्न नहीं।
राउटर या URL मैप खोलिए और हर डायनामिक सेगमेंट लिखिए। आम संदिग्ध ऐसे दिखते हैं:
/s/:id,/share/:id,/p/:token/chat/:id,/conversation/:id,/thread/:id/u/:handle,/profile/:handle/app/:id,/build/:id,/project/:id/r/:slug,/preview/:token,/report/:id
फिर Google जो पहले से जानता है उससे मिलाइए, क्योंकि कोड और इंडेक्स अलग-अलग हो जाते हैं।
sitemap से। डाउनलोड कीजिए और गिनिए:
curl -s https://example.com/sitemap.xml | grep -c "<loc>"
curl -s https://example.com/sitemap.xml | grep -oE "https://[^<]+" | sed -E 's#https://[^/]+##' | cut -d/ -f2 | sort | uniq -c | sort -rn
दूसरी कमांड पथ-प्रीफ़िक्स के हिसाब से अनुमानित हिस्टोग्राम देती है। अगर कोई जनरेट किया रूट आपके sitemap में है, तो यह अपने आप में ग़लती है: sitemap उन पेजों की सूची है जिन्हें आप Google से इंडेक्स करने को कह रहे हैं।
Search Console से। Page indexing रिपोर्ट खोलिए, हर संभावित रूट के URL-प्रीफ़िक्स से फ़िल्टर कीजिए और संख्याएँ लिख लीजिए। यही एक ऐसा स्रोत है जो बताता है कि Google ने उन URL के साथ असल में क्या किया।
सर्वर लॉग से। Googlebot की रिक्वेस्ट प्रीफ़िक्स के हिसाब से समूहित कीजिए:
grep -i "Googlebot" access.log | awk '{print $7}' | cut -d/ -f2 | sort | uniq -c | sort -rn | head -20अपेक्षित नतीजा। रूट पैटर्न की सूची, साथ में URL की संख्या, कम से कम दो स्रोतों से ली गई।
गुणवत्ता जाँच। हर वह रूट जो टीम के बाहर के किसी को 200 लौटा सकता है, सूची में होना चाहिए। अगर एक ही प्रीफ़िक्स पर sitemap और Search Console की संख्याएँ कुछ प्रतिशत से ज़्यादा अलग हैं, तो कुछ बदलने से पहले कारण पता कीजिए।
अगर कुछ नहीं मिला। संभवतः आपका राउटर क्लाइंट-साइड है। रूट परिभाषाएँ फ़्रंटएंड में खोजिए, बैकएंड में नहीं, और किसी असली शेयर लिंक पर नेटवर्क टैब देखिए।
कदम 2: हर रूट का वर्गीकरण तालिका में कीजिए, मीटिंग में नहीं
फ़ैसला वहाँ लिखिए जहाँ इसे पढ़ा जा सके। हर रूट पैटर्न के लिए एक पंक्ति काफ़ी है।
रूट | कौन बनाता है | खोज का रास्ता | बाहरी व्यक्ति के लिए उपयोगिता | फ़ैसला | कंट्रोल | मालिक |
|---|---|---|---|---|---|---|
| कोई भी उपयोगकर्ता | सिर्फ़ लिंक | कोई नहीं | noindex | हेडर | प्लेटफ़ॉर्म |
| क्यूरेशन | आंतरिक लिंक, sitemap | ऊँची | index | कोई नहीं | कंटेंट |
| कोई भी उपयोगकर्ता | प्रोफ़ाइल से लिंक | कम, जब तक सक्रिय न हो | प्रतिष्ठा बनने तक noindex | मेटा | ट्रस्ट और सेफ़्टी |
| कोई भी उपयोगकर्ता | सिर्फ़ लिंक | कोई नहीं | noindex | हेडर | प्लेटफ़ॉर्म |
| एडिटर | sitemap | ऊँची | index | कोई नहीं | कंटेंट |
तालिका तभी काम करती है जब तीन बातें सच हों।
हर पंक्ति का एक ज़िम्मेदार व्यक्ति। धुँधली ज़िम्मेदारी ही वजह है कि जनरेट किए रूट सालों तक इंडेक्स में बने रहते हैं।
कंट्रोल फ़ैसले के बगल में लिखिए, बाद में नहीं। जब तक किसी को पता न हो कि हेडर है, टेम्पलेट बदलाव है या CDN नियम, तब तक "noindex" कोई फ़ैसला नहीं है।
अपवाद नोट कीजिए। अगर कोई रूट noindex होना चाहिए, लेकिन एक छोटा हिस्सा सार्वजनिक रहे, तो उस हिस्से की शर्त अभी लिख लीजिए। छह महीने बाद इसे काटना वही रास्ता है जिससे noindex नियम आख़िर में पूरा ही हट जाता है, चुपचाप।
कदम 3: कंट्रोल को टेम्पलेट स्तर पर लगाइए
पेज-दर-पेज सुधार अगली डिप्लॉयमेंट तक ही टिकते हैं। कंट्रोल वहाँ लगाइए जहाँ रूट रेंडर होता है।
HTML पेजों के लिए टैग सर्वर-रेंडर किए head में रखिए। Next.js App Router में यह metadata है; Astro में लेआउट का head; Rails या Django में लेआउट टेम्पलेट। सटीक सिंटैक्स से ज़्यादा जगह मायने रखती है: यह उसी HTML में होना चाहिए जो Google को मिलता है, क्लाइंट-साइड इफ़ेक्ट से जोड़ा हुआ नहीं।
<meta name="robots" content="noindex">जो HTML नहीं है, उसके लिए मेटा टैग नहीं होता, तो हेडर इस्तेमाल कीजिए:
X-Robots-Tag: noindexइसमें PDF एक्सपोर्ट, JSON रिस्पॉन्स, जनरेट की गई तस्वीरें और CSV डाउनलोड आते हैं। अगर ये फ़ाइलें CDN से मिलती हैं, तो हेडर एज पर सेट कीजिए ताकि नए रूट नियम विरासत में पाएँ।
रूट के पूरे परिवार के लिए हर टेम्पलेट छूने से मिडलवेयर नियम आम तौर पर साफ़ होता है:
// Express उदाहरण: सभी जनरेट किए शेयर URL पर noindex
app.use(['/s', '/share', '/report'], (req, res, next) => {
  res.set('X-Robots-Tag', 'noindex');
  next();
});
अपेक्षित नतीजा। ऐसी डिप्लॉयमेंट जिसमें noindex चिह्नित हर रूट अनाम रिक्वेस्ट के पहले बाइट में निर्देश लौटाता है।
गुणवत्ता जाँच। पब्लिश किए URL पर curl -sI चलाइए। रिस्पॉन्स हेडर में x-robots-tag: noindex दिखना चाहिए, और curl -s को किसी स्क्रिप्ट चलने से पहले सोर्स में मेटा टैग दिखाना चाहिए।
वापसी का रास्ता। अगर टैग JavaScript चलने के बाद ही आता है, तो उसे सर्वर-साइड रेंडरिंग में ले जाइए। अगर फ़्रेमवर्क हर रूट के लिए head टैग रेंडर नहीं करता, तो हेडर इस्तेमाल कीजिए। JS से डाला noindex पब्लिश मत कीजिए और मत मानिए कि वह काम करता है: Google रेंडर किए noindex के व्यवहार को अनिर्धारित बताता है।
उसी pull request में दो और चीज़ें हैं। noindex वाले रूट sitemap से हटाइए, क्योंकि जिस URL को आप इंडेक्स नहीं करना चाहते उसे भेजना विरोधाभास है, और Google उसे अपने पक्ष में सुलझाएगा। और समाप्ति का नियम जोड़िए: जब शेयर लिंक मर जाए, तो खाली अवस्था के साथ 200 रखने की जगह 410 लौटाइए।
कदम 4: जाँचिए कि Googlebot को निर्देश दिखता है
ऊपर का कुछ भी सत्यापित नहीं है जब तक आप इसे वैसे न जाँचें जैसे Google जाँचता है।
पहले रिस्पॉन्स हेडर देखिए:
curl -sI https://example.com/s/abc123 | grep -i x-robots-tagफिर सोर्स HTML, किसी स्क्रिप्ट के चलने से पहले:
curl -s https://example.com/s/abc123 | grep -i 'name="robots"'आख़िर में जाँचिए कि robots.txt पथ को ब्लॉक नहीं कर रहा। अगर कर रहा है, तो Google पेज कभी क्रॉल नहीं करेगा और निर्देश कभी नहीं पढ़ेगा:
curl -s https://example.com/robots.txtSearch Console अंतिम जाँच है। URL Inspection टूल में URL जाँच का अनुरोध कीजिए और फ़ैसला पढ़िए।
सही नतीजा है "URL इंडेक्स नहीं है: 'noindex' टैग द्वारा बाहर रखा गया"। जो नतीजा जाल दिखाता है वह है "इंडेक्स किया गया, लेकिन robots.txt द्वारा ब्लॉक किया गया": Google के पास URL है, निर्देश पढ़ नहीं सकता और उसे दिखाता रह सकता है। अगर यह दिखे, तो robots.txt से नियम हटाइए और noindex को काम करने दीजिए।
आप Googlebot की नज़र से पेज क्रॉलर सिम्युलेटर से भी ले सकते हैं। बीस रूट जाँचते समय नई क्रॉलिंग का इंतज़ार करने से यह तेज़ है: Googlebot Spider Simulator।
अपेक्षित नतीजा। noindex वाला हर रूट अगली क्रॉलिंग के कुछ दिनों में noindex वजह से बाहर रखे जाने की स्थिति दिखाता है। बदलाव के बाद बने रूट इंडेक्स में आने ही नहीं चाहिए।
वापसी का रास्ता। अगर दो हफ़्ते बाद भी URL इंडेक्स है, तो जाँचिए कि Google उसे क्रॉल कर सकता है या नहीं, पेज Googlebot को 200 लौटाता है या नहीं, और कोई canonical या hreflang टैग सर्च इंजन को कहीं और तो नहीं भेज रहा। Removal टूल सिर्फ़ अस्थायी रोक के तौर पर इस्तेमाल कीजिए, जब तक असली वजह ठीक हो; वह निर्देश की जगह नहीं लेता।
जब शेयर पेज ही ग्रोथ चैनल हो
कुछ जनरेट किए पेज सचमुच इंडेक्स होने चाहिए, और सब पर noindex अपने ही पैर पर कुल्हाड़ी मारना है। ये वे हैं जिन्हें बचाना चाहिए:
पैटर्न | इंडेक्स के लायक क्यों है | सुरक्षा-कवच |
|---|---|---|
सार्वजनिक टेम्पलेट गैलरी | उपयोगकर्ता डिज़ाइन पब्लिश करते हैं, दूसरे उसे इस्तेमाल करते हैं; नतीजा अनोखा और टिकाऊ है | नए सबमिशन पर मॉडरेशन |
सार्वजनिक शोकेस पेज वाले बिल्डर | "built with" निशान के साथ असली नतीजा वितरण का चैनल है | शोकेस टेम्पलेट को मार्केटिंग पेज से अलग रखिए |
उपयोगकर्ता थ्रेड से निकली डॉक्युमेंटेशन | बार-बार आने वाला सवाल स्थायी और संपादित जवाब का हक़दार है | क्यूरेट किए जवाब को इंडेक्स कीजिए, कच्ची बातचीत को नहीं |
अगर आप इनमें से किसी श्रेणी में हैं, तो Google की पुरानी सलाह अब भी लागू है और सबसे अच्छा लीवर है: बिना प्रतिष्ठा वाले उपयोगकर्ता कंटेंट पर noindex, फिर अकाउंट का इतिहास बनने पर खोल देना। यह एंगेजमेंट लूप छोड़े बिना स्पैम के प्रति टिकाऊपन देता है, और यही पैटर्न इस अपडेट से पहले गाइड सुझाती थी।
तीनों के लिए परीक्षण एक ही है। अगर पेज को Search performance में उन क्वेरी पर इंप्रेशन मिल रहे हैं जो कोई बाहरी व्यक्ति टाइप करेगा, तो वह इंडेक्स का हक़दार है। अगर इंप्रेशन सिर्फ़ उसके अपने URL स्ट्रिंग से आ रहे हैं और कहीं और से नहीं, तो नहीं है।
एक दूसरे दर्जे का असर भी है जिसे नाम देना चाहिए। सार्वजनिक शेयर URL सालों से लिंक की सस्ती सतह रहे हैं: किसी मज़बूत डोमेन वाले प्लेटफ़ॉर्म पर पेज बनाइए, अपनी साइट पर लिंक लगाइए, बीस प्रॉपर्टी पर दोहराइए। Patrick Stox ने उसी थ्रेड में अलग-अलग प्लेटफ़ॉर्म से 20 से ज़्यादा लिंक गिने। अगर प्लेटफ़ॉर्म सलाह मानते हैं, तो यह सतह सिकुड़ेगी। नहीं मानते, तो Google के पास अब एक दस्तावेज़ है जिसका हवाला अगली बार दे सकता है जब वह इन पेजों को स्पैम ठहराए।
कदम 5: जिस पैटर्न का Google ने ज़िक्र किया, उसे नापिए
मॉनिटरिंग वाला सेक्शन अपडेट का वह हिस्सा है जिसे ज़्यादातर टीमें छोड़ देंगी, और ठीक वही जो असली घटना को मैन्युअल कार्रवाई बनने से पहले पकड़ता है।
चार जाँचें, हर एक के साथ देखने की जगह।
Search Console प्रॉपर्टी। साइट या सबडोमेन सत्यापित कीजिए ताकि मैन्युअल कार्रवाई और सुरक्षा चेतावनियाँ ईमेल पर आएँ। अगर आप ऐसा प्लेटफ़ॉर्म चलाते हैं जहाँ हर किरायेदार का सबडोमेन है, तो पैरेंट और कम से कम कुछ बच्चे सत्यापित कीजिए; जो चेतावनी कहीं नहीं पहुँचती वह मॉनिटरिंग नहीं है।
Page indexing ट्रेंड। आज हर जनरेट किए रूट के इंडेक्स किए URL की बेसलाइन लिखिए और शोर की जगह सीढ़ीनुमा बदलाव देखिए। जिस रूट पर स्थिर रहना चाहिए, वहाँ एक हफ़्ते में इंडेक्स किए URL का दोगुना होना संकेत है।
Search performance में विसंगति। गैर-प्रोडक्ट क्वेरी से फ़िल्टर कीजिए। स्पैम पेज स्पैम क्वेरी खींचते हैं, उससे बहुत पहले कि कोई शिकायत करे।
निर्माण बनाम इंडेक्सिंग अनुपात। यह वह मीट्रिक है जिसका Google नाम लेता है और जिसे लगभग कोई नहीं मापता: एक अकाउंट एक दिन में कितने इंडेक्स हो सकने वाले URL बना सकता है, और नए ऐसे URL का कितना हिस्सा 1% सबसे ज़्यादा उत्पादक अकाउंट से आता है। अकाउंट के लिए पिछले सात दिनों के 3 मीडियन पर चेतावनी-सीमा मनमानी है पर काम करती है; इसे अपने ट्रैफ़िक के हिसाब से सेट कीजिए।
यही अनुपात प्रोडक्ट गार्ड-रेल के तौर पर भी काम करता है। अगर कोई फ़ीचर उपयोगकर्ता को दिन में हज़ार इंडेक्स होने लायक URL बनाने देता है, तो वह इंडेक्स फुलाने वाला फ़ीचर है, भले ही अभी किसी ने दुरुपयोग न किया हो।
यह अपडेट असल में क्या कह रहा है
शब्दजाल हटाइए — और Google एक प्रस्ताव पर बहस कर रहा है।
बीस साल से स्पैम नीति पेजों को बयान करती थी: पतले, स्क्रैप किए, छिपाए गए, कीवर्ड से भरे। ये श्रेणियाँ मानती हैं कि कोई इंसान या स्क्रिप्ट पेज बनाने का फ़ैसला करता है, और Google तय करता है कि वह रैंकिंग का हक़दार है या नहीं। जनरेट किए नतीजे यह मॉडल तोड़ देते हैं। एक प्रोडक्ट फ़ैसला दस लाख URL बना सकता है, सब तकनीकी रूप से अनोखे, सब तकनीकी रूप से 200, ज़्यादातर उन लोगों के लिए बेकार जिन्होंने उन्हें नहीं बनाया। Google इन्हें एक-एक करके आँक नहीं सकता और उसने यह दिखाना छोड़ दिया है कि आँक सकता है।
प्रतिक्रिया दो खेमों में बँटी। पहले ने इसे चेतावनी की गोली पढ़ा: Marie Haynes ने पूछा कि AI टूल और ऐप बिल्डर के लिए नई मैन्युअल कार्रवाइयाँ आएँगी या नहीं, और Lily Ray ने सेक्शन को इस संकेत के रूप में लिया कि Google पहले से ही पैमाने पर इससे लड़ रहा है, Claude आर्टिफ़ैक्ट, ChatGPT शेयर पेज और सोशल पोस्ट का ज़िक्र करते हुए। दूसरे ने कंधे उचकाए। सावधान टीमें सालों से उपयोगकर्ता-जनित रिपोर्ट पर noindex लगाती रही हैं, कई जवाबों ने तर्क दिया, और Google के अपने जनरेट किए पेज बड़ी समस्या हैं। दोनों पाठ सच हो सकते हैं। सलाह को मायने देती यह बात नहीं कि वह नई है, बल्कि यह कि वह अब ऐसी जगह लिखी है जिसका हवाला नीति लागू करते समय दिया जा सकता है।
तो सलाह फ़ैसला श्रृंखला में ऊपर ले जाती है। प्लेटफ़ॉर्म से टेम्पलेट स्तर का निर्णय अपेक्षित है: URL की कौन सी श्रेणी इंडेक्स में है। यह अभिशासन का सवाल है, SEO का नहीं, और इसीलिए यह सलाह इंडेक्सिंग दस्तावेज़ के बजाय स्पैम गाइड में गई।
AI सर्च के लिए वही तर्क दोनों दिशाओं में लागू होता है। Google की AI सुविधाएँ Google के इंडेक्स से लेती हैं, तो noindex निर्देश पेज को पूल से और नीले लिंक से भी हटा देता है। अगर कोई जनरेट किया पेज AI Overviews में उद्धरण जोड़ रहा था, तो उम्मीद कीजिए कि यह रुकेगा। शेयर लिंक के लिए यह आम तौर पर सही है, टेम्पलेट पेज के लिए नहीं। दूसरे AI क्रॉलर के अपने नियम हैं, तो अलग से तय कीजिए कि उनमें से किसे इन पेजों को क्रॉल करने देना है।
काम का निष्कर्ष एक वाक्य है जिसे डिज़ाइन समीक्षा में ले जाया जा सकता है: उपयोगकर्ता जो भी URL बना सकता है, वह या प्रोडक्ट की सतह है या इंडेक्स के प्रति एक दायित्व, और यह टेम्पलेट तय करता है।
अक्सर पूछे जाने वाले सवाल
क्या यह आम मार्केटिंग साइट पर लागू होता है?
नहीं, अगर आपकी साइट उपयोगकर्ता इनपुट से URL नहीं बनाती। मार्केटिंग साइट पेजों का ऐसा समूह पब्लिश करती है जिन्हें किसी इंसान ने तय किया है कि उन्हें होना चाहिए — गाइड में बताई गई समस्या का उल्टा। पैमाने वाली पंक्ति होस्टिंग प्लेटफ़ॉर्म और वे टूल गिनाती है जो उपयोगकर्ताओं को शेयर करने के लिए पेज, जनरेट किया गया कंटेंट या वेब ऐप पब्लिश करने देते हैं। अगर आपके पास कमेंट, फ़ोरम या सदस्य प्रोफ़ाइल हैं, तो पुरानी सलाह लागू है: अविश्वसनीय अकाउंट के लिंक पर nofollow या ugc, और नए उपयोगकर्ताओं पर noindex जब तक वे प्रतिष्ठा न बनाएँ।
robots.txt इस्तेमाल करें या noindex मेटा टैग?
noindex, और एक रूट पर दोनों में से सिर्फ़ एक। Google का वाक्य दोनों विकल्प गिनाता है, लेकिन वे अलग-अलग काम करते हैं। robots.txt में Disallow क्रॉलिंग रोकता है, और बाहर से लिंक मिला ब्लॉक किया URL बिना स्निपेट के नतीजों में रह सकता है। noindex सिर्फ़ तब काम करता है जब Google पेज क्रॉल कर सके और पढ़ सके। व्यवहार में इसका मतलब है मेटा टैग या रिस्पॉन्स हेडर, और उसी पथ पर कभी robots.txt नियम नहीं।
शेयर पेज पर noindex लगाने से ट्रैफ़िक चला जाएगा?
फ़ैसले से पहले रूट जाँचिए, बाद में नहीं। अगर पेज को इंप्रेशन सिर्फ़ उसके अपने URL स्ट्रिंग से मिलते हैं, तो वह ऑर्गेनिक ट्रैफ़िक नहीं लाता और उसे हटाने में कुछ नहीं जाता। ट्रैफ़िक खोने वाला पैटर्न यह है कि सार्वजनिक गैलरी के साथ उसके अंदर का सब कुछ भी गिरा दिया जाए। गैलरी इंडेक्स में रहने दीजिए, उसके नीचे के हिस्से पर noindex लगाइए, और बदलाव से पहले और बाद में गैलरी क्वेरी के Search performance की निगरानी कीजिए।
क्या AI सर्च इंजन noindex मानते हैं?
Google की AI सुविधाएँ हाँ, क्योंकि AI Overviews और AI Mode उसी इंडेक्स से लेते हैं, तो निर्देश पेज को नीले लिंक से और AI जवाबों से भी हटा देता है। दूसरे AI क्रॉलर अलग फ़ैसला है। प्रदाताओं का व्यवहार अलग-अलग है और चेंजलॉग के बिना बदलता है, तो हर क्रॉलर का दस्तावेज़ पढ़िए और उसके user agent से पेज लाइए, यह मानने की जगह कि एक निर्देश सबको कवर करता है।
लेखिका: Grace Miller, Auspia में AI Search जोखिम विश्लेषक। 200 से अधिक नीति बदलावों पर नज़र रखती हैं। प्लेटफ़ॉर्म नियम, कंटेंट जोखिम और नीति-सचेत ऑप्टिमाइज़ेशन पर लिखती हैं।