अगर किसी ने पूछा है कि आपका ब्रांड ChatGPT में दिखता है या नहीं, तो पहला ईमानदार जवाब यह है कि खाली नतीजा और असली शून्य एक जैसे दिखते हैं, जब तक आप एक चीज़ जाँच न लें। यह गाइड उनके लिए है जिन्हें यह जवाब बिना किसी मॉनिटरिंग प्लेटफ़ॉर्म के देना है, सिर्फ़ एक चैट विंडो, एक स्प्रेडशीट और क़रीब तीस मिनट के साथ।
आख़िर में आपके पास हर प्रॉम्प्ट का एक फ़ैसला होगा, एक दोहराने योग्य रिकॉर्ड जिसे आप मीटिंग में रख सकते हैं, और एक शेड्यूल किया हुआ जॉब जो उसे ताज़ा रखता है। पूरा होने की शर्त सीधी है: हर प्रॉम्प्ट के लिए आप बता सकते हैं कि जवाब स्रोत-आधारित था या नहीं, उसने ब्रांड का नाम लिया या नहीं, और उसने साइट लिंक की या नहीं।
पूरा होने पर आपके पास क्या होगा
नतीजा | कहाँ रहता है |
|---|---|
असली बातचीत से लिखी 8 से 12 प्रॉम्प्ट की सूची | आपकी स्प्रेडशीट का पहला टैब |
हर प्रॉम्प्ट के लिए चार फ़ील्ड और मॉडल वर्शन वाली एक पंक्ति | वही टैब |
हर प्रॉम्प्ट के लिए चार में से एक फ़ैसला, साथ में जुड़ी कार्रवाई | फ़ैसले का कॉलम |
कम से कम दो प्रॉम्प्ट का दोहराव | उसी स्प्रेडशीट की पंक्ति 2 और 3 |
तय मूल्यांकन मानदंड वाली शेड्यूल की हुई जाँच | आपके एजेंट का प्रोजेक्ट फ़ोल्डर |
पहले से ज़रूरी: वेब सर्च के साथ ChatGPT तक पहुँच, एक स्प्रेडशीट, और अगर आप इसे ऑटोमेट करते हैं तो दस प्रॉम्प्ट के एक रन पर क़रीब 0.29 डॉलर खर्च करने की क्षमता।
चरण 1: प्रॉम्प्ट बातचीत से लिखें, कीवर्ड से नहीं
सेल्स टीम ने जिन आख़िरी बीस सवालों के जवाब दिए, उन्हें निकालें और समूह बनाएँ। बीस प्रॉम्प्ट के हमारे अध्ययन में सबसे चौड़ी स्रोत-सूची उस सवाल से आई कि आपका हवाला कैसे दिया जाए, और सबसे संकरी सूची दो टूल की सीधी तुलना से आई, यानी सवाल का रूप तय करता है कि आपको कितना डेटा वापस मिलेगा।
प्रॉम्प्ट को चार रूपों में लिखें: श्रेणी ("Y के लिए सबसे अच्छा X"), तुलना ("A बनाम B"), समस्या ("मुझे कैसे पता चले कि AI मेरी कंपनी को जानता है") और प्रमाण ("2026 में X की सिफ़ारिश कौन करता है")। दो ऐसे प्रॉम्प्ट जोड़ें जो सीधे आपके ब्रांड का नाम लें, क्योंकि उनका व्यवहार श्रेणी वाले प्रॉम्प्ट से अलग होता है। अगर उसी सूची के लिए कई सतहों का प्रमाण चाहिए, तो AI दृश्यता चेकर का विश्लेषण दिखाता है कि वही प्रॉम्प्ट तीन सतहों पर जाने पर क्या बदलता है।
नतीजा: 8 से 12 प्रॉम्प्ट की अंतिम सूची, हर एक अपने रूप के साथ चिह्नित। गुणवत्ता जाँच: हर प्रॉम्प्ट वह होना चाहिए जो कोई ग्राहक सचमुच टाइप करे। अगर कोई प्रॉम्प्ट सिर्फ़ इसलिए है कि उसमें कोई कीवर्ड है, तो उसे हटा दें।
चरण 2: और कुछ भी पढ़ने से पहले वैधता द्वार पार करें
यही वह चरण है जिसे ज़्यादातर जाँचें छोड़ देती हैं, और यही वजह है कि खाली नतीजे शून्य बताए जाते हैं। हमारे रन में ChatGPT ने 20 में से 8 प्रॉम्प्ट पर सर्च क्वेरी भेजीं और बाक़ी 12 का जवाब याद से दिया।
हमने क्या देखा | स्रोत-आधारित जवाब (8 प्रॉम्प्ट) | ग़ैर-स्रोत-आधारित जवाब (12 प्रॉम्प्ट) |
|---|---|---|
भेजी गई सर्च क्वेरी | हर प्रॉम्प्ट पर 4 से 8 | 0 |
लौटाए गए स्रोत नोट | 6 से 18, माध्यिका 12 | 0 |
हवाला दिए गए अलग डोमेन | 4 से 10, माध्यिका 7 | 0 |
टेक्स्ट में अब भी नाम लिए गए ब्रांड | हाँ | हाँ, कुल 20 में से 13 प्रॉम्प्ट पर |
अपने ब्रांड के बारे में कुछ भी दर्ज करने से पहले हर प्रॉम्प्ट चलाएँ और एक सवाल का जवाब दें: क्या मॉडल ने कुछ खोजा? ChatGPT के इंटरफ़ेस में संकेत जवाब के नीचे दी गई स्रोत-सूची है। अगर स्रोत-सूची नहीं है, तो जवाब याद से आया है, और आपके ब्रांड के बारे में उसकी चुप्पी का अभी कोई मतलब नहीं है।
नतीजा: स्रोत-आधार कॉलम में हर प्रॉम्प्ट के लिए हाँ या नहीं। गुणवत्ता जाँच: बिना स्रोत-सूची वाला जवाब कभी दृश्यता संकेत के तौर पर दर्ज नहीं होता, सिर्फ़ याद के संकेत के तौर पर। हमारे ग़ैर-स्रोत-आधारित जवाब छोटे भी नहीं थे: आउटपुट टोकन की माध्यिका 1,730 रही, जबकि स्रोत-आधारित जवाबों में 1,645, यानी लंबाई काम का संकेत नहीं है।
चरण 3: चार फ़ील्ड दर्ज करें, एक नहीं
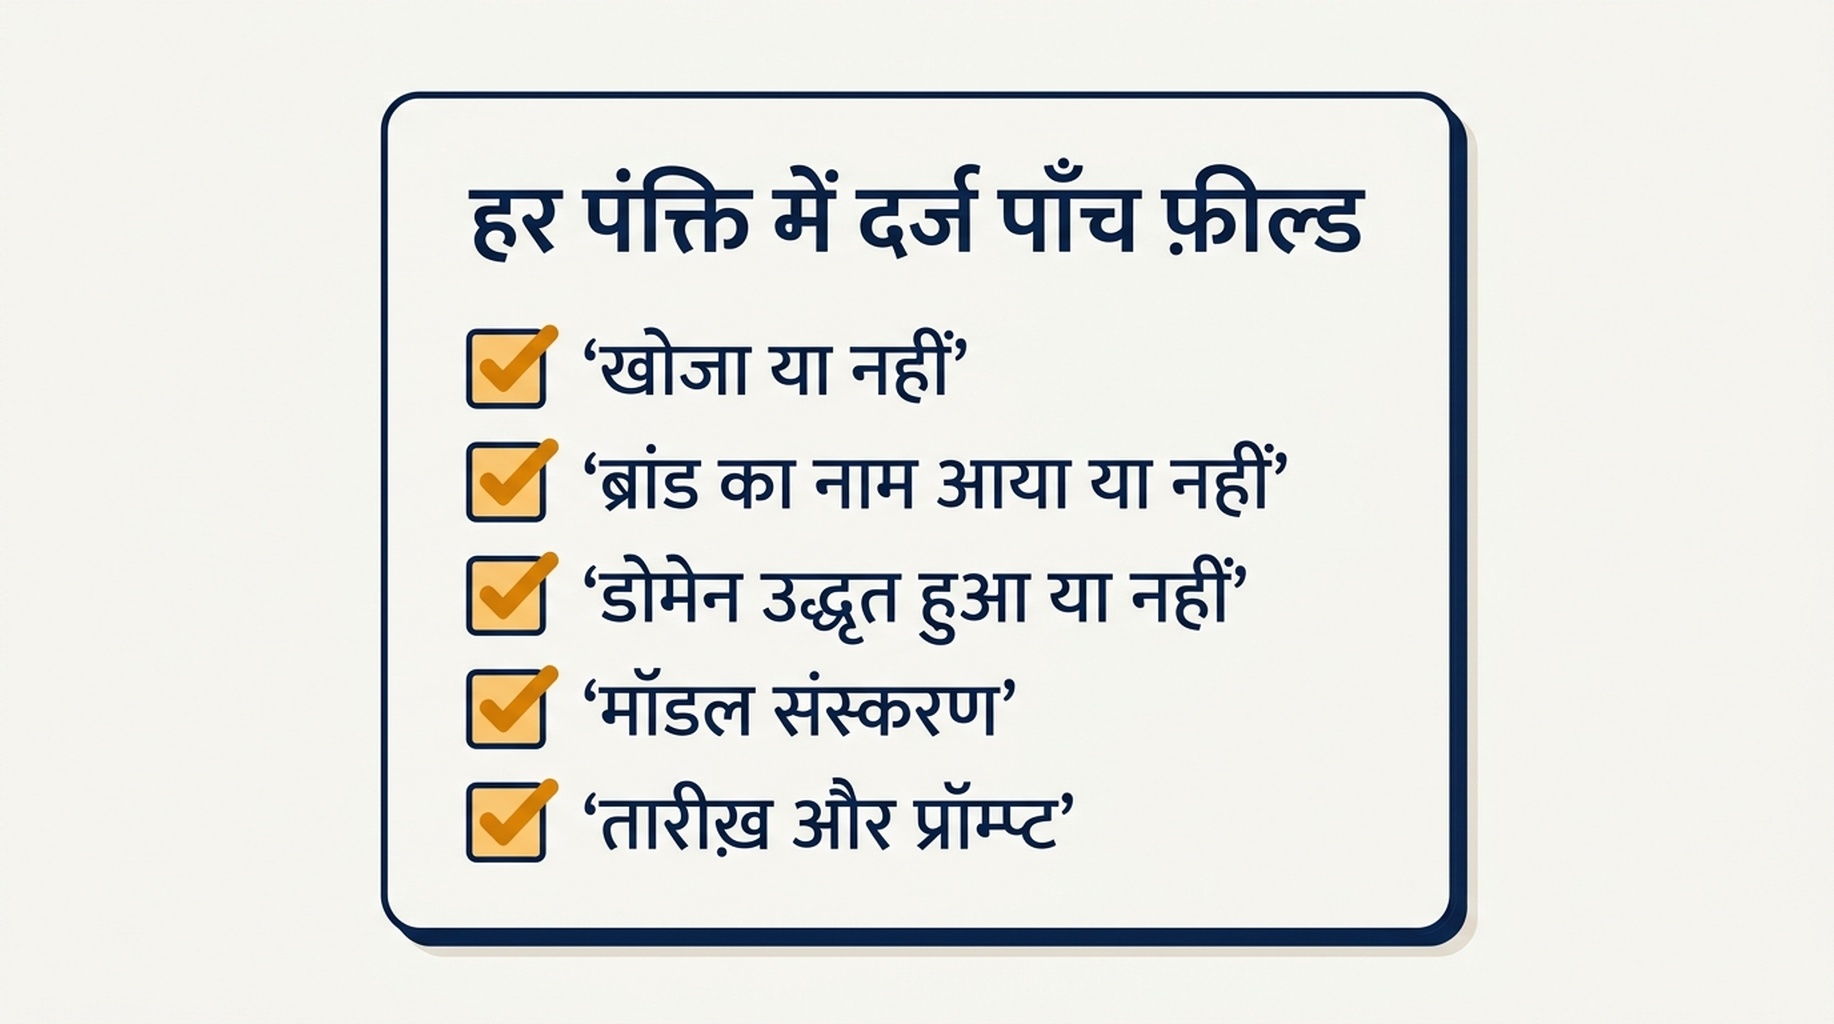
हर प्रॉम्प्ट पर एक संख्या ही वजह है कि रिपोर्टें आपस में टकराती हैं। ये चार रखें।
फ़ील्ड | मान | क्यों मायने रखता है |
|---|---|---|
स्रोत-आधारित | हाँ या नहीं | तय करता है कि प्रॉम्प्ट लिंक दे ही सकता है या नहीं |
ब्रांड का नाम लिया गया | हाँ या नहीं | वह संकेत जो ग़ैर-स्रोत-आधारित जवाब में भी बचा रहता है |
डोमेन लिंक किया गया | हाँ या नहीं | वह संकेत जिसकी रिपोर्ट ज़्यादातर टूल अकेले करते हैं |
मॉडल वर्शन | जैसे gpt-5-2025-08-07 | हमारे रन में व्यवहार वर्शन के बीच बदला |
आख़िरी फ़ील्ड दफ़्तरी काम नहीं है। वही 20 प्रॉम्प्ट, उसी एंडपॉइंट पर, पुराने मॉडल के साथ सिर्फ़ 2 प्रॉम्प्ट पर स्रोत लौटाए, जबकि मौजूदा मॉडल के साथ 8 पर। मॉडल वर्शन के बिना रिपोर्ट की तुलना अगले महीने से नहीं की जा सकती।
नतीजा: हर प्रॉम्प्ट के लिए चार भरे फ़ील्ड। गुणवत्ता जाँच: अगर कोई सेल खाली है, तो वह पंक्ति रिपोर्ट नहीं की जा सकती। जवाब का कच्चा टेक्स्ट और स्रोतों की कच्ची सूची फ़ील्ड के पास रखें, ताकि समीक्षक प्रॉम्प्ट दोबारा चलाए बिना फ़ैसला जाँच सके।
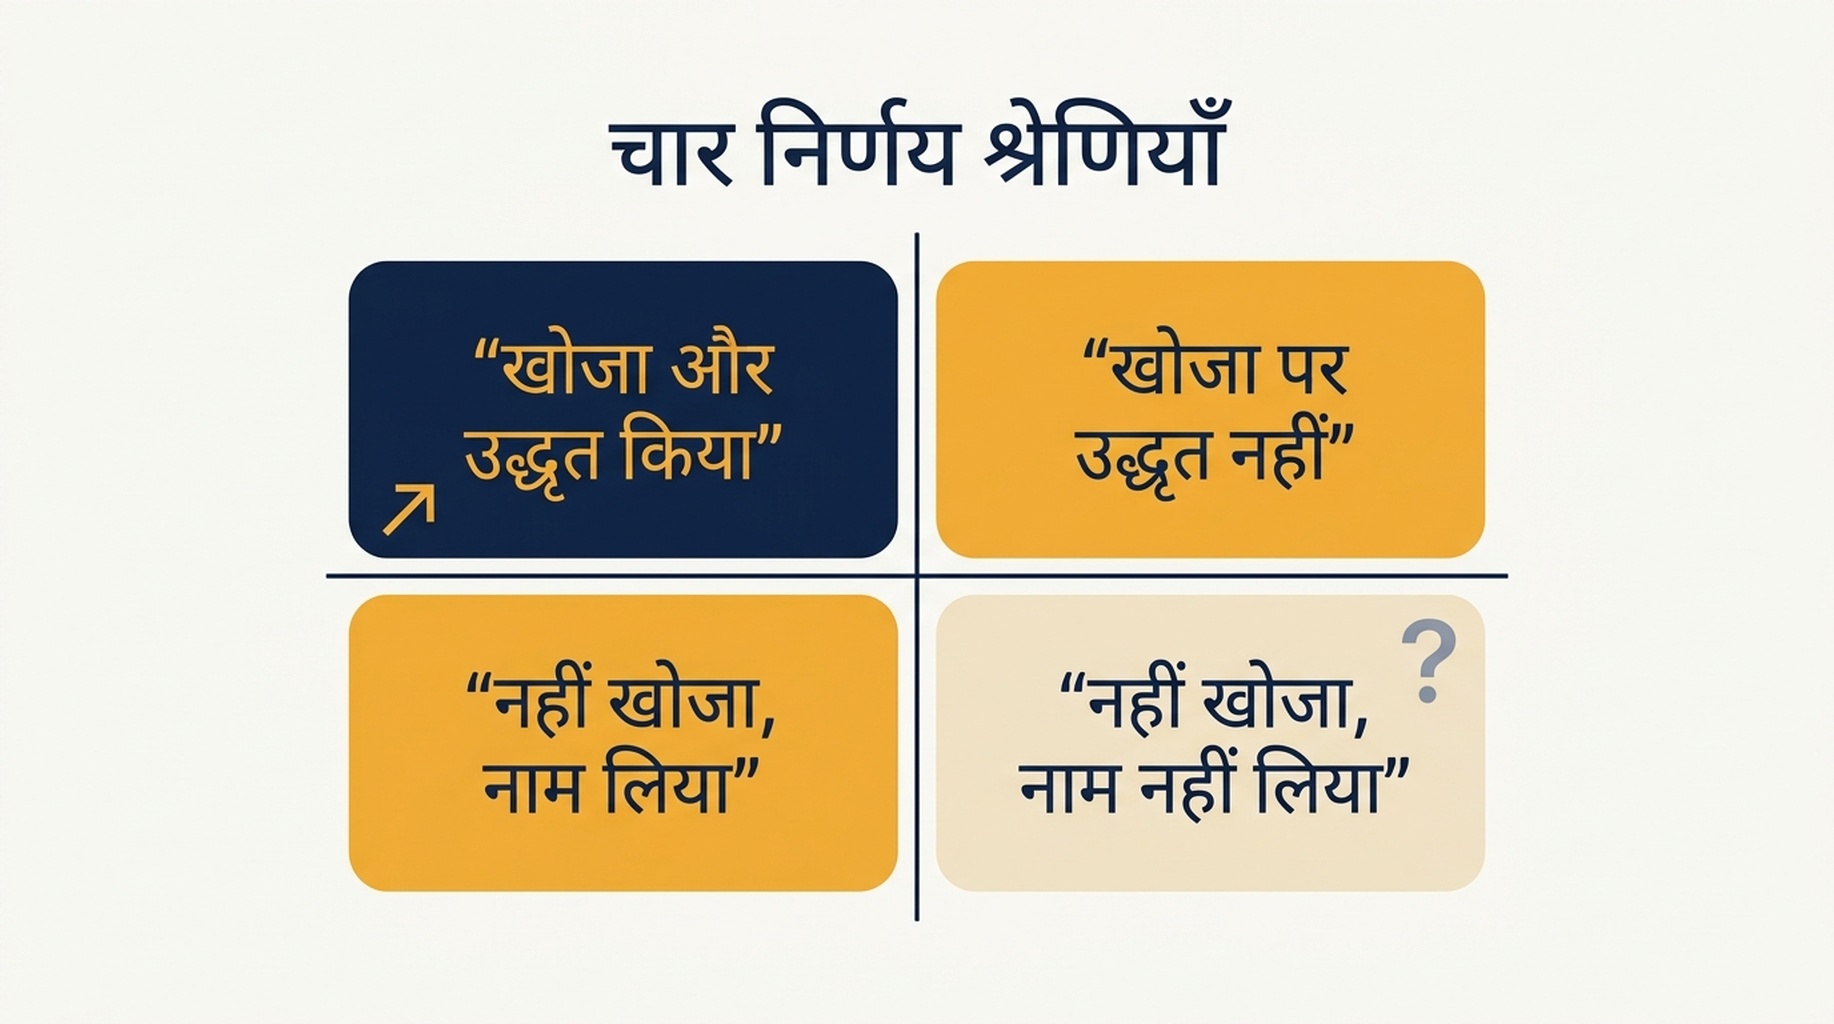
चरण 4: हर जवाब को चार फ़ैसलों में से एक में रखें
फ़ैसला | इसका मतलब | आगे क्या करें |
|---|---|---|
स्रोत-आधारित और लिंक किया गया | ChatGPT ने कुछ खोजा और आपके डोमेन का हवाला दिया | हवाला दिए गए पेज की रक्षा करें और देखें कि किस सवाल-रूप ने उसे बनाया |
स्रोत-आधारित, लिंक नहीं | उसने खोजा, वेब पढ़ा और किसी और की सिफ़ारिश की | कमी सामग्री और स्रोत-कवरेज में है, मॉडल के ज्ञान में नहीं |
ग़ैर-स्रोत-आधारित पर नाम लिया गया | उसने याद से जवाब दिया और फिर भी आपका नाम लिया | ठीक करने को कुछ नहीं। बाद में वही प्रॉम्प्ट दोहराएँ, देखें कि खोजना शुरू करता है या नहीं |
ग़ैर-स्रोत-आधारित और नाम नहीं लिया गया | उसने याद से जवाब दिया और आपका नाम नहीं लिया | यह अभी संकेत नहीं है। प्रॉम्प्ट ठीक करें या स्रोत-आधारित रन का इंतज़ार करें |
चौथी पंक्ति ही ज़्यादातर झूठे अलार्म की जड़ है। हमारे डेटा में 20 में से 13 ChatGPT जवाबों ने कम से कम एक विक्रेता का नाम लिया, जबकि 20 में से सिर्फ़ 8 ने कुछ भी हवाला दिया, यानी कुछ जवाब ऐसी जाँच को खाली लगेंगे जो सिर्फ़ लिंक पढ़ती है, जबकि वही टेक्स्ट ब्रांडों के नाम ले रहा है।
नतीजा: हर प्रॉम्प्ट पर एक फ़ैसला, साथ में कार्रवाई। गुणवत्ता जाँच: हर "अदृश्य" फ़ैसला किसी स्रोत-आधारित जवाब से जुड़ा होना चाहिए। अगर फ़ैसले का तर्क एक वाक्य में लिखे जाने पर टिकता नहीं, तो प्रॉम्प्ट दोबारा चलाएँ।
चरण 5: किसी बदलाव पर भरोसा करने से पहले दो प्रॉम्प्ट दोहराएँ
कम से कम दो प्रॉम्प्ट नई बातचीत में दूसरी बार चलाएँ और फ़ैसले की तुलना करें, गिनती की नहीं।
प्रॉम्प्ट | पहला रन | दूसरा रन | स्थिर |
|---|---|---|---|
AI दृश्यता के लिए सबसे अच्छे टूल | स्रोत-आधारित, 13 स्रोत, 6 डोमेन | स्रोत-आधारित, 14 स्रोत, 4 डोमेन | फ़ैसला हाँ, गिनती नहीं |
ब्रांड के ज़िक्र पर नज़र रखने का सबसे अच्छा टूल | स्रोत-आधारित, 8 स्रोत, 8 डोमेन | स्रोत-आधारित, 9 स्रोत, 5 डोमेन | फ़ैसला हाँ, गिनती नहीं |
मेरे ब्रांड को AI जवाबों में जाँचें | ग़ैर-स्रोत-आधारित, 0 स्रोत | ग़ैर-स्रोत-आधारित, 0 स्रोत | हाँ |
AI जवाब कितनी बार बदलते हैं | ग़ैर-स्रोत-आधारित, 0 स्रोत | ग़ैर-स्रोत-आधारित, 0 स्रोत | हाँ |
जिन पाँच प्रॉम्प्ट को हमने दोहराया, उन सबमें खोजने का फ़ैसला हर बार ख़ुद से मेल खाया, जबकि डोमेन की गिनती दो या तीन खिसकी। यही सही अंशांकन है: फ़ैसले को संकेत मानें और गिनती को दायरे वाला अनुमान।
नतीजा: कम से कम दो प्रॉम्प्ट के लिए दोहराव की पंक्ति। गुणवत्ता जाँच: अगर किसी बिना बदले प्रॉम्प्ट पर फ़ैसला रनों के बीच पलट जाए, तो उस प्रॉम्प्ट को अस्थिर चिह्नित करें और दोहराए जाने तक उसे महीने-दर-महीने रिपोर्ट से बाहर रखें।
चरण 6: जाँच को शेड्यूल पर डालें
दस प्रॉम्प्ट की जाँच मौजूदा ChatGPT मॉडल पर क़रीब 0.29 डॉलर की पड़ती है, हर हफ़्ते चलाने पर महीने के क़रीब 1.27 डॉलर। इस क़ीमत पर असली काम API कॉल नहीं, मूल्यांकन मानदंड है, इसलिए यह काम ऐसे एजेंट को दें जिसके पास साफ़ संग्रह नियम हों, सारांश के अनुरोध को नहीं।
एजेंट को ये शर्तें दें:
- जवाब का टेक्स्ट शब्द-दर-शब्द और स्रोत-सूची शब्द-दर-शब्द कैप्चर करें। दोनों में से किसी का सारांश न बनाएँ।
- हर पंक्ति में स्रोत-आधार फ़्लैग, मॉडल वर्शन और टाइमस्टैम्प दर्ज करें।
- गिनतियाँ संग्रह के बाद कोड में निकालें, कभी प्रॉम्प्ट के अंदर नहीं।
- तारीख़ वाली फ़ाइल में लिखें, ताकि दोहराव पिछले महीने के सबूत न मिटा दे।
अगर आप पहले से सर्च रिपोर्ट के लिए एजेंट चलाते हैं, तो संग्रह का तरीक़ा वही है जो Codex के साथ रोज़ाना SEO और GEO मॉनिटरिंग में इस्तेमाल हुआ, और उसी लूप का टर्मिनल वर्शन Claude Code के साथ रोज़ाना मॉनिटरिंग में है। यहाँ एकमात्र नई शर्त स्रोत-आधार फ़्लैग है, क्योंकि जिस चैट सतह ने खोजा ही नहीं, उसे हवाले के नतीजे के तौर पर नहीं पढ़ा जा सकता।
नतीजा: एक शेड्यूल किया हुआ जॉब जो तारीख़ वाली पंक्तियाँ लिखता है। गुणवत्ता जाँच: पिछले हफ़्ते की फ़ाइल खोलें और पुष्टि करें कि सिर्फ़ सहेजे गए सबूत से आप फ़ैसला दोबारा बना सकते हैं।
सत्यापन: मान्य जाँच ऐसी दिखती है
- हर पंक्ति में स्रोत-आधार फ़्लैग, मॉडल वर्शन और तारीख़ है।
- हर "अदृश्य" फ़ैसला किसी स्रोत-आधारित जवाब का है।
- कम से कम दो प्रॉम्प्ट दो बार चले और उनके फ़ैसले तुलना किए गए।
- जवाब का कच्चा टेक्स्ट और स्रोतों की कच्ची सूची गिनतियों के पास सहेजी गई है।
- प्रॉम्प्ट की सूची रूप के हिसाब से चिह्नित है, और रिपोर्ट नतीजे कुल के हिसाब से नहीं, रूप के हिसाब से समूहित करती है।
सीमाएँ
- एक मॉडल वर्शन, एक जगह, अंग्रेज़ी, एक दिन के रन। ChatGPT का व्यवहार वर्शनों के बीच अलग होता है।
- वेब सर्च API से चालू किया गया था। उपभोक्ता ऐप किसी अलग प्रॉम्प्ट-सेट पर खोज सकता है।
- ब्रांड के नाम लेने को टेक्स्ट मिलान से मापा गया, इसलिए कंपनी के नाम के बिना आया कोई उत्पाद-नाम छूट सकता है।
- यह जाँच जवाब मापती है, ट्रैफ़िक नहीं। रेफ़रल व्यवहार एक अलग माप है।
अक्सर पूछे जाने वाले प्रश्न
ChatGPT मेरे ब्रांड के बारे में कुछ क्यों नहीं कहता?
पहले जाँचें कि उसने खोजा या नहीं। हमारे रन में उसने 20 में से 12 प्रॉम्प्ट का जवाब याद से दिया, बिना स्रोत, और ऐसे जवाब पुराने प्रशिक्षण डेटा से किसी विक्रेता का नाम ले सकते हैं या किसी का नहीं। ग़ैर-स्रोत-आधारित जवाब आपकी दृश्यता का सबूत नहीं है।
ChatGPT में कितने प्रॉम्प्ट जाँचने चाहिए?
हर चक्र में आठ से बारह काफ़ी हैं, बशर्ते वे श्रेणी, तुलना, समस्या और प्रमाण के रूपों को कवर करें। सौ प्रॉम्प्ट चलाने पर उन्हीं चार रूपों का बड़ा नमूना मिलता है, नई जानकारी नहीं।
क्या यह बिना API जाँचा जा सकता है?
हाँ। स्रोत-आधार फ़्लैग और ब्रांड का नाम, दोनों इंटरफ़ेस में दिखते हैं, और जवाब के नीचे की स्रोत-सूची हवाले वाला आधा हिस्सा कवर करती है। API तभी मायने रखता है जब आपको तारीख़ वाली पंक्तियाँ और बिना हाथ से कॉपी किए दोहराव चाहिए।
मुझे कैसे पता चले कि बदलाव असली है?
बदलाव की रिपोर्ट करने से पहले प्रॉम्प्ट दोहराएँ। हमारे पाँच दोहराव जोड़ों में खोजने का फ़ैसला एक बार भी नहीं पलटा, जबकि स्रोतों की गिनती दो या तीन खिसकी। स्रोत-आधारित प्रॉम्प्ट पर फ़ैसला बदलना जाँच के लायक़ है। गिनती बदलना नहीं।
Auspia की राय: कोई भी संख्या पढ़ने से पहले वैधता द्वार पार करें, और गिनती के बजाय फ़ैसला बताएँ। हमें जो सबसे आम ग़लती मिली, वह छूटा हुआ हवाला नहीं था, बल्कि ChatGPT का खाली जवाब था जिसे अदृश्यता बताया गया, जबकि मॉडल ने कुछ खोजा ही नहीं था। पहले फ़्लैग ठीक करें, और रिपोर्ट का बाक़ी हिस्सा महीने-दर-महीने तुलनीय हो जाएगा।
लेखन: विक्टर लेन