ChatGPTであなたのブランドが表示されるかどうかを誰かに聞かれたなら、最初に正直に言える答えはこうです。空白の結果と本物のゼロは、ある一点を確認するまでは見分けがつかない、というものです。このガイドは、監視プラットフォームを持たずに、チャット画面と表計算とおよそ30分だけでその答えを出さなければならない人のためのものです。
読み終えるころには、プロンプトごとの判定と、会議で防御できる再現可能な記録と、それを最新に保つ定期ジョブが手に入ります。完了条件は単純です。すべてのプロンプトについて、回答がグラウンディングありだったか、ブランドを名指ししたか、サイトにリンクしたかを述べられることです。
読み終えたときに手元にあるもの
出力 | 置き場所 |
|---|---|
実際の会話から書いた8〜12問のプロンプトリスト | シートの最初のタブ |
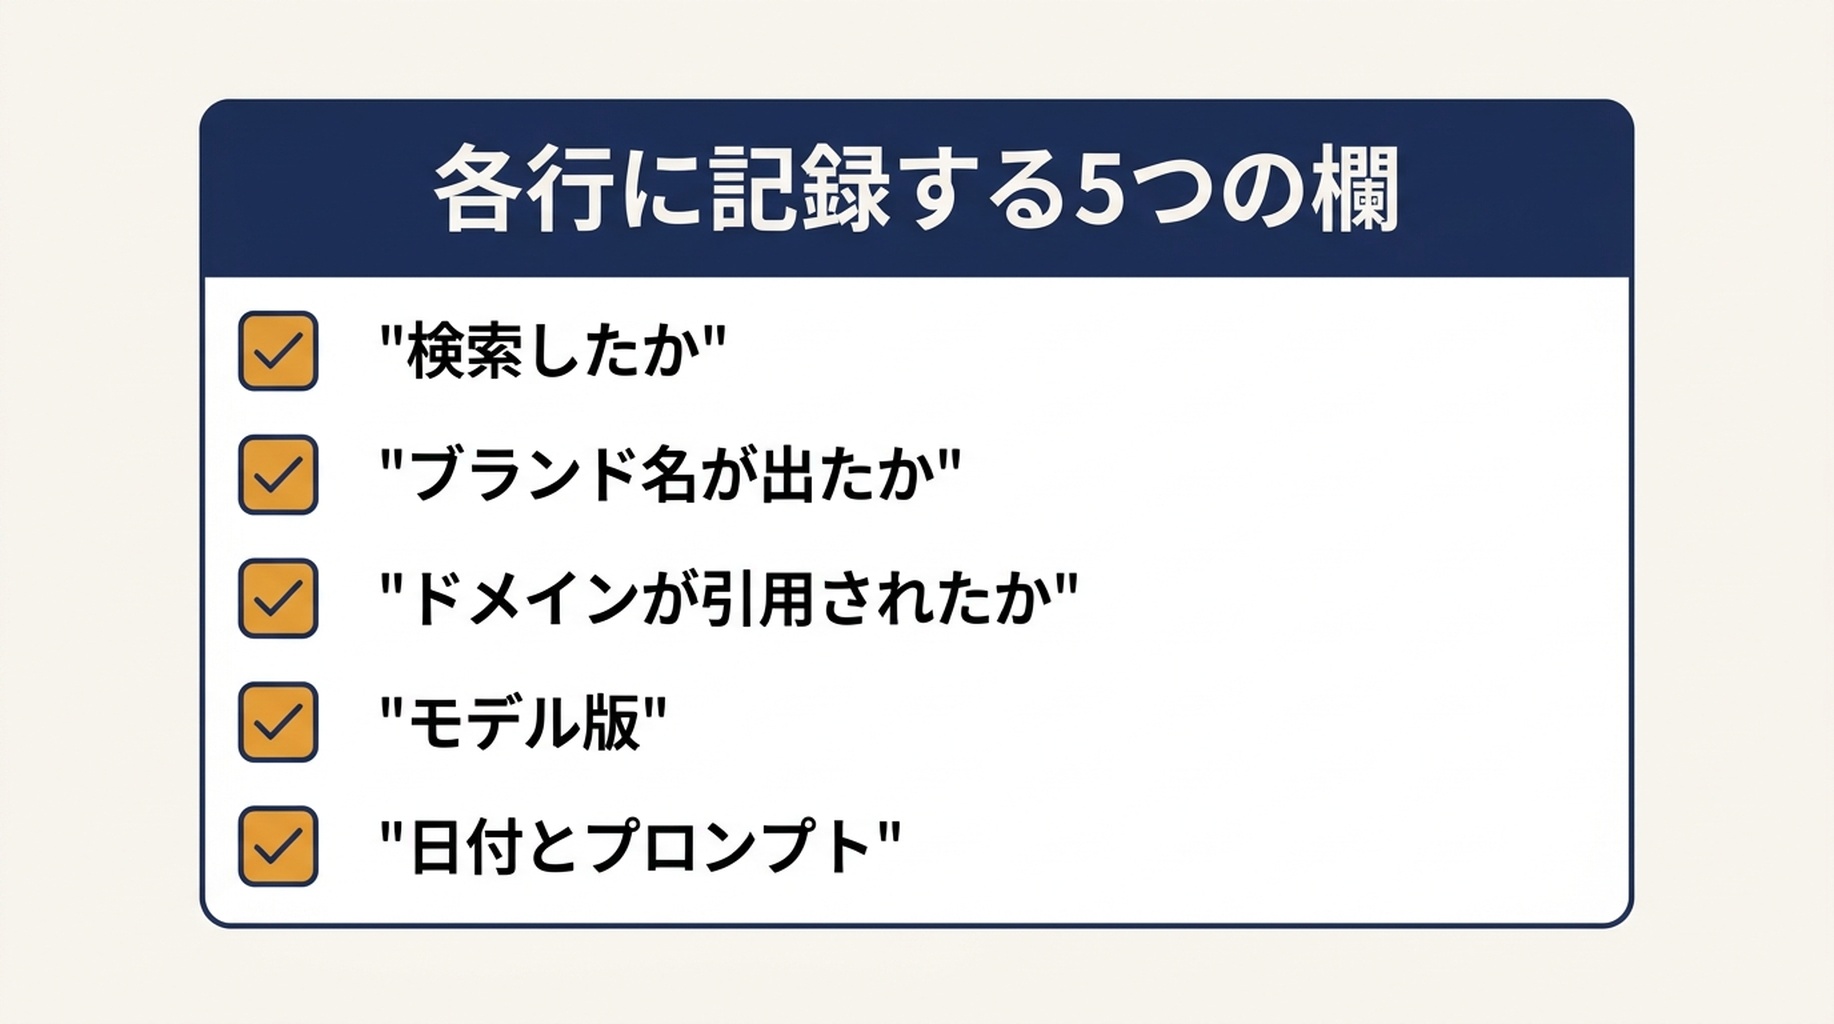
4つのフィールドとモデルバージョンを持つ、プロンプト1行ずつの行 | 同じタブ |
プロンプトごとに4つある判定のいずれかと、それに紐づくアクション | 判定の列 |
少なくとも2つのプロンプトの再実行 | 同じシートの2行目と3行目 |
固定した評価基準つきの定期チェック | エージェントのプロジェクトフォルダ |
前提は、ウェブ検索つきのChatGPTへのアクセス、表計算、そして自動化する場合に10プロンプトの実行でおよそ0.29ドルを使えることです。
ステップ1:プロンプトはキーワードからではなく会話から書く
直近で営業チームが答えた20の質問を集め、それをグループ分けします。私たちの20プロンプトの調査では、最も広い情報源リストはそもそも引用されるにはどうするかという問いから生まれ、最も狭いものはツール同士の一対一比較から生まれました。つまり質問の形が、返ってくるデータの量を決めます。
4つの形にまたがる8〜12個のプロンプトを書きます。カテゴリ(「Yに最適なX」)、比較(「A対B」)、問題(「AIが自社を知っているかどうかをどう調べるか」)、証拠(「2026年にXを推薦しているのは誰か」)です。加えて、あなたのブランドを直接名指しするプロンプトを2つ足します。これらはカテゴリのプロンプトとは挙動が違うからです。同じリストで複数面の証拠が欲しいなら、同じプロンプトを3つの面に送ると何が変わるかをAI可視性チェッカーの分析が示しています。
出力:最終的な8〜12個のプロンプトのリスト。それぞれに形のタグをつけます。品質チェック:すべてのプロンプトは、顧客が実際に入力しそうなものでなければなりません。キーワードを含むという理由だけで存在するプロンプトは削ります。
ステップ2:ほかを読む前に有効性ゲートを通す
これはほとんどの検査が飛ばすステップであり、空白がゼロとして報告される理由でもあります。私たちの実行では、ChatGPTは20のプロンプトのうち8つで検索クエリを発行し、残りの12は記憶から答えました。
観察したこと | グラウンディングありの回答(8プロンプト) | グラウンディングなしの回答(12プロンプト) |
|---|---|---|
発行された検索クエリ | 1プロンプトあたり4〜8件 | 0 |
返された情報源アノテーション | 6〜18件、中央値12 | 0 |
引用された異なるドメイン | 4〜10件、中央値7 | 0 |
本文中で依然として挙げられたブランド | あり | あり、全体20プロンプト中13件 |
ブランドについて何かを記録する前に、各プロンプトを実行し、1つの問いに答えます。モデルは何かを調べたか。ChatGPTの画面では、手がかりは回答の下にある情報源リストです。情報源リストがなければ、その回答は記憶から作られたものであり、あなたのブランドについて沈黙していることはまだ何の意味も持ちません。
出力:グラウンディング列のプロンプトごとのあり/なし。品質チェック:情報源リストのない回答は可視性のシグナルとしては決して記録せず、記憶のシグナルとしてのみ記録します。グラウンディングなしの回答は短くもありませんでした。出力トークンの中央値は1,730で、グラウンディングありの1,645に対してです。長さは使える手がかりになりません。
ステップ3:1つではなく4つのフィールドを記録する
プロンプトごとに数字が1つだけなのが、レポートが食い違う理由です。この4つを保ってください。
フィールド | 値 | 重要な理由 |
|---|---|---|
グラウンディング | あり/なし | そのプロンプトがそもそもリンクを生み得るかを決める |
ブランド指名 | あり/なし | グラウンディングなしの回答でも残るシグナル |
ドメインリンク | あり/なし | ほとんどのツールがこれ単独で報告するシグナル |
モデルバージョン | 例:gpt-5-2025-08-07 | 私たちの実行ではバージョン間で挙動が動いた |
最後のフィールドは事務作業ではありません。同じ20のプロンプトを同じエンドポイントで古いモデルに通すと、情報源を返したのは2プロンプトで、現行モデルでは8でした。モデルバージョンのないレポートは来月のものと比較できません。
出力:プロンプトごとに埋まった4つのフィールド。品質チェック:空のセルが1つでもあれば、その行は報告できません。生の回答テキストと生の情報源リストをフィールドと並べて保管し、レビューする人がプロンプトを再実行せずに判定を再確認できるようにします。
ステップ4:各回答を4つの判定のいずれかに分類する
判定 | 意味 | 次にすること |
|---|---|---|
グラウンディングあり・リンクあり | ChatGPTが何かを調べ、あなたのドメインを引用した | 引用されたページを守り、どの質問形がそれを生んだかを確認する |
グラウンディングあり・リンクなし | 検索し、ウェブを読み、他社を推薦した | ギャップはモデルの知識ではなく、コンテンツと情報源の網羅性にある |
グラウンディングなし・指名あり | 記憶から答え、それでもあなたを挙げた | 直すものはない。後で同じプロンプトを再実行し、検索を始めるか見る |
グラウンディングなし・指名なし | 記憶から答え、あなたを挙げなかった | まだシグナルではない。プロンプトを直すか、グラウンディングありの実行を待つ |
4行目が、誤報のほとんどが出てくる場所です。私たちのデータでは、ChatGPTの回答20件のうち13件が少なくとも1つのベンダーを名指しした一方、何かを引用したのは20件のうち8件だけでした。つまりリンクだけを見る検査では空に見える回答のうち、同じテキストがブランドを挙げているものが相当数あります。
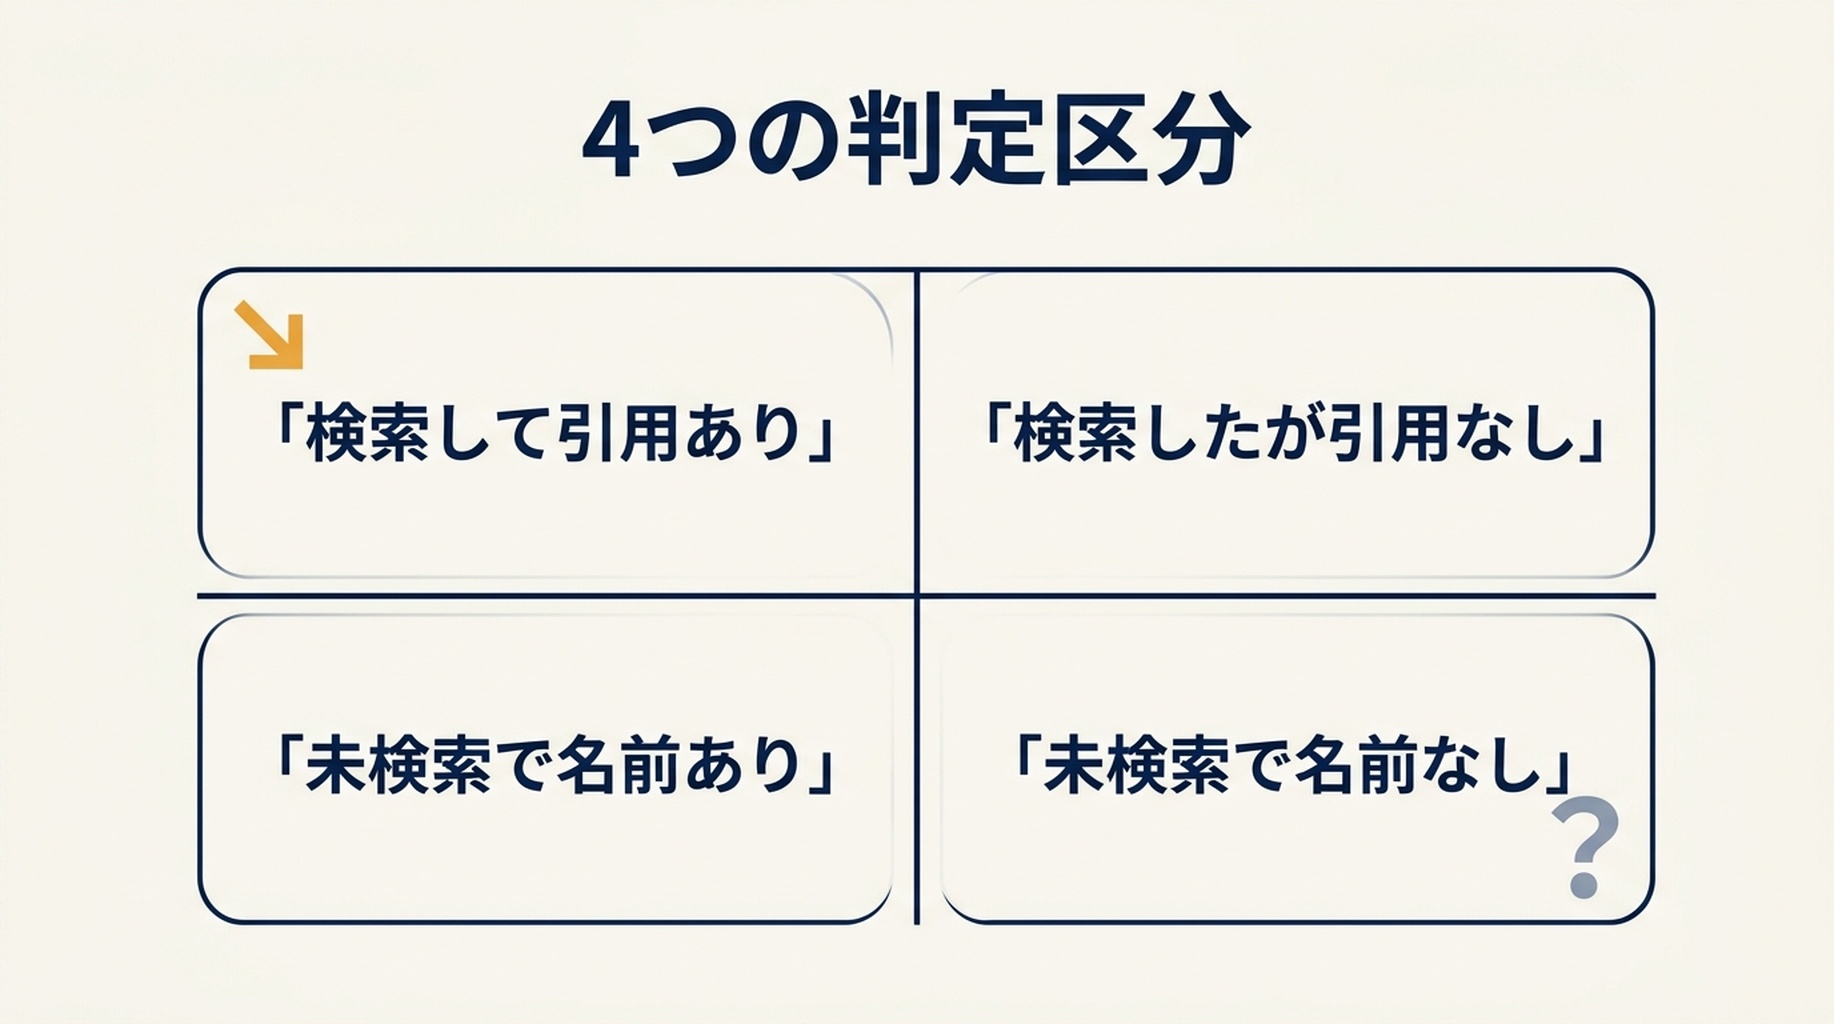
出力:プロンプトごとに1つの判定と、アクション。品質チェック:「見えない」という判定は必ずグラウンディングありの回答に結びつけます。判定の根拠が1文に書き出して耐えられないなら、そのプロンプトは再実行します。
ステップ5:変化を信じる前に2つのプロンプトを繰り返す
少なくとも2つのプロンプトを、新しい会話で2回目に実行し、件数ではなく判定を比べます。
プロンプト | 1回目 | 2回目 | 安定 |
|---|---|---|---|
最高のAI可視性ツール | グラウンディングあり、情報源13件、ドメイン6件 | グラウンディングあり、情報源14件、ドメイン4件 | 判定は安定、件数は不安定 |
ブランド言及を追うのに最適なツール | グラウンディングあり、情報源8件、ドメイン8件 | グラウンディングあり、情報源9件、ドメイン5件 | 判定は安定、件数は不安定 |
AIの回答で自社ブランドを監査する | グラウンディングなし、情報源0件 | グラウンディングなし、情報源0件 | 安定 |
AIの回答はどのくらい変わるか | グラウンディングなし、情報源0件 | グラウンディングなし、情報源0件 | 安定 |
繰り返した5つのプロンプト全体で、検索するかどうかの決定は毎回一致し、一方でドメイン数は2〜3動きました。これが正しい較正です。判定をシグナルとして扱い、件数は幅のある推計として扱います。
出力:少なくとも2つのプロンプトの再実行行。品質チェック:変わっていないプロンプトで判定が実行間で反転したら、そのプロンプトを不安定と印づけ、再現するまで前月比の報告から外します。
ステップ6:チェックを定期実行に載せる
10プロンプトのチェックは現行のChatGPTモデルでおよそ0.29ドル、週次で回せば月およそ1.27ドルです。この価格なら、仕事はAPI呼び出しではなく評価基準のほうです。だからこのジョブは、要約の依頼ではなく明示的な収集ルールを持たせたエージェントに渡します。
エージェントに次の制約を渡します。
- 回答テキストと情報源リストをそのまま取得する。どちらも要約しない。
- グラウンディングのフラグ、モデルバージョン、タイムスタンプを毎行に記録する。
- 集計は収集後にコードで計算し、プロンプトの中では決して計算しない。
- 日付つきのファイルに書き出し、再実行が前月の証拠を上書きできないようにする。
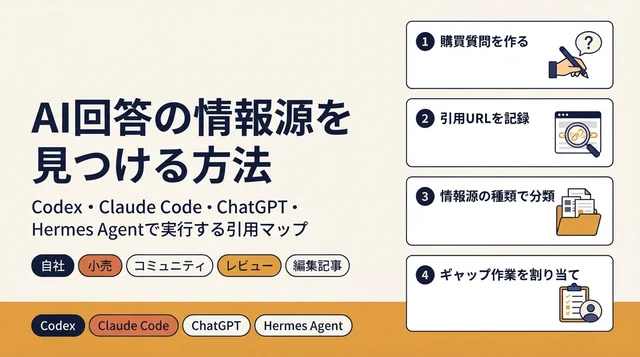
検索レポート用のエージェントをすでに動かしているなら、収集の型はCodexによる日次のSEO・GEO監視で使っているものと同じで、同じループのターミナル版はClaude Codeの日次監視にあります。ここで新しい要件はグラウンディングのフラグだけです。検索しなかったチャット面を引用の結果として読んではならないからです。
出力:日付つきの行を書き出す定期ジョブ。品質チェック:先週のファイルを開き、保存された証拠だけで判定を組み直せることを確認します。
検証:まともなチェックはこうなっている
- すべての行にグラウンディングのフラグ、モデルバージョン、日付がある。
- 「見えない」という判定はすべてグラウンディングありの回答に属する。
- 少なくとも2つのプロンプトが2回実行され、その判定が比較されている。
- 生の回答テキストと生の情報源リストが、件数の隣に保存されている。
- プロンプトリストに形のタグがつき、レポートは合計ではなく形ごとに結果をまとめている。
限界
- 1つのモデルバージョン、1つの地域、英語、1日分の実行。ChatGPTの挙動はバージョン間で異なります。
- ウェブ検索はAPI経由で有効にしました。消費者向けアプリは別のプロンプト集合で検索するかもしれません。
- ブランドの指名は文字列一致で測ったので、会社名を伴わない製品名は見落とされ得ます。
- このチェックが測るのは回答であり、トラフィックではありません。参照の挙動は別の測定です。
よくある質問
ChatGPTが自社ブランドについて何も言わないのはなぜですか?
まず検索したかどうかを確認してください。私たちの実行では20のプロンプトのうち12を情報源なしで記憶から答え、そうした回答は古い学習データからベンダーを挙げることも、誰も挙げないこともありました。グラウンディングなしの回答は、あなたの可視性についての証拠にはなりません。
ChatGPTでは何個のプロンプトを確認すべきですか?
1サイクルあたり8〜12個で、パターンを見るには十分です。ただしカテゴリ、比較、問題、証拠の4つの形を覆っていることが条件です。100個のプロンプトを回しても、同じ4つの形のより大きな標本が得られるだけで、新しい情報にはなりません。
APIなしでこれを確認できますか?
できます。グラウンディングのフラグもブランドの指名も画面で見えますし、回答の下の情報源リストが引用の半分を担います。APIが要るのは、手作業のコピーなしに日付つきの行と再実行が欲しいときだけです。
変化が本物かどうかはどう分かりますか?
変化を報告する前にプロンプトを繰り返してください。私たちの5組の再実行では、検索の決定は一度も反転しませんでしたが、情報源の件数は2〜3動きました。グラウンディングありのプロンプトで判定が変わったなら調べる価値があります。件数の変化にはありません。
Auspia の見解:数字を読む前に有効性ゲートを通し、件数ではなく判定を報告してください。私たちが見つけた最も多い誤りは引用の取りこぼしではなく、モデルが何も調べていないのに空白のChatGPT回答を見えない状態として報告してしまうことです。まずフラグを直せば、レポートの残りは前月比で比較できるようになります。
執筆: ヴィクター・レイン