Wenn jemand gefragt hat, ob Ihre Marke in ChatGPT auftaucht, lautet die ehrliche erste Antwort: Ein leeres Ergebnis und eine echte Null sehen identisch aus, bis Sie eine Sache prüfen. Dieser Leitfaden ist für alle, die diese Antwort ohne Monitoring-Plattform liefern müssen, mit nichts als einem Chatfenster, einer Tabelle und etwa dreißig Minuten.
Am Ende haben Sie ein Urteil pro Prompt, eine wiederholbare Aufzeichnung, die Sie in einer Besprechung verteidigen können, und einen geplanten Job, der sie aktuell hält. Die Abschlussbedingung ist einfach: Zu jedem Prompt können Sie sagen, ob die Antwort gestützt war, ob sie die Marke genannt hat und ob sie die Website verlinkt hat.
Was Sie am Ende haben
Ergebnis | Wo es liegt |
|---|---|
Eine Liste von 8 bis 12 Prompts, aus echten Gesprächen geschrieben | Das erste Tab Ihrer Tabelle |
Eine Zeile pro Prompt mit vier Feldern und der Modellversion | Dasselbe Tab |
Eines von vier Urteilen pro Prompt, mit der zugehörigen Maßnahme | Die Urteilsspalte |
Eine Wiederholung für mindestens zwei Prompts | Die Zeilen 2 und 3 derselben Tabelle |
Eine geplante Prüfung mit festem Bewertungsmaßstab | Der Projektordner Ihres Agenten |
Voraussetzungen: Zugang zu ChatGPT mit Websuche, eine Tabelle und die Möglichkeit, rund 0,29 Dollar für einen Lauf mit zehn Prompts auszugeben, wenn Sie das automatisieren.
Schritt 1: Schreiben Sie die Prompts aus Gesprächen, nicht aus Keywords
Ziehen Sie die letzten zwanzig Fragen heran, die das Vertriebsteam beantwortet hat, und gruppieren Sie sie. In unserer Studie mit zwanzig Prompts kam die breiteste Quellenliste aus einer Frage dazu, wie man überhaupt zitiert wird, und die engste aus einem direkten Werkzeugvergleich, das heißt, die Form der Frage entscheidet, wie viele Daten zu Ihnen zurückkommen.
Schreiben Sie 8 bis 12 Prompts über vier Formen: Kategorie („das beste X für Y"), Vergleich („A gegen B"), Problem („wie finde ich heraus, ob die KI mein Unternehmen kennt") und Beleg („wer empfiehlt X im Jahr 2026"). Fügen Sie zwei Prompts hinzu, die Ihre Marke direkt nennen, denn sie verhalten sich anders als Kategorie-Prompts. Wenn Sie Belege über mehrere Oberflächen für dieselbe Liste wollen, zeigt die Analyse des KI-Sichtbarkeitsprüfers, was sich ändert, wenn derselbe Prompt auf drei Oberflächen geht.
Ergebnis: eine endgültige Liste von 8 bis 12 Prompts, jeder mit seiner Form markiert. Qualitätskontrolle: Jeder Prompt muss etwas sein, das ein Kunde wirklich eintippen würde. Existiert ein Prompt nur, weil ein Keyword darin vorkommt, streichen Sie ihn.
Schritt 2: Durchlaufen Sie das Gültigkeitstor, bevor Sie irgendetwas anderes lesen
Das ist der Schritt, den die meisten Prüfungen überspringen, und er ist der Grund, warum Leerstellen als Nullen gemeldet werden. In unserem Lauf gab ChatGPT bei 8 der 20 Prompts Suchanfragen aus und beantwortete die anderen 12 aus dem Gedächtnis.
Was wir beobachtet haben | Gestützte Antworten (8 Prompts) | Ungestützte Antworten (12 Prompts) |
|---|---|---|
Ausgegebene Suchanfragen | 4 bis 8 pro Prompt | 0 |
Zurückgegebene Quellenvermerke | 6 bis 18, Median 12 | 0 |
Zitierte verschiedene Domains | 4 bis 10, Median 7 | 0 |
Marken, die im Text noch genannt werden | ja | ja, insgesamt in 13 der 20 Prompts |
Bevor Sie irgendetwas über Ihre Marke festhalten, führen Sie jeden Prompt aus und beantworten Sie eine Frage: Hat das Modell überhaupt gesucht? In der ChatGPT-Oberfläche ist die Quellenliste unter der Antwort der Hinweis. Gibt es keine Quellenliste, stammt die Antwort aus dem Gedächtnis, und ihr Schweigen über Ihre Marke bedeutet noch nichts.
Ergebnis: ja oder nein pro Prompt in der Spalte für die Stützung. Qualitätskontrolle: Eine Antwort ohne Quellenliste wird nie als Sichtbarkeitssignal erfasst, nur als Gedächtnissignal. Unsere ungestützten Antworten waren auch nicht kürzer: Median 1.730 Ausgabe-Token gegen 1.645 bei den gestützten, die Länge ist also kein brauchbarer Hinweis.
Schritt 3: Erfassen Sie vier Felder, nicht eines
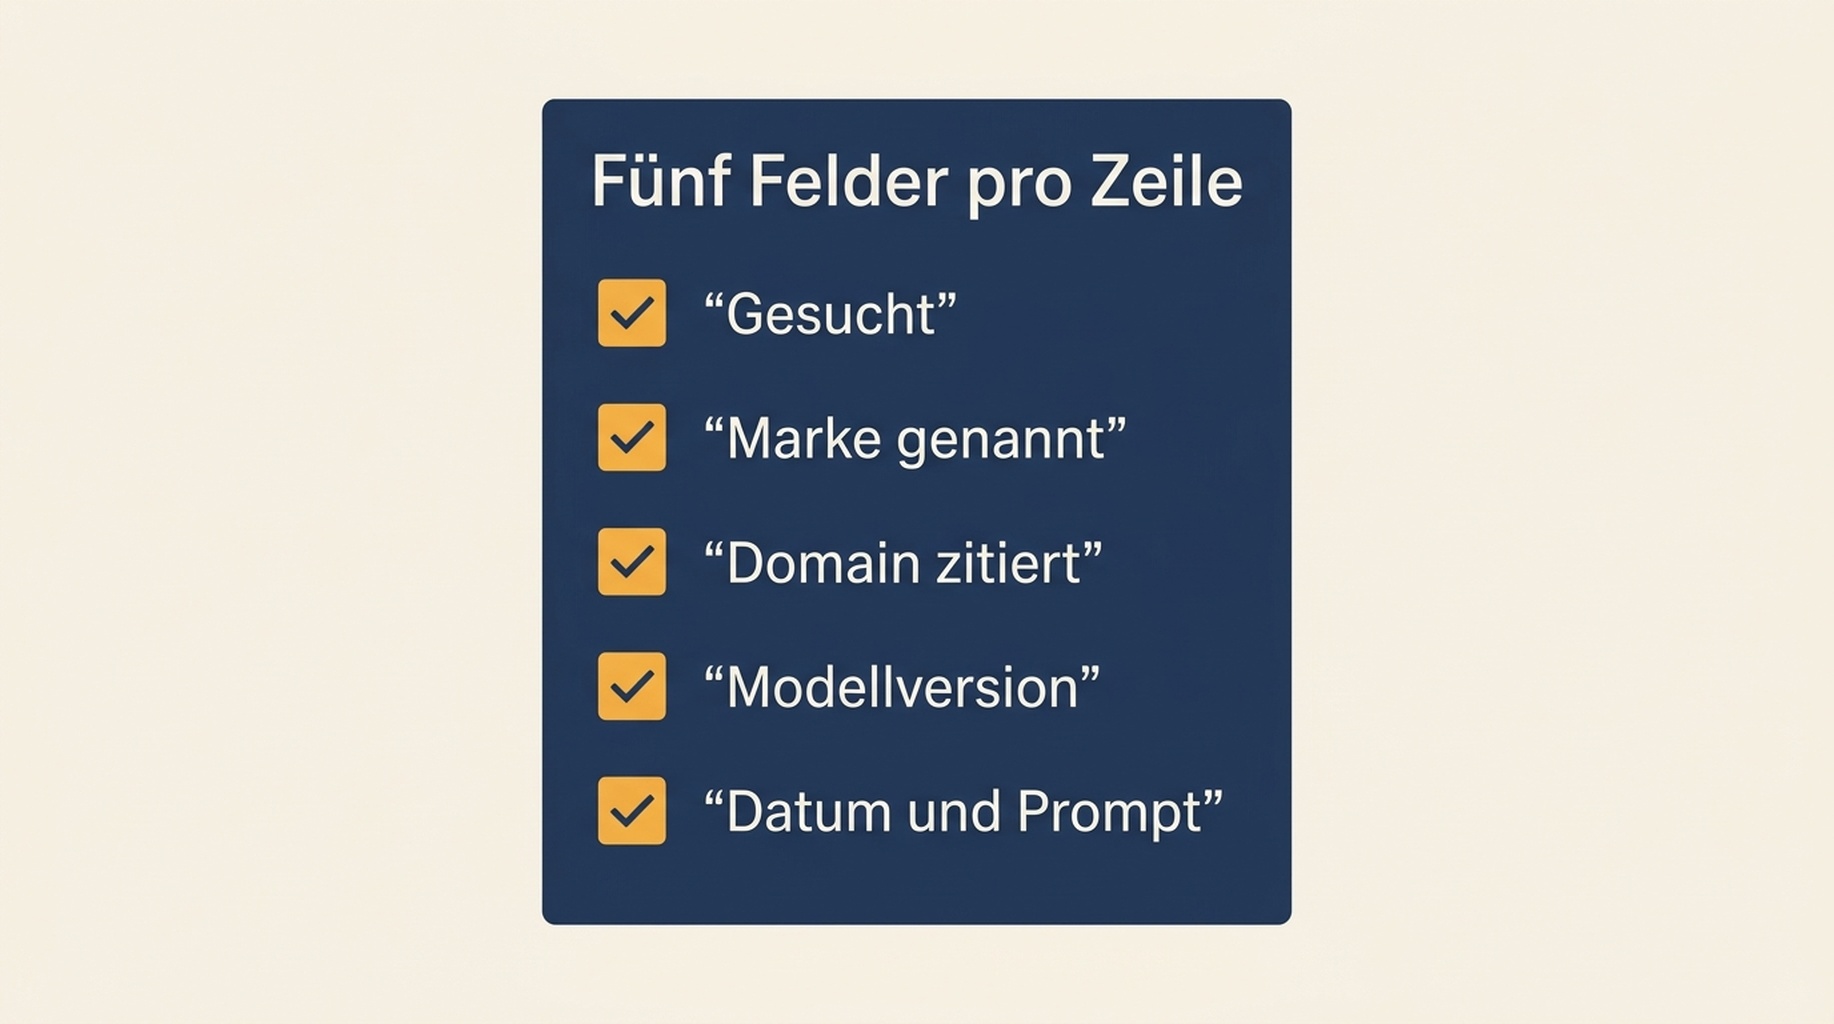
Eine Zahl pro Prompt ist der Grund, warum Berichte einander widersprechen. Halten Sie diese vier fest.
Feld | Wert | Warum es zählt |
|---|---|---|
Gestützt | ja oder nein | Entscheidet, ob der Prompt überhaupt einen Link erzeugen kann |
Marke genannt | ja oder nein | Das Signal, das eine ungestützte Antwort überlebt |
Domain verlinkt | ja oder nein | Das Signal, das die meisten Werkzeuge allein melden |
Modellversion | etwa gpt-5-2025-08-07 | Das Verhalten bewegte sich in unseren Läufen zwischen Versionen |
Das letzte Feld ist keine Formsache. Dieselben 20 Prompts am selben Endpunkt gaben bei einem älteren Modell nur bei 2 Prompts Quellen zurück, gegenüber 8 beim aktuellen. Ein Bericht ohne Modellversion lässt sich nicht mit dem des nächsten Monats vergleichen.
Ergebnis: vier ausgefüllte Felder pro Prompt. Qualitätskontrolle: Ist eine Zelle leer, darf die Zeile nicht gemeldet werden. Bewahren Sie den Rohtext der Antwort und die rohe Quellenliste neben den Feldern auf, damit eine prüfende Person ein Urteil nachvollziehen kann, ohne den Prompt erneut auszuführen.
Schritt 4: Ordnen Sie jede Antwort einem von vier Urteilen zu
Urteil | Was es bedeutet | Was als Nächstes zu tun ist |
|---|---|---|
Gestützt und verlinkt | ChatGPT hat etwas gesucht und Ihre Domain zitiert | Schützen Sie die zitierte Seite und prüfen Sie, welche Frageform sie erzeugt hat |
Gestützt, nicht verlinkt | Es hat gesucht, das Web gelesen und jemand anderen empfohlen | Die Lücke liegt in Inhalt und Quellenabdeckung, nicht im Wissen des Modells |
Ungestützt und genannt | Es hat aus dem Gedächtnis geantwortet und Sie trotzdem genannt | Nichts zu beheben. Wiederholen Sie den Prompt später, um zu sehen, ob es zu suchen beginnt |
Ungestützt und nicht genannt | Es hat aus dem Gedächtnis geantwortet und Sie nicht genannt | Noch kein Signal. Korrigieren Sie den Prompt oder warten Sie auf einen gestützten Lauf |
Aus der vierten Zeile stammen die meisten Fehlalarme. In unseren Daten nannten 13 der 20 ChatGPT-Antworten mindestens einen Anbieter, während nur 8 von 20 überhaupt etwas zitierten, das heißt, ein Teil der Antworten wirkt leer für eine Prüfung, die nur Links liest, während derselbe Text Marken nennt.
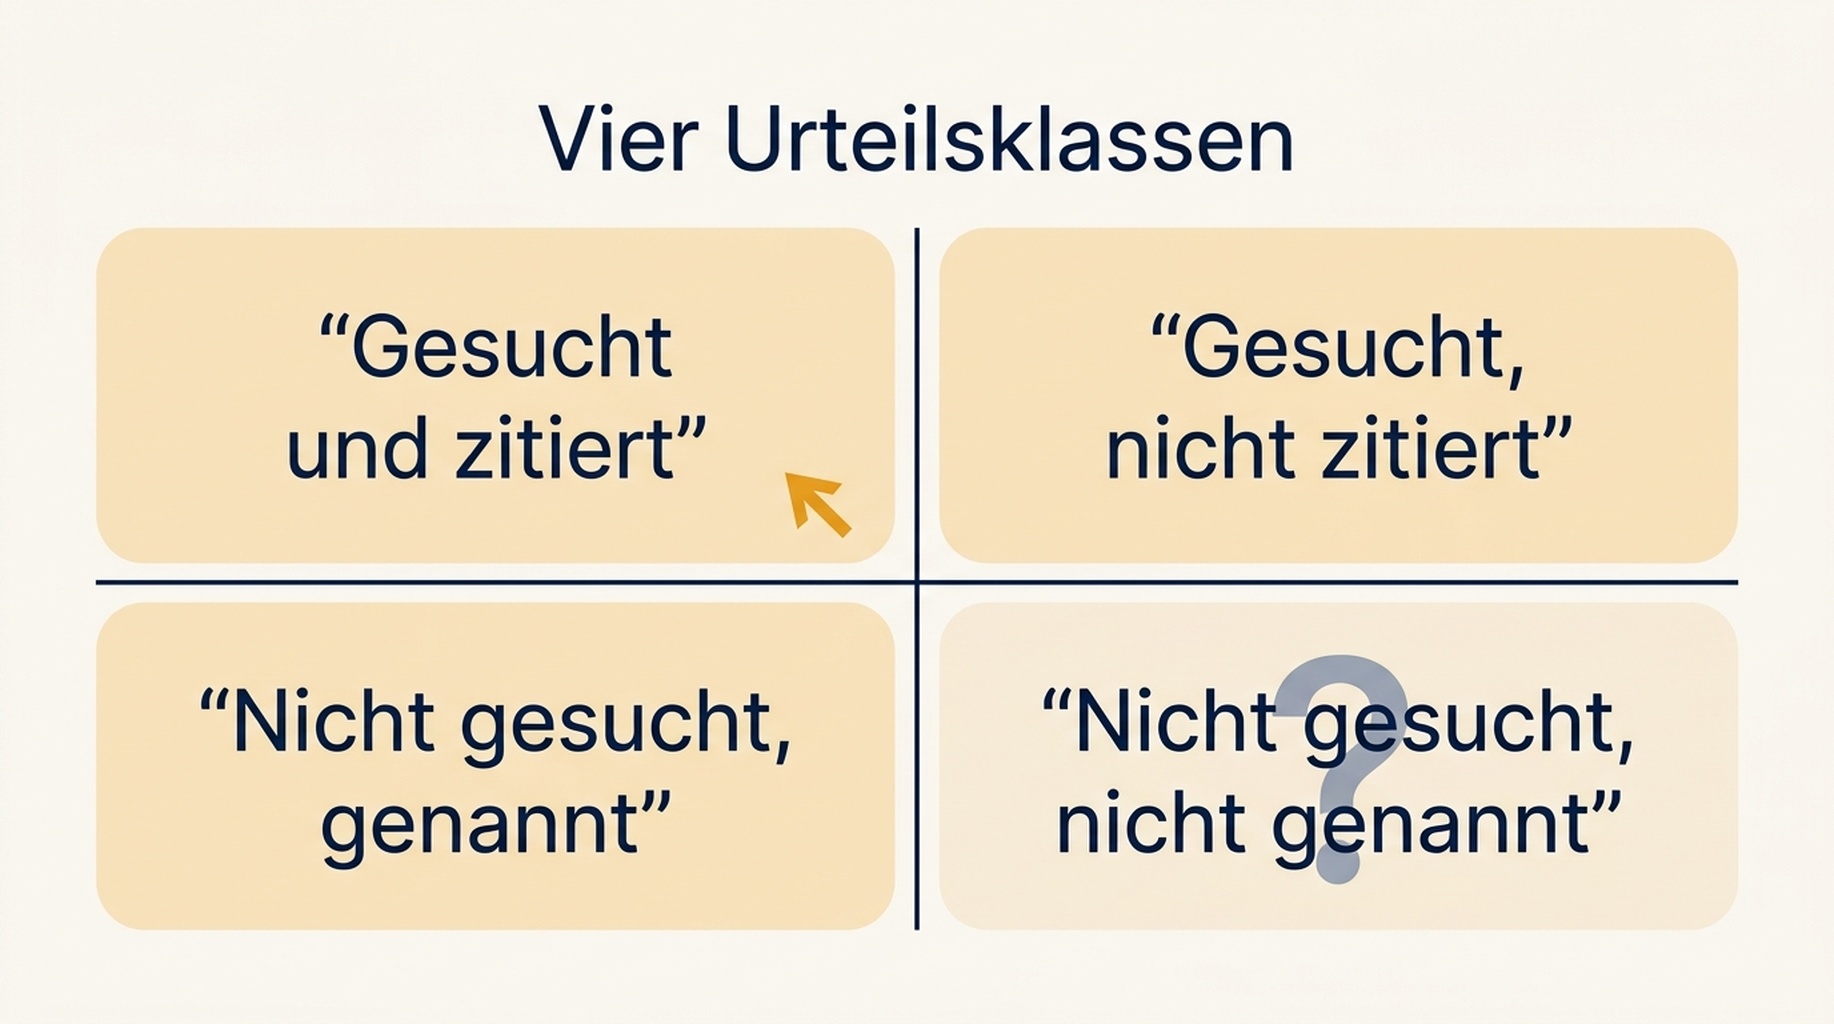
Ergebnis: ein Urteil pro Prompt plus Maßnahme. Qualitätskontrolle: Jedes Urteil „unsichtbar" muss an eine gestützte Antwort gebunden sein. Hält die Begründung eines Urteils nicht in einem Satz stand, führen Sie den Prompt erneut aus.
Schritt 5: Wiederholen Sie zwei Prompts, bevor Sie einer Veränderung trauen
Führen Sie mindestens zwei Prompts ein zweites Mal aus, in einer neuen Unterhaltung, und vergleichen Sie das Urteil, nicht die Zahl.
Prompt | Erster Lauf | Zweiter Lauf | Stabil |
|---|---|---|---|
Beste Werkzeuge für KI-Sichtbarkeit | gestützt, 13 Quellen, 6 Domains | gestützt, 14 Quellen, 4 Domains | Urteil ja, Zahl nein |
Bestes Werkzeug zur Markenbeobachtung | gestützt, 8 Quellen, 8 Domains | gestützt, 9 Quellen, 5 Domains | Urteil ja, Zahl nein |
Prüfe meine Marke in KI-Antworten | ungestützt, 0 Quellen | ungestützt, 0 Quellen | ja |
Wie oft ändern sich KI-Antworten | ungestützt, 0 Quellen | ungestützt, 0 Quellen | ja |
Bei allen fünf wiederholten Prompts stimmte die Suchentscheidung jedes Mal mit sich selbst überein, während sich die Domainzahl um zwei oder drei bewegte. Das ist die richtige Kalibrierung: Behandeln Sie das Urteil als Signal und die Zahl als Schätzung mit Bandbreite.
Ergebnis: eine Wiederholungszeile für mindestens zwei Prompts. Qualitätskontrolle: Kippt das Urteil zwischen Läufen bei einem unveränderten Prompt, markieren Sie den Prompt als instabil und nehmen Sie ihn aus dem Monatsbericht, bis er sich wiederholt.
Schritt 6: Setzen Sie die Prüfung auf einen Zeitplan
Eine Prüfung mit zehn Prompts kostet rund 0,29 Dollar beim aktuellen ChatGPT-Modell, etwa 1,27 Dollar im Monat bei wöchentlichem Lauf. Bei diesem Preis liegt die Arbeit nicht im API-Aufruf, sondern im Bewertungsmaßstab, also übergeben Sie den Job einem Agenten mit ausdrücklichen Erfassungsregeln, nicht einer Zusammenfassungsbitte.
Geben Sie dem Agenten diese Vorgaben:
- Erfassen Sie den Antworttext wörtlich und die Quellenliste wörtlich. Fassen Sie keines von beiden zusammen.
- Erfassen Sie das Stützungs-Flag, die Modellversion und den Zeitstempel in jeder Zeile.
- Berechnen Sie Zahlen im Code nach der Erfassung, niemals im Prompt.
- Schreiben Sie in eine datierte Datei, damit eine Wiederholung die Belege des Vormonats nicht überschreibt.
Wenn Sie bereits einen Agenten für Suchberichte betreiben, ist das Erfassungsmuster dasselbe wie beim täglichen SEO- und GEO-Monitoring mit Codex, und die Terminal-Version derselben Schleife steht im täglichen Monitoring mit Claude Code. Die einzige neue Anforderung hier ist das Stützungs-Flag, denn eine Chat-Oberfläche, die nicht gesucht hat, darf nicht als Zitationsergebnis gelesen werden.
Ergebnis: ein geplanter Job, der datierte Zeilen schreibt. Qualitätskontrolle: Öffnen Sie die Datei der Vorwoche und bestätigen Sie, dass Sie das Urteil allein aus den gespeicherten Belegen rekonstruieren können.
Verifikation: So sieht eine gültige Prüfung aus
- Jede Zeile trägt ein Stützungs-Flag, eine Modellversion und ein Datum.
- Jedes Urteil „unsichtbar" gehört zu einer gestützten Antwort.
- Mindestens zwei Prompts wurden zweimal ausgeführt und ihre Urteile verglichen.
- Der Rohtext der Antwort und die rohe Quellenliste liegen neben den Zahlen.
- Die Prompt-Liste ist nach Form markiert, und der Bericht gruppiert Ergebnisse nach Form, nicht nach Summe.
Grenzen
- Eine Modellversion, ein Ort, Englisch, ein Tag voller Läufe. Das Verhalten von ChatGPT unterscheidet sich zwischen Versionen.
- Die Websuche wurde über die API aktiviert. Die Verbraucher-App kann mit einem anderen Promptsatz suchen.
- Markennennung wurde per Textabgleich gemessen, ein Produktname ohne den Firmennamen kann also übersehen werden.
- Diese Prüfung misst Antworten, nicht Traffic. Verweisverhalten ist eine eigene Messung.
Häufige Fragen
Warum sagt ChatGPT nichts über meine Marke?
Prüfen Sie zuerst, ob es gesucht hat. In unserem Lauf beantwortete es 12 der 20 Prompts aus dem Gedächtnis, ohne Quellen, und solche Antworten können einen Anbieter aus alten Trainingsdaten nennen oder niemanden. Eine ungestützte Antwort ist kein Beleg für Ihre Sichtbarkeit.
Wie viele Prompts sollte ich in ChatGPT prüfen?
Acht bis zwölf pro Zyklus reichen, um das Muster zu sehen, sofern sie die Formen Kategorie, Vergleich, Problem und Beleg abdecken. Hundert Prompts geben eine größere Stichprobe derselben vier Formen, keine neue Information.
Lässt sich das ohne API prüfen?
Ja. Sowohl das Stützungs-Flag als auch die Markennennung sind in der Oberfläche sichtbar, und die Quellenliste unter einer Antwort deckt die Zitationshälfte ab. Die API zählt erst, wenn Sie datierte Zeilen und Wiederholungen ohne Handarbeit wollen.
Woran erkenne ich, ob eine Veränderung echt ist?
Wiederholen Sie den Prompt, bevor Sie eine Veränderung melden. In unseren fünf Wiederholungspaaren kippte die Suchentscheidung kein einziges Mal, während sich die Quellenzahlen um zwei oder drei bewegten. Ein Urteilswechsel bei einem gestützten Prompt ist eine Untersuchung wert. Ein Zahlenwechsel nicht.
Auspia-Sicht: Durchlaufen Sie das Gültigkeitstor, bevor Sie irgendeine Zahl lesen, und melden Sie das Urteil statt einer Zahl. Der häufigste Fehler, den wir gefunden haben, ist kein verpasstes Zitat, sondern eine leere ChatGPT-Antwort, die als Unsichtbarkeit gemeldet wird, obwohl das Modell gar nichts gesucht hat. Beheben Sie zuerst das Flag, dann wird der Rest des Berichts von Monat zu Monat vergleichbar.
Autor: Victor Lane