ถ้ามีคนถามว่าแบรนด์ของคุณปรากฏใน ChatGPT หรือไม่ คำตอบแรกที่ซื่อสัตย์คือ ผลลัพธ์ว่างเปล่ากับศูนย์จริงนั้นดูเหมือนกันทุกประการจนกว่าจะตรวจสิ่งหนึ่ง คู่มือนี้เขียนให้คนที่ต้องให้คำตอบนั้นโดยไม่มีแพลตฟอร์มติดตาม มีเพียงหน้าต่างแชต ชีตหนึ่งแผ่น และเวลาราวสามสิบนาที
เมื่ออ่านจบ คุณจะมีคำตัดสินต่อพรอมป์หนึ่งคำ สร้างบันทึกที่ทำซ้ำได้และใช้ป้องกันตัวในที่ประชุมได้ และมีงานตามกำหนดเวลาที่ทำให้มันเป็นปัจจุบัน เงื่อนไขการทำงานให้เสร็จนั้นง่าย คือ ทุกพรอมป์คุณบอกได้ว่าคำตอบนั้นมีการค้นหาหรือไม่ เอ่ยชื่อแบรนด์หรือไม่ และลิงก์ไปยังเว็บไซต์หรือไม่
เมื่อทำเสร็จคุณจะได้อะไร
ผลลัพธ์ | อยู่ที่ไหน |
|---|---|
รายการพรอมป์ 8 ถึง 12 ข้อ ที่เขียนจากบทสนทนาจริง | แท็บแรกของชีต |
หนึ่งแถวต่อหนึ่งพรอมป์ มีสี่ฟิลด์และเวอร์ชันโมเดล | แท็บเดียวกัน |
หนึ่งในสี่คำตัดสินต่อพรอมป์ พร้อมการดำเนินการที่ผูกไว้ | คอลัมน์คำตัดสิน |
การรันซ้ำอย่างน้อยสองพรอมป์ | แถวที่ 2 และ 3 ของชีตเดียวกัน |
การตรวจตามกำหนดเวลาที่มีเกณฑ์การให้คะแนนคงที่ | โฟลเดอร์โปรเจกต์ของเอเจนต์ |
สิ่งที่ต้องมีก่อนเริ่ม คือ สิทธิ์เข้าใช้ ChatGPT ที่เปิดการค้นหาเว็บ ชีตหนึ่งแผ่น และความสามารถในการใช้จ่ายราว 0.29 ดอลลาร์ต่อการรันสิบพรอมป์ หากคุณทำให้มันทำงานอัตโนมัติ
ขั้นที่ 1: เขียนพรอมป์จากบทสนทนา ไม่ใช่จากคำค้น
ดึงยี่สิบคำถามล่าสุดที่ทีมขายตอบไป แล้วจัดกลุ่ม ในงานศึกษาสองสิบพรอมป์ของเรา รายการแหล่งที่มากว้างที่สุดมาจากคำถามเรื่องจะถูกอ้างอิงได้อย่างไรตั้งแต่แรก และรายการที่แคบที่สุดมาจากการเทียบเครื่องมือแบบตัวต่อตัว หมายความว่ารูปของคำถามเป็นตัวกำหนดว่าจะได้ข้อมูลกลับมาเท่าไร
เขียนพรอมป์ 8 ถึง 12 ตัวครอบสี่รูป ได้แก่ หมวดหมู่ ("X ที่ดีที่สุดสำหรับ Y") การเปรียบเทียบ ("A กับ B") ปัญหา ("ฉันจะรู้ได้อย่างไรว่า AI รู้จักบริษัทของฉัน") และหลักฐาน ("ใครแนะนำ X ในปี 2026") เพิ่มพรอมป์อีกสองตัวที่เอ่ยชื่อแบรนด์ของคุณตรง ๆ เพราะมันมีพฤติกรรมต่างจากพรอมป์หมวดหมู่ ถ้าคุณอยากได้หลักฐานข้ามพื้นผิวสำหรับรายการเดียวกัน การวิเคราะห์เครื่องมือตรวจการมองเห็นใน AI แสดงว่าเกิดอะไรขึ้นเมื่อพรอมป์เดิมถูกส่งไปสามพื้นผิว
ผลลัพธ์: รายการพรอมป์สุดท้าย 8 ถึง 12 ตัว แต่ละตัวติดป้ายรูปของมัน การตรวจคุณภาพ: ทุกพรอมป์ต้องเป็นสิ่งที่ลูกค้าพิมพ์จริง ๆ ถ้าพรอมป์ใดมีอยู่เพียงเพราะมีคำค้นอยู่ในนั้น ให้ตัดทิ้ง
ขั้นที่ 2: ผ่านประตูความสมเหตุสมผลก่อนอ่านสิ่งอื่น
นี่คือขั้นที่การตรวจส่วนใหญ่ข้ามไป และเป็นเหตุผลที่ช่องว่างถูกรายงานเป็นศูนย์ ในการรันของเรา ChatGPT ส่งคำค้นใน 8 จาก 20 พรอมป์ และตอบอีก 12 ตัวจากความจำ
สิ่งที่เราสังเกต | คำตอบที่มีการค้นหา (8 พรอมป์) | คำตอบที่ไม่มีการค้นหา (12 พรอมป์) |
|---|---|---|
คำค้นที่ส่งออกไป | 4 ถึง 8 ต่อพรอมป์ | 0 |
คำอธิบายแหล่งที่มาที่ส่งกลับ | 6 ถึง 18 มัธยฐาน 12 | 0 |
โดเมนต่างกันที่ถูกอ้างอิง | 4 ถึง 10 มัธยฐาน 7 | 0 |
แบรนด์ที่ยังถูกเอ่ยถึงในเนื้อความ | ใช่ | ใช่ ใน 13 จาก 20 พรอมป์โดยรวม |
ก่อนจะบันทึกอะไรเกี่ยวกับแบรนด์ของคุณ ให้รันแต่ละพรอมป์แล้วตอบคำถามข้อเดียว: โมเดลค้นหาอะไรหรือไม่ ในหน้าจอ ChatGPT เบาะแสคือรายการแหล่งที่มาที่อยู่ใต้คำตอบ ถ้าไม่มีรายการแหล่งที่มา คำตอบนั้นสร้างจากความจำ และการที่มันเงียบเรื่องแบรนด์ของคุณยังไม่มีความหมายอะไร
ผลลัพธ์: ใช่หรือไม่ต่อพรอมป์ในคอลัมน์การค้นหา การตรวจคุณภาพ: คำตอบที่ไม่มีรายการแหล่งที่มาจะไม่ถูกบันทึกเป็นสัญญาณการมองเห็นเลย บันทึกเป็นสัญญาณความจำเท่านั้น คำตอบที่ไม่มีการค้นหาของเราก็ไม่ได้สั้นกว่าเช่นกัน มัธยฐานโทเคนเอาต์พุตอยู่ที่ 1,730 เทียบกับ 1,645 ของคำตอบที่มีการค้นหา ความยาวจึงไม่ใช่เบาะแสที่ใช้ได้
ขั้นที่ 3: บันทึกสี่ฟิลด์ ไม่ใช่ฟิลด์เดียว
ตัวเลขเดียวต่อพรอมป์คือเหตุผลที่รายงานขัดกันเอง เก็บสี่อย่างนี้ไว้
ฟิลด์ | ค่า | ทำไมจึงสำคัญ |
|---|---|---|
มีการค้นหา | ใช่หรือไม่ | ตัดสินว่าพรอมป์นั้นให้ลิงก์ได้หรือไม่ตั้งแต่แรก |
แบรนด์ถูกเอ่ยชื่อ | ใช่หรือไม่ | สัญญาณที่อยู่รอดในคำตอบที่ไม่มีการค้นหา |
โดเมนถูกลิงก์ | ใช่หรือไม่ | สัญญาณที่เครื่องมือส่วนใหญ่รายงานเพียงลำพัง |
เวอร์ชันโมเดล | เช่น gpt-5-2025-08-07 | พฤติกรรมขยับระหว่างเวอร์ชันในการรันของเรา |
ฟิลด์สุดท้ายไม่ใช่งานธุรการ พรอมป์ชุดเดิม 20 ตัวบนปลายทางเดิมส่งแหล่งที่มากลับมาเพียง 2 พรอมป์เมื่อใช้โมเดลรุ่นเก่า เทียบกับ 8 ตัวเมื่อใช้รุ่นปัจจุบัน รายงานที่ไม่มีเวอร์ชันโมเดลเทียบกับเดือนหน้าไม่ได้
ผลลัพธ์: สี่ฟิลด์ที่กรอกครบต่อพรอมป์ การตรวจคุณภาพ: ถ้ามีช่องใดว่าง แถวนั้นรายงานไม่ได้ เก็บข้อความคำตอบดิบและรายการแหล่งที่มาดิบไว้ข้างฟิลด์ เพื่อให้ผู้ตรวจย้อนดูคำตัดสินได้โดยไม่ต้องรันพรอมป์ใหม่
ขั้นที่ 4: จัดคำตอบแต่ละอันเข้าคำตัดสินหนึ่งในสี่
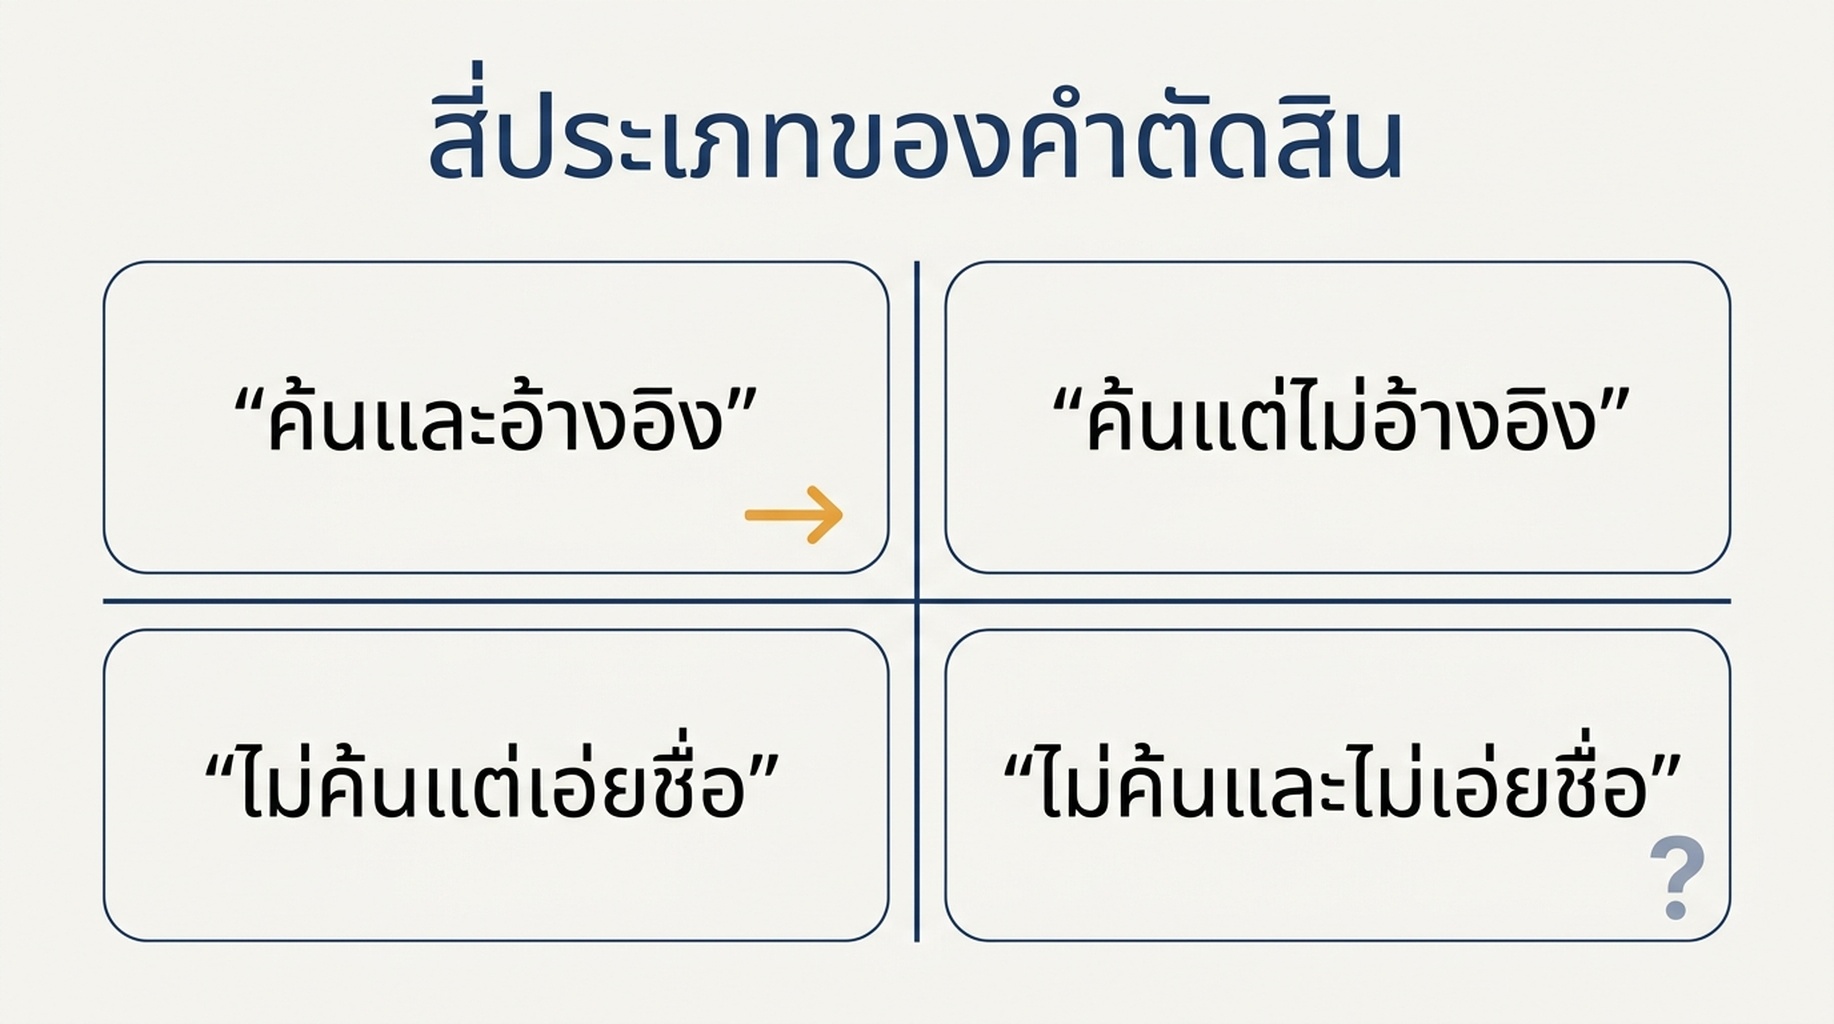
คำตัดสิน | ความหมาย | ต้องทำอะไรต่อ |
|---|---|---|
มีการค้นหาและมีลิงก์ | ChatGPT ค้นหาบางอย่างและอ้างอิงโดเมนของคุณ | ปกป้องหน้าที่ถูกอ้างอิงและดูว่ารูปแบบคำถามใดทำให้เกิดสิ่งนั้น |
มีการค้นหาแต่ไม่มีลิงก์ | มันค้นหา อ่านเว็บ และแนะนำเจ้าอื่น | ช่องว่างอยู่ที่เนื้อหาและความครอบคลุมของแหล่งที่มา ไม่ใช่ความรู้ของโมเดล |
ไม่มีการค้นหาแต่ถูกเอ่ยชื่อ | มันตอบจากความจำและยังเอ่ยชื่อคุณ | ไม่มีอะไรต้องแก้ รันซ้ำภายหลังด้วยพรอมป์เดิมเพื่อดูว่ามันเริ่มค้นหาหรือยัง |
ไม่มีการค้นหาและไม่ถูกเอ่ยชื่อ | มันตอบจากความจำและไม่เอ่ยชื่อคุณ | ยังไม่ใช่สัญญาณ แก้พรอมป์หรือรอการรันที่มีการค้นหา |
แถวที่สี่คือที่มาของการเตือนผิดส่วนใหญ่ ในข้อมูลของเรา คำตอบ ChatGPT 13 จาก 20 ตัวเอ่ยชื่อผู้ให้บริการอย่างน้อยหนึ่งราย ขณะที่มีเพียง 8 จาก 20 ตัวที่อ้างอิงอะไรเลย ซึ่งหมายความว่าคำตอบจำนวนหนึ่งจะดูว่างเปล่าสำหรับการตรวจที่อ่านแต่ลิงก์ ในขณะที่ข้อความเดียวกันกำลังเอ่ยชื่อแบรนด์
ผลลัพธ์: หนึ่งคำตัดสินต่อพรอมป์ บวกการดำเนินการ การตรวจคุณภาพ: คำตัดสิน "มองไม่เห็น" ทุกอันต้องผูกกับคำตอบที่มีการค้นหา ถ้าเหตุผลเบื้องหลังคำตัดสินทนการเขียนเป็นประโยคเดียวไม่ได้ ให้รันพรอมป์ใหม่
ขั้นที่ 5: รันสองพรอมป์ซ้ำก่อนเชื่อการเปลี่ยนแปลง
รันอย่างน้อยสองพรอมป์เป็นครั้งที่สองในบทสนทนาใหม่ แล้วเทียบคำตัดสินไม่ใช่ตัวเลข
พรอมป์ | รันครั้งแรก | รันครั้งที่สอง | เสถียร |
|---|---|---|---|
เครื่องมือดูการมองเห็นใน AI ที่ดีที่สุด | มีการค้นหา 13 แหล่ง 6 โดเมน | มีการค้นหา 14 แหล่ง 4 โดเมน | คำตัดสินคงที่ ตัวเลขไม่คงที่ |
เครื่องมือที่ดีที่สุดในการติดตามการเอ่ยถึงแบรนด์ | มีการค้นหา 8 แหล่ง 8 โดเมน | มีการค้นหา 9 แหล่ง 5 โดเมน | คำตัดสินคงที่ ตัวเลขไม่คงที่ |
ตรวจสอบแบรนด์ของฉันในคำตอบ AI | ไม่มีการค้นหา 0 แหล่ง | ไม่มีการค้นหา 0 แหล่ง | คงที่ |
คำตอบ AI เปลี่ยนแปลงบ่อยแค่ไหน | ไม่มีการค้นหา 0 แหล่ง | ไม่มีการค้นหา 0 แหล่ง | คงที่ |
ในห้าพรอมป์ที่เรารันซ้ำ การตัดสินใจว่าจะค้นหาหรือไม่ตรงกับตัวเองทุกครั้ง ขณะที่จำนวนโดเมนขยับไปสองหรือสาม นี่คือการปรับเทียบที่ถูกต้อง มองคำตัดสินเป็นสัญญาณ และมองตัวเลขเป็นค่าประมาณที่มีช่วง
ผลลัพธ์: แถวการรันซ้ำอย่างน้อยสองพรอมป์ การตรวจคุณภาพ: ถ้าคำตัดสินพลิกกลับระหว่างการรันบนพรอมป์ที่ไม่เปลี่ยน ให้ทำเครื่องหมายว่าพรอมป์นั้นไม่เสถียรและตัดออกจากรายงานเดือนต่อเดือนจนกว่าจะทำซ้ำได้
ขั้นที่ 6: ใส่การตรวจลงในตารางเวลา
การตรวจสิบพรอมป์มีค่าใช้จ่ายราว 0.29 ดอลลาร์บนโมเดล ChatGPT ปัจจุบัน ประมาณ 1.27 ดอลลาร์ต่อเดือนถ้ารันทุกสัปดาห์ ในราคานั้น งานไม่ใช่การเรียก API แต่เป็นเกณฑ์การให้คะแนน ดังนั้นมอบงานนี้ให้เอเจนต์ที่มีกฎการเก็บข้อมูลชัดเจน ไม่ใช่คำขอให้สรุป
มอบข้อจำกัดเหล่านี้ให้เอเจนต์
- เก็บข้อความคำตอบแบบคำต่อคำและรายการแหล่งที่มาแบบคำต่อคำ ไม่สรุปทั้งสองอย่าง
- บันทึกธงการค้นหา เวอร์ชันโมเดล และเวลากำกับในทุกแถว
- คำนวณตัวเลขในโค้ดหลังการเก็บข้อมูล ไม่คำนวณในพรอมป์เด็ดขาด
- เขียนลงไฟล์ที่ติดวันที่ เพื่อให้การรันซ้ำเขียนทับหลักฐานของเดือนก่อนไม่ได้
ถ้าคุณรันเอเจนต์สำหรับรายงานการค้นหาอยู่แล้ว รูปแบบการเก็บข้อมูลก็แบบเดียวกับที่ใช้ในการติดตาม SEO และ GEO รายวันด้วย Codex และเวอร์ชันเทอร์มินัลของลูปเดียวกันอยู่ในการติดตามรายวันด้วย Claude Code ข้อกำหนดใหม่เดียวตรงนี้คือธงการค้นหา เพราะพื้นผิวแชตที่ไม่ได้ค้นหาต้องไม่ถูกอ่านเป็นผลการอ้างอิง
ผลลัพธ์: งานตามกำหนดเวลาที่เขียนแถวติดวันที่ การตรวจคุณภาพ: เปิดไฟล์ของสัปดาห์ที่แล้วและยืนยันว่าคุณสร้างคำตัดสินกลับขึ้นมาได้จากหลักฐานที่เก็บไว้เพียงอย่างเดียว
การยืนยัน: การตรวจที่ใช้ได้มีหน้าตาแบบนี้
- ทุกแถวมีธงการค้นหา เวอร์ชันโมเดล และวันที่
- คำตัดสิน "มองไม่เห็น" ทุกอันเป็นของคำตอบที่มีการค้นหา
- อย่างน้อยสองพรอมป์ถูกรันสองครั้งและคำตัดสินถูกนำมาเทียบกัน
- ข้อความคำตอบดิบและรายการแหล่งที่มาดิบถูกเก็บไว้ข้างตัวเลข
- รายการพรอมป์ติดป้ายตามรูป และรายงานจัดกลุ่มผลตามรูปไม่ใช่ตามยอดรวม
ข้อจำกัด
- โมเดลเวอร์ชันเดียว สถานที่เดียว ภาษาอังกฤษ และการรันหนึ่งวัน พฤติกรรมของ ChatGPT ต่างกันระหว่างเวอร์ชัน
- เปิดการค้นหาเว็บผ่าน API แอปสำหรับผู้ใช้ทั่วไปอาจค้นหาบนชุดพรอมป์ที่ต่างออกไป
- การเอ่ยชื่อแบรนด์วัดด้วยการจับคู่ข้อความ ชื่อสินค้าที่ไม่มีชื่อบริษัทจึงอาจถูกมองข้ามได้
- การตรวจนี้วัดคำตอบ ไม่ได้วัดทราฟฟิก พฤติกรรมการส่งต่อเป็นการวัดคนละอย่าง
คำถามที่พบบ่อย
ทำไม ChatGPT ไม่พูดอะไรเกี่ยวกับแบรนด์ของฉัน?
ตรวจก่อนว่ามันค้นหาหรือไม่ ในการรันของเรา มันตอบจากความจำโดยไม่มีแหล่งที่มา 12 จาก 20 พรอมป์ และคำตอบเหล่านั้นอาจเอ่ยชื่อผู้ให้บริการจากข้อมูลฝึกที่เก่า หรือไม่เอ่ยใครเลย คำตอบที่ไม่มีการค้นหาไม่ใช่หลักฐานเกี่ยวกับการมองเห็นของคุณ
ควรตรวจกี่พรอมป์ใน ChatGPT?
แปดถึงสิบสองตัวต่อรอบก็พอเห็นรูปแบบ โดยต้องครอบสี่รูปคือ หมวดหมู่ การเปรียบเทียบ ปัญหา และหลักฐาน การรันร้อยพรอมป์ให้ตัวอย่างที่ใหญ่ขึ้นของสี่รูปแบบเดิม ไม่ใช่ข้อมูลใหม่
ตรวจสิ่งนี้โดยไม่มี API ได้ไหม?
ได้ ทั้งธงการค้นหาและการเอ่ยชื่อแบรนด์มองเห็นได้ในหน้าจอ และรายการแหล่งที่มาใต้คำตอบก็ครอบคลุมครึ่งที่เป็นการอ้างอิง API สำคัญก็ต่อเมื่อคุณต้องการแถวติดวันที่และการรันซ้ำโดยไม่ต้องคัดลอกด้วยมือ
ฉันจะรู้ได้อย่างไรว่าการเปลี่ยนแปลงเป็นของจริง?
รันพรอมป์ซ้ำก่อนรายงานการเปลี่ยนแปลง ในห้าคู่ที่เรารันซ้ำ การตัดสินใจค้นหาไม่เคยพลิกกลับเลย ขณะที่จำนวนแหล่งที่มาขยับไปสองหรือสาม คำตัดสินที่เปลี่ยนบนพรอมป์ที่มีการค้นหาควรค่าแก่การตรวจสอบ ส่วนตัวเลขที่เปลี่ยนไม่ควร
มุมมองของ Auspia: ผ่านประตูความสมเหตุสมผลก่อนอ่านตัวเลขใด ๆ และรายงานคำตัดสินไม่ใช่ตัวเลข ข้อผิดพลาดที่พบบ่อยที่สุดที่เราเจอไม่ใช่การอ้างอิงที่พลาดไป แต่เป็นคำตอบ ChatGPT ที่ว่างเปล่าถูกรายงานว่า "มองไม่เห็น" ทั้งที่โมเดลไม่ได้ค้นหาอะไรเลย แก้ธงก่อน ส่วนที่เหลือของรายงานจะเทียบกันได้เดือนต่อเดือน
ผู้เขียน: วิกเตอร์ เลน