إذا سألك أحدهم إن كانت علامتك التجارية تظهر في ChatGPT، فأول جواب صادق هو أن النتيجة الفارغة والصفر الحقيقي يبدوان متطابقين حتى تتحقق من أمر واحد. هذا الدليل موجّه لكل من عليه أن يقدّم ذلك الجواب بلا منصة مراقبة، ولا يملك سوى نافذة محادثة وجدول بيانات ونحو ثلاثين دقيقة.
بحلول النهاية سيكون لديك حكم لكل مُدخل، وسجل قابل للتكرار تستطيع الدفاع عنه في اجتماع، ومهمة مجدولة تُبقيه محدثاً. شرط الإتمام بسيط: أن تستطيع، لكل مُدخل، أن تقول هل كان الجواب مُسنَداً، وهل ذكر العلامة، وهل ربط بالموقع.
ما سيكون بيدك عند الانتهاء
المُخرَج | مكانه |
|---|---|
قائمة من 8 إلى 12 مُدخلاً مكتوبة من محادثات حقيقية | التبويب الأول في جدولك |
صف واحد لكل مُدخل بأربعة حقول وإصدار النموذج | التبويب نفسه |
واحد من أربعة أحكام لكل مُدخل، مع الإجراء المرتبط به | عمود الحكم |
إعادة تشغيل لمُدخلين على الأقل | الصفان 2 و3 في الجدول نفسه |
فحص مجدول بمعيار تقييم ثابت | مجلد مشروع الوكيل |
المتطلبات المسبقة: وصول إلى ChatGPT مع البحث في الويب، وجدول بيانات، والقدرة على إنفاق نحو 0.29 دولار على تشغيل من عشرة مُدخلات إن أتمتته.
الخطوة 1: اكتب المُدخلات من المحادثات، لا من الكلمات المفتاحية
استخرج آخر عشرين سؤالاً أجاب عنها فريق المبيعات، ثم صنّفها في مجموعات. في دراستنا للعشرين مُدخلاً جاء أوسع قائمة مصادر من سؤال عن كيفية الاستشهاد بك أصلاً، وجاءت أضيق قائمة من مقارنة مباشرة بين أداتين، أي أن شكل السؤال هو ما يحدد حجم البيانات التي تعود إليك.
اكتب 8 إلى 12 مُدخلاً موزعة على أربعة أشكال: الفئة («أفضل X من أجل Y»)، والمقارنة («A مقابل B»)، والمشكلة («كيف أعرف إن كان الذكاء الاصطناعي يعرف شركتي»)، والإثبات («من يوصي بـ X في 2026»). وأضف مُدخلين يذكران علامتك بالاسم مباشرة، لأن سلوكهما يختلف عن مُدخلات الفئة. وإن أردت دليلاً من عدة أسطح للقائمة نفسها، فـتحليل مدقّق الظهور في الذكاء الاصطناعي يوضّح ما يتغير حين يذهب المُدخل نفسه إلى ثلاثة أسطح.
المُخرَج: قائمة نهائية من 8 إلى 12 مُدخلاً، كل واحد موسوم بشكله. فحص الجودة: يجب أن يكون كل مُدخل مما يكتبه عميل فعلاً. وإن كان المُدخل موجوداً فقط لأنه يحتوي كلمة مفتاحية، فاحذفه.
الخطوة 2: شغّل بوابة الصلاحية قبل أن تقرأ أي شيء آخر
هذه هي الخطوة التي تتخطاها معظم الفحوص، وهي سبب الإبلاغ عن الفراغات كأصفار. في تشغيلنا أصدر ChatGPT استعلامات بحث في 8 من 20 مُدخلاً، وأجاب عن الاثني عشر الباقية من الذاكرة.
ما لاحظناه | أجوبة مُسنَدة (8 مُدخلات) | أجوبة غير مُسنَدة (12 مُدخلاً) |
|---|---|---|
استعلامات بحث صادرة | 4 إلى 8 لكل مُدخل | 0 |
إشارات المصادر المُعادة | 6 إلى 18، الوسيط 12 | 0 |
النطاقات المتميزة المستشهد بها | 4 إلى 10، الوسيط 7 | 0 |
علامات تجارية ذُكرت في النص | نعم | نعم، في 13 من 20 مُدخلاً إجمالاً |
قبل أن تسجّل أي شيء عن علامتك، شغّل كل مُدخل وأجب عن سؤال واحد: هل بحث النموذج عن أي شيء؟ في واجهة ChatGPT تكون العلامة الدالة هي قائمة المصادر أسفل الجواب. وإن لم توجد قائمة مصادر، فالجواب أُنتج من الذاكرة، وصمته عن علامتك لا يعني شيئاً بعد.
المُخرَج: نعم أو لا لكل مُدخل في عمود الإسناد. فحص الجودة: الجواب بلا قائمة مصادر لا يُسجَّل أبداً كإشارة ظهور، بل كإشارة ذاكرة فقط. ولم تكن أجوبتنا غير المُسنَدة أقصر أيضاً، إذ بلغ وسيط رموز المُخرَج 1,730 مقابل 1,645 للمُسنَدة، أي أن الطول ليس علامة دالة صالحة.
الخطوة 3: سجّل أربعة حقول، لا حقلاً واحداً
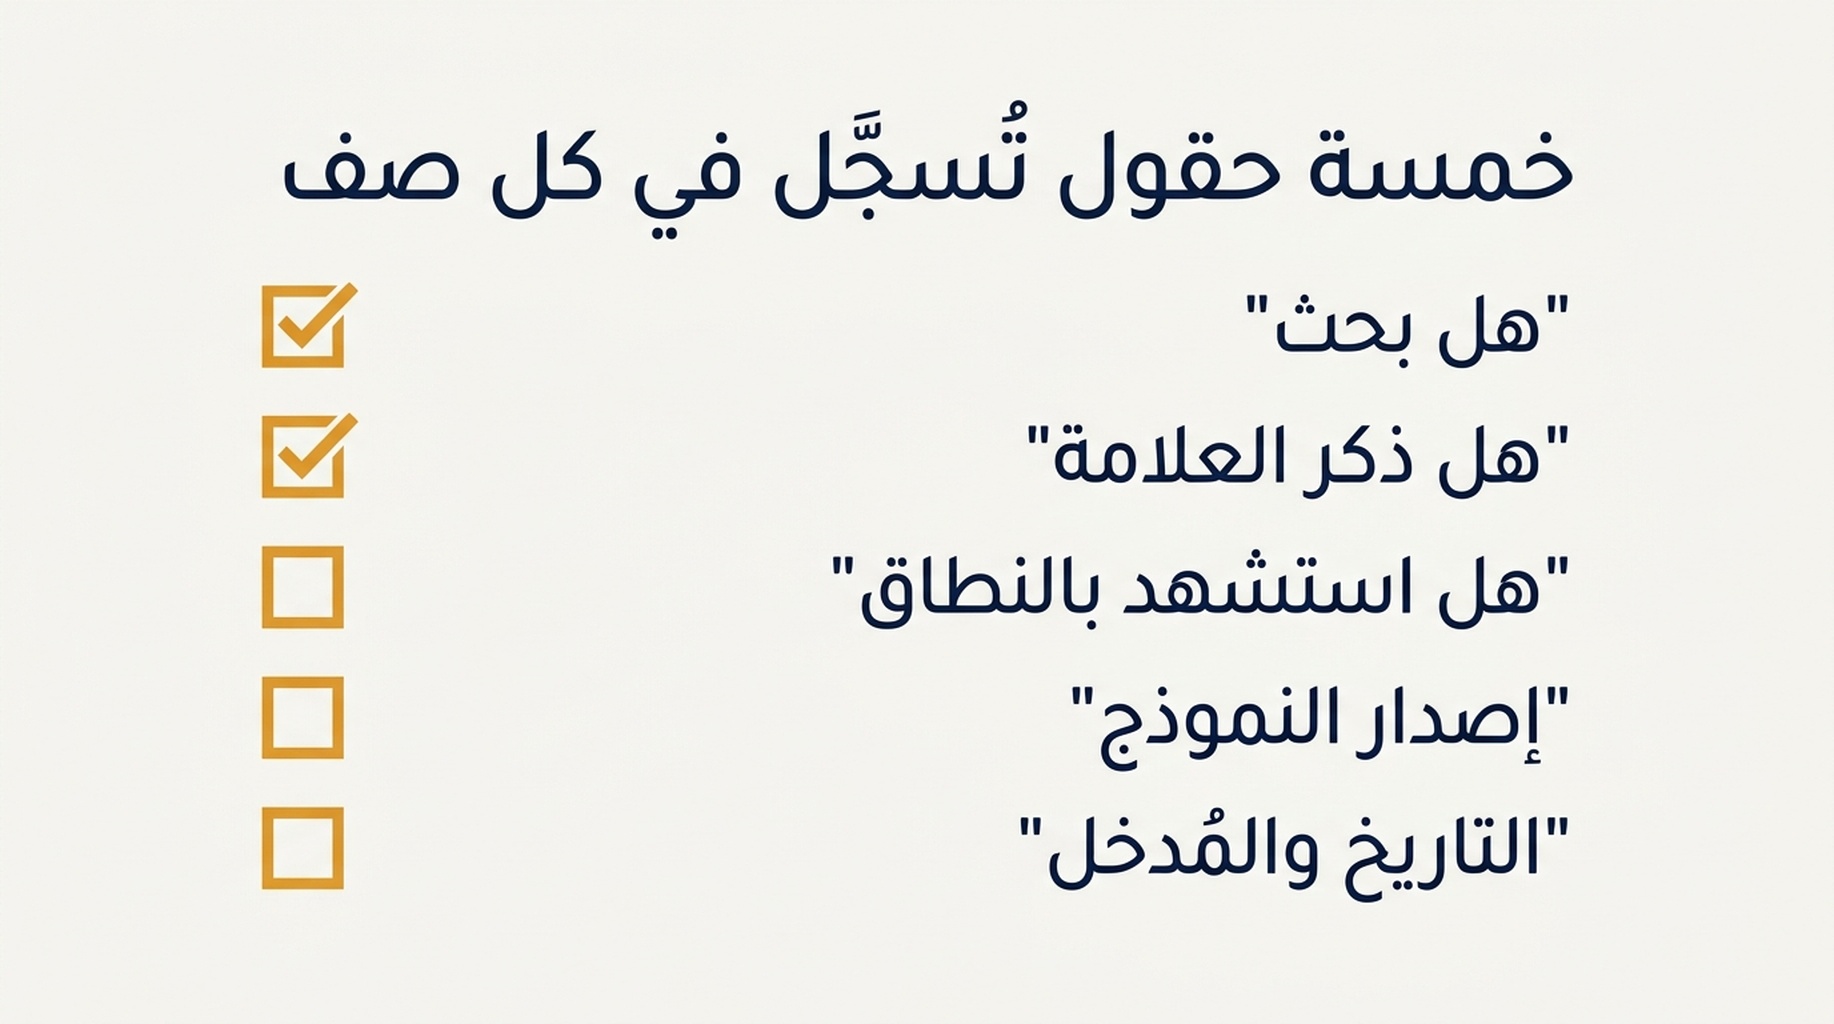
رقم واحد لكل مُدخل هو سبب تناقض التقارير. أبقِ هذه الأربعة.
الحقل | القيمة | لماذا يهم |
|---|---|---|
مُسنَد | نعم أو لا | يحدد ما إذا كان المُدخل قادراً على إنتاج رابط أصلاً |
ذُكرت العلامة | نعم أو لا | الإشارة التي تبقى في جواب غير مُسنَد |
رُبط النطاق | نعم أو لا | الإشارة التي تُبلّغ عنها معظم الأدوات وحدها |
إصدار النموذج | مثلاً gpt-5-2025-08-07 | تحرّك السلوك بين الإصدارات في تشغيلاتنا |
الحقل الأخير ليس عملاً إدارياً. العشرون مُدخلاً نفسها، على النقطة الطرفية نفسها، أعادت المصادر في مُدخلين فقط مع نموذج أقدم، مقابل 8 مع النموذج الحالي. وتقرير بلا إصدار نموذج لا يمكن مقارنته بتقرير الشهر القادم.
المُخرَج: أربعة حقول مكتملة لكل مُدخل. فحص الجودة: إن كانت أي خلية فارغة، فلا يمكن التبليغ عن ذلك الصف. واحفظ نص الجواب الخام وقائمة المصادر الخام إلى جانب الحقول، ليتمكن المراجع من إعادة التحقق من الحكم دون إعادة تشغيل المُدخل.
الخطوة 4: صنّف كل جواب في واحد من أربعة أحكام
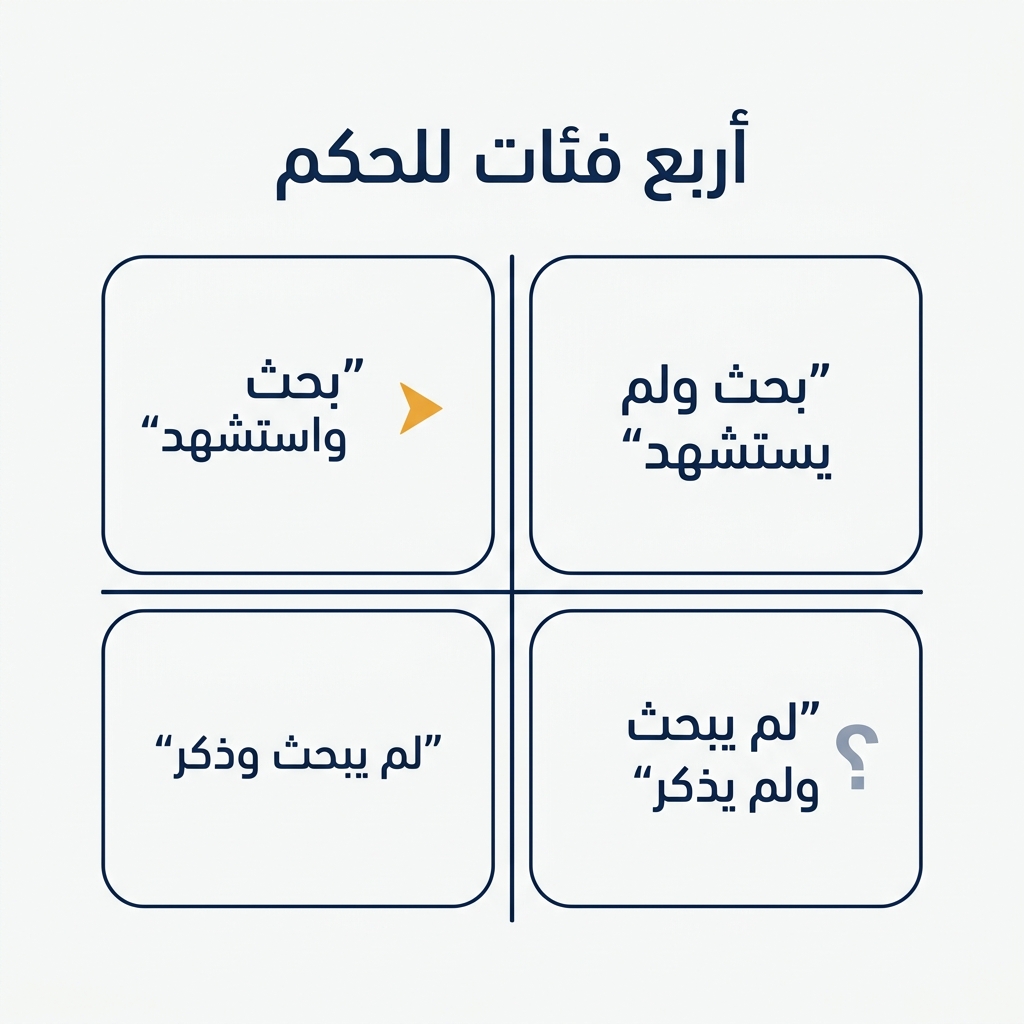
الحكم | معناه | ما العمل بعده |
|---|---|---|
مُسنَد ومرتبط | بحث ChatGPT عن شيء واستشهد بنطاقك | احمِ الصفحة المستشهد بها وتحقق من شكل السؤال الذي أنتجها |
مُسنَد وغير مرتبط | بحث وقرأ الويب وأوصى بغيرك | الفجوة في المحتوى وتغطية المصادر، لا في معرفة النموذج |
غير مُسنَد ومذكور | أجاب من الذاكرة وذكرك مع ذلك | لا شيء يُصلَح. أعد التشغيل لاحقاً بالمُدخل نفسه لترى إن بدأ يبحث |
غير مُسنَد وغير مذكور | أجاب من الذاكرة ولم يذكرك | ليس إشارة بعد. صحّح المُدخل أو انتظر تشغيلاً مُسنَداً |
الصف الرابع هو مصدر معظم الإنذارات الكاذبة. في بياناتنا ذكرت 13 من 20 جواباً لـChatGPT مورّداً واحداً على الأقل، بينما استشهد 8 من 20 فقط بأي شيء، أي أن جزءاً من الأجوبة سيبدو فارغاً لفحص لا يقرأ إلا الروابط، في حين أن النص نفسه يذكر علامات تجارية.
المُخرَج: حكم واحد لكل مُدخل، مع الإجراء. فحص الجودة: أي حكم بـ«غير مرئي» يجب أن يرتبط بجواب مُسنَد. وإن كان منطق الحكم لا يصمد مكتوباً في جملة واحدة، فأعد تشغيل المُدخل.
الخطوة 5: أعد تشغيل مُدخلين قبل أن تثق بأي تغيّر
شغّل مُدخلين على الأقل مرة ثانية في محادثة جديدة، وقارن الحكم لا العدد.
المُدخل | التشغيل الأول | التشغيل الثاني | مستقر |
|---|---|---|---|
أفضل أدوات الظهور في الذكاء الاصطناعي | مُسنَد، 13 مصدراً، 6 نطاقات | مُسنَد، 14 مصدراً، 4 نطاقات | الحكم نعم، العدد لا |
أفضل أداة لتتبع ذكر العلامة | مُسنَد، 8 مصادر، 8 نطاقات | مُسنَد، 9 مصادر، 5 نطاقات | الحكم نعم، العدد لا |
دقّق علامتي في أجوبة الذكاء الاصطناعي | غير مُسنَد، 0 مصادر | غير مُسنَد، 0 مصادر | نعم |
كم مرة تتغير أجوبة الذكاء الاصطناعي | غير مُسنَد، 0 مصادر | غير مُسنَد، 0 مصادر | نعم |
عبر المُدخلات الخمسة التي أعدنا تشغيلها، اتفق قرار البحث مع نفسه في كل مرة، بينما تحرك عدد النطاقات بمقدار اثنين أو ثلاثة. هذا هو المعايرة الصحيحة: عامل الحكم كإشارة، والعدد كتقدير له مدى.
المُخرَج: صف إعادة تشغيل لمُدخلين على الأقل. فحص الجودة: إن انقلب الحكم بين تشغيلين على مُدخل لم يتغير، فوسم المُدخل بأنه غير مستقر واستبعده من التقارير الشهرية حتى يتكرر.
الخطوة 6: ضع الفحص في جدول زمني
فحص من عشرة مُدخلات يكلّف نحو 0.29 دولار على نموذج ChatGPT الحالي، أي نحو 1.27 دولار شهرياً إن شغّلته أسبوعياً. وبهذا السعر يصبح العمل ليس نداء الـAPI، بل معيار التقييم، لذا سلّم المهمة إلى وكيل بقيود جمع صريحة، لا إلى طلب تلخيص.
سلّم الوكيل هذه القيود:
- التقط نص الجواب حرفياً وقائمة المصادر حرفياً. ولا تلخّص أياً منهما.
- سجّل راية الإسناد وإصدار النموذج والطابع الزمني في كل صف.
- احسب الأعداد في الكود بعد الجمع، لا داخل المُدخل أبداً.
- اكتب إلى ملف بتاريخ محدد، حتى لا تمسح إعادة التشغيل أدلة الشهر الماضي.
إن كنت تشغّل وكيلاً لتقارير البحث، فنمط الجمع هو نفسه المستخدم في المراقبة اليومية لتحسين محركات البحث وGEO عبر Codex، والنسخة الطرفية من الحلقة نفسها في المراقبة اليومية عبر Claude Code. والمطلب الجديد الوحيد هنا هو راية الإسناد، لأن سطح محادثة لم يبحث لا يجوز أن يُقرأ كنتيجة استشهاد.
المُخرَج: مهمة مجدولة تكتب صفوفاً بتاريخ محدد. فحص الجودة: افتح ملف الأسبوع الماضي وتأكد أنك تستطيع إعادة بناء الحكم من الأدلة المحفوظة وحدها.
التحقق: هكذا يبدو فحص صالح
- كل صف يحمل راية إسناد وإصدار نموذج وتاريخاً.
- كل حكم بـ«غير مرئي» ينتمي إلى جواب مُسنَد.
- أُعيد تشغيل مُدخلين على الأقل وقُورنت أحكامهما.
- نص الجواب الخام وقائمة المصادر الخام محفوظان بجوار الأعداد.
- قائمة المُدخلات موسومة بالشكل، والتقرير يجمع النتائج بالشكل لا بالإجمالي.
الحدود
- إصدار نموذج واحد، وموقع واحد، واللغة الإنجليزية، ويوم واحد من التشغيلات. يختلف سلوك ChatGPT بين الإصدارات.
- فُعّل البحث في الويب عبر واجهة برمجية. وقد يبحث تطبيق المستهلك في مجموعة مُدخلات مختلفة.
- قيس ذكر العلامة بمطابقة النصوص، لذا قد يفوتنا اسم منتج بلا اسم الشركة.
- هذا الفحص يقيس الأجوبة لا الزيارات. سلوك الإحالة قياس منفصل.
الأسئلة الشائعة
لماذا لا يقول ChatGPT شيئاً عن علامتي التجارية؟
تحقق أولاً مما إذا كان قد بحث. في تشغيلنا أجاب عن 12 من 20 مُدخلاً من الذاكرة بلا مصادر، وتلك الأجوبة قد تذكر مورّداً من بيانات تدريب قديمة أو لا تذكر أحداً إطلاقاً. والجواب غير المُسنَد ليس دليلاً على ظهورك.
كم مُدخلاً يجب أن أفحص في ChatGPT؟
ثمانية إلى اثني عشر في كل دورة تكفي لرؤية النمط، بشرط أن تغطي أشكال الفئة والمقارنة والمشكلة والإثبات. وتشغيل مئة مُدخل يمنحك عينة أكبر من الأشكال الأربعة نفسها، لا معلومة جديدة.
هل أستطيع فحص هذا بلا واجهة برمجية؟
نعم. فراية الإسناد وذكر العلامة كلاهما مرئي في الواجهة، وقائمة المصادر أسفل الجواب تغطي نصف الاستشهاد. والواجهة البرمجية لا تهم إلا حين تريد صفوفاً بتاريخ محدد وإعادة تشغيل بلا نسخ يدوي.
كيف أعرف أن التغيّر حقيقي؟
أعد تشغيل المُدخل قبل أن تبلّغ عن تغيّر. في أزواج الإعادة الخمسة، لم ينقلب قرار البحث مرة واحدة، بينما تحركت أعداد المصادر بمقدار اثنين أو ثلاثة. وتغيّر الحكم على مُدخل مُسنَد يستحق التحقيق. أما تغيّر العدد فلا.
رأي Auspia: شغّل بوابة الصلاحية قبل أن تقرأ أي رقم، وبلّغ عن الحكم لا عن عدد. وأكثر خطأ وجدناه ليس استشهاداً فائتاً، بل جواب ChatGPT فارغ يُبلَّغ عنه كغياب ظهور بينما النموذج لم يبحث عن أي شيء. أصلح الراية أولاً، وسيصبح باقي التقرير قابلاً للمقارنة شهراً بشهر.
الكاتب/ة: فيكتور لين