Если вас спросили, появляется ли ваш бренд в ChatGPT, честный первый ответ такой: пустой результат и настоящий ноль выглядят одинаково, пока не проверишь одну вещь. Это руководство для тех, кому нужно выдать этот ответ без платформы мониторинга, имея только окно чата, таблицу и примерно тридцать минут.
К концу у вас будет вердикт по каждому запросу, воспроизводимая запись, которую можно защитить на совещании, и задача по расписанию, которая держит её актуальной. Условие завершения простое: по каждому запросу вы можете сказать, был ли ответ обоснован, назвал ли он бренд и сослался ли он на сайт.
Что у вас будет на выходе
Результат | Где он лежит |
|---|---|
Список из 8–12 запросов, написанных из реальных разговоров | Первая вкладка таблицы |
Одна строка на запрос с четырьмя полями и версией модели | Та же вкладка |
Один из четырёх вердиктов на запрос с привязанным действием | Столбец вердикта |
Повторный прогон как минимум двух запросов | Строки 2 и 3 той же таблицы |
Проверка по расписанию с фиксированным критерием оценки | Папка проекта агента |
Что нужно заранее: доступ к ChatGPT с веб-поиском, таблица и возможность потратить около 0,29 доллара на прогон из десяти запросов, если вы его автоматизируете.
Шаг 1: пишите запросы из разговоров, а не из ключевых слов
Поднимите последние двадцать вопросов, на которые отвечала команда продаж, и сгруппируйте их. В нашем исследовании двадцати запросов самый широкий список источников дал вопрос о том, как вообще добиться цитирования, а самый узкий — прямое сравнение двух инструментов, то есть форма вопроса определяет, сколько данных вам вернётся.
Напишите 8–12 запросов по четырём формам: категория («лучший X для Y»), сравнение («A против B»), проблема («как узнать, знает ли ИИ мою компанию») и доказательство («кто рекомендует X в 2026 году»). Добавьте два запроса, которые прямо называют ваш бренд: они ведут себя иначе, чем категорийные. Если для того же списка нужны доказательства с нескольких поверхностей, анализ чекера видимости в ИИ показывает, что меняется, когда один и тот же запрос уходит на три поверхности.
Результат: итоговый список из 8–12 запросов, каждый помечен своей формой. Проверка качества: каждый запрос должен быть таким, какой клиент действительно набрал бы. Если запрос существует только потому, что в нём есть ключевое слово, вычеркните его.
Шаг 2: прогоните ворота достоверности, прежде чем читать что-либо ещё
Это шаг, который пропускают большинство проверок, и именно из-за него пустоты попадают в отчёты как нули. В нашем прогоне ChatGPT отправлял поисковые запросы в 8 случаях из 20, а на остальные 12 отвечал по памяти.
Что мы наблюдали | Обоснованные ответы (8 запросов) | Необоснованные ответы (12 запросов) |
|---|---|---|
Отправленные поисковые запросы | 4–8 на запрос | 0 |
Возвращённые пометки источников | 6–18, медиана 12 | 0 |
Процитированные уникальные домены | 4–10, медиана 7 | 0 |
Бренды, всё ещё названные в тексте | да | да, в 13 из 20 запросов всего |
Прежде чем записывать что-либо о своём бренде, прогоните каждый запрос и ответьте на один вопрос: искала ли модель хоть что-нибудь? В интерфейсе ChatGPT подсказкой служит список источников под ответом. Если списка источников нет, ответ сделан по памяти, и его молчание о вашем бренде пока ничего не значит.
Результат: да или нет по каждому запросу в столбце обоснованности. Проверка качества: ответ без списка источников никогда не записывается как сигнал видимости, только как сигнал памяти. Наши необоснованные ответы к тому же не были короче: медиана выходных токенов 1 730 против 1 645 у обоснованных, так что длина — негодная подсказка.
Шаг 3: записывайте четыре поля, а не одно
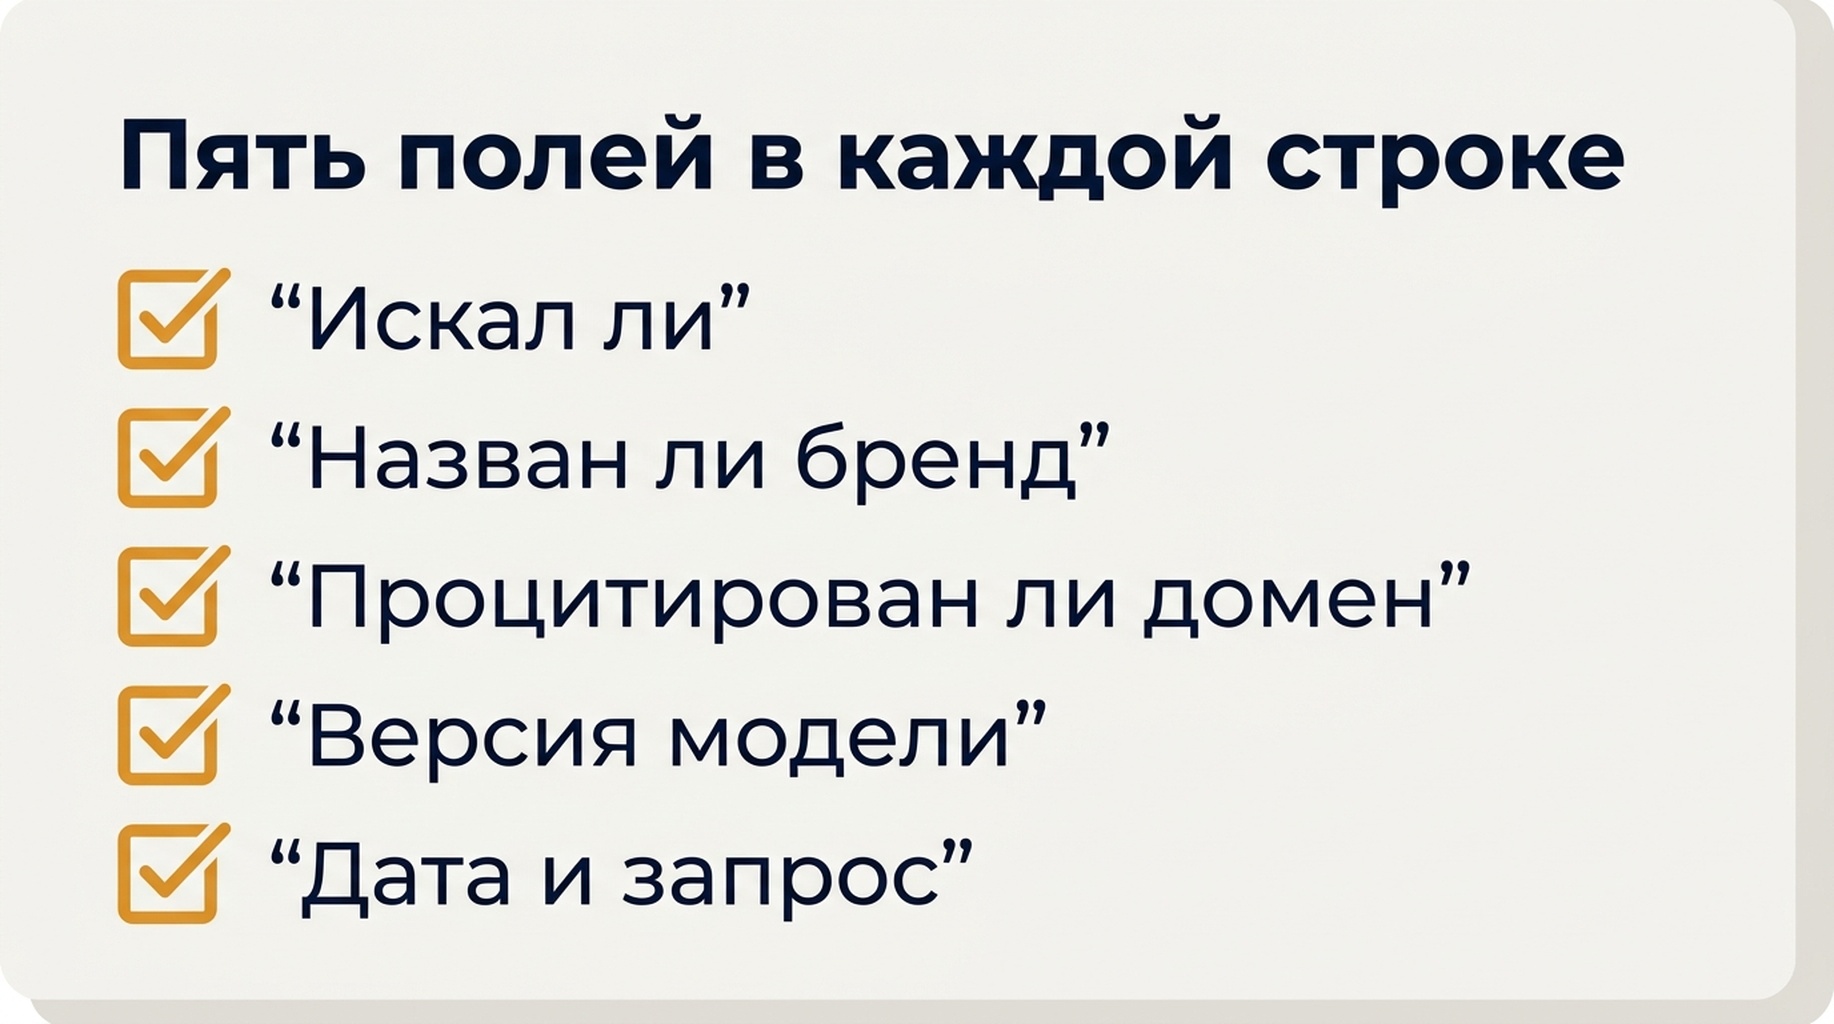
Одно число на запрос — вот почему отчёты противоречат друг другу. Сохраните эти четыре.
Поле | Значение | Почему это важно |
|---|---|---|
Обоснован | да или нет | Определяет, может ли запрос вообще дать ссылку |
Бренд назван | да или нет | Сигнал, который выживает в необоснованном ответе |
Домен связан | да или нет | Сигнал, о котором большинство инструментов сообщает в одиночку |
Версия модели | например gpt-5-2025-08-07 | В наших прогонах поведение менялось между версиями |
Последнее поле — не делопроизводство. Те же 20 запросов на той же конечной точке вернули источники в 2 случаях на старой модели против 8 на текущей. Отчёт без версии модели нельзя сравнить с отчётом следующего месяца.
Результат: четыре заполненных поля на запрос. Проверка качества: если хоть одна ячейка пуста, строку нельзя включать в отчёт. Храните сырой текст ответа и сырой список источников рядом с полями, чтобы проверяющий мог перепроверить вердикт, не прогоняя запрос заново.
Шаг 4: отнесите каждый ответ к одному из четырёх вердиктов
Вердикт | Что он значит | Что делать дальше |
|---|---|---|
Обоснован и связан | ChatGPT что-то поискал и сослался на ваш домен | Защитите процитированную страницу и проверьте, какая форма вопроса её породила |
Обоснован, но не связан | Он искал, читал веб и порекомендовал кого-то другого | Разрыв в контенте и охвате источников, а не в знаниях модели |
Не обоснован, но назван | Он ответил по памяти и всё же назвал вас | Чинить нечего. Повторите позже тот же запрос и посмотрите, начнёт ли он искать |
Не обоснован и не назван | Он ответил по памяти и не назвал вас | Это пока не сигнал. Исправьте запрос или дождитесь обоснованного прогона |
Четвёртая строка — источник большинства ложных тревог. В наших данных 13 из 20 ответов ChatGPT назвали хотя бы одного вендора, тогда как процитировали хоть что-нибудь только 8 из 20, то есть часть ответов покажется пустой проверке, читающей только ссылки, в то время как тот же текст называет бренды.
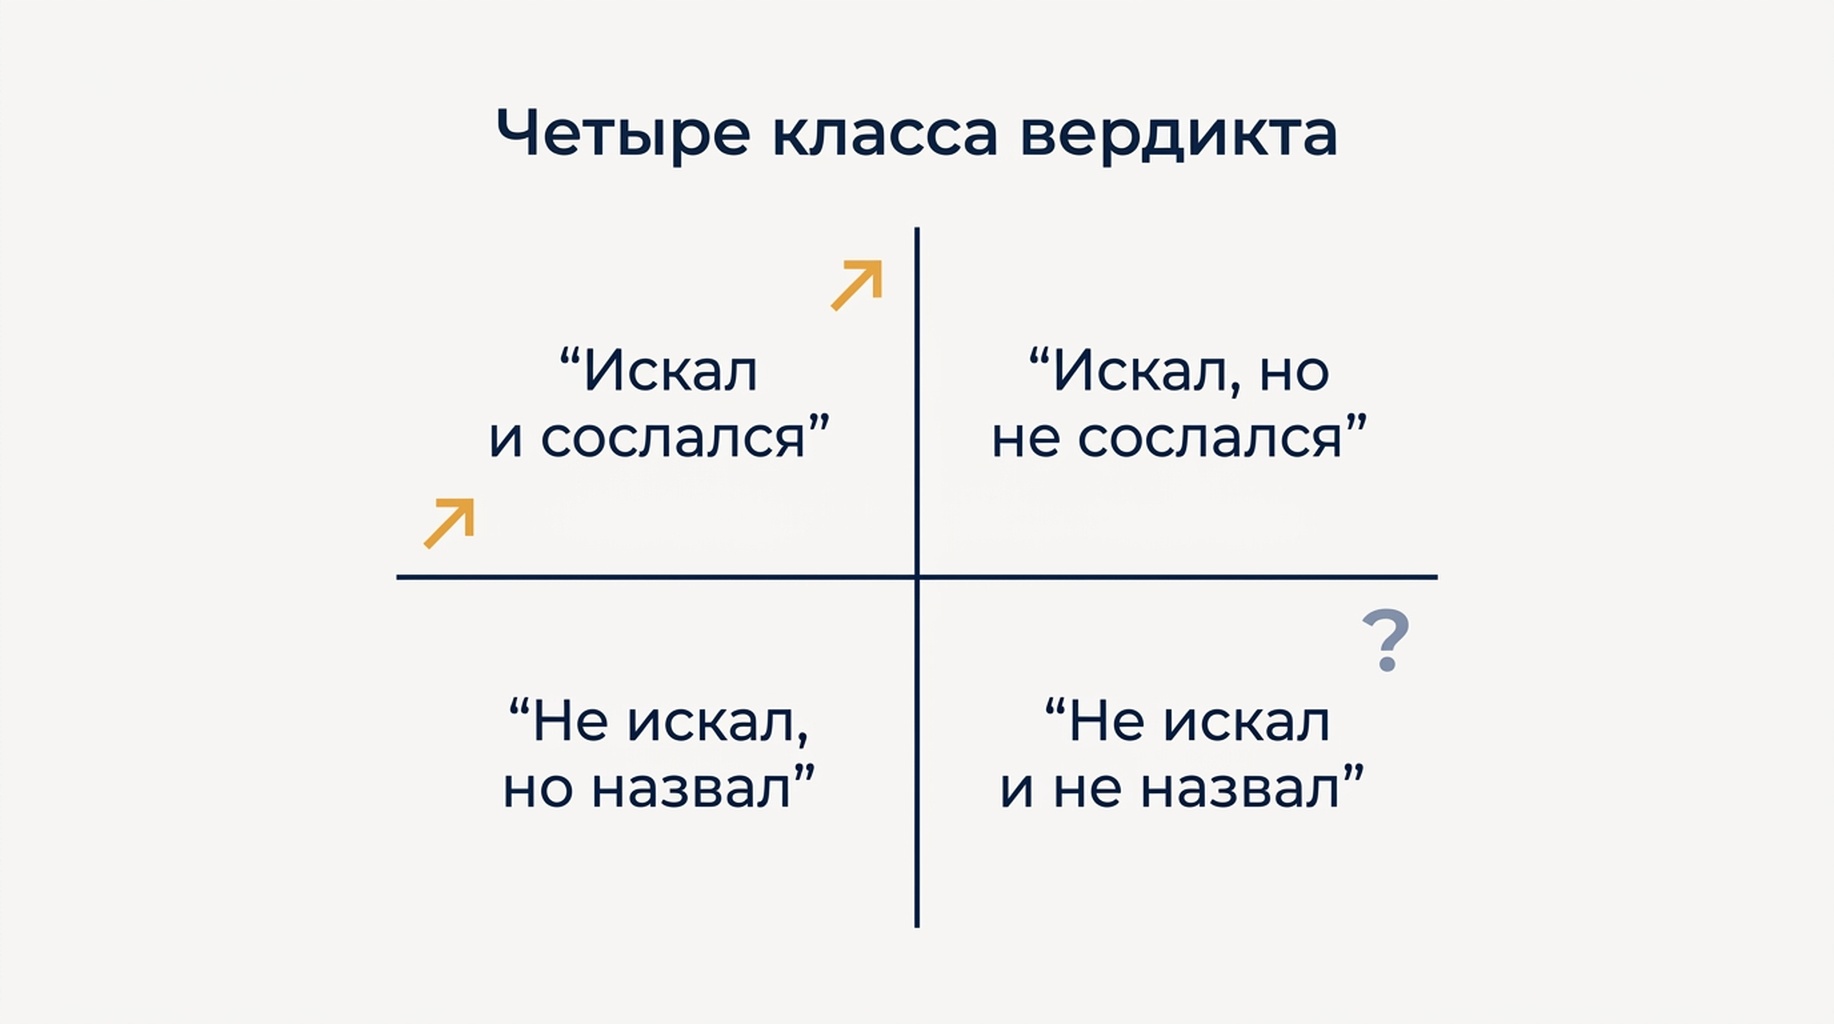
Результат: один вердикт на запрос плюс действие. Проверка качества: любой вердикт «невидим» должен быть привязан к обоснованному ответу. Если обоснование вердикта не выдерживает изложения одним предложением, прогоните запрос заново.
Шаг 5: повторите два запроса, прежде чем верить изменению
Прогоните как минимум два запроса второй раз, в новом разговоре, и сравните вердикт, а не счёт.
Запрос | Первый прогон | Второй прогон | Стабильно |
|---|---|---|---|
Лучшие инструменты видимости в ИИ | обоснован, 13 источников, 6 доменов | обоснован, 14 источников, 4 домена | вердикт да, счёт нет |
Лучший инструмент для отслеживания упоминаний бренда | обоснован, 8 источников, 8 доменов | обоснован, 9 источников, 5 доменов | вердикт да, счёт нет |
Проверьте мой бренд в ответах ИИ | не обоснован, 0 источников | не обоснован, 0 источников | да |
Как часто меняются ответы ИИ | не обоснован, 0 источников | не обоснован, 0 источников | да |
На всех пяти повторённых запросах решение искать совпало с самим собой каждый раз, а число доменов сдвигалось на два-три. Это и есть верная калибровка: относитесь к вердикту как к сигналу, а к счёту как к оценке с диапазоном.
Результат: строка повторного прогона минимум для двух запросов. Проверка качества: если на неизменённом запросе вердикт переворачивается между прогонами, помечайте запрос как нестабильный и исключайте его из отчётов месяц к месяцу, пока он не повторится.
Шаг 6: поставьте проверку на расписание
Проверка из десяти запросов стоит около 0,29 доллара на текущей модели ChatGPT, примерно 1,27 доллара в месяц при недельном запуске. При такой цене работа не в вызове API, а в критерии оценки, поэтому отдавайте задачу агенту с явными правилами сбора, а не запросу «сделай выжимку».
Передайте агенту такие ограничения:
- Забирайте текст ответа дословно и список источников дословно. Ни то, ни другое не пересказывайте.
- Записывайте флаг обоснованности, версию модели и метку времени в каждой строке.
- Считайте числа в коде после сбора, никогда внутри запроса.
- Пишите в файл с датой, чтобы повторный прогон не затёр доказательства прошлого месяца.
Если вы уже ведёте агента для отчётов по поиску, схема сбора та же, что в ежедневном мониторинге SEO и GEO с Codex, а терминальная версия того же цикла — в ежедневном мониторинге с Claude Code. Единственное новое требование здесь — флаг обоснованности, потому что поверхность чата, которая не искала, нельзя читать как результат цитирования.
Результат: задача по расписанию, которая пишет строки с датами. Проверка качества: откройте файл прошлой недели и убедитесь, что вердикт восстанавливается из одних сохранённых доказательств.
Проверка: так выглядит годная работа
- В каждой строке есть флаг обоснованности, версия модели и дата.
- Каждый вердикт «невидим» принадлежит обоснованному ответу.
- Как минимум два запроса прогнаны дважды, и их вердикты сравнены.
- Сырой текст ответа и сырой список источников лежат рядом со счётами.
- Список запросов помечен по форме, а отчёт группирует результаты по форме, а не по сумме.
Ограничения
- Одна версия модели, одно место, английский язык, один день прогонов. Поведение ChatGPT различается между версиями.
- Веб-поиск был включён через API. Потребительское приложение может искать по другому набору запросов.
- Называние бренда измерялось сопоставлением строк, поэтому название продукта без названия компании может быть пропущено.
- Эта проверка измеряет ответы, а не трафик. Переходы — отдельное измерение.
Частые вопросы
Почему ChatGPT ничего не говорит о моём бренде?
Сначала проверьте, искал ли он. В нашем прогоне он ответил по памяти на 12 из 20 запросов без источников, а такие ответы могут назвать вендора из устаревших обучающих данных или не назвать никого. Необоснованный ответ не является доказательством вашей видимости.
Сколько запросов проверять в ChatGPT?
Восьми — двенадцати за цикл достаточно, чтобы увидеть закономерность, при условии что они покрывают формы категории, сравнения, проблемы и доказательства. Сотня запросов даст большую выборку тех же четырёх форм, а не новую информацию.
Можно ли проверить это без API?
Да. И флаг обоснованности, и называние бренда видны в интерфейсе, а список источников под ответом закрывает половину с цитированием. API нужен только тогда, когда вы хотите строки с датами и повторные прогоны без ручного копирования.
Как понять, что изменение настоящее?
Повторите запрос, прежде чем сообщать об изменении. В наших пяти парах повторных прогонов решение искать ни разу не перевернулось, а счёт источников сдвигался на два-три. Смена вердикта на обоснованном запросе стоит разбирательства. Смена счёта — нет.
Взгляд Auspia: прогоняйте ворота достоверности, прежде чем читать любую цифру, и отчитывайтесь вердиктом, а не счётом. Самая частая ошибка, которую мы нашли, — не пропущенное цитирование, а пустой ответ ChatGPT, поданный как невидимость, когда модель вообще ничего не искала. Исправьте сначала флаг, и остальная часть отчёта станет сравнимой месяц к месяцу.
Автор: Виктор Лейн