Jika seseorang bertanya apakah merek Anda muncul di ChatGPT, jawaban jujur pertama adalah hasil kosong dan nol sungguhan terlihat identik sampai Anda memeriksa satu hal. Panduan ini untuk siapa pun yang harus memberi jawaban itu tanpa platform pemantauan, hanya bermodal jendela obrolan, satu lembar spreadsheet, dan sekitar tiga puluh menit.
Di akhir Anda akan punya satu putusan per prompt, catatan yang bisa diulang dan Anda pertahankan di rapat, serta tugas terjadwal yang menjaganya tetap terbaru. Syarat selesainya sederhana: untuk setiap prompt, Anda bisa menyebut apakah jawabannya berbasis pencarian, apakah menyebut merek Anda, dan apakah menautkan situs.
Apa yang Anda miliki setelah selesai
Hasil | Letaknya |
|---|---|
Daftar 8 sampai 12 prompt yang ditulis dari percakapan nyata | Tab pertama spreadsheet Anda |
Satu baris per prompt dengan empat bidang dan versi model | Tab yang sama |
Satu dari empat putusan per prompt, dengan tindakan yang menyertainya | Kolom putusan |
Pengulangan untuk minimal dua prompt | Baris 2 dan 3 di spreadsheet yang sama |
Pemeriksaan terjadwal dengan tolok ukur tetap | Folder proyek agen Anda |
Prasyarat: akses ke ChatGPT dengan pencarian web, satu spreadsheet, dan kemampuan membelanjakan sekitar 0,29 dolar untuk sekali jalan sepuluh prompt bila Anda mengotomatiskannya.
Langkah 1: tulis prompt dari percakapan, bukan dari kata kunci
Tarik dua puluh pertanyaan terakhir yang dijawab tim penjualan, lalu kelompokkan. Dalam studi dua puluh prompt kami, daftar sumber terlebar datang dari pertanyaan tentang bagaimana bisa dikutip, dan yang tersempit dari perbandingan langsung antar alat, artinya bentuk pertanyaan menentukan berapa banyak data yang kembali kepada Anda.
Tulis 8 sampai 12 prompt dalam empat bentuk: kategori ("X terbaik untuk Y"), perbandingan ("A versus B"), masalah ("bagaimana saya tahu apakah AI mengenal perusahaan saya"), dan bukti ("siapa yang merekomendasikan X pada 2026"). Tambahkan dua prompt yang menyebut merek Anda langsung, karena perilakunya berbeda dari prompt kategori. Kalau Anda ingin bukti lintas permukaan untuk daftar yang sama, analisis pemeriksa visibilitas di AI menunjukkan apa yang berubah saat prompt yang sama dikirim ke tiga permukaan.
Hasil: daftar akhir 8 sampai 12 prompt, masing-masing ditandai bentuknya. Pemeriksaan mutu: setiap prompt harus sesuatu yang benar-benar akan diketik pelanggan. Kalau sebuah prompt ada hanya karena memuat kata kunci, potong saja.
Langkah 2: lewati gerbang validitas sebelum membaca hal lain
Inilah langkah yang dilewati sebagian besar pemeriksaan, dan inilah sebabnya kekosongan dilaporkan sebagai nol. Dalam eksekusi kami, ChatGPT mengeluarkan kueri pencarian pada 8 dari 20 prompt dan menjawab 12 sisanya dari ingatan.
Yang kami amati | Jawaban berbasis pencarian (8 prompt) | Jawaban tanpa pencarian (12 prompt) |
|---|---|---|
Kueri pencarian yang dikeluarkan | 4 sampai 8 per prompt | 0 |
Anotasi sumber yang dikembalikan | 6 sampai 18, median 12 | 0 |
Domain berbeda yang dikutip | 4 sampai 10, median 7 | 0 |
Merek yang tetap disebut di teks | ya | ya, pada 13 dari 20 prompt secara keseluruhan |
Sebelum mencatat apa pun tentang merek Anda, jalankan setiap prompt dan jawab satu pertanyaan: apakah model mencari sesuatu? Di antarmuka ChatGPT, petunjuknya adalah daftar sumber di bawah jawaban. Kalau tidak ada daftar sumber, jawaban itu keluar dari ingatan, dan diamnya soal merek Anda belum berarti apa-apa.
Hasil: ya atau tidak per prompt di kolom basis pencarian. Pemeriksaan mutu: jawaban tanpa daftar sumber tidak pernah dicatat sebagai sinyal visibilitas, hanya sebagai sinyal ingatan. Jawaban kami yang tanpa pencarian juga tidak lebih pendek: median 1.730 token keluaran berbanding 1.645 pada yang berbasis pencarian, jadi panjang bukan petunjuk yang berguna.
Langkah 3: catat empat bidang, bukan satu
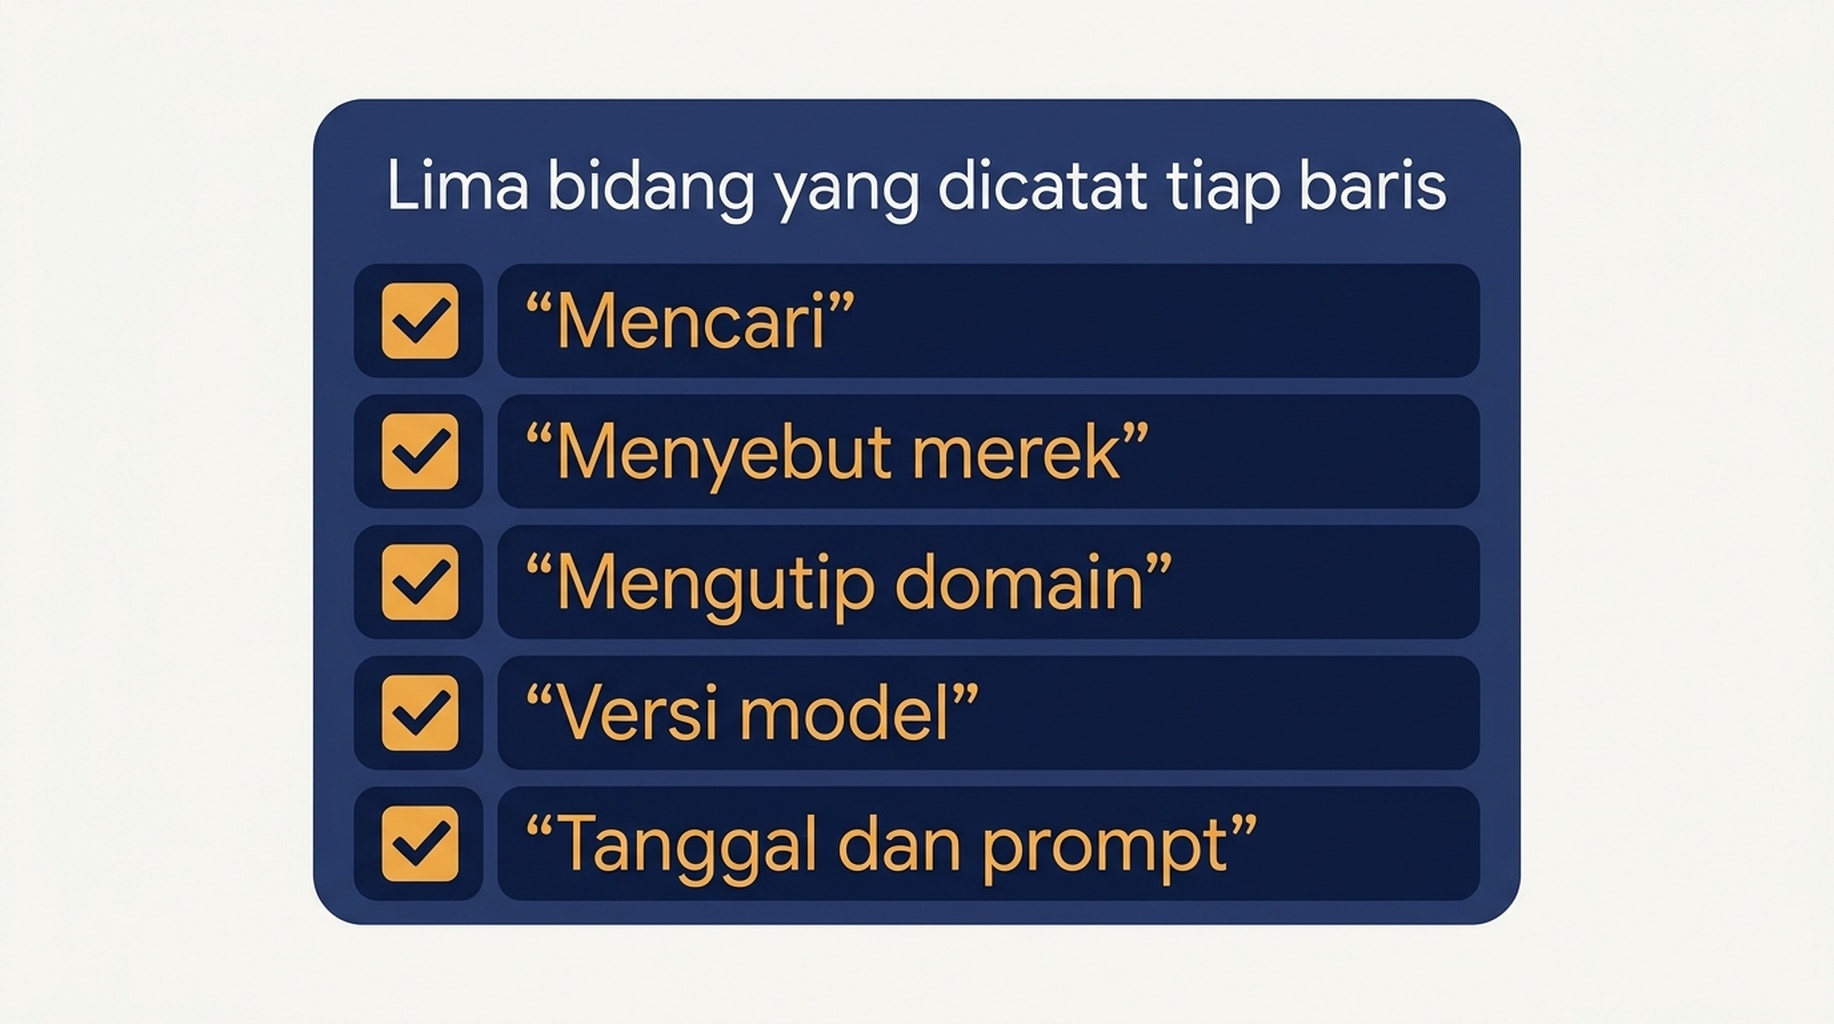
Satu angka per prompt adalah sebab laporan saling bertentangan. Simpan empat ini.
Bidang | Nilai | Kenapa penting |
|---|---|---|
Berbasis pencarian | ya atau tidak | Menentukan apakah prompt itu bisa menghasilkan tautan sejak awal |
Merek disebut | ya atau tidak | Sinyal yang bertahan di jawaban tanpa pencarian |
Domain ditautkan | ya atau tidak | Sinyal yang dilaporkan sebagian besar alat sendirian |
Versi model | misalnya gpt-5-2025-08-07 | Perilaku bergeser antar versi dalam eksekusi kami |
Bidang terakhir bukan urusan administrasi. Dua puluh prompt yang sama, di endpoint yang sama, mengembalikan sumber hanya pada 2 prompt dengan model lama, berbanding 8 dengan model saat ini. Laporan tanpa versi model tidak bisa dibandingkan dengan laporan bulan depan.
Hasil: empat bidang terisi untuk setiap prompt. Pemeriksaan mutu: kalau ada sel kosong, baris itu tidak boleh dilaporkan. Simpan teks jawaban mentah dan daftar sumber mentah di samping bidang-bidang itu, supaya peninjau bisa memeriksa ulang putusan tanpa menjalankan prompt lagi.
Langkah 4: golongkan setiap jawaban ke satu dari empat putusan
Putusan | Artinya | Yang harus dilakukan berikutnya |
|---|---|---|
Berbasis pencarian dan ditautkan | ChatGPT mencari sesuatu dan mengutip domain Anda | Lindungi halaman yang dikutip dan periksa bentuk pertanyaan mana yang menghasilkannya |
Berbasis pencarian, tidak ditautkan | Ia mencari, membaca web, dan merekomendasikan pihak lain | Celahnya ada di konten dan cakupan sumber, bukan di pengetahuan model |
Tanpa pencarian tetapi disebut | Ia menjawab dari ingatan dan tetap menyebut Anda | Tidak ada yang perlu diperbaiki. Ulangi nanti dengan prompt yang sama untuk melihat apakah ia mulai mencari |
Tanpa pencarian dan tidak disebut | Ia menjawab dari ingatan dan tidak menyebut Anda | Ini belum sinyal. Perbaiki prompt atau tunggu eksekusi yang berbasis pencarian |
Baris keempat adalah sumber sebagian besar alarm palsu. Dalam data kami, 13 dari 20 jawaban ChatGPT menyebut minimal satu vendor, sementara hanya 8 dari 20 yang mengutip apa pun, artinya sebagian jawaban akan tampak kosong bagi pemeriksaan yang hanya membaca tautan, padahal teks yang sama sedang menyebut merek.
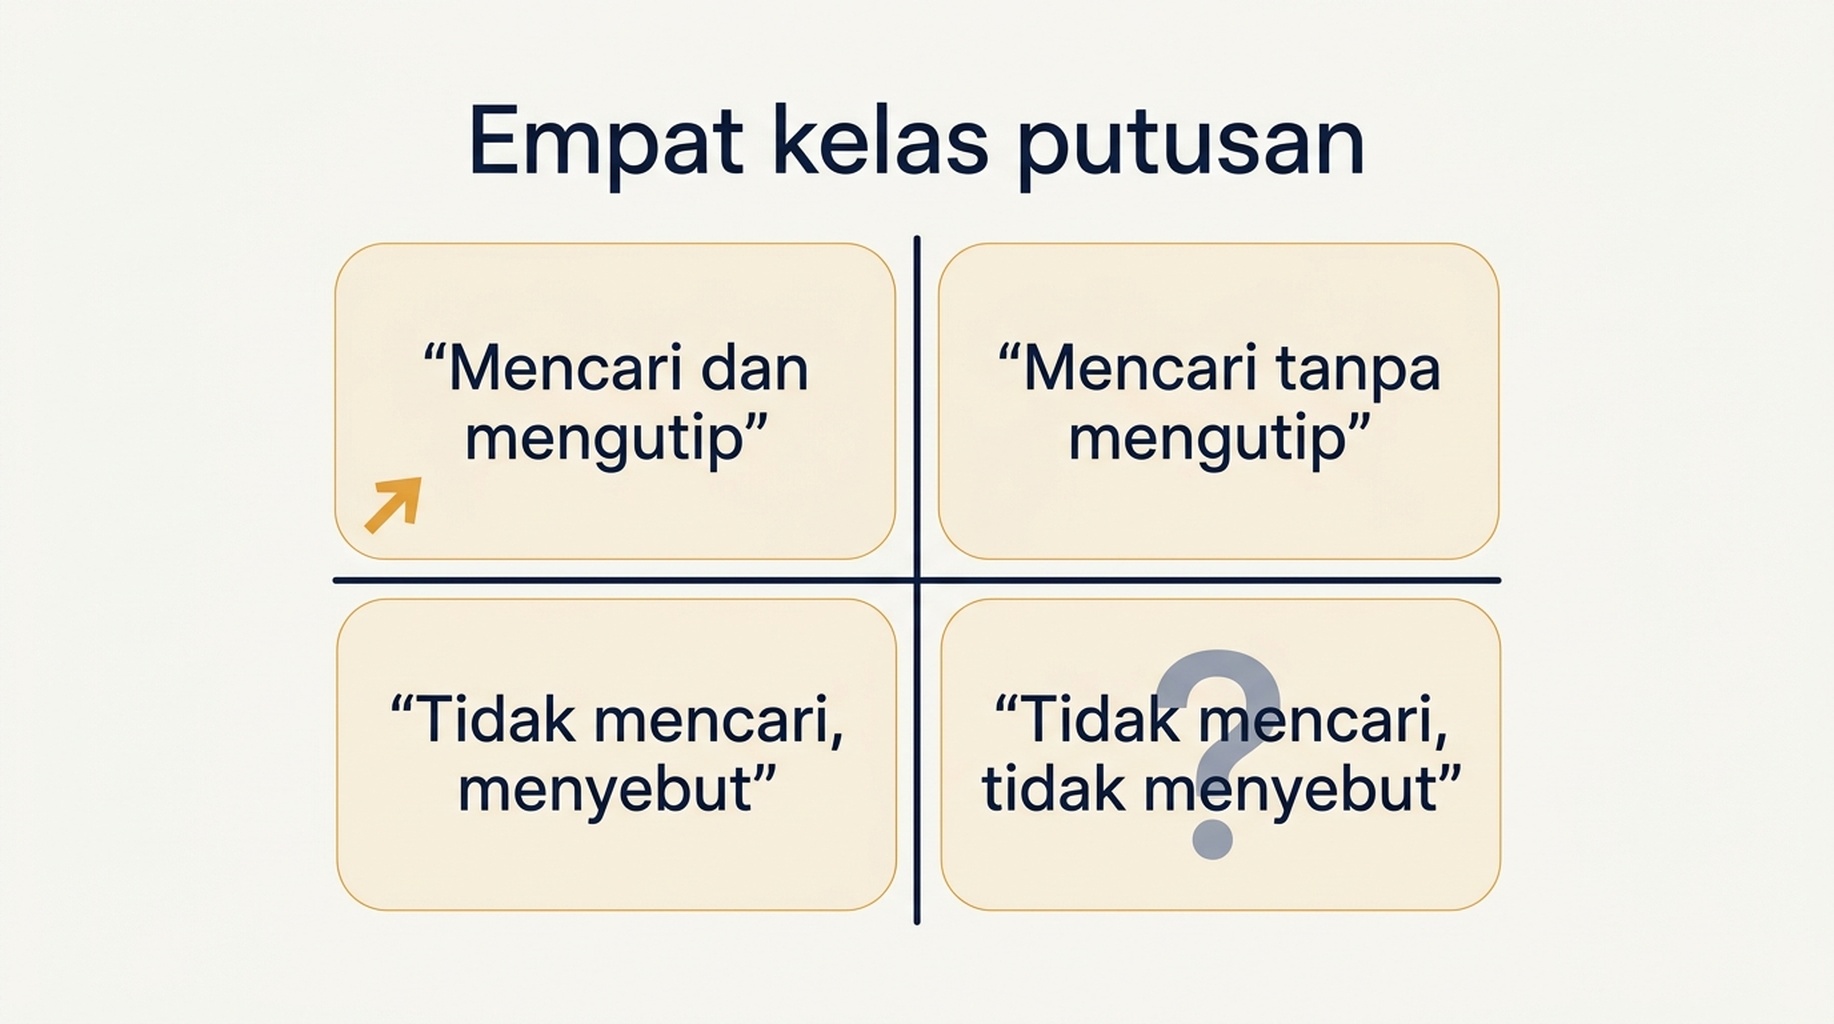
Hasil: satu putusan per prompt, plus tindakannya. Pemeriksaan mutu: setiap putusan "tidak terlihat" harus terikat pada jawaban yang berbasis pencarian. Kalau alasan di balik putusan tidak bertahan ditulis dalam satu kalimat, jalankan ulang prompt itu.
Langkah 5: ulangi dua prompt sebelum memercayai perubahan
Jalankan minimal dua prompt untuk kedua kalinya, di percakapan baru, lalu bandingkan putusannya, bukan angkanya.
Prompt | Jalan pertama | Jalan kedua | Stabil |
|---|---|---|---|
Alat visibilitas AI terbaik | berbasis pencarian, 13 sumber, 6 domain | berbasis pencarian, 14 sumber, 4 domain | putusan ya, angka tidak |
Alat terbaik untuk memantau sebutan merek | berbasis pencarian, 8 sumber, 8 domain | berbasis pencarian, 9 sumber, 5 domain | putusan ya, angka tidak |
Audit merek saya di jawaban AI | tanpa pencarian, 0 sumber | tanpa pencarian, 0 sumber | ya |
Seberapa sering jawaban AI berubah | tanpa pencarian, 0 sumber | tanpa pencarian, 0 sumber | ya |
Pada kelima prompt yang kami ulang, keputusan mencari selalu cocok dengan dirinya sendiri, sementara jumlah domain bergeser dua atau tiga. Itu kalibrasi yang benar: perlakukan putusan sebagai sinyal dan angka sebagai perkiraan yang punya rentang.
Hasil: baris pengulangan untuk minimal dua prompt. Pemeriksaan mutu: kalau putusan berbalik antar jalan pada prompt yang tidak berubah, tandai prompt itu tidak stabil dan keluarkan dari laporan bulan ke bulan sampai ia berulang.
Langkah 6: masukkan pemeriksaan ke jadwal
Pemeriksaan sepuluh prompt berbiaya sekitar 0,29 dolar pada model ChatGPT saat ini, kira-kira 1,27 dolar per bulan bila dijalankan mingguan. Pada harga itu, pekerjaannya bukan panggilan API melainkan tolok ukur, jadi serahkan tugas ini ke agen dengan aturan pengumpulan yang eksplisit, bukan ke permintaan ringkasan.
Berikan batasan ini ke agen:
- Tangkap teks jawaban secara harfiah dan daftar sumber secara harfiah. Jangan ringkas keduanya.
- Catat penanda basis pencarian, versi model, dan stempel waktu di setiap baris.
- Hitung angka di kode setelah pengumpulan, jangan pernah di dalam prompt.
- Tulis ke berkas bertanggal, supaya pengulangan tidak menimpa bukti bulan lalu.
Kalau Anda sudah menjalankan agen untuk laporan pencarian, pola pengumpulannya sama dengan yang dipakai di pemantauan SEO dan GEO harian dengan Codex, dan versi terminal dari loop yang sama ada di pemantauan harian dengan Claude Code. Satu-satunya syarat baru di sini adalah penanda basis pencarian, karena permukaan obrolan yang tidak mencari tidak boleh dibaca sebagai hasil kutipan.
Hasil: tugas terjadwal yang menulis baris bertanggal. Pemeriksaan mutu: buka berkas minggu lalu dan pastikan Anda bisa menyusun ulang putusan hanya dari bukti yang tersimpan.
Verifikasi: pemeriksaan yang sah terlihat seperti ini
- Setiap baris punya penanda basis pencarian, versi model, dan tanggal.
- Setiap putusan "tidak terlihat" milik jawaban yang berbasis pencarian.
- Minimal dua prompt dijalankan dua kali dan putusannya dibandingkan.
- Teks jawaban mentah dan daftar sumber mentah disimpan di samping angka.
- Daftar prompt ditandai menurut bentuk, dan laporan mengelompokkan hasil menurut bentuk, bukan menurut total.
Batasan
- Satu versi model, satu tempat, bahasa Inggris, satu hari eksekusi. Perilaku ChatGPT berbeda antar versi.
- Pencarian web diaktifkan lewat API. Aplikasi konsumen bisa mencari pada kumpulan prompt yang berbeda.
- Penyebutan merek diukur dengan pencocokan teks, jadi nama produk tanpa nama perusahaan bisa terlewat.
- Pemeriksaan ini mengukur jawaban, bukan trafik. Perilaku rujukan adalah pengukuran terpisah.
Pertanyaan umum
Kenapa ChatGPT tidak mengatakan apa pun tentang merek saya?
Periksa dulu apakah ia mencari. Dalam eksekusi kami, ia menjawab 12 dari 20 prompt dari ingatan tanpa sumber, dan jawaban seperti itu bisa menyebut vendor dari data latih lama atau tidak menyebut siapa pun. Jawaban tanpa pencarian bukan bukti tentang visibilitas Anda.
Berapa banyak prompt yang harus saya periksa di ChatGPT?
Delapan sampai dua belas per siklus cukup untuk melihat polanya, asalkan mencakup bentuk kategori, perbandingan, masalah, dan bukti. Menjalankan seratus prompt memberi sampel lebih besar dari empat bentuk yang sama, bukan informasi baru.
Bisakah memeriksa ini tanpa API?
Bisa. Penanda basis pencarian maupun penyebutan merek sama-sama terlihat di antarmuka, dan daftar sumber di bawah jawaban menutup separuh sisi kutipan. API baru penting kalau Anda ingin baris bertanggal dan pengulangan tanpa menyalin manual.
Bagaimana saya tahu sebuah perubahan itu nyata?
Ulangi prompt sebelum melaporkan perubahan. Pada kelima pasangan pengulangan kami, keputusan mencari tidak pernah berbalik, sementara jumlah sumber bergeser dua atau tiga. Perubahan putusan pada prompt yang berbasis pencarian layak diselidiki. Perubahan angka tidak.
Pandangan Auspia: lewati gerbang validitas sebelum membaca angka apa pun, dan laporkan putusannya alih-alih angka. Kesalahan paling umum yang kami temukan bukan kutipan yang terlewat, melainkan jawaban ChatGPT yang kosong dilaporkan sebagai ketidakterlihatan padahal modelnya tidak mencari apa pun. Perbaiki penandanya lebih dulu, dan sisa laporannya menjadi bisa dibandingkan bulan ke bulan.
Penulis: Victor Lane