Biri size markanızın ChatGPT'de görünüp görünmediğini sorduysa, ilk dürüst yanıt şudur: boş bir sonuç ile gerçek bir sıfır, siz bir şeyi kontrol edene kadar tıpatıp aynı görünür. Bu rehber, o yanıtı bir izleme platformu olmadan vermesi gerekenler için: elinde yalnızca bir sohbet penceresi, bir tablo ve yaklaşık otuz dakika olanlar için.
Sonunda her istem için bir hüküm, bir toplantıda savunabileceğiniz tekrarlanabilir bir kayıt ve bunu güncel tutan zamanlanmış bir iş olacak. Bitirme koşulu basit: her istem için yanıtın dayanaklı olup olmadığını, markayı anıp anmadığını ve siteye bağlantı verip vermediğini söyleyebiliyorsunuz.
Bitirdiğinizde elinizde ne olacak
Çıktı | Nerede duruyor |
|---|---|
Gerçek konuşmalardan yazılmış 8 ila 12 istemlik liste | Tablonuzun ilk sekmesi |
Her istem için dört alan ve model sürümü içeren bir satır | Aynı sekme |
Her istem için eylemiyle eşleşen dört hükümden biri | Hüküm sütunu |
En az iki istemin tekrar çalıştırılması | Aynı tablonun 2. ve 3. satırları |
Sabit değerlendirme ölçütü olan zamanlanmış bir kontrol | Ajanınızın proje klasörü |
Ön koşullar: web araması açık ChatGPT erişimi, bir tablo ve otomatikleştirirseniz on istemlik bir çalıştırma için yaklaşık 0,29 dolar harcayabilme.
Adım 1: istemleri anahtar kelimelerden değil konuşmalardan yazın
Satış ekibinin yanıtladığı son yirmi soruyu çıkarın ve gruplayın. Yirmi istemlik çalışmamızda en geniş kaynak listesi nasıl alıntılanacağınıza dair bir sorudan, en dar liste ise iki aracın doğrudan karşılaştırılmasından geldi; yani sorunun biçimi size ne kadar veri döneceğini belirliyor.
İstemleri dört biçimde yazın: kategori ("Y için en iyi X"), karşılaştırma ("A ile B"), sorun ("yapay zekânın şirketimi tanıyıp tanımadığını nasıl anlarım") ve kanıt ("2026'da X'i kim öneriyor"). Doğrudan markanızı anan iki istem ekleyin, çünkü bunlar kategori istemlerinden farklı davranıyor. Aynı liste için birden fazla yüzeyden kanıt istiyorsanız, yapay zekâ görünürlük denetleyicisi analizi aynı istem üç yüzeye gittiğinde neyin değiştiğini gösteriyor.
Çıktı: her biri biçimiyle etiketlenmiş, 8 ila 12 istemden oluşan nihai liste. Kalite kontrolü: her istem bir müşterinin gerçekten yazacağı bir şey olmalı. Bir istem yalnızca içinde anahtar kelime var diye duruyorsa çıkarın.
Adım 2: başka bir şey okumadan önce geçerlilik kapısından geçin
Çoğu kontrolün atladığı adım budur ve boşlukların sıfır olarak raporlanmasının nedeni de budur. Çalıştırmamızda ChatGPT 20 istemin 8'inde arama sorgusu üretti ve kalan 12'sini hafızadan yanıtladı.
Ne gözlemledik | Dayanaklı yanıtlar (8 istem) | Dayanaksız yanıtlar (12 istem) |
|---|---|---|
Üretilen arama sorguları | istem başına 4 ila 8 | 0 |
Dönen kaynak notları | 6 ila 18, ortanca 12 | 0 |
Alıntılanan farklı alan adları | 4 ila 10, ortanca 7 | 0 |
Metinde hâlâ anılan markalar | evet | evet, toplamda 20 istemin 13'ünde |
Markanızla ilgili bir şey kaydetmeden önce her istemi çalıştırın ve tek bir soruya cevap verin: model bir şey aradı mı? ChatGPT arayüzünde ipucu, yanıtın altındaki kaynak listesidir. Kaynak listesi yoksa yanıt hafızadan gelmiştir ve markanız hakkındaki sessizliği henüz hiçbir şey ifade etmez.
Çıktı: dayanak sütununda her istem için evet ya da hayır. Kalite kontrolü: kaynak listesi olmayan bir yanıt asla görünürlük sinyali olarak kaydedilmez, yalnızca hafıza sinyali olarak kaydedilir. Bizim dayanaksız yanıtlarımız da daha kısa değildi: çıktı token ortancası 1.730'a karşılık dayanaklılarda 1.645, yani uzunluk kullanılabilir bir ipucu değil.
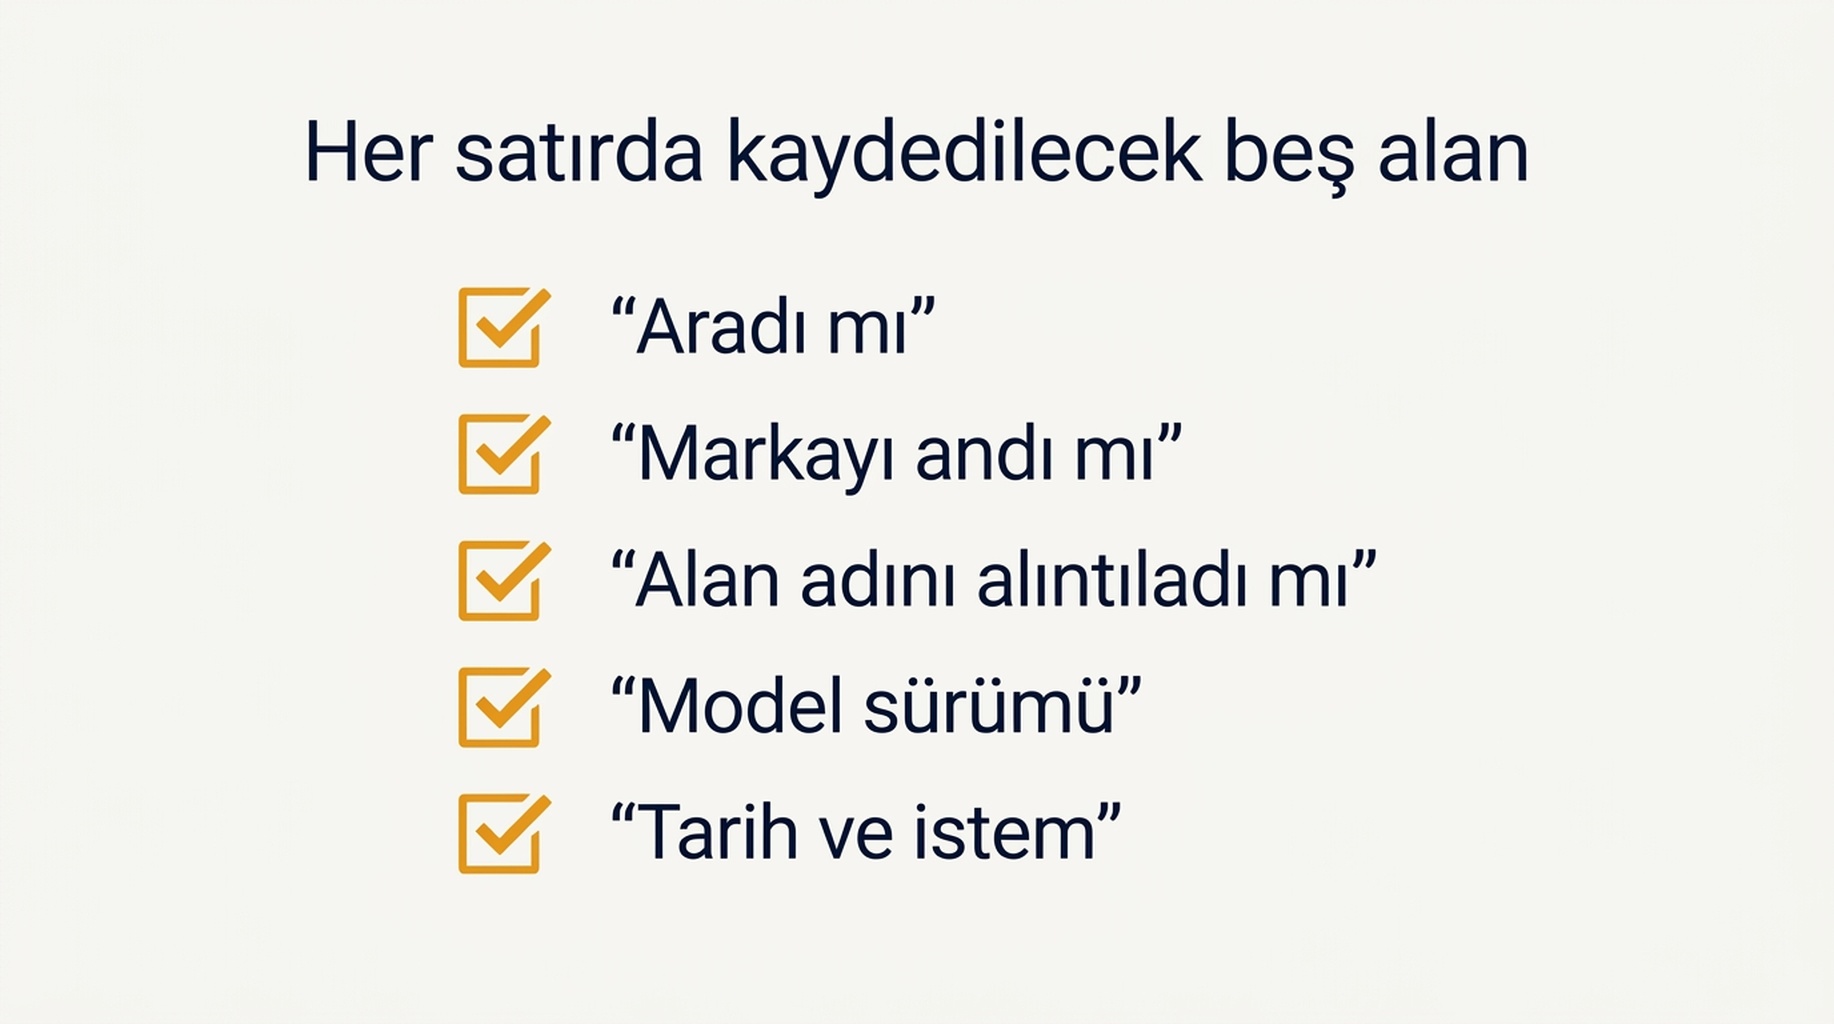
Adım 3: bir değil dört alan kaydedin
İstem başına tek sayı, raporların birbiriyle çelişmesinin nedenidir. Şu dördünü tutun.
Alan | Değer | Neden önemli |
|---|---|---|
Dayanaklı | evet ya da hayır | İstemin baştan bağlantı üretip üretemeyeceğini belirler |
Marka anıldı | evet ya da hayır | Dayanaksız bir yanıtta hayatta kalan sinyal |
Alan adı bağlandı | evet ya da hayır | Çoğu aracın tek başına raporladığı sinyal |
Model sürümü | örneğin gpt-5-2025-08-07 | Çalıştırmalarımızda davranış sürümler arasında kaydı |
Son alan bürokrasi değil. Aynı 20 istem, aynı uç noktada, eski modelle yalnızca 2 istemde kaynak döndürdü; güncel modelle 8. Model sürümü olmayan bir rapor gelecek aykiyle karşılaştırılamaz.
Çıktı: her istem için dört alan dolu. Kalite kontrolü: herhangi bir hücre boşsa o satır raporlanamaz. Ham yanıt metnini ve ham kaynak listesini alanların yanında saklayın, böylece bir gözden geçiren istemi yeniden çalıştırmadan hükmü doğrulayabilir.
Adım 4: her yanıtı dört hükümden birine yerleştirin
Hüküm | Ne anlama gelir | Sonra ne yapmalı |
|---|---|---|
Dayanaklı ve bağlantılı | ChatGPT bir şey aradı ve alan adınızı alıntıladı | Alıntılanan sayfayı koruyun ve hangi soru biçiminin onu ürettiğini kontrol edin |
Dayanaklı ama bağlantısız | Aradı, web'i okudu ve başkasını önerdi | Boşluk içerikte ve kaynak kapsamında, modelin bilgisinde değil |
Dayanaksız ama anılan | Hafızadan yanıtladı ve yine de sizi andı | Düzeltilecek bir şey yok. Aramaya başlıyor mu diye aynı istemi sonra tekrarlayın |
Dayanaksız ve anılmayan | Hafızadan yanıtladı ve sizi anmadı | Bu henüz sinyal değil. İstemi düzeltin ya da dayanaklı bir çalıştırmayı bekleyin |
Dördüncü satır yanlış alarmların çoğunun kaynağıdır. Verilerimizde 20 ChatGPT yanıtının 13'ü en az bir satıcıyı andı, oysa yalnızca 20'nin 8'i herhangi bir şey alıntıladı; yani yanıtların bir kısmı yalnızca bağlantı okuyan bir kontrole boş görünecek, oysa aynı metin markaları anıyor.
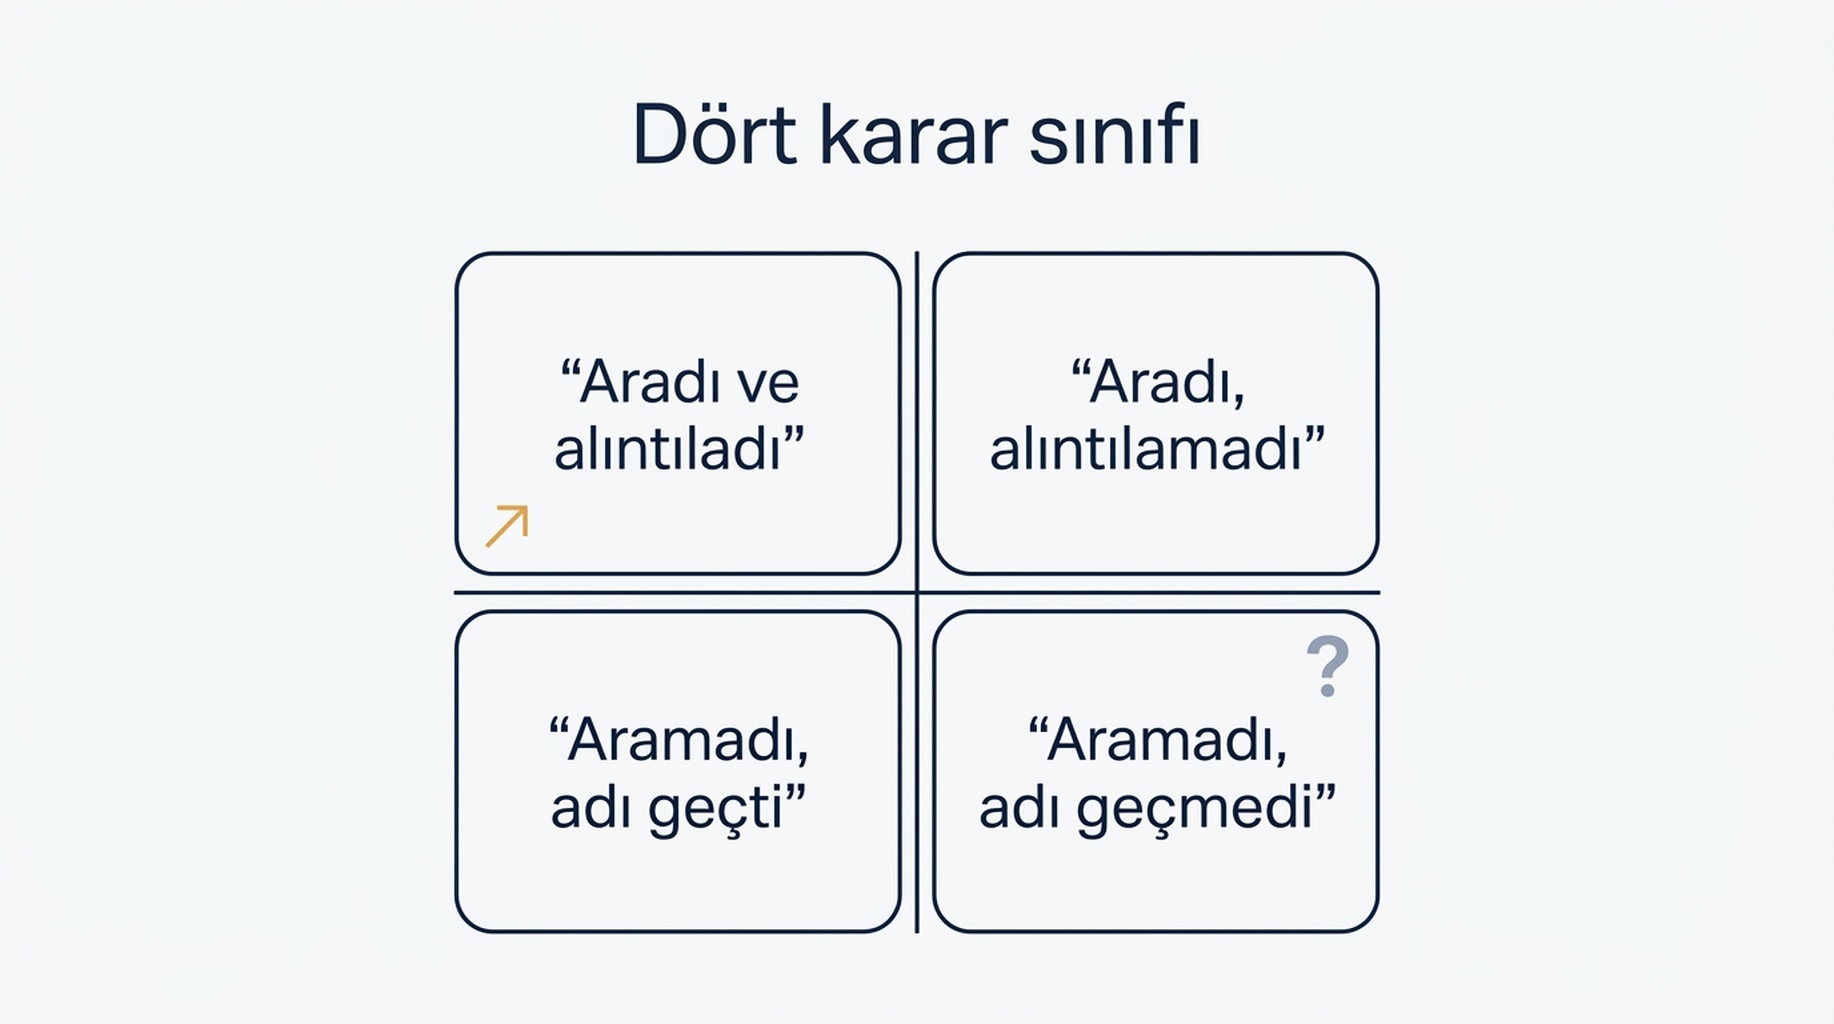
Çıktı: her istem için bir hüküm ve eylemi. Kalite kontrolü: her "görünmez" hükmü dayanaklı bir yanıta bağlı olmalı. Bir hükmün gerekçesi tek cümleyle yazıldığında ayakta kalmıyorsa istemi yeniden çalıştırın.
Adım 5: bir değişikliğe güvenmeden önce iki istemi tekrarlayın
En az iki istemi yeni bir konuşmada ikinci kez çalıştırın ve sayıyı değil hükmü karşılaştırın.
İstem | İlk çalıştırma | İkinci çalıştırma | Kararlı |
|---|---|---|---|
En iyi yapay zekâ görünürlük araçları | dayanaklı, 13 kaynak, 6 alan adı | dayanaklı, 14 kaynak, 4 alan adı | hüküm evet, sayı hayır |
Marka anmalarını izlemek için en iyi araç | dayanaklı, 8 kaynak, 8 alan adı | dayanaklı, 9 kaynak, 5 alan adı | hüküm evet, sayı hayır |
Markamı yapay zekâ yanıtlarında denetle | dayanaksız, 0 kaynak | dayanaksız, 0 kaynak | evet |
Yapay zekâ yanıtları ne sıklıkla değişir | dayanaksız, 0 kaynak | dayanaksız, 0 kaynak | evet |
Tekrarladığımız beş istemin tamamında arama kararı her seferinde kendisiyle uyuştu, alan adı sayısı ise iki ya da üç kaydı. Doğru kalibrasyon budur: hükmü sinyal, sayıyı aralığı olan bir tahmin olarak ele alın.
Çıktı: en az iki istem için tekrar satırı. Kalite kontrolü: değişmeyen bir istemde hüküm çalıştırmalar arasında ters dönüyorsa o istemi kararsız olarak işaretleyin ve tekrarlanana kadar aydan aya rapordan çıkarın.
Adım 6: kontrolü bir takvime bağlayın
On istemlik bir kontrol güncel ChatGPT modelinde yaklaşık 0,29 dolar, haftalık çalıştırırsanız ayda aşağı yukarı 1,27 dolar. Bu fiyatta iş API çağrısı değil, değerlendirme ölçütüdür; bu yüzden görevi özet isteğine değil, açık toplama kuralları olan bir ajana verin.
Ajana şu kısıtları aktarın:
- Yanıt metnini harfiyen ve kaynak listesini harfiyen yakalayın. İkisini de özetlemeyin.
- Her satıra dayanak bayrağını, model sürümünü ve zaman damgasını kaydedin.
- Sayıları toplama sonrasında kodda hesaplayın, asla istemin içinde hesaplamayın.
- Tarihli bir dosyaya yazın ki bir tekrar geçen ayın kanıtını ezmesin.
Arama raporları için zaten bir ajan çalıştırıyorsanız toplama deseni Codex ile günlük SEO ve GEO izleme yazısındakiyle aynı, aynı döngünün terminal sürümü ise Claude Code ile günlük izleme yazısında. Buradaki tek yeni gereksinim dayanak bayrağı, çünkü arama yapmayan bir sohbet yüzeyi alıntı sonucu olarak okunamaz.
Çıktı: tarihli satırlar yazan zamanlanmış bir iş. Kalite kontrolü: geçen haftanın dosyasını açın ve hükmü yalnızca saklanan kanıttan yeniden kurabildiğinizi doğrulayın.
Doğrulama: geçerli bir kontrol böyle görünür
- Her satırda dayanak bayrağı, model sürümü ve tarih var.
- Her "görünmez" hükmü dayanaklı bir yanıta ait.
- En az iki istem iki kez çalıştırıldı ve hükümleri karşılaştırıldı.
- Ham yanıt metni ve ham kaynak listesi sayıların yanında saklanıyor.
- İstem listesi biçime göre etiketli ve rapor sonuçları toplama göre değil biçime göre grupluyor.
Sınırlar
- Tek model sürümü, tek yer, İngilizce, tek günlük çalıştırma. ChatGPT'nin davranışı sürümler arasında farklılık gösteriyor.
- Web araması API üzerinden açıldı. Tüketici uygulaması farklı bir istem kümesinde arama yapabilir.
- Marka anılması metin eşleştirmesiyle ölçüldü, bu yüzden şirket adı olmadan geçen bir ürün adı gözden kaçabilir.
- Bu kontrol yanıtları ölçer, trafiği ölçmez. Yönlendirme davranışı ayrı bir ölçümdür.
Sık sorulan sorular
ChatGPT markam hakkında neden hiçbir şey söylemiyor?
Önce arayıp aramadığını kontrol edin. Çalıştırmamızda 20 istemin 12'sini kaynak olmadan hafızadan yanıtladı ve bu yanıtlar eski eğitim verilerinden bir satıcı anabilir ya da kimseyi anmayabilir. Dayanaksız bir yanıt görünürlüğünüz hakkında kanıt değildir.
ChatGPT'de kaç istem kontrol etmeliyim?
Döngü başına sekiz ila on iki istem, kategori, karşılaştırma, sorun ve kanıt biçimlerini kapsadığı sürece deseni görmeye yeter. Yüz istem çalıştırmak aynı dört biçimin daha büyük bir örneklemini verir, yeni bilgi vermez.
Bunu API olmadan kontrol edebilir miyim?
Evet. Hem dayanak bayrağı hem de marka anılması arayüzde görünür ve bir yanıtın altındaki kaynak listesi alıntının yarısını karşılar. API yalnızca tarihli satırlar ve elle kopyalamadan tekrarlar istediğinizde önemlidir.
Bir değişikliğin gerçek olduğunu nasıl anlarım?
Bir değişikliği bildirmeden önce istemi tekrarlayın. Beş tekrar çiftimizin hiçbirinde arama kararı ters dönmedi, kaynak sayıları ise iki ya da üç kaydı. Dayanaklı bir istemde hüküm değişikliği incelemeye değer. Sayı değişikliği değil.
Auspia görüşü: herhangi bir sayıyı okumadan önce geçerlilik kapısından geçin ve sayı yerine hükmü raporlayın. Bulduğumuz en yaygın hata kaçırılmış bir alıntı değil, model hiçbir şey aramadığı hâlde görünmezlik diye raporlanan boş bir ChatGPT yanıtı. Önce bayrağı düzeltin; raporun geri kalanı aydan aya karşılaştırılabilir hâle gelir.
Yazan: Victor Lane