Nếu có ai hỏi thương hiệu của bạn có xuất hiện trên ChatGPT hay không, câu trả lời trung thực đầu tiên là một kết quả trống và một số không thật trông giống hệt nhau cho đến khi bạn kiểm tra một điều. Hướng dẫn này dành cho người phải đưa ra câu trả lời đó mà không có nền tảng theo dõi, chỉ với một cửa sổ chat, một bảng tính và khoảng ba mươi phút.
Khi xong, bạn sẽ có một phán quyết cho mỗi câu lệnh, một bản ghi lặp lại được mà bạn bảo vệ được trong cuộc họp, và một tác vụ theo lịch giữ nó luôn mới. Điều kiện hoàn thành rất đơn giản: với mỗi câu lệnh, bạn nói được câu trả lời có dựa trên tìm kiếm hay không, có nêu tên thương hiệu hay không, và có liên kết tới website hay không.
Bạn sẽ có gì khi hoàn thành
Kết quả | Nằm ở đâu |
|---|---|
Danh sách 8 đến 12 câu lệnh viết từ hội thoại thật | Tab đầu tiên trong bảng tính của bạn |
Một dòng cho mỗi câu lệnh với bốn trường và phiên bản mô hình | Cùng tab đó |
Một trong bốn phán quyết cho mỗi câu lệnh, kèm hành động gắn theo | Cột phán quyết |
Việc chạy lặp lại ít nhất hai câu lệnh | Dòng 2 và 3 của cùng bảng tính |
Một kiểm tra theo lịch với tiêu chí đánh giá cố định | Thư mục dự án của agent |
Điều kiện tiên quyết: quyền truy cập ChatGPT có bật tìm kiếm web, một bảng tính, và khả năng chi khoảng 0,29 đô la cho một lần chạy mười câu lệnh nếu bạn tự động hóa.
Bước 1: viết câu lệnh từ hội thoại, không từ từ khóa
Lấy hai mươi câu hỏi gần nhất mà đội bán hàng đã trả lời rồi nhóm lại. Trong nghiên cứu hai mươi câu lệnh của chúng tôi, danh sách nguồn rộng nhất đến từ một câu hỏi về cách được trích dẫn, còn danh sách hẹp nhất đến từ so sánh trực tiếp hai công cụ, nghĩa là hình dạng câu hỏi quyết định lượng dữ liệu trả về cho bạn.
Viết 8 đến 12 câu lệnh theo bốn dạng: danh mục ("X tốt nhất cho Y"), so sánh ("A so với B"), vấn đề ("làm sao biết AI có biết công ty tôi không") và bằng chứng ("ai đề xuất X vào năm 2026"). Thêm hai câu lệnh nêu thẳng tên thương hiệu của bạn, vì chúng hành xử khác với câu lệnh danh mục. Nếu bạn muốn bằng chứng từ nhiều bề mặt cho cùng danh sách đó, phân tích công cụ kiểm tra hiển thị trên AI cho thấy điều gì thay đổi khi cùng câu lệnh đi tới ba bề mặt.
Kết quả: danh sách cuối cùng 8 đến 12 câu lệnh, mỗi câu được gắn nhãn dạng của nó. Kiểm tra chất lượng: mỗi câu lệnh phải là thứ khách hàng thật sự sẽ gõ. Nếu một câu lệnh tồn tại chỉ vì có từ khóa trong đó, hãy cắt bỏ.
Bước 2: qua cổng hợp lệ trước khi đọc bất cứ thứ gì khác
Đây là bước mà hầu hết các kiểm tra bỏ qua, và là lý do các khoảng trống bị báo cáo thành số không. Trong lần chạy của chúng tôi, ChatGPT phát truy vấn tìm kiếm ở 8 trong 20 câu lệnh và trả lời 12 câu còn lại từ ký ức.
Điều chúng tôi quan sát | Câu trả lời dựa trên tìm kiếm (8 câu lệnh) | Câu trả lời không dựa trên tìm kiếm (12 câu lệnh) |
|---|---|---|
Truy vấn tìm kiếm phát ra | 4 đến 8 mỗi câu lệnh | 0 |
Chú thích nguồn trả về | 6 đến 18, trung vị 12 | 0 |
Tên miền khác nhau được trích dẫn | 4 đến 10, trung vị 7 | 0 |
Thương hiệu vẫn được nêu trong văn bản | có | có, ở 13 trong 20 câu lệnh tính chung |
Trước khi ghi bất cứ điều gì về thương hiệu của bạn, hãy chạy từng câu lệnh và trả lời một câu hỏi: mô hình có tìm kiếm gì không? Trong giao diện ChatGPT, manh mối là danh sách nguồn bên dưới câu trả lời. Nếu không có danh sách nguồn, câu trả lời đến từ ký ức, và việc nó im lặng về thương hiệu của bạn chưa có nghĩa gì.
Kết quả: có hoặc không cho mỗi câu lệnh ở cột dựa trên tìm kiếm. Kiểm tra chất lượng: câu trả lời không có danh sách nguồn không bao giờ được ghi là tín hiệu hiển thị, chỉ là tín hiệu ký ức. Câu trả lời không dựa trên tìm kiếm của chúng tôi cũng không ngắn hơn: trung vị 1.730 token đầu ra so với 1.645 ở nhóm dựa trên tìm kiếm, nên độ dài không phải manh mối dùng được.
Bước 3: ghi bốn trường, không phải một
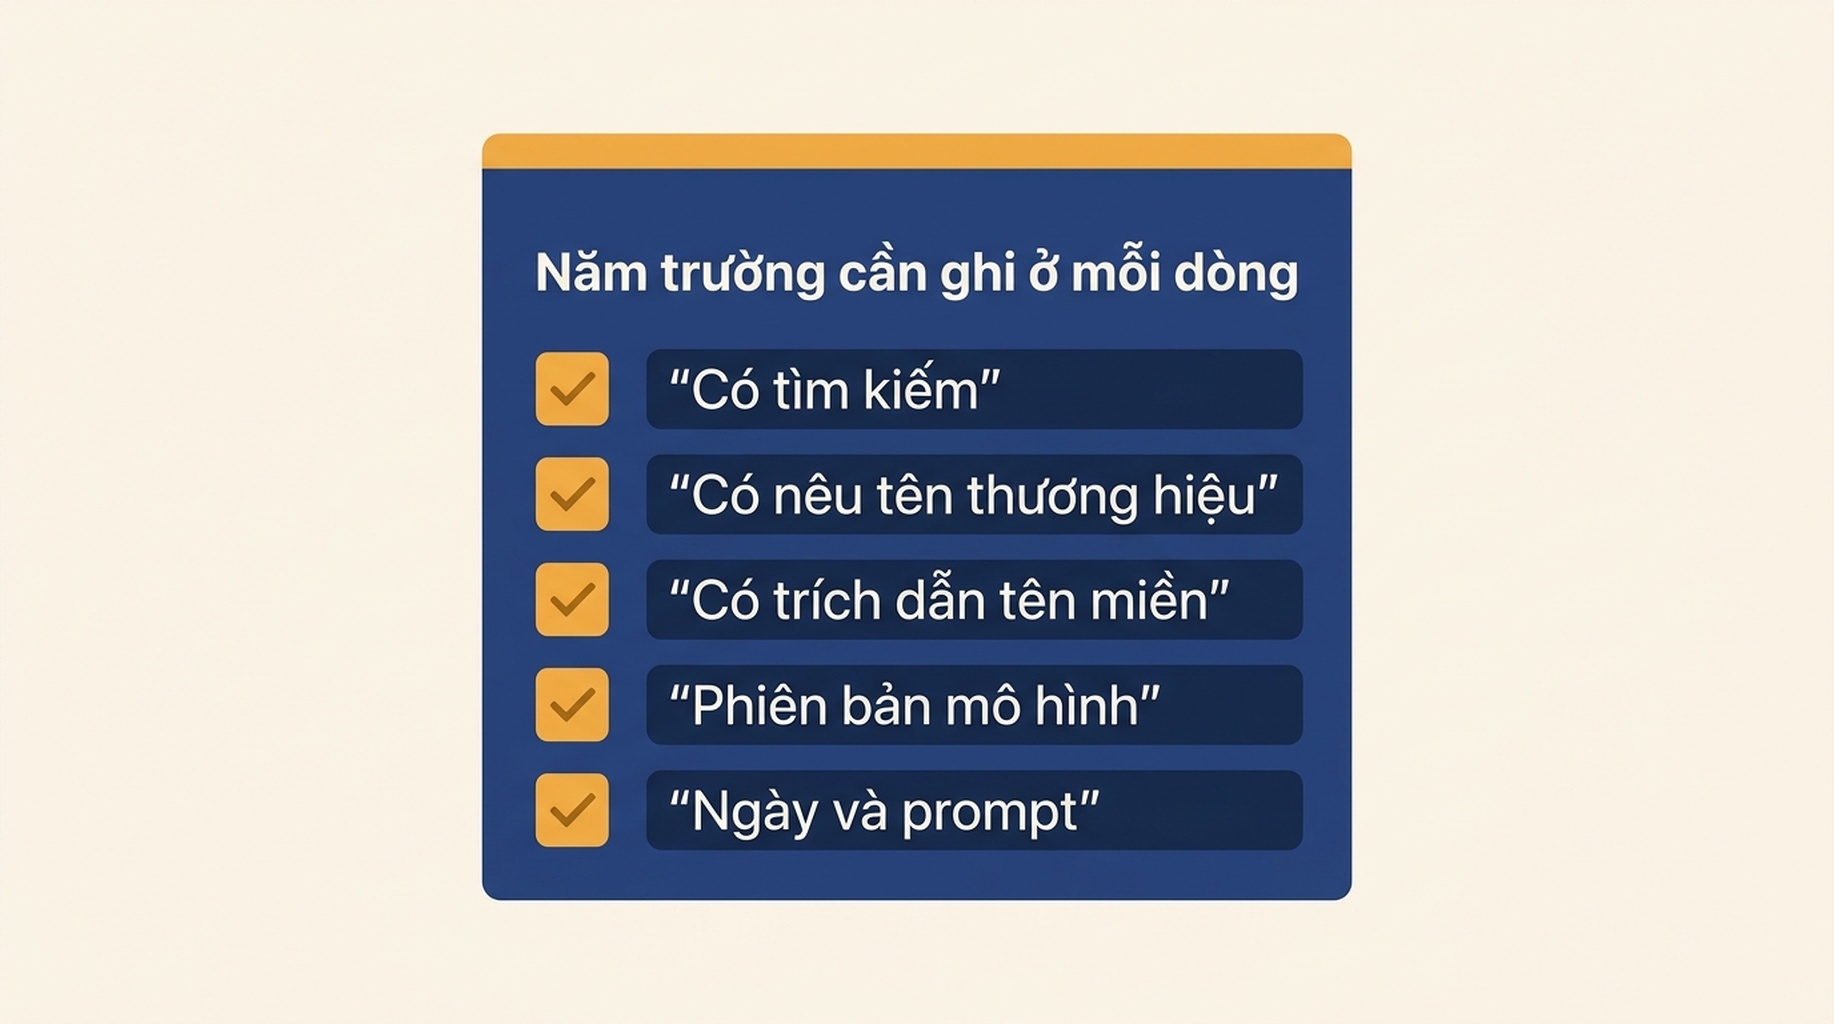
Một con số cho mỗi câu lệnh là lý do các báo cáo mâu thuẫn nhau. Giữ bốn thứ này.
Trường | Giá trị | Vì sao quan trọng |
|---|---|---|
Dựa trên tìm kiếm | có hoặc không | Quyết định câu lệnh có thể tạo liên kết ngay từ đầu hay không |
Thương hiệu được nêu | có hoặc không | Tín hiệu sống sót trong câu trả lời không dựa trên tìm kiếm |
Tên miền được liên kết | có hoặc không | Tín hiệu mà hầu hết công cụ báo cáo một mình |
Phiên bản mô hình | ví dụ gpt-5-2025-08-07 | Hành vi dịch chuyển giữa các phiên bản trong lần chạy của chúng tôi |
Trường cuối không phải thủ tục giấy tờ. Cùng 20 câu lệnh, trên cùng endpoint, chỉ trả nguồn ở 2 câu lệnh với mô hình cũ, so với 8 ở mô hình hiện tại. Báo cáo không có phiên bản mô hình thì không so được với báo cáo tháng sau.
Kết quả: bốn trường đầy đủ cho mỗi câu lệnh. Kiểm tra chất lượng: nếu có ô nào trống, dòng đó không được báo cáo. Lưu văn bản thô của câu trả lời và danh sách nguồn thô bên cạnh các trường, để người phản biện kiểm lại phán quyết mà không phải chạy lại câu lệnh.
Bước 4: xếp mỗi câu trả lời vào một trong bốn phán quyết
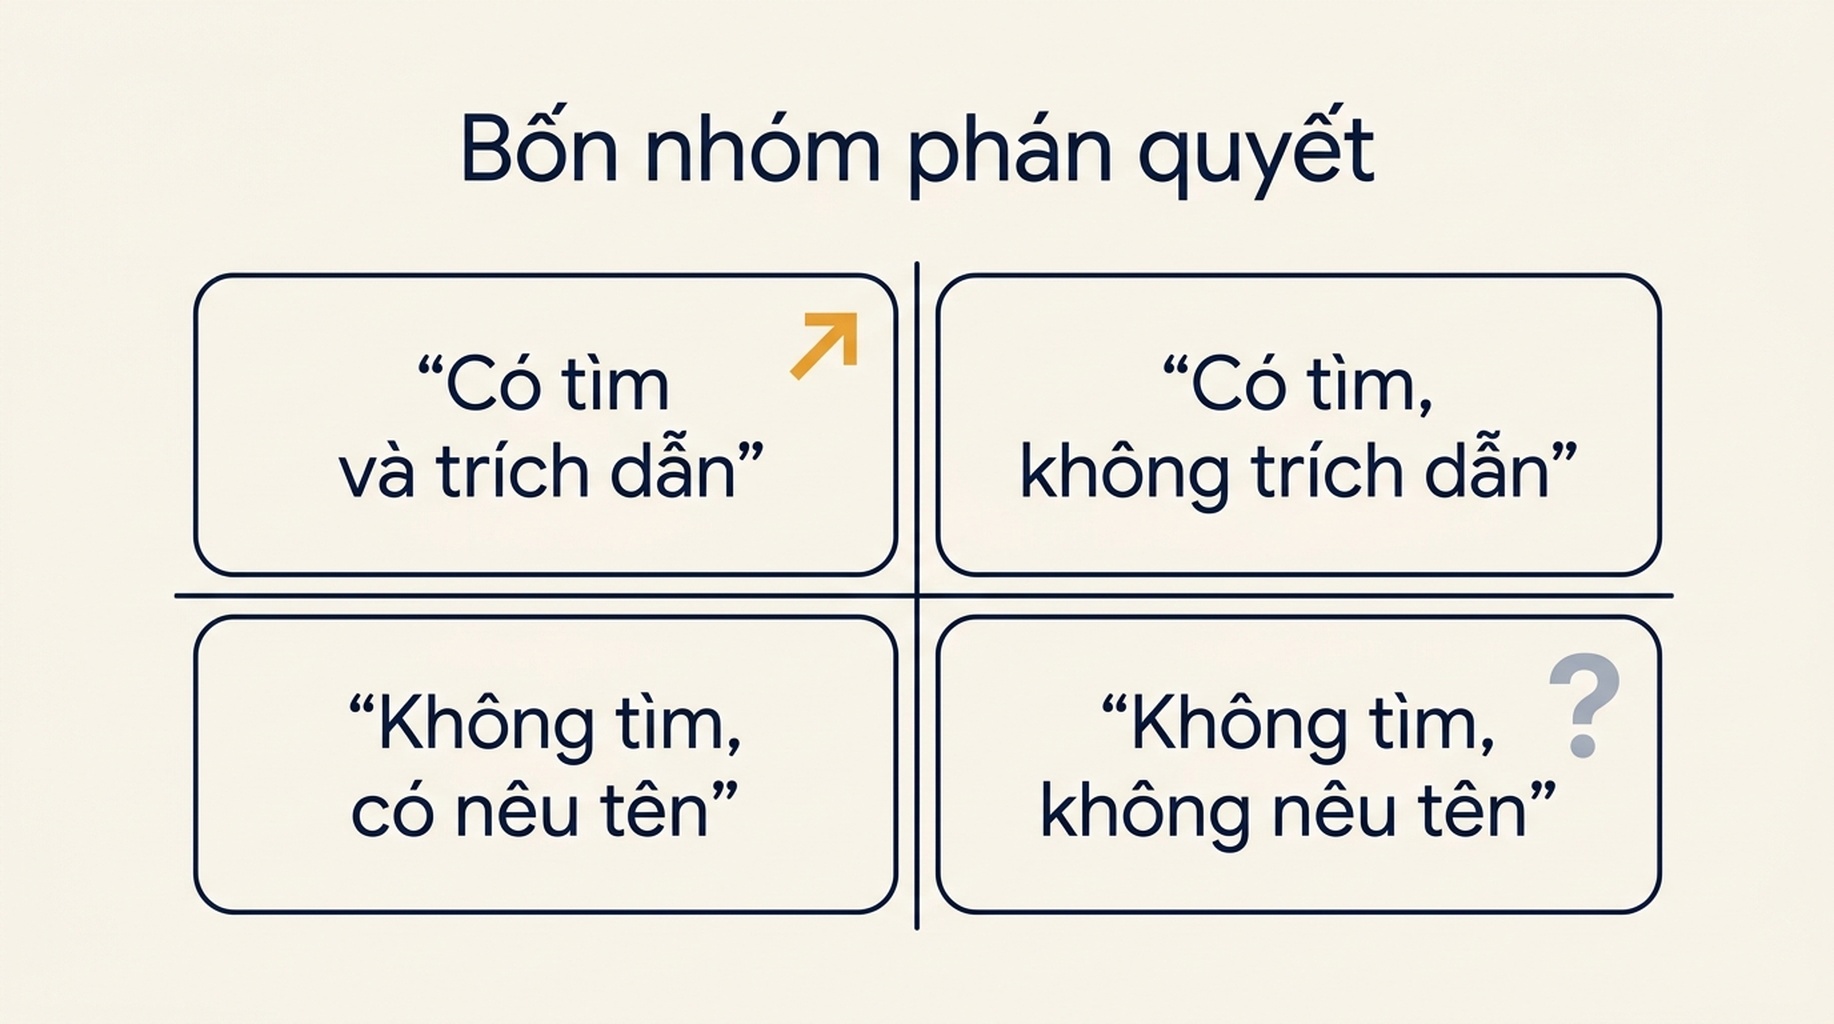
Phán quyết | Nghĩa là gì | Việc cần làm tiếp |
|---|---|---|
Có tìm kiếm và có liên kết | ChatGPT đã tìm gì đó và trích dẫn tên miền của bạn | Bảo vệ trang được trích dẫn và xem dạng câu hỏi nào tạo ra nó |
Có tìm kiếm, không liên kết | Nó đã tìm, đọc web và đề xuất bên khác | Khoảng trống nằm ở nội dung và độ phủ nguồn, không ở kiến thức của mô hình |
Không tìm kiếm nhưng được nêu tên | Nó trả lời từ ký ức và vẫn nêu tên bạn | Không có gì phải sửa. Chạy lại câu lệnh đó sau để xem nó có bắt đầu tìm kiếm không |
Không tìm kiếm và không được nêu tên | Nó trả lời từ ký ức và không nêu tên bạn | Đây chưa phải tín hiệu. Sửa câu lệnh hoặc chờ một lần chạy có tìm kiếm |
Dòng thứ tư là nguồn của phần lớn báo động giả. Trong dữ liệu của chúng tôi, 13 trong 20 câu trả lời của ChatGPT nêu ít nhất một nhà cung cấp, trong khi chỉ 8 trong 20 trích dẫn bất cứ điều gì, nghĩa là một phần câu trả lời sẽ trông trống với kiểm tra chỉ đọc liên kết, trong khi chính văn bản đó đang nêu tên thương hiệu.
Kết quả: một phán quyết cho mỗi câu lệnh, kèm hành động. Kiểm tra chất lượng: mọi phán quyết "vô hình" phải gắn với một câu trả lời dựa trên tìm kiếm. Nếu lý lẽ đằng sau phán quyết không trụ nổi khi viết thành một câu, hãy chạy lại câu lệnh.
Bước 5: lặp lại hai câu lệnh trước khi tin một thay đổi
Chạy ít nhất hai câu lệnh lần thứ hai, trong hội thoại mới, rồi so phán quyết chứ không so con số.
Câu lệnh | Lần chạy đầu | Lần chạy thứ hai | Ổn định |
|---|---|---|---|
Công cụ hiển thị trên AI tốt nhất | có tìm kiếm, 13 nguồn, 6 tên miền | có tìm kiếm, 14 nguồn, 4 tên miền | phán quyết có, con số không |
Công cụ tốt nhất để theo dõi nhắc tới thương hiệu | có tìm kiếm, 8 nguồn, 8 tên miền | có tìm kiếm, 9 nguồn, 5 tên miền | phán quyết có, con số không |
Kiểm tra thương hiệu của tôi trong câu trả lời AI | không tìm kiếm, 0 nguồn | không tìm kiếm, 0 nguồn | có |
Câu trả lời AI thay đổi bao lâu một lần | không tìm kiếm, 0 nguồn | không tìm kiếm, 0 nguồn | có |
Ở cả năm câu lệnh chúng tôi chạy lặp, quyết định tìm kiếm luôn khớp với chính nó, trong khi số tên miền dịch hai hoặc ba đơn vị. Đó là cách hiệu chỉnh đúng: coi phán quyết là tín hiệu và con số là ước lượng có khoảng.
Kết quả: một dòng lặp lại cho ít nhất hai câu lệnh. Kiểm tra chất lượng: nếu phán quyết lật giữa các lần chạy trên một câu lệnh không đổi, đánh dấu câu lệnh đó là không ổn định và loại khỏi báo cáo tháng này qua tháng khác cho tới khi nó lặp lại.
Bước 6: đưa kiểm tra vào lịch
Một kiểm tra mười câu lệnh tốn khoảng 0,29 đô la trên mô hình ChatGPT hiện tại, tức khoảng 1,27 đô la mỗi tháng nếu chạy hằng tuần. Với mức giá đó, công việc không nằm ở lời gọi API mà ở tiêu chí đánh giá, nên hãy giao việc cho một agent có quy tắc thu thập rõ ràng, không phải cho một yêu cầu tóm tắt.
Truyền cho agent những ràng buộc này:
- Ghi lại nguyên văn văn bản câu trả lời và nguyên văn danh sách nguồn. Không tóm tắt cả hai.
- Ghi cờ dựa trên tìm kiếm, phiên bản mô hình và dấu thời gian vào mọi dòng.
- Tính con số bằng mã sau khi thu thập, không bao giờ tính trong câu lệnh.
- Ghi vào tệp có ngày, để lần chạy lặp không ghi đè bằng chứng tháng trước.
Nếu bạn đã chạy agent cho báo cáo tìm kiếm, mẫu thu thập cũng giống như trong theo dõi SEO và GEO hằng ngày với Codex, và bản terminal của cùng vòng lặp đó nằm ở theo dõi hằng ngày với Claude Code. Yêu cầu mới duy nhất ở đây là cờ dựa trên tìm kiếm, vì một bề mặt chat không tìm kiếm thì không được đọc như kết quả trích dẫn.
Kết quả: một tác vụ theo lịch ghi các dòng có ngày. Kiểm tra chất lượng: mở tệp tuần trước và xác nhận bạn dựng lại được phán quyết chỉ từ bằng chứng đã lưu.
Xác minh: một kiểm tra hợp lệ trông như thế này
- Mọi dòng đều có cờ dựa trên tìm kiếm, phiên bản mô hình và ngày.
- Mọi phán quyết "vô hình" đều thuộc một câu trả lời dựa trên tìm kiếm.
- Ít nhất hai câu lệnh được chạy hai lần và phán quyết của chúng được đem so.
- Văn bản thô của câu trả lời và danh sách nguồn thô được lưu bên cạnh các con số.
- Danh sách câu lệnh được gắn nhãn theo dạng, và báo cáo nhóm kết quả theo dạng chứ không theo tổng.
Giới hạn
- Một phiên bản mô hình, một địa điểm, tiếng Anh, một ngày chạy. Hành vi của ChatGPT khác nhau giữa các phiên bản.
- Tìm kiếm web được bật qua API. Ứng dụng cho người dùng có thể tìm trên một tập câu lệnh khác.
- Việc nêu tên thương hiệu được đo bằng khớp văn bản, nên một tên sản phẩm không kèm tên công ty có thể bị bỏ sót.
- Kiểm tra này đo câu trả lời, không đo lưu lượng. Hành vi giới thiệu là một phép đo riêng.
Câu hỏi thường gặp
Vì sao ChatGPT không nói gì về thương hiệu của tôi?
Trước tiên hãy kiểm tra xem nó có tìm kiếm không. Trong lần chạy của chúng tôi, nó trả lời từ ký ức 12 trong 20 câu lệnh, không có nguồn, và những câu trả lời đó có thể nêu một nhà cung cấp từ dữ liệu huấn luyện cũ hoặc không nêu ai. Một câu trả lời không dựa trên tìm kiếm không phải bằng chứng về hiển thị của bạn.
Nên kiểm tra bao nhiêu câu lệnh trên ChatGPT?
Tám đến mười hai mỗi vòng là đủ để thấy quy luật, miễn là chúng phủ bốn dạng danh mục, so sánh, vấn đề và bằng chứng. Chạy một trăm câu lệnh cho mẫu lớn hơn của chính bốn dạng đó, không phải thông tin mới.
Có kiểm tra được mà không cần API không?
Được. Cả cờ dựa trên tìm kiếm lẫn việc nêu tên thương hiệu đều thấy được trong giao diện, và danh sách nguồn dưới một câu trả lời bao phần trích dẫn. API chỉ quan trọng khi bạn muốn các dòng có ngày và chạy lặp mà không phải sao chép thủ công.
Làm sao biết một thay đổi là thật?
Chạy lặp câu lệnh trước khi báo cáo thay đổi. Ở năm cặp chạy lặp của chúng tôi, quyết định tìm kiếm chưa lần nào lật, trong khi số nguồn dịch hai hoặc ba. Phán quyết đổi trên một câu lệnh dựa trên tìm kiếm thì đáng điều tra. Con số đổi thì không.
Góc nhìn của Auspia: qua cổng hợp lệ trước khi đọc bất kỳ con số nào, và báo cáo phán quyết thay vì con số. Lỗi phổ biến nhất chúng tôi tìm thấy không phải một trích dẫn bị bỏ lỡ, mà là một câu trả lời trống của ChatGPT bị báo cáo thành vô hình trong khi mô hình chẳng tìm gì cả. Sửa cờ trước, phần còn lại của báo cáo sẽ trở nên so được theo từng tháng.
Tác giả: Victor Lane