Якщо вас запитали, чи з'являється ваш бренд у ChatGPT, чесна перша відповідь така: порожній результат і справжній нуль виглядають однаково, доки ви не перевірите одну річ. Цей посібник для тих, кому треба дати цю відповідь без платформи моніторингу, маючи лише вікно чату, таблицю та приблизно тридцять хвилин.
Наприкінці у вас буде вердикт на кожен запит, відтворюваний запис, який можна захистити на нараді, і завдання за розкладом, що тримає його актуальним. Умова завершення проста: для кожного запиту ви можете сказати, чи відповідь була обґрунтована, чи назвала вона бренд і чи послалася вона на сайт.
Що у вас буде наприкінці
Результат | Де він лежить |
|---|---|
Список із 8–12 запитів, написаний з реальних розмов | Перша вкладка вашої таблиці |
Один рядок на запит із чотирма полями та версією моделі | Та сама вкладка |
Один із чотирьох вердиктів на запит із прив'язаною дією | Стовпець вердикту |
Повторний прогін принаймні двох запитів | Рядки 2 і 3 тієї самої таблиці |
Перевірка за розкладом із фіксованим критерієм оцінювання | Папка проєкту вашого агента |
Що потрібно заздалегідь: доступ до ChatGPT із вебпошуком, таблиця та можливість витратити близько 0,29 долара на прогін із десяти запитів, якщо ви його автоматизуєте.
Крок 1: пишіть запити з розмов, а не з ключових слів
Підніміть останні двадцять питань, на які відповідала команда продажів, і згрупуйте їх. У нашому дослідженні двадцяти запитів найширший список джерел дав запит про те, як узагалі домогтися цитування, а найвужчий — пряме порівняння двох інструментів, тобто форма питання визначає, скільки даних вам повернеться.
Напишіть 8–12 запитів за чотирма формами: категорія («найкращий X для Y»), порівняння («A проти B»), проблема («як дізнатися, чи знає ШІ мою компанію») і доказ («хто рекомендує X у 2026 році»). Додайте два запити, які прямо називають ваш бренд, бо вони поводяться інакше, ніж категорійні. Якщо для того самого списку потрібні докази з кількох поверхонь, аналіз перевіряча видимості в ШІ показує, що змінюється, коли той самий запит іде на три поверхні.
Результат: остаточний список із 8–12 запитів, кожен позначений своєю формою. Перевірка якості: кожен запит має бути таким, який клієнт справді набрав би. Якщо запит існує лише тому, що містить ключове слово, викресліть його.
Крок 2: пройдіть ворота достовірності, перш ніж читати будь-що інше
Це крок, який пропускає більшість перевірок, і саме через нього порожнечі потрапляють у звіти як нулі. У нашому прогоні ChatGPT надсилав пошукові запити в 8 випадках із 20, а на решту 12 відповідав із пам'яті.
Що ми спостерігали | Обґрунтовані відповіді (8 запитів) | Необґрунтовані відповіді (12 запитів) |
|---|---|---|
Надіслані пошукові запити | 4–8 на запит | 0 |
Повернені позначки джерел | 6–18, медіана 12 | 0 |
Процитовані унікальні домени | 4–10, медіана 7 | 0 |
Бренди, досі названі в тексті | так | так, загалом у 13 із 20 запитів |
Перш ніж записувати будь-що про свій бренд, проганяйте кожен запит і дайте відповідь на одне питання: чи модель хоч щось шукала? В інтерфейсі ChatGPT підказкою слугує список джерел під відповіддю. Якщо списку джерел немає, відповідь зроблена з пам'яті, і її мовчання про ваш бренд поки нічого не означає.
Результат: так або ні на кожен запит у стовпці обґрунтованості. Перевірка якості: відповідь без списку джерел ніколи не записується як сигнал видимості, лише як сигнал пам'яті. Наші необґрунтовані відповіді до того ж не були коротшими: медіана вихідних токенів 1 730 проти 1 645 в обґрунтованих, тож довжина — непридатна підказка.
Крок 3: записуйте чотири поля, а не одне
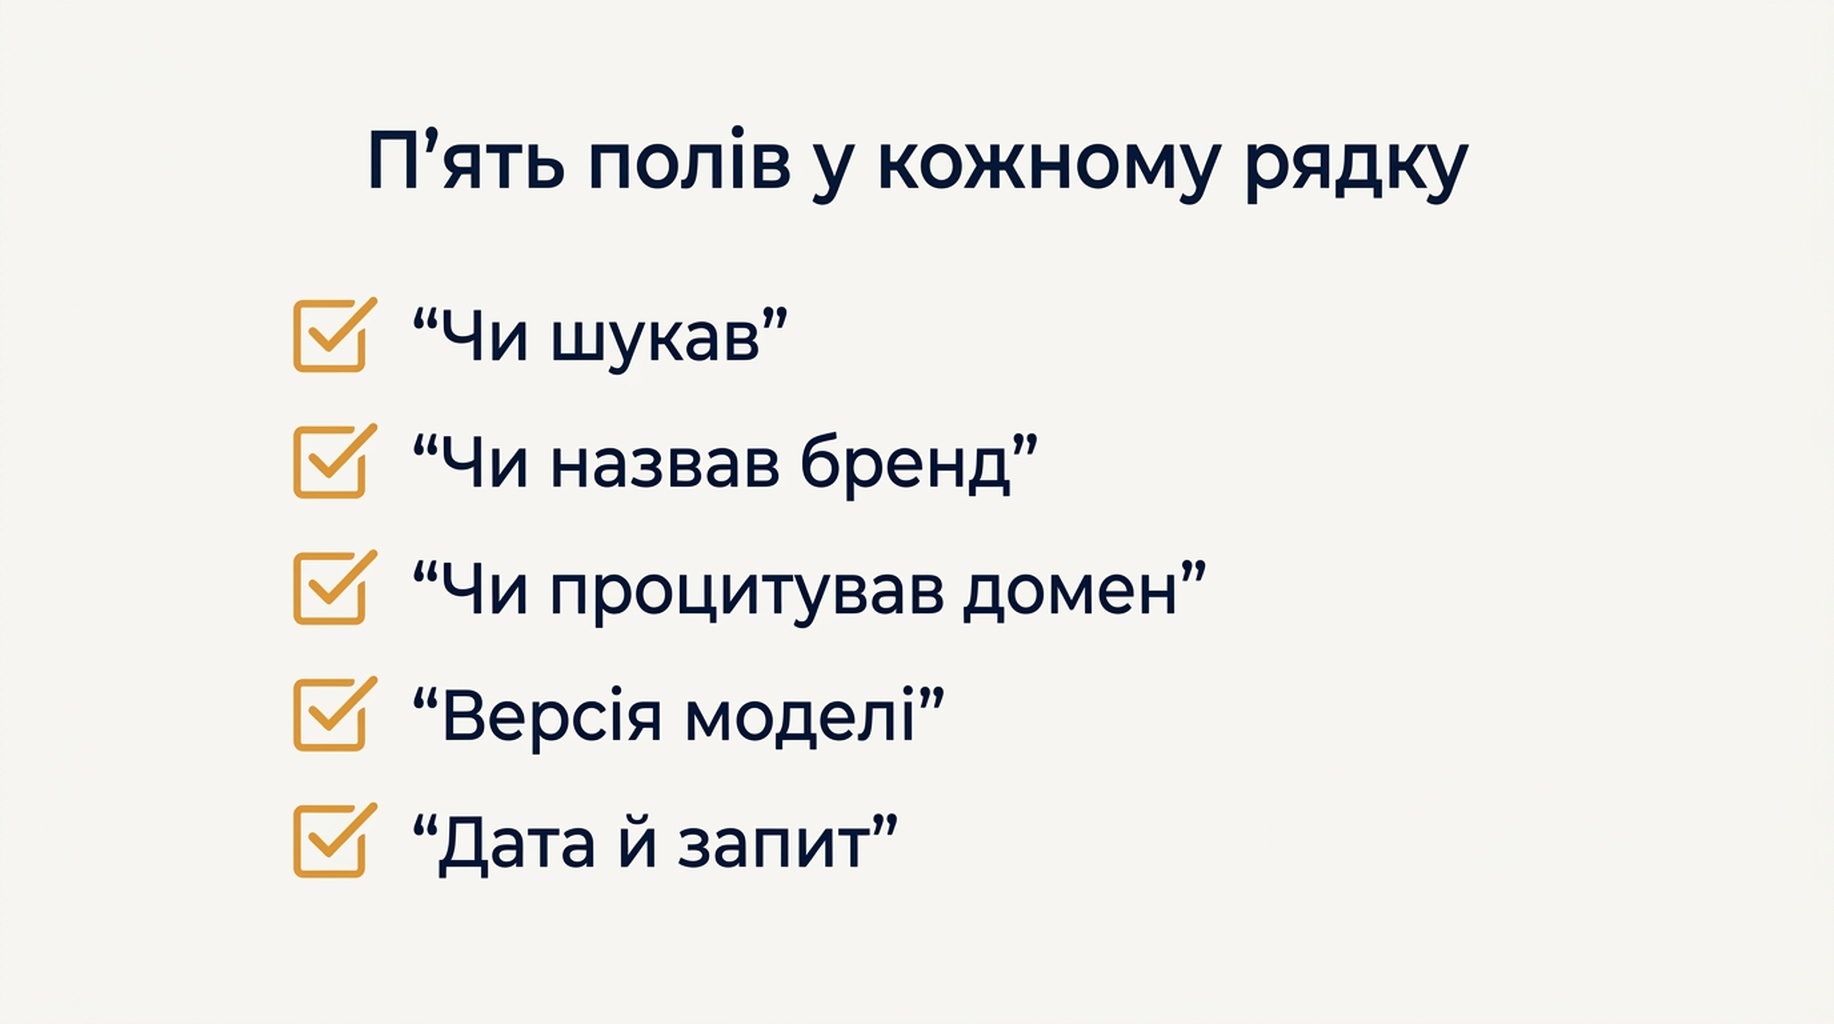
Одне число на запит — ось чому звіти суперечать одне одному. Збережіть ці чотири.
Поле | Значення | Чому це важливо |
|---|---|---|
Обґрунтовано | так або ні | Визначає, чи запит узагалі може дати посилання |
Бренд названо | так або ні | Сигнал, який виживає в необґрунтованій відповіді |
Домен пов'язано | так або ні | Сигнал, про який більшість інструментів повідомляє окремо |
Версія моделі | наприклад gpt-5-2025-08-07 | У наших прогонах поведінка змінювалася між версіями |
Останнє поле — не діловодство. Ті самі 20 запитів на тій самій кінцевій точці повернули джерела лише в 2 запитах на старій моделі проти 8 на поточній. Звіт без версії моделі не можна порівняти зі звітом наступного місяця.
Результат: чотири заповнені поля на запит. Перевірка якості: якщо хоч одна комірка порожня, рядок не можна включати у звіт. Тримайте сирий текст відповіді та сирий список джерел поруч із полями, щоб той, хто перевіряє, міг перепідтвердити вердикт, не проганяючи запит знову.
Крок 4: віднесіть кожну відповідь до одного з чотирьох вердиктів
Вердикт | Що він означає | Що робити далі |
|---|---|---|
Обґрунтовано й пов'язано | ChatGPT щось пошукав і процитував ваш домен | Захистіть процитовану сторінку та з'ясуйте, яка форма питання її породила |
Обґрунтовано, але не пов'язано | Він шукав, читав веб і порадив когось іншого | Розрив у контенті та охопленні джерел, а не в знаннях моделі |
Не обґрунтовано, але названо | Він відповів із пам'яті й усе ж назвав вас | Нічого лагодити. Повторіть пізніше той самий запит і подивіться, чи почне він шукати |
Не обґрунтовано й не названо | Він відповів із пам'яті й не назвав вас | Це поки не сигнал. Виправте запит або дочекайтеся обґрунтованого прогону |
Четвертий рядок — джерело більшості хибних тривог. У наших даних 13 із 20 відповідей ChatGPT назвали принаймні одного постачальника, тоді як процитували хоч щось лише 8 із 20, тобто частина відповідей видасться порожньою перевірці, яка читає лише посилання, тоді як той самий текст називає бренди.
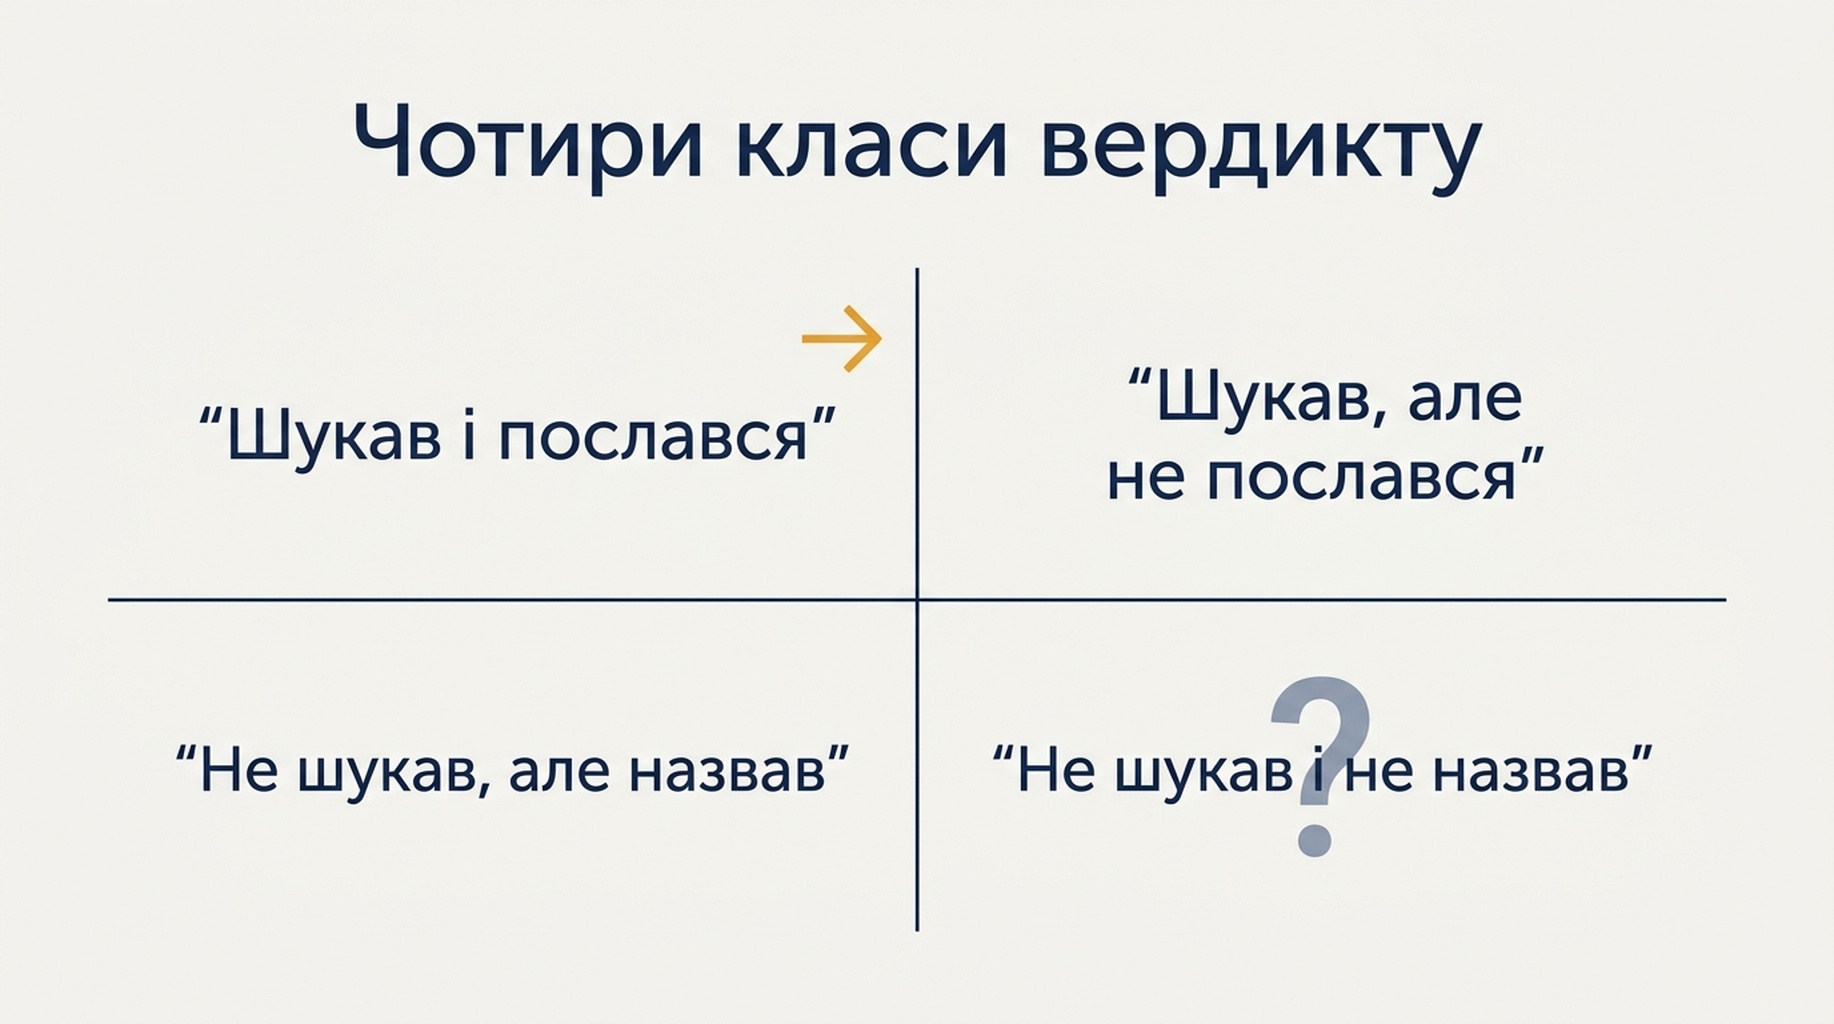
Результат: один вердикт на запит плюс дія. Перевірка якості: будь-який вердикт «невидимий» має бути прив'язаний до обґрунтованої відповіді. Якщо обґрунтування вердикту не витримує викладу одним реченням, проженіть запит знову.
Крок 5: повторіть два запити, перш ніж вірити зміні
Проженіть принаймні два запити вдруге, у новій розмові, і порівняйте вердикт, а не число.
Запит | Перший прогін | Другий прогін | Стабільно |
|---|---|---|---|
Найкращі інструменти видимості в ШІ | обґрунтовано, 13 джерел, 6 доменів | обґрунтовано, 14 джерел, 4 домени | вердикт так, число ні |
Найкращий інструмент для відстеження згадок бренду | обґрунтовано, 8 джерел, 8 доменів | обґрунтовано, 9 джерел, 5 доменів | вердикт так, число ні |
Перевірте мій бренд у відповідях ШІ | не обґрунтовано, 0 джерел | не обґрунтовано, 0 джерел | так |
Як часто змінюються відповіді ШІ | не обґрунтовано, 0 джерел | не обґрунтовано, 0 джерел | так |
На всіх п'яти повторених запитах рішення шукати щоразу збігалося саме із собою, тоді як число доменів зсувалося на два-три. Це і є правильне калібрування: ставтеся до вердикту як до сигналу, а до числа — як до оцінки з діапазоном.
Результат: рядок повторного прогону принаймні для двох запитів. Перевірка якості: якщо на незміненому запиті вердикт перевертається між прогонами, позначте запит як нестабільний і виключайте його зі звітів місяць до місяця, доки він не повториться.
Крок 6: поставте перевірку на розклад
Перевірка з десяти запитів коштує близько 0,29 долара на поточній моделі ChatGPT, приблизно 1,27 долара на місяць за тижневого запуску. За такої ціни робота не у виклику API, а в критерії оцінювання, тож віддавайте завдання агенту з явними правилами збору, а не запиту «зроби вижимку».
Передайте агенту такі обмеження:
- Збирайте текст відповіді дослівно та список джерел дослівно. Ні того, ні того не переказуйте.
- Записуйте прапорець обґрунтованості, версію моделі та позначку часу в кожному рядку.
- Рахуйте числа в коді після збору, ніколи всередині запиту.
- Пишіть у файл із датою, щоб повторний прогін не затер докази минулого місяця.
Якщо ви вже ведете агента для звітів із пошуку, схема збору та сама, що використана в щоденному моніторингу SEO та GEO з Codex, а термінальна версія того самого циклу — у щоденному моніторингу з Claude Code. Єдина нова вимога тут — прапорець обґрунтованості, бо поверхню чату, яка не шукала, не можна читати як результат цитування.
Результат: завдання за розкладом, яке пише рядки з датами. Перевірка якості: відкрийте файл минулого тижня та підтвердьте, що вердикт відновлюється з самих лише збережених доказів.
Перевірка: так виглядає придатна робота
- У кожному рядку є прапорець обґрунтованості, версія моделі та дата.
- Кожен вердикт «невидимий» належить обґрунтованій відповіді.
- Принаймні два запити прогнано двічі, і їхні вердикти порівняно.
- Сирий текст відповіді та сирий список джерел лежать поруч із числами.
- Список запитів позначено за формою, а звіт групує результати за формою, а не за сумою.
Обмеження
- Одна версія моделі, одне місце, англійська, один день прогонів. Поведінка ChatGPT різниться між версіями.
- Вебпошук увімкнено через API. Споживчий застосунок може шукати за іншим набором запитів.
- Називання бренду вимірювалося зіставленням рядків, тож назва продукту без назви компанії може бути пропущена.
- Ця перевірка вимірює відповіді, а не трафік. Поведінка переходів — окреме вимірювання.
Часті питання
Чому ChatGPT нічого не каже про мій бренд?
Спершу перевірте, чи він шукав. У нашому прогоні він відповів із пам'яті на 12 із 20 запитів без джерел, а такі відповіді можуть назвати постачальника зі старих навчальних даних або не назвати нікого. Необґрунтована відповідь не є доказом вашої видимості.
Скільки запитів перевіряти в ChatGPT?
Восьми — дванадцяти за цикл достатньо, щоб побачити закономірність, за умови що вони покривають форми категорії, порівняння, проблеми та доказу. Сотня запитів дасть більшу вибірку тих самих чотирьох форм, а не нову інформацію.
Чи можна перевірити це без API?
Так. І прапорець обґрунтованості, і називання бренду видно в інтерфейсі, а список джерел під відповіддю закриває половину із цитуванням. API потрібен лише тоді, коли ви хочете рядки з датами та повторні прогони без ручного копіювання.
Як зрозуміти, що зміна справжня?
Повторіть запит, перш ніж повідомляти про зміну. У наших п'яти парах повторних прогонів рішення шукати жодного разу не перевернулося, тоді як число джерел зсувалося на два-три. Зміна вердикту на обґрунтованому запиті варта розгляду. Зміна числа — ні.
Погляд Auspia: пройдіть ворота достовірності, перш ніж читати будь-яку цифру, і звітуйте вердиктом, а не числом. Найчастіша помилка, яку ми знайшли, — не пропущене цитування, а порожня відповідь ChatGPT, подана як невидимість, коли модель узагалі нічого не шукала. Виправте спершу прапорець, і решта звіту стане порівнюваною місяць до місяця.
Автор: Віктор Лейн