Se alguém perguntou se a sua marca aparece no ChatGPT, a primeira resposta honesta é que um resultado em branco e um zero de verdade são idênticos até você checar uma coisa. Este guia é para quem precisa entregar essa resposta sem plataforma de monitoramento, com nada além de uma janela de chat, uma planilha e uns trinta minutos.
No fim você terá um veredito por prompt, um registro repetível que você consegue defender numa reunião e um job agendado que mantém tudo atualizado. A condição de conclusão é simples: para cada prompt, você consegue dizer se a resposta foi fundamentada, se nomeou a marca e se vinculou o site.
O que você terá ao terminar
Resultado | Onde fica |
|---|---|
Uma lista de 8 a 12 prompts, escrita a partir de conversas reais | A primeira aba da sua planilha |
Uma linha por prompt com quatro campos e a versão do modelo | A mesma aba |
Um de quatro vereditos por prompt, com a ação atrelada | A coluna de veredito |
Uma repetição para pelo menos dois prompts | As linhas 2 e 3 da mesma planilha |
Uma verificação agendada com critério de avaliação fixo | A pasta do projeto do seu agente |
Pré-requisitos: acesso ao ChatGPT com busca na web, uma planilha e a capacidade de gastar cerca de 0,29 dólar numa execução de dez prompts, caso você automatize.
Passo 1: escreva os prompts a partir de conversas, não de palavras-chave
Puxe as últimas vinte perguntas que o time de vendas respondeu e agrupe. No nosso estudo de vinte prompts, a lista de fontes mais ampla veio de uma pergunta sobre como ser citado, e a mais estreita veio de uma comparação direta entre ferramentas, ou seja, o formato da pergunta decide quantos dados voltam para você.
Escreva de 8 a 12 prompts em quatro formatos: categoria ("melhor X para Y"), comparação ("A vs B"), problema ("como descubro se a IA conhece a minha empresa") e prova ("quem recomenda X em 2026"). Acrescente dois prompts que nomeiam sua marca diretamente, porque eles se comportam diferente dos prompts de categoria. Se você quer evidência de várias superfícies para a mesma lista, a análise do verificador de visibilidade em IA mostra o que muda quando o mesmo prompt vai a três superfícies.
Resultado: uma lista final de 8 a 12 prompts, cada um marcado com seu formato. Verificação de qualidade: todo prompt precisa ser algo que um cliente realmente digitaria. Se um prompt existe só porque contém uma palavra-chave, corte.
Passo 2: passe pelo portão de validade antes de ler qualquer outra coisa
Este é o passo que a maioria das verificações pula, e é a razão de brancos serem reportados como zeros. Na nossa execução, o ChatGPT emitiu consultas de busca em 8 dos 20 prompts e respondeu os outros 12 de memória.
O que observamos | Respostas fundamentadas (8 prompts) | Respostas não fundamentadas (12 prompts) |
|---|---|---|
Consultas de busca emitidas | 4 a 8 por prompt | 0 |
Anotações de fonte devolvidas | 6 a 18, mediana 12 | 0 |
Domínios distintos citados | 4 a 10, mediana 7 | 0 |
Marcas ainda nomeadas no texto | sim | sim, em 13 dos 20 prompts no total |
Antes de registrar qualquer coisa sobre a sua marca, rode cada prompt e responda a uma pergunta: o modelo pesquisou alguma coisa? Na interface do ChatGPT, a pista é a lista de fontes embaixo da resposta. Se não há lista de fontes, a resposta saiu da memória, e o silêncio dela sobre a sua marca ainda não significa nada.
Resultado: sim ou não por prompt na coluna de fundamentação. Verificação de qualidade: uma resposta sem lista de fontes nunca é registrada como sinal de visibilidade, só como sinal de memória. As nossas respostas não fundamentadas também não eram mais curtas: mediana de 1.730 tokens de saída contra 1.645 das fundamentadas, então comprimento não é uma pista utilizável.
Passo 3: registre quatro campos, não um
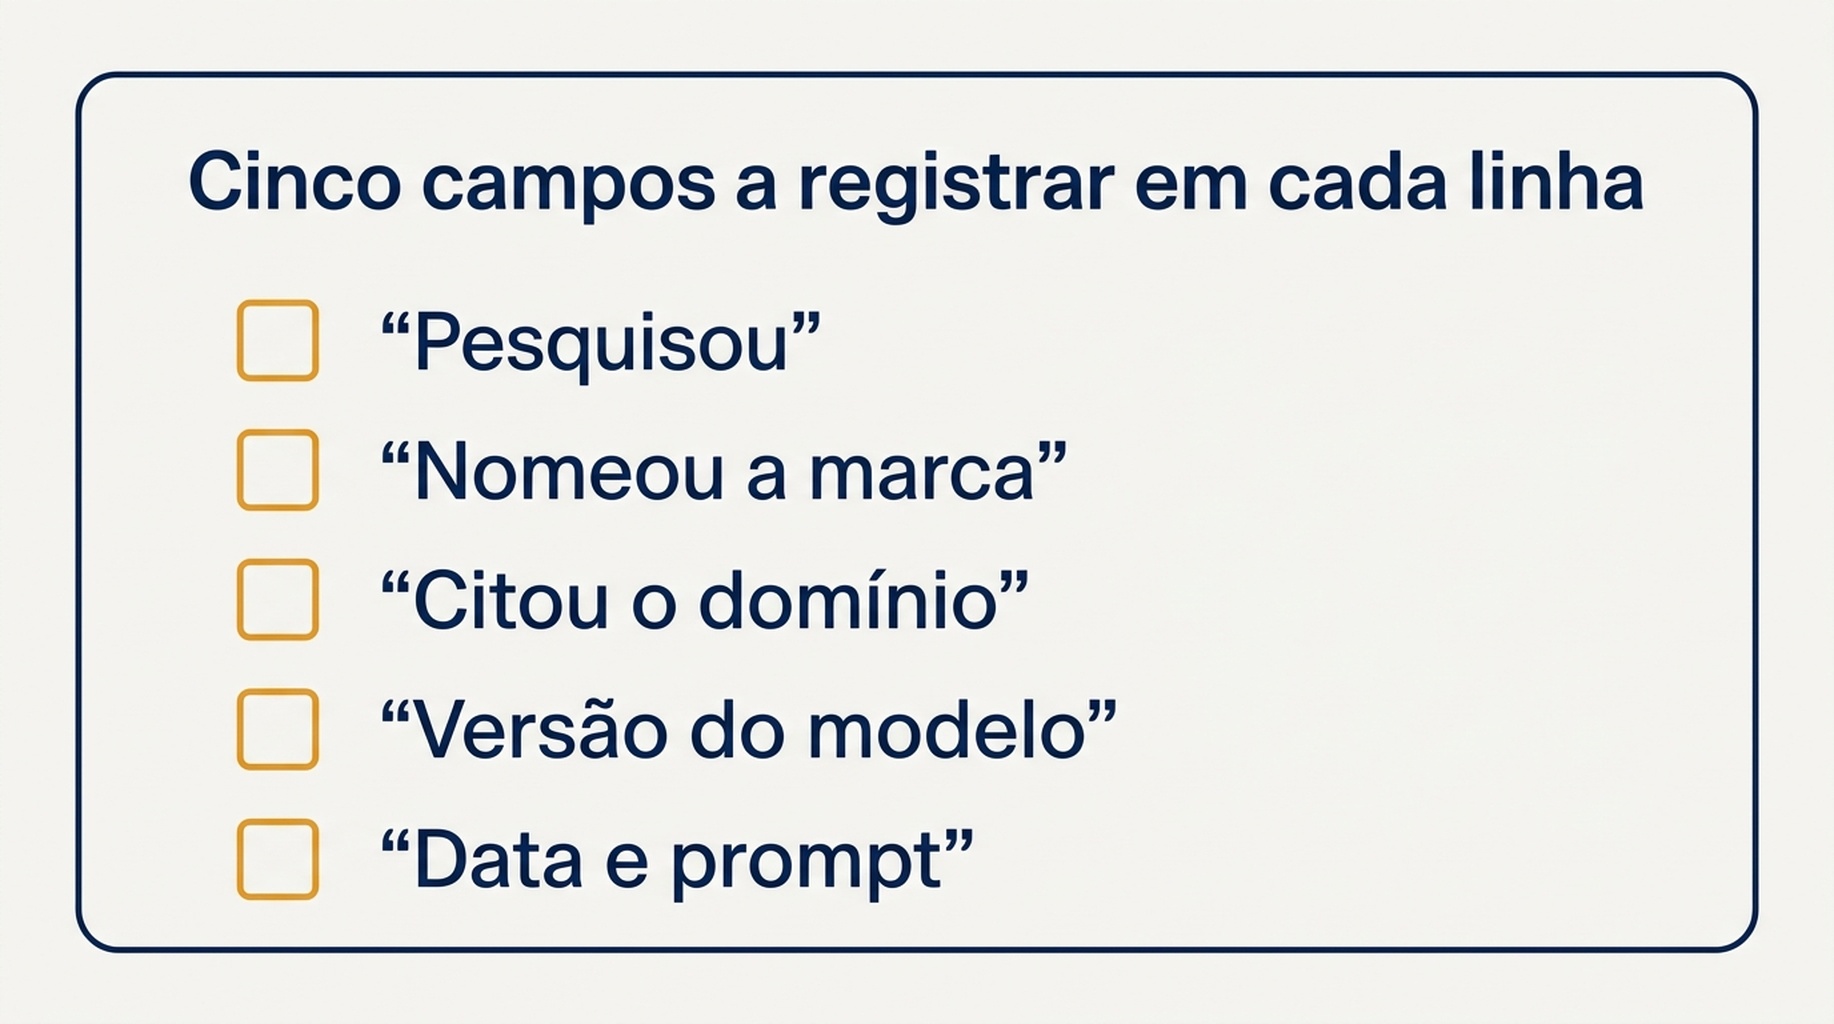
Um número por prompt é a razão de os relatórios discordarem entre si. Mantenha estes quatro.
Campo | Valor | Por que importa |
|---|---|---|
Fundamentado | sim ou não | Decide se o prompt pode gerar um link |
Marca nomeada | sim ou não | O sinal que sobrevive a uma resposta não fundamentada |
Domínio vinculado | sim ou não | O sinal que a maioria das ferramentas relata sozinho |
Versão do modelo | por exemplo gpt-5-2025-08-07 | O comportamento mudou entre versões nas nossas execuções |
O último campo não é burocracia. Os mesmos 20 prompts, no mesmo endpoint, devolveram fontes em 2 prompts com um modelo antigo, contra 8 com o atual. Um relatório sem versão do modelo não pode ser comparado com o do mês que vem.
Resultado: quatro campos preenchidos por prompt. Verificação de qualidade: se qualquer célula estiver vazia, a linha não pode ser reportada. Guarde o texto bruto da resposta e a lista bruta de fontes ao lado dos campos, para que um revisor possa reconferir um veredito sem rodar o prompt de novo.
Passo 4: classifique cada resposta em um dos quatro vereditos
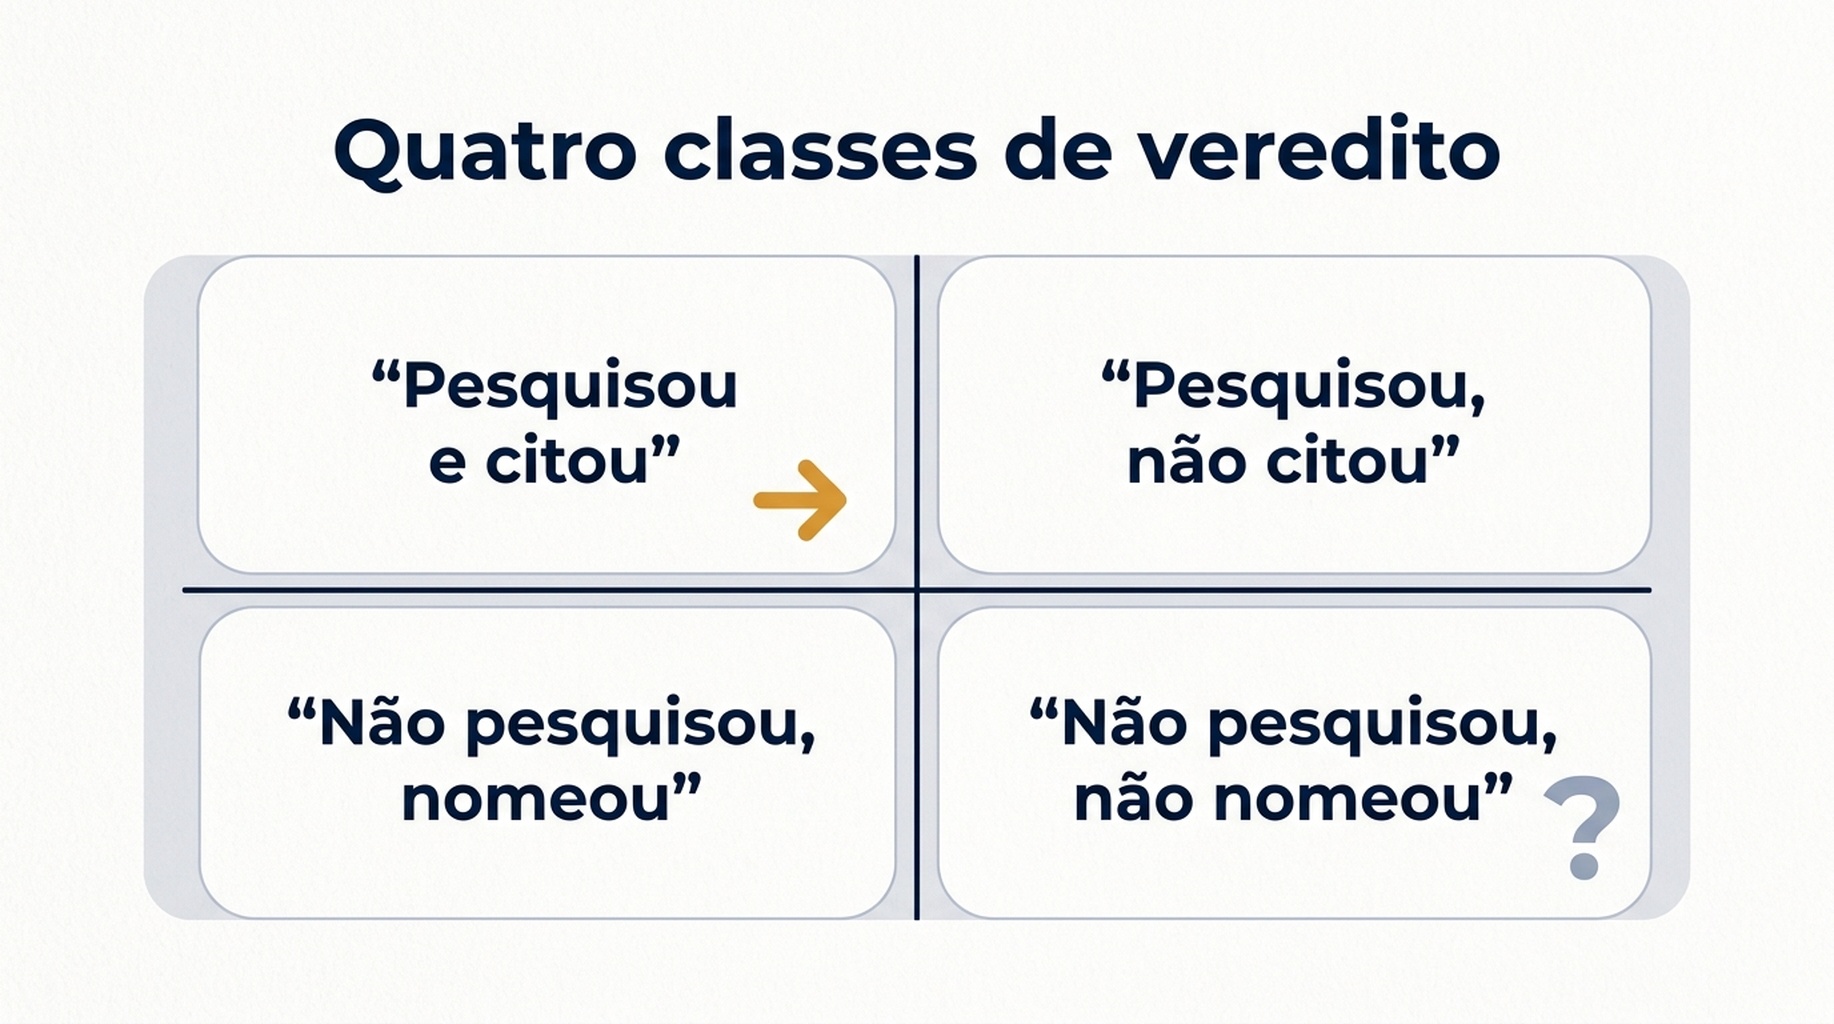
Veredito | O que significa | O que fazer a seguir |
|---|---|---|
Fundamentado e vinculado | O ChatGPT pesquisou algo e citou seu domínio | Proteja a página citada e verifique qual formato de pergunta a produziu |
Fundamentado, sem vínculo | Ele buscou, leu a web e recomendou outra empresa | A lacuna está em conteúdo e cobertura de fontes, não no conhecimento do modelo |
Não fundamentado e nomeado | Ele respondeu de memória e ainda assim nomeou você | Nada a corrigir. Repita depois com o mesmo prompt para ver se ele começa a buscar |
Não fundamentado e não nomeado | Ele respondeu de memória e não nomeou você | Ainda não é um sinal. Corrija o prompt ou espere uma execução fundamentada |
A quarta linha é de onde vêm a maioria dos alarmes falsos. Nos nossos dados, 13 das 20 respostas do ChatGPT nomearam ao menos um fornecedor, enquanto só 8 das 20 citaram qualquer coisa, o que significa que uma parte das respostas vai parecer vazia para uma verificação que só lê links, enquanto o mesmo texto está nomeando marcas.
Resultado: um veredito por prompt, mais a ação. Verificação de qualidade: todo veredito de "invisível" precisa estar atrelado a uma resposta fundamentada. Se o raciocínio por trás de um veredito não sobrevive a ser escrito em uma frase, rode o prompt de novo.
Passo 5: repita dois prompts antes de confiar numa mudança
Rode pelo menos dois prompts uma segunda vez, numa conversa nova, e compare o veredito, não a contagem.
Prompt | Primeira execução | Segunda execução | Estável |
|---|---|---|---|
Melhores ferramentas de visibilidade em IA | fundamentado, 13 fontes, 6 domínios | fundamentado, 14 fontes, 4 domínios | veredito sim, contagem não |
Melhor ferramenta para acompanhar menções à marca | fundamentado, 8 fontes, 8 domínios | fundamentado, 9 fontes, 5 domínios | veredito sim, contagem não |
Audite minha marca nas respostas de IA | não fundamentado, 0 fontes | não fundamentado, 0 fontes | sim |
Com que frequência as respostas de IA mudam | não fundamentado, 0 fontes | não fundamentado, 0 fontes | sim |
Nos cinco prompts que repetimos, a decisão de buscar concordou consigo mesma todas as vezes, enquanto a contagem de domínios se moveu em dois ou três. Essa é a calibragem certa: trate o veredito como sinal e a contagem como estimativa com faixa.
Resultado: uma linha de repetição para pelo menos dois prompts. Verificação de qualidade: se o veredito virar entre execuções num prompt que não mudou, marque o prompt como instável e exclua-o do relatório mês a mês até ele se repetir.
Passo 6: coloque a verificação num cronograma
Uma verificação de dez prompts custa cerca de 0,29 dólar no modelo atual do ChatGPT, mais ou menos 1,27 dólar por mês se você rodar semanalmente. Nesse preço, o trabalho não é a chamada de API, é o critério de avaliação, então entregue o job a um agente com regras de coleta explícitas, não a um pedido de resumo.
Passe estas restrições ao agente:
- Capture o texto da resposta literalmente e a lista de fontes literalmente. Não resuma nenhum dos dois.
- Registre o sinalizador de fundamentação, a versão do modelo e o carimbo de data e hora em todas as linhas.
- Calcule contagens em código depois da coleta, nunca dentro do prompt.
- Escreva num arquivo com data, para que uma repetição não sobrescreva a evidência do mês passado.
Se você já roda um agente para relatórios de busca, o padrão de coleta é o mesmo usado no monitoramento diário de SEO e GEO com o Codex, e a versão de terminal do mesmo laço está no monitoramento diário com o Claude Code. O único requisito novo aqui é o sinalizador de fundamentação, porque uma superfície de chat que não buscou não pode ser lida como resultado de citação.
Resultado: um job agendado que escreve linhas com data. Verificação de qualidade: abra o arquivo da semana passada e confirme que você consegue reconstruir o veredito apenas com a evidência guardada.
Verificação: uma checagem válida se parece com isto
- Toda linha tem um sinalizador de fundamentação, uma versão de modelo e uma data.
- Todo veredito de "invisível" pertence a uma resposta fundamentada.
- Pelo menos dois prompts foram rodados duas vezes e seus vereditos comparados.
- O texto bruto da resposta e a lista bruta de fontes estão guardados ao lado das contagens.
- A lista de prompts está marcada por formato, e o relatório agrupa resultados por formato, não por total.
Limites
- Uma versão de modelo, um local, inglês, um dia de execuções. O comportamento do ChatGPT difere entre versões.
- A busca na web foi ativada por API. O app de consumidor pode buscar num conjunto diferente de prompts.
- A nomeação de marca foi medida por correspondência de texto, então um nome de produto sem o nome da empresa pode passar batido.
- Esta verificação mede respostas, não tráfego. O comportamento de referral é uma medição separada.
Perguntas frequentes
Por que o ChatGPT não diz nada sobre a minha marca?
Verifique primeiro se ele buscou. Na nossa execução, ele respondeu 12 dos 20 prompts de memória, sem fontes, e essas respostas podem nomear um fornecedor de dados de treino antigos ou não nomear ninguém. Uma resposta não fundamentada não é evidência sobre a sua visibilidade.
Quantos prompts devo verificar no ChatGPT?
De oito a doze por ciclo já basta para ver o padrão, desde que cubram os formatos de categoria, comparação, problema e prova. Rodar cem prompts dá uma amostra maior dos mesmos quatro formatos, não informação nova.
Dá para verificar isso sem API?
Dá. Tanto o sinalizador de fundamentação quanto a nomeação de marca são visíveis na interface, e a lista de fontes embaixo de uma resposta cobre a metade da citação. A API só importa quando você quer linhas com data e repetições sem cópia manual.
Como sei se uma mudança é real?
Repita o prompt antes de reportar uma mudança. Nos nossos cinco pares de repetição, a decisão de buscar nunca virou, enquanto as contagens de fontes se moveram em dois ou três. Uma mudança de veredito num prompt fundamentado vale investigação. Uma mudança de contagem, não.
Visão da Auspia: passe pelo portão de validade antes de ler qualquer número, e reporte o veredito em vez de uma contagem. O erro mais comum que encontramos não é uma citação perdida, é uma resposta em branco do ChatGPT sendo reportada como invisibilidade quando o modelo nunca pesquisou nada. Conserte o sinalizador primeiro, e o resto do relatório passa a ser comparável mês a mês.
Autor: Victor Lane