Si alguien te preguntó si tu marca aparece en ChatGPT, la primera respuesta honesta es que un resultado en blanco y un cero real se ven idénticos hasta que compruebas una cosa. Esta guía es para quien tiene que dar esa respuesta sin plataforma de monitoreo, con nada más que una ventana de chat, una hoja de cálculo y unos treinta minutos.
Al terminar tendrás un veredicto por prompt, un registro repetible que puedes defender en una reunión y un trabajo programado que lo mantiene al día. La condición de cierre es simple: para cada prompt, puedes decir si la respuesta estuvo fundamentada, si nombró la marca y si enlazó el sitio.
Qué tendrás al terminar
Resultado | Dónde vive |
|---|---|
Una lista de 8 a 12 prompts, escrita a partir de conversaciones reales | La primera pestaña de tu hoja |
Una fila por prompt con cuatro campos y la versión del modelo | La misma pestaña |
Uno de cuatro veredictos por prompt, con la acción adjunta | La columna de veredicto |
Una repetición de al menos dos prompts | Las filas 2 y 3 de la misma hoja |
Una verificación programada con criterio de evaluación fijo | La carpeta de proyecto de tu agente |
Requisitos previos: acceso a ChatGPT con búsqueda web, una hoja de cálculo y la capacidad de gastar unos 0,29 dólares en una ejecución de diez prompts si lo automatizas.
Paso 1: escribe los prompts desde conversaciones, no desde palabras clave
Saca las últimas veinte preguntas que respondió el equipo de ventas y agrúpalas. En nuestro estudio de veinte prompts, la lista de fuentes más amplia vino de una pregunta sobre cómo lograr que te citen, y la más estrecha de una comparación directa entre herramientas, es decir, la forma de la pregunta decide cuántos datos te vuelven.
Escribe de 8 a 12 prompts en cuatro formas: categoría («el mejor X para Y»), comparación («A frente a B»), problema («cómo sé si la IA conoce mi empresa») y prueba («quién recomienda X en 2026»). Añade dos prompts que nombren tu marca directamente, porque se comportan distinto de los de categoría. Si quieres evidencia de varias superficies para la misma lista, el análisis del verificador de visibilidad en IA muestra qué cambia cuando el mismo prompt va a tres superficies.
Resultado: una lista final de 8 a 12 prompts, cada uno marcado con su forma. Control de calidad: cada prompt debe ser algo que un cliente teclearía de verdad. Si un prompt existe solo porque contiene una palabra clave, córtalo.
Paso 2: pasa la puerta de validez antes de leer cualquier otra cosa
Este es el paso que la mayoría de las verificaciones se salta, y es la razón de que los blancos se reporten como ceros. En nuestra ejecución, ChatGPT emitió consultas de búsqueda en 8 de los 20 prompts y respondió los otros 12 de memoria.
Qué observamos | Respuestas fundamentadas (8 prompts) | Respuestas no fundamentadas (12 prompts) |
|---|---|---|
Consultas de búsqueda emitidas | 4 a 8 por prompt | 0 |
Anotaciones de fuente devueltas | 6 a 18, mediana 12 | 0 |
Dominios distintos citados | 4 a 10, mediana 7 | 0 |
Marcas aún nombradas en el texto | sí | sí, en 13 de los 20 prompts en total |
Antes de registrar nada sobre tu marca, ejecuta cada prompt y responde una pregunta: ¿el modelo buscó algo? En la interfaz de ChatGPT, la pista es la lista de fuentes bajo la respuesta. Si no hay lista de fuentes, la respuesta salió de la memoria, y su silencio sobre tu marca todavía no significa nada.
Resultado: sí o no por prompt en la columna de fundamentación. Control de calidad: una respuesta sin lista de fuentes nunca se registra como señal de visibilidad, solo como señal de memoria. Nuestras respuestas no fundamentadas tampoco eran más cortas: mediana de 1.730 tokens de salida frente a 1.645 de las fundamentadas, así que la longitud no es una pista utilizable.
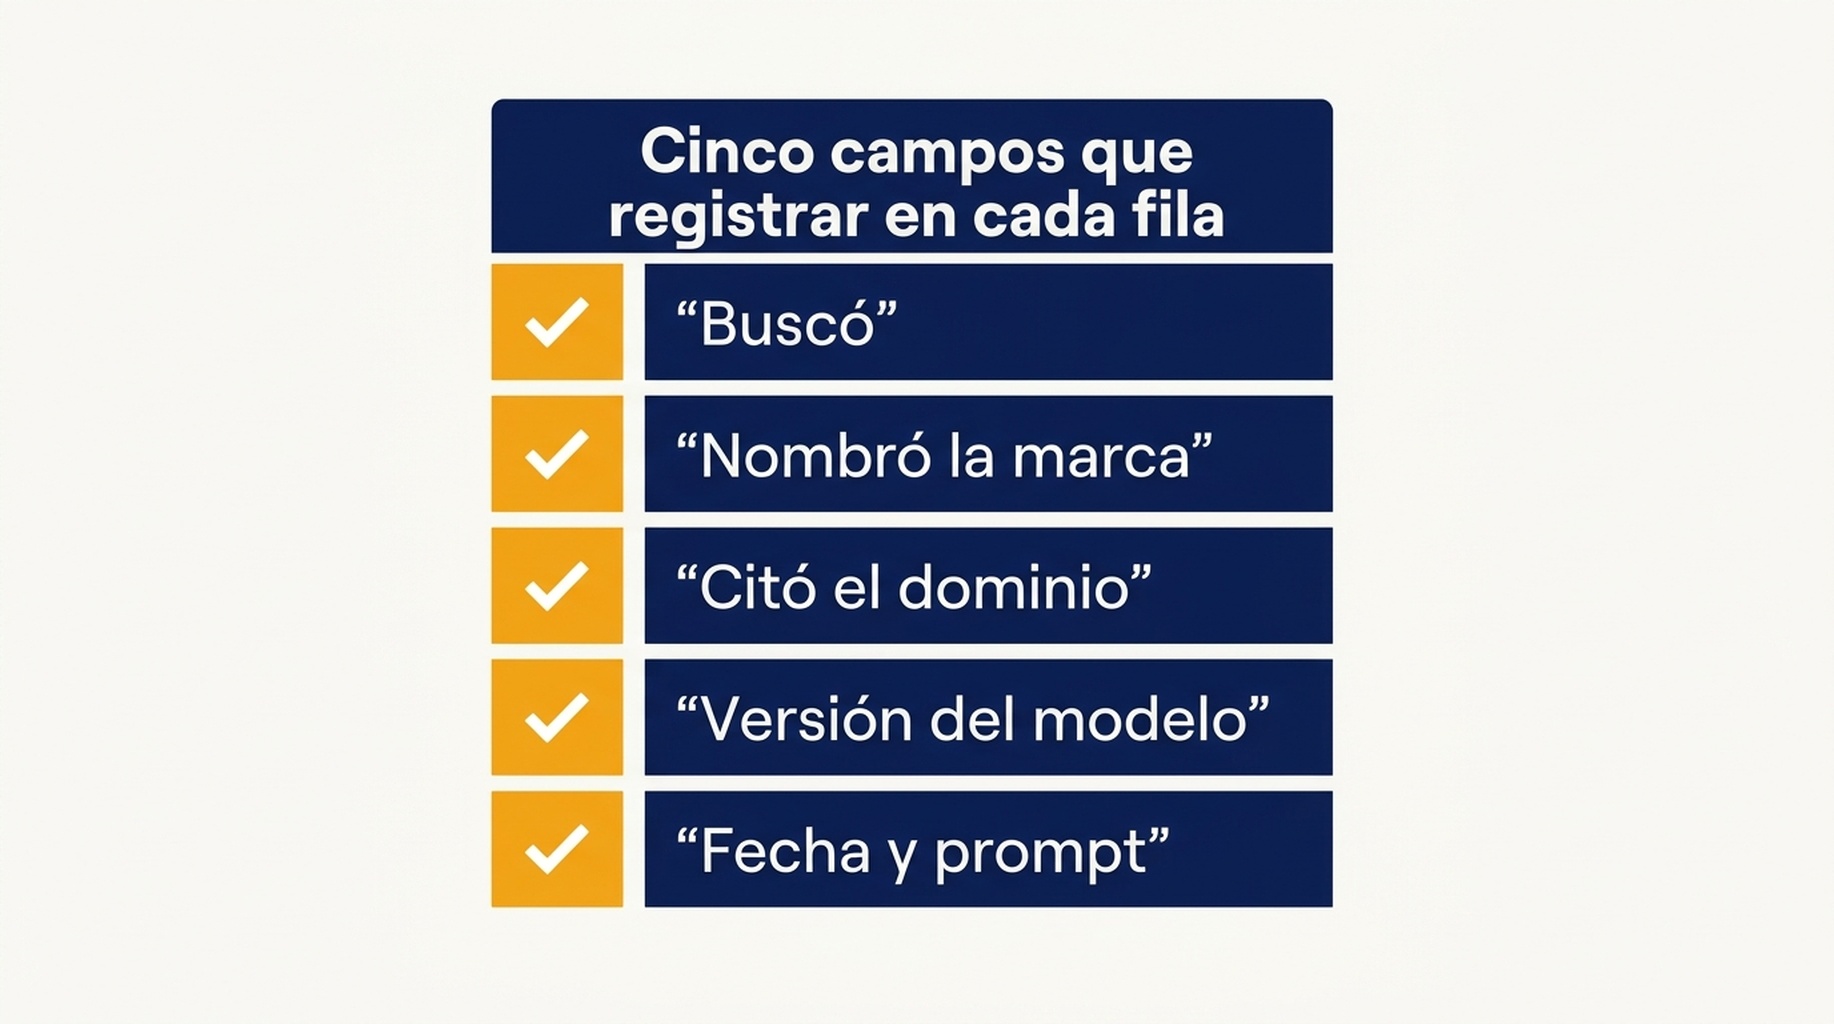
Paso 3: registra cuatro campos, no uno
Un número por prompt es la razón de que los informes se contradigan entre sí. Conserva estos cuatro.
Campo | Valor | Por qué importa |
|---|---|---|
Fundamentado | sí o no | Decide si el prompt puede siquiera producir un enlace |
Marca nombrada | sí o no | La señal que sobrevive en una respuesta no fundamentada |
Dominio enlazado | sí o no | La señal que la mayoría de las herramientas reporta por sí sola |
Versión del modelo | por ejemplo gpt-5-2025-08-07 | El comportamiento se movió entre versiones en nuestras ejecuciones |
El último campo no es burocracia. Los mismos 20 prompts, en el mismo endpoint, devolvieron fuentes en 2 prompts con un modelo antiguo, frente a 8 con el actual. Un informe sin versión del modelo no se puede comparar con el del mes que viene.
Resultado: cuatro campos completos por prompt. Control de calidad: si alguna celda está vacía, la fila no se puede reportar. Guarda el texto crudo de la respuesta y la lista cruda de fuentes junto a los campos, para que un revisor pueda revalidar un veredicto sin volver a ejecutar el prompt.
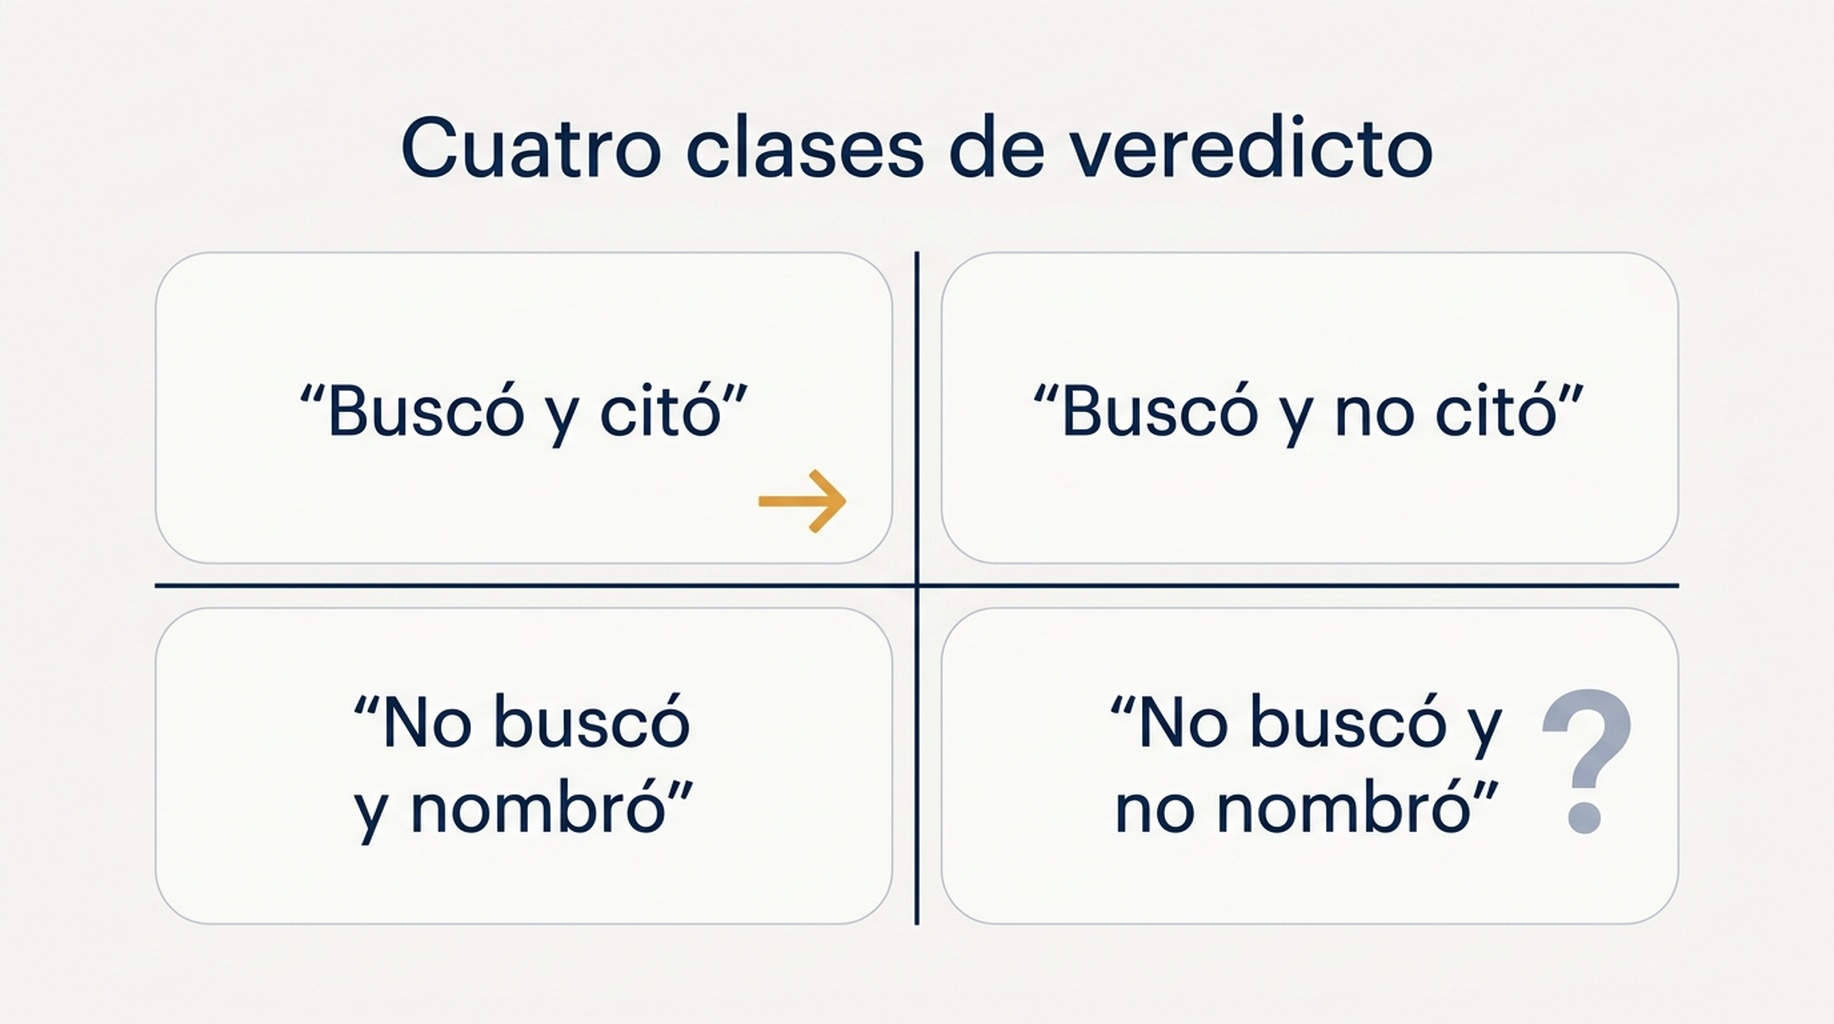
Paso 4: clasifica cada respuesta en uno de cuatro veredictos
Veredicto | Qué significa | Qué hacer después |
|---|---|---|
Fundamentado y enlazado | ChatGPT buscó algo y citó tu dominio | Protege la página citada y comprueba qué forma de pregunta la produjo |
Fundamentado, no enlazado | Buscó, leyó la web y recomendó a otro | La brecha está en el contenido y la cobertura de fuentes, no en el conocimiento del modelo |
No fundamentado y nombrado | Respondió de memoria y aun así te nombró | Nada que arreglar. Repite luego el mismo prompt para ver si empieza a buscar |
No fundamentado y no nombrado | Respondió de memoria y no te nombró | Todavía no es una señal. Corrige el prompt o espera una ejecución fundamentada |
La cuarta fila es de donde salen la mayoría de las falsas alarmas. En nuestros datos, 13 de las 20 respuestas de ChatGPT nombraron al menos a un proveedor, mientras que solo 8 de 20 citaron algo, lo que significa que parte de las respuestas parecerá vacía a una verificación que solo lee enlaces, mientras ese mismo texto está nombrando marcas.
Resultado: un veredicto por prompt, más la acción. Control de calidad: todo veredicto de «invisible» debe estar atado a una respuesta fundamentada. Si el razonamiento detrás de un veredicto no aguanta escribirse en una frase, vuelve a ejecutar el prompt.
Paso 5: repite dos prompts antes de confiar en un cambio
Ejecuta al menos dos prompts una segunda vez, en una conversación nueva, y compara el veredicto, no el recuento.
Prompt | Primera ejecución | Segunda ejecución | Estable |
|---|---|---|---|
Mejores herramientas de visibilidad en IA | fundamentado, 13 fuentes, 6 dominios | fundamentado, 14 fuentes, 4 dominios | veredicto sí, recuento no |
Mejor herramienta para seguir menciones de marca | fundamentado, 8 fuentes, 8 dominios | fundamentado, 9 fuentes, 5 dominios | veredicto sí, recuento no |
Audita mi marca en las respuestas de IA | no fundamentado, 0 fuentes | no fundamentado, 0 fuentes | sí |
Con qué frecuencia cambian las respuestas de IA | no fundamentado, 0 fuentes | no fundamentado, 0 fuentes | sí |
En los cinco prompts que repetimos, la decisión de buscar coincidió consigo misma todas las veces, mientras que el recuento de dominios se movió en dos o tres. Esa es la calibración correcta: trata el veredicto como señal y el recuento como una estimación con rango.
Resultado: una fila de repetición para al menos dos prompts. Control de calidad: si el veredicto se da la vuelta entre ejecuciones en un prompt que no cambió, marca ese prompt como inestable y exclúyelo del informe mes a mes hasta que se repita.
Paso 6: pon la verificación en un calendario
Una verificación de diez prompts cuesta unos 0,29 dólares con el modelo actual de ChatGPT, alrededor de 1,27 dólares al mes si la ejecutas semanalmente. A ese precio, el trabajo no es la llamada a la API, es el criterio de evaluación, así que entrega la tarea a un agente con reglas de recolección explícitas, no a una petición de resumen.
Pasa estas restricciones al agente:
- Captura el texto de la respuesta literalmente y la lista de fuentes literalmente. No resumas ninguna de las dos.
- Registra la bandera de fundamentación, la versión del modelo y la marca de tiempo en cada fila.
- Calcula los recuentos en código después de la recolección, nunca dentro del prompt.
- Escribe en un archivo con fecha, para que una repetición no sobrescriba la evidencia del mes pasado.
Si ya ejecutas un agente para informes de búsqueda, el patrón de recolección es el mismo que se usa en el monitoreo diario de SEO y GEO con Codex, y la versión de terminal del mismo bucle está en el monitoreo diario con Claude Code. El único requisito nuevo aquí es la bandera de fundamentación, porque una superficie de chat que no buscó no se puede leer como resultado de citación.
Resultado: un trabajo programado que escribe filas con fecha. Control de calidad: abre el archivo de la semana pasada y confirma que puedes reconstruir el veredicto solo con la evidencia guardada.
Verificación: así se ve una comprobación válida
- Cada fila tiene una bandera de fundamentación, una versión de modelo y una fecha.
- Todo veredicto de «invisible» pertenece a una respuesta fundamentada.
- Al menos dos prompts se ejecutaron dos veces y sus veredictos se compararon.
- El texto crudo de la respuesta y la lista cruda de fuentes están guardados junto a los recuentos.
- La lista de prompts está marcada por forma, y el informe agrupa resultados por forma, no por total.
Límites
- Una versión de modelo, un lugar, inglés, un día de ejecuciones. El comportamiento de ChatGPT difiere entre versiones.
- La búsqueda web se activó por API. La app de consumidor puede buscar con un conjunto distinto de prompts.
- El nombramiento de marca se midió por coincidencia de texto, así que un nombre de producto sin el nombre de la empresa puede pasarse por alto.
- Esta verificación mide respuestas, no tráfico. El comportamiento de referencia es una medición aparte.
Preguntas frecuentes
¿Por qué ChatGPT no dice nada sobre mi marca?
Comprueba primero si buscó. En nuestra ejecución respondió de memoria 12 de los 20 prompts, sin fuentes, y esas respuestas pueden nombrar a un proveedor de datos de entrenamiento antiguos o no nombrar a nadie. Una respuesta no fundamentada no es evidencia sobre tu visibilidad.
¿Cuántos prompts debería verificar en ChatGPT?
De ocho a doce por ciclo bastan para ver el patrón, siempre que cubran las formas de categoría, comparación, problema y prueba. Ejecutar cien prompts da una muestra mayor de las mismas cuatro formas, no información nueva.
¿Se puede verificar esto sin API?
Sí. Tanto la bandera de fundamentación como el nombramiento de marca son visibles en la interfaz, y la lista de fuentes bajo una respuesta cubre la mitad de la citación. La API solo importa cuando quieres filas con fecha y repeticiones sin copiar a mano.
¿Cómo sé si un cambio es real?
Repite el prompt antes de reportar un cambio. En nuestros cinco pares de repetición, la decisión de buscar nunca se dio la vuelta, mientras que los recuentos de fuentes se movieron en dos o tres. Un cambio de veredicto en un prompt fundamentado merece investigación. Un cambio de recuento, no.
Visión de Auspia: pasa la puerta de validez antes de leer cualquier número, y reporta el veredicto en lugar de un recuento. El error más común que encontramos no es una cita perdida, sino una respuesta en blanco de ChatGPT reportada como invisibilidad cuando el modelo no buscó nada. Arregla primero la bandera, y el resto del informe pasa a ser comparable mes a mes.
Autoría: Victor Lane