如果有人問過你的品牌在 ChatGPT 裡出不出現,誠實的第一個回答是:在確認一件事之前,空白結果和真正的零看起來一模一樣。這份指南寫給那些沒有監測平台、只能用聊天視窗、一張工作表和大約三十分鐘交出這個答案的人。
讀完之後,你會拿到每個提示詞的判定、一份能在會議上站得住的重現記錄,以及一個讓它保持最新的排程工作。完成條件很簡單:對每個提示詞,你都能說出這次回答是否已檢索、是否點了品牌名、是否連結到網站。
完成之後你手上有什麼
產出 | 存放位置 |
|---|---|
從真實對話寫出的 8 到 12 個問題的提示詞清單 | 工作表的第一個分頁 |
每個提示詞一列,含四個欄位和模型版本 | 同一個分頁 |
每個提示詞四種判定之一,並附上對應動作 | 判定欄 |
至少兩個提示詞的重跑 | 同一張工作表的第 2 列和第 3 列 |
帶固定評分標準的定期檢查 | 代理的專案資料夾 |
前提條件:能使用帶網頁搜尋的 ChatGPT、一張工作表,以及在自動化時願意為一次十個提示詞的批次花大約 0.29 美元。
第 1 步:提示詞要從對話裡寫,不要從關鍵字裡寫
把業務團隊最近回答過的二十個問題翻出來,然後歸類。在我們的二十個提示詞研究裡,最寬的來源清單來自一個關於怎樣才能被引用的提問,最窄的清單來自工具之間的一對一比較,所以提問的形態決定了你能拿回多少資料。
跨四種形態寫出 8 到 12 個提示詞:品類(「適合 Y 的最佳 X」)、比較(「A 與 B」)、問題(「我怎麼知道 AI 是否知道我們公司」)、佐證(「2026 年誰在推薦 X」)。再加上兩個直接點名你品牌的提示詞,因為它們的行為和品類型不一樣。如果你想為同一份清單拿到跨平台的證據,AI 可見性檢查器分析展示了同一個提示詞送到三個平台時會發生什麼變化。
產出:一份最終的 8 到 12 個提示詞清單,每個都標上形態。品質檢查:每個提示詞都必須是客戶真會敲進去的那種。如果某個提示詞存在的唯一理由就是裡面有個關鍵字,刪掉它。
第 2 步:在讀取任何其他東西之前先過有效性閘門
這是大多數檢查都會跳過的一步,也正是空白被當成零上報的原因。在我們的批次裡,ChatGPT 在 20 個提示詞中的 8 個上發出了搜尋查詢,另外 12 個憑記憶作答。
我們觀察到的情況 | 已檢索的回答(8 個提示詞) | 未檢索的回答(12 個提示詞) |
|---|---|---|
發出的搜尋查詢 | 每個提示詞 4 到 8 條 | 0 |
傳回的來源標註 | 6 到 18 條,中位數 12 | 0 |
引用的不同網域 | 4 到 10 個,中位數 7 | 0 |
正文中仍然點名的品牌 | 有 | 有,全部 20 個提示詞中 13 個 |
在你記錄任何關於品牌的東西之前,先跑一遍每個提示詞,回答一個問題:模型到底查過東西嗎?在 ChatGPT 介面裡,線索就是回答下方那份來源清單。如果沒有來源清單,這次回答是憑記憶生成的,它對你品牌的沉默目前毫無意義。
產出:已檢索欄裡每個提示詞的是或否。品質檢查:沒有來源清單的回答絕不作為可見性訊號記錄,只作為記憶訊號記錄。我們那些未檢索的回答也並不更短,輸出 token 中位數是 1,730,而已檢索的是 1,645,所以長度不是一個可用的線索。
第 3 步:記四個欄位,不是一個
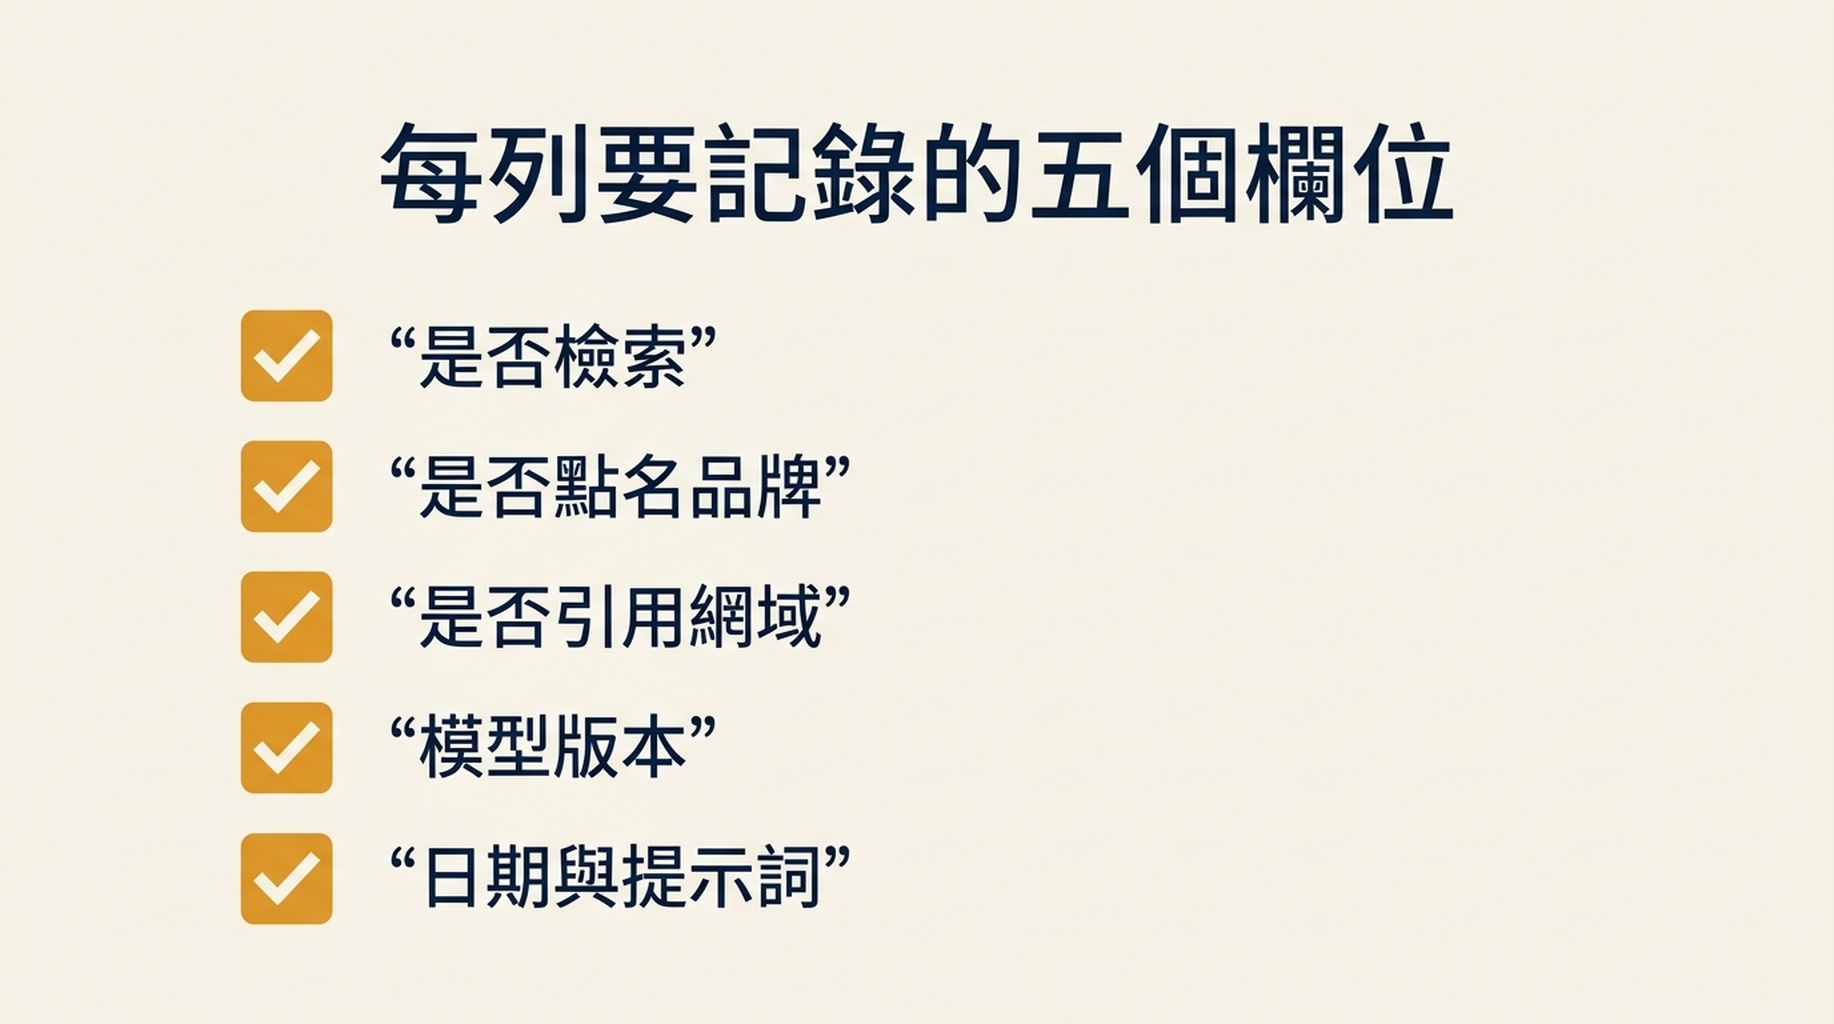
每個提示詞只留一個數字,正是報告彼此打架的原因。把這四個留住。
欄位 | 取值 | 為什麼重要 |
|---|---|---|
已檢索 | 是或否 | 決定這個提示詞究竟能不能產生連結 |
品牌被點名 | 是或否 | 在未檢索的回答裡依然存活的訊號 |
網域被連結 | 是或否 | 大多數工具單獨報告的那個訊號 |
模型版本 | 例如 gpt-5-2025-08-07 | 在我們的批次中,行為在不同版本之間發生了變化 |
最後一個欄位不是雜務。同樣這 20 個提示詞,在同一個端點上換用舊模型,只有 2 個提示詞傳回了來源,而當前模型是 8 個。沒有模型版本的報告沒辦法跟下個月的對比。
產出:每個提示詞四個填滿的欄位。品質檢查:任何一個格子是空的,這一列就不能上報。把原始回答文字和原始來源清單跟欄位存在一起,好讓複核的人不必重跑提示詞就能複查判定。
第 4 步:把每個回答歸入四種判定之一
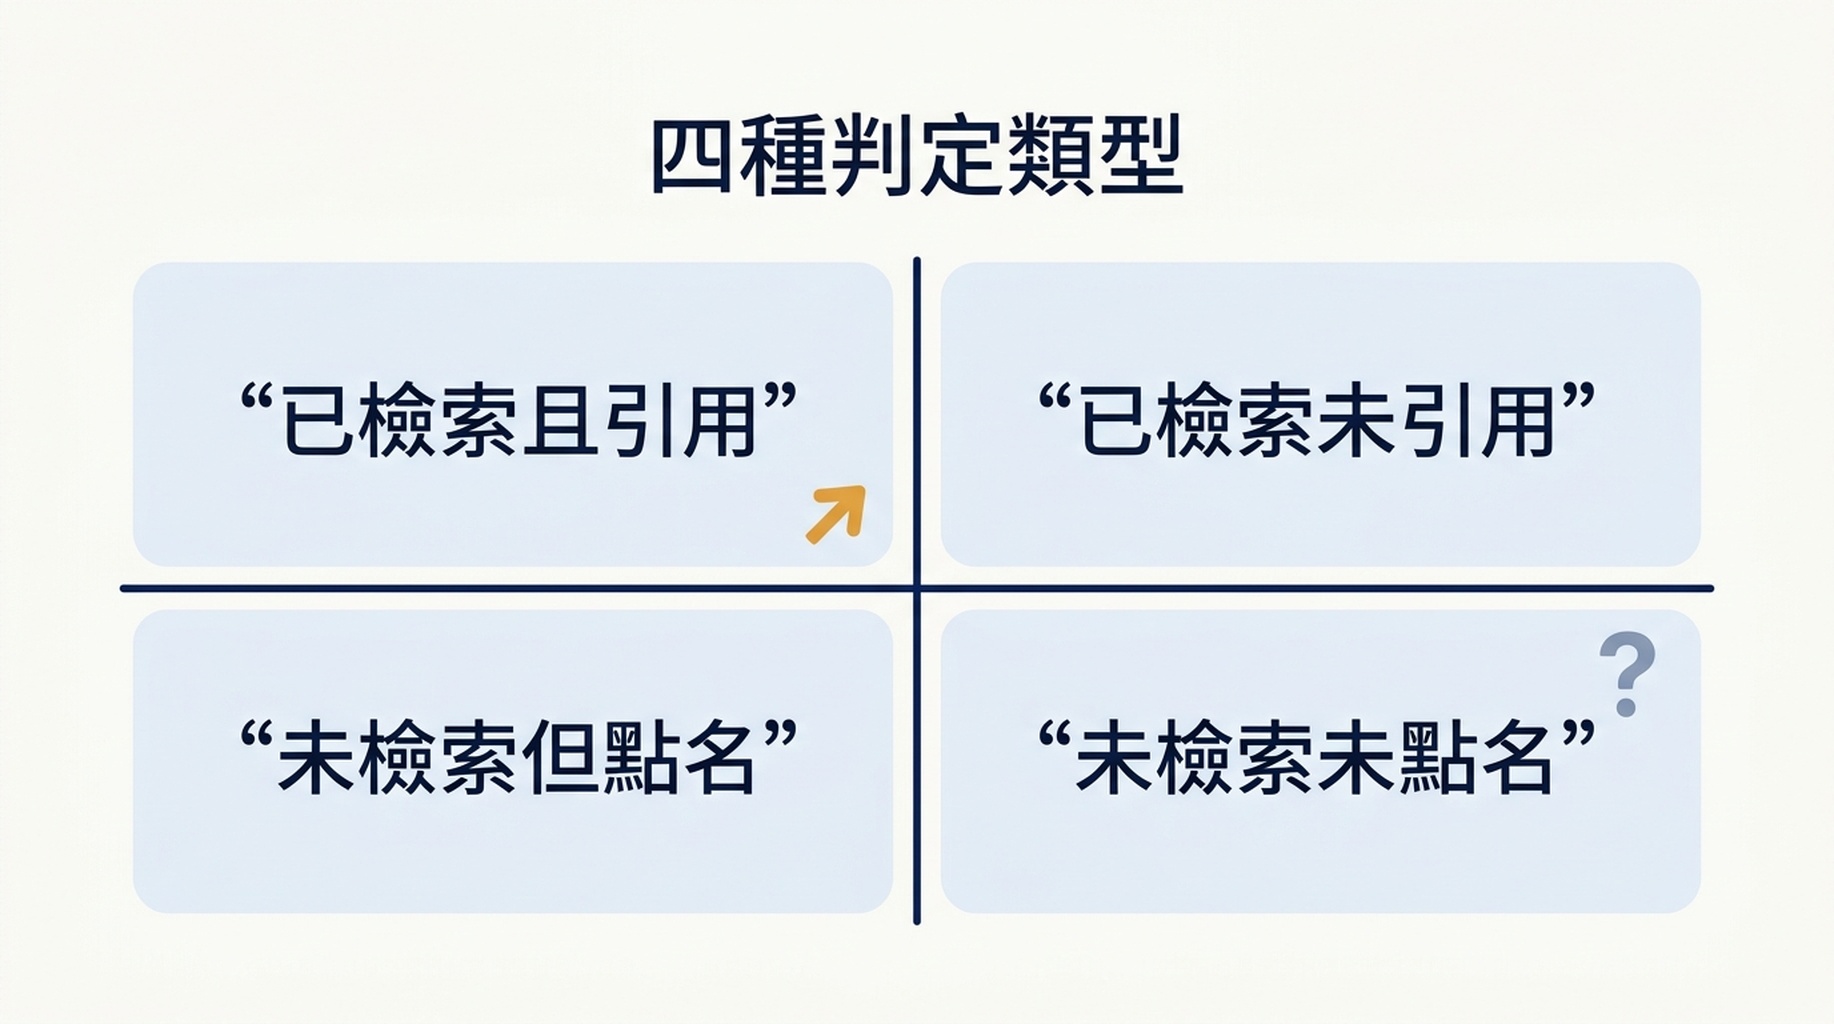
判定 | 含義 | 下一步做什麼 |
|---|---|---|
已檢索且已連結 | ChatGPT 查了資料,並引用了你的網域 | 保護被引用的頁面,並確認是哪種提問形態帶來了它 |
已檢索但未連結 | 它搜尋了、讀了網頁,卻推薦了別人 | 差距在內容與來源覆蓋,不在模型知識 |
未檢索但被點名 | 它憑記憶作答,仍然點了你的名 | 無需修復。之後用同一個提示詞重跑,看它是否開始搜尋 |
未檢索且未被點名 | 它憑記憶作答,沒有點你的名 | 還不是訊號。修正提示詞,或等一次已檢索的批次 |
第四列正是大多數誤報的來源。在我們的資料裡,20 條 ChatGPT 回答中有 13 條至少點名了一個廠商,而只有 8 條引用了任何東西,這意味著只看連結的檢查會把相當一部分回答看成空的,而同一段文字其實正在點名品牌。
產出:每個提示詞一個判定,外加對應動作。品質檢查:任何「看不見」的判定都必須綁定在已檢索的回答上。如果某個判定背後的理由經不起寫成一句話,就重跑這個提示詞。
第 5 步:在相信一次變化之前,先把兩個提示詞重跑一遍
至少用兩個提示詞在新對話裡跑第二遍,然後比較判定,而不是比較計數。
提示詞 | 第一次跑 | 第二次跑 | 是否穩定 |
|---|---|---|---|
最好的 AI 可見性工具 | 已檢索,13 條來源,6 個網域 | 已檢索,14 條來源,4 個網域 | 判定穩定,計數不穩定 |
追蹤品牌提及的最好工具 | 已檢索,8 條來源,8 個網域 | 已檢索,9 條來源,5 個網域 | 判定穩定,計數不穩定 |
審計我的品牌在 AI 回答中的表現 | 未檢索,0 條來源 | 未檢索,0 條來源 | 穩定 |
AI 回答多久變一次 | 未檢索,0 條來源 | 未檢索,0 條來源 | 穩定 |
在我們重跑過的五個提示詞裡,是否搜尋這個決定每次都自洽,而網域計數會浮動兩三個。這就是正確的校準方式:把判定當作訊號,把計數當作帶範圍的估計。
產出:至少兩個提示詞的重跑列。品質檢查:如果提示詞沒變、判定卻在兩次批次之間翻轉,把這個提示詞標為不穩定,並從環比報告裡排除,直到它重新重現。
第 6 步:把檢查放進排程
一次十個提示詞的檢查,在當前的 ChatGPT 模型上大約花 0.29 美元,每週跑一次大約每月 1.27 美元。在這個價位上,活兒不是 API 呼叫,而是評分標準,所以這項工作應該交給一個帶明確採集規則的代理,而不是交給一個「幫我摘要一下」的請求。
把這些限制交給代理:
- 逐字抓取回答文字,逐字抓取來源清單。兩者都不做摘要。
- 每一列都記錄已檢索標記、模型版本和時間戳。
- 計數在採集之後用程式碼算,絕不在提示詞裡面算。
- 寫入帶日期的檔案,讓重跑無法覆蓋上個月的證據。
如果你已經在跑一個做搜尋報告的代理,採集模式跟用 Codex 做每日 SEO 與 GEO 監測裡用的是同一套,同一個迴圈的終端版本在 Claude Code 每日監測裡。這裡唯一新增的要求就是已檢索標記,因為一個沒有搜尋過的聊天平台絕不能被讀成引用結果。
產出:一個寫出帶日期列的排程工作。品質檢查:打開上週的檔案,確認僅憑存下來的證據就能把判定重建出來。
驗證:一次合格的檢查長這樣
- 每一列都有已檢索標記、模型版本和日期。
- 每一個「看不見」的判定都屬於已檢索的回答。
- 至少有兩個提示詞跑了兩遍,並且比較了它們的判定。
- 原始回答文字和原始來源清單就存在計數旁邊。
- 提示詞清單按形態打了標籤,報告按形態而不是按總數來分組結果。
局限
- 一個模型版本、一個地區、英文、一天的批次。ChatGPT 的行為在不同版本之間有差異。
- 網頁搜尋是透過 API 開啟的。消費端應用程式可能會在另一組提示詞上搜尋。
- 品牌點名是用字串比對測的,所以沒有公司名的產品名可能被漏掉。
- 這項檢查測的是回答,不是流量。導流行為是另一項量測。
常見問題
為什麼 ChatGPT 對我的品牌隻字不提?
先確認它有沒有搜尋過。在我們的批次裡,20 個提示詞中有 12 個是憑記憶、沒有任何來源作答的,而那些回答可能從過時的訓練資料裡點出一個廠商,也可能誰都不點。一個未檢索的回答不是你可見性的證據。
我應該在 ChatGPT 裡檢查多少個提示詞?
每個週期 8 到 12 個就夠看出規律,前提是它們覆蓋品類、比較、問題和佐證四種形態。跑一百個提示詞,得到的只是同樣四種形態的更大樣本,而不是新資訊。
我不用 API 能檢查這件事嗎?
可以。已檢索標記和品牌點名在介面上都看得見,回答下方那份來源清單補上引用那一半。只有當你想在不手動複製的情況下拿到帶日期的列和重跑時,API 才重要。
我怎麼知道一次變化是真的?
在報告變化之前先把提示詞重跑一遍。在我們的五組重跑裡,是否搜尋的決定從未翻轉,而來源計數浮動了兩三個。已檢索的提示詞上判定變了,值得查。計數變了,不值得。
Auspia 觀點:在讀任何數字之前先跑有效性閘門,並且報告判定而不是計數。我們發現的最常見錯誤不是漏掉一次引用,而是模型根本沒查過任何東西,ChatGPT 的空白回答卻被上報成「看不見」。先把標記修好,報告剩下的部分才能在月度之間可比。
作者:維克多·萊恩