Se qualcuno ti ha chiesto se il tuo marchio compare in ChatGPT, la prima risposta onesta è che un risultato vuoto e uno zero reale sono identici finché non verifichi una cosa. Questa guida è per chi deve dare quella risposta senza piattaforma di monitoraggio, con nient'altro che una finestra di chat, un foglio di calcolo e una trentina di minuti.
Alla fine avrai un verdetto per prompt, un registro ripetibile che puoi difendere in riunione e un job pianificato che lo tiene aggiornato. La condizione di chiusura è semplice: per ogni prompt sai dire se la risposta è stata supportata, se ha nominato il marchio e se ha collegato il sito.
Cosa avrai alla fine
Risultato | Dove si trova |
|---|---|
Un elenco di 8-12 prompt, scritto da conversazioni reali | La prima scheda del foglio |
Una riga per prompt con quattro campi e la versione del modello | La stessa scheda |
Uno di quattro verdetti per prompt, con l'azione collegata | La colonna del verdetto |
Una ripetizione di almeno due prompt | Le righe 2 e 3 dello stesso foglio |
Un controllo pianificato con criterio di valutazione fisso | La cartella di progetto del tuo agente |
Prerequisiti: accesso a ChatGPT con ricerca web, un foglio di calcolo e la possibilità di spendere circa 0,29 dollari su un'esecuzione di dieci prompt, se la automatizzi.
Passo 1: scrivi i prompt dalle conversazioni, non dalle parole chiave
Recupera le ultime venti domande a cui ha risposto il team commerciale e raggruppale. Nel nostro studio su venti prompt, l'elenco di fonti più ampio è venuto da una domanda su come farsi citare, e il più stretto da un confronto diretto tra strumenti: la forma della domanda decide quanti dati ti tornano indietro.
Scrivi 8-12 prompt su quattro forme: categoria ("il miglior X per Y"), confronto ("A contro B"), problema ("come faccio a sapere se l'IA conosce la mia azienda") e prova ("chi consiglia X nel 2026"). Aggiungi due prompt che nominano direttamente il tuo marchio, perché si comportano diversamente da quelli di categoria. Se vuoi prove su più superfici per lo stesso elenco, l'analisi del verificatore di visibilità in IA mostra cosa cambia quando lo stesso prompt va su tre superfici.
Risultato: un elenco finale di 8-12 prompt, ciascuno etichettato con la sua forma. Controllo di qualità: ogni prompt deve essere qualcosa che un cliente digiterebbe davvero. Se un prompt esiste solo perché contiene una parola chiave, taglialo.
Passo 2: passa il cancello di validità prima di leggere qualunque altra cosa
È il passo che quasi tutti i controlli saltano, ed è il motivo per cui i vuoti vengono riportati come zeri. Nella nostra esecuzione, ChatGPT ha emesso query di ricerca su 8 dei 20 prompt e ha risposto agli altri 12 a memoria.
Cosa abbiamo osservato | Risposte supportate (8 prompt) | Risposte non supportate (12 prompt) |
|---|---|---|
Query di ricerca emesse | 4-8 per prompt | 0 |
Annotazioni di fonte restituite | 6-18, mediana 12 | 0 |
Domini distinti citati | 4-10, mediana 7 | 0 |
Marchi ancora nominati nel testo | sì | sì, su 13 dei 20 prompt in totale |
Prima di registrare qualcosa sul tuo marchio, esegui ogni prompt e rispondi a una domanda: il modello ha cercato qualcosa? Nell'interfaccia di ChatGPT l'indizio è l'elenco delle fonti sotto la risposta. Se non c'è un elenco di fonti, la risposta viene dalla memoria, e il suo silenzio sul tuo marchio non significa ancora nulla.
Risultato: sì o no per prompt nella colonna del supporto. Controllo di qualità: una risposta senza elenco di fonti non viene mai registrata come segnale di visibilità, solo come segnale di memoria. Le nostre risposte non supportate non erano nemmeno più brevi: mediana di 1.730 token di output contro 1.645 delle supportate, quindi la lunghezza non è un indizio utilizzabile.
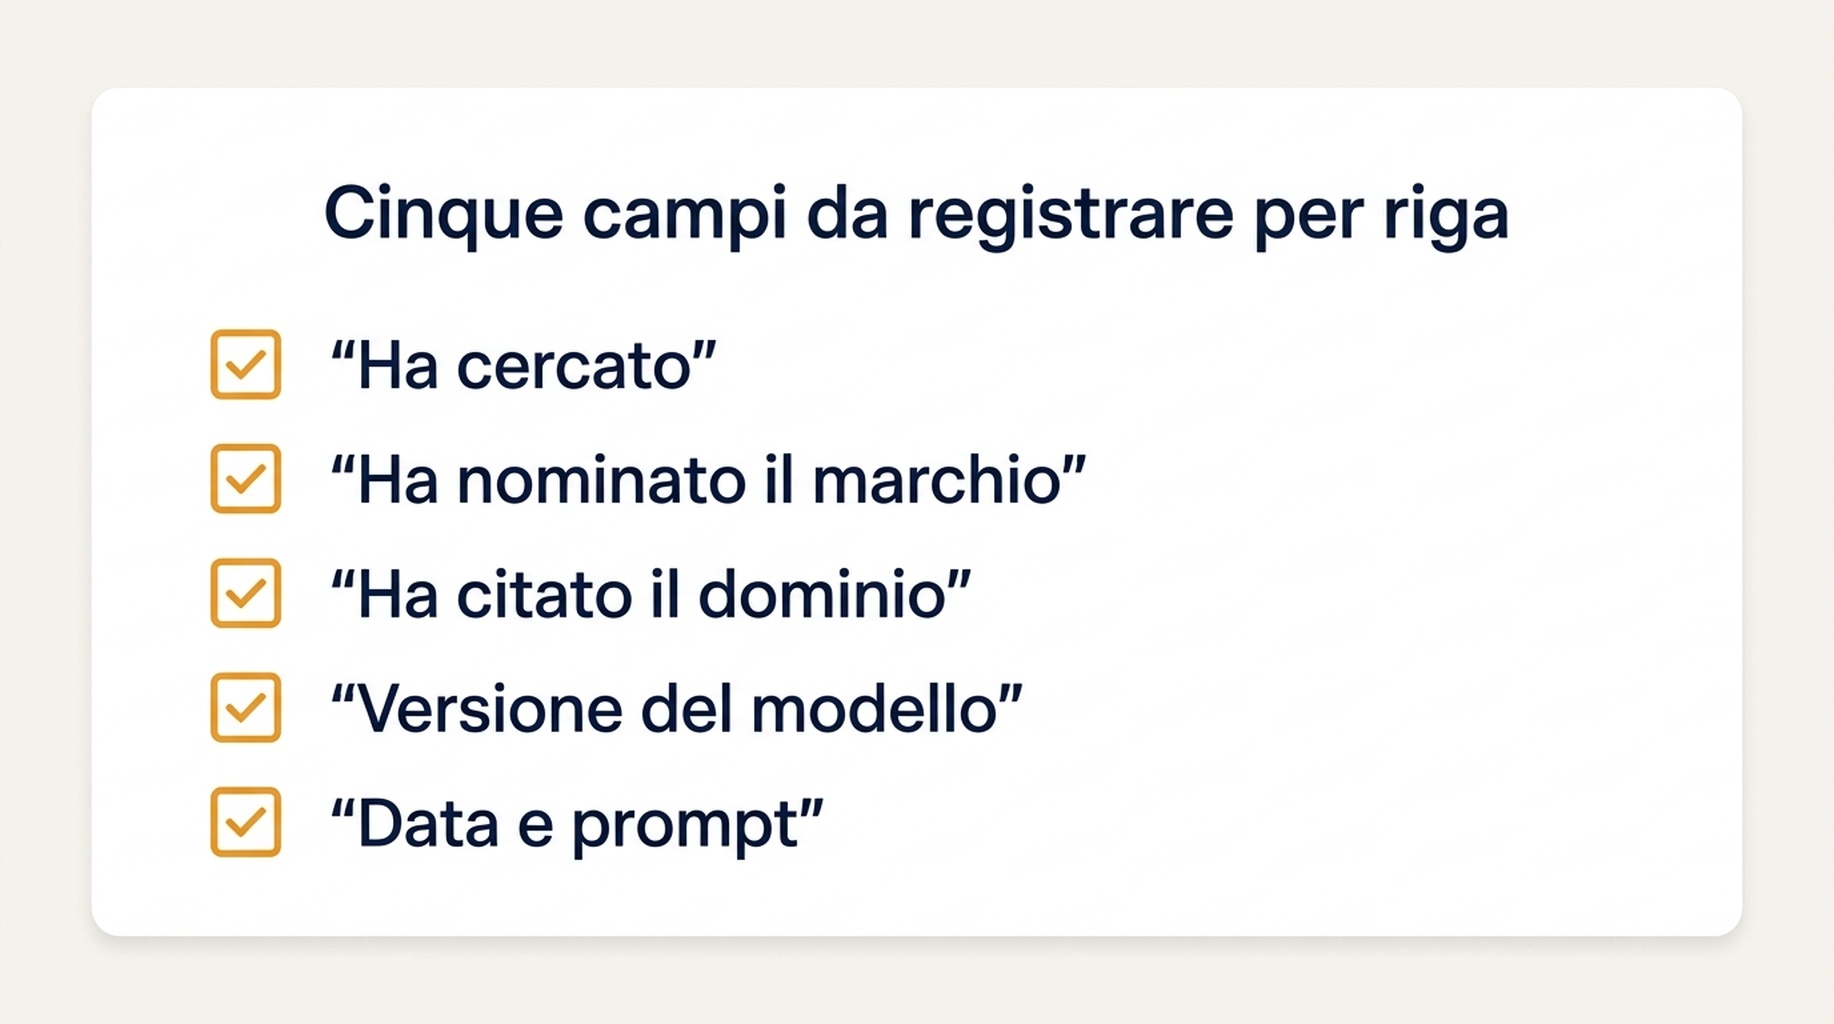
Passo 3: registra quattro campi, non uno
Un numero per prompt è il motivo per cui i report si contraddicono tra loro. Tieni questi quattro.
Campo | Valore | Perché conta |
|---|---|---|
Supportata | sì o no | Decide se il prompt può produrre un link |
Marchio nominato | sì o no | Il segnale che sopravvive in una risposta non supportata |
Dominio collegato | sì o no | Il segnale che la maggior parte degli strumenti riporta da sola |
Versione del modello | per esempio gpt-5-2025-08-07 | Nelle nostre esecuzioni il comportamento si è mosso tra versioni |
L'ultimo campo non è burocrazia. Gli stessi 20 prompt, sullo stesso endpoint, hanno restituito fonti su 2 prompt con un modello vecchio, contro 8 con quello attuale. Un report senza versione del modello non è confrontabile con quello del mese prossimo.
Risultato: quattro campi compilati per prompt. Controllo di qualità: se una cella è vuota, la riga non può essere riportata. Conserva il testo grezzo della risposta e l'elenco grezzo delle fonti accanto ai campi, così un revisore può ricontrollare un verdetto senza rieseguire il prompt.
Passo 4: classifica ogni risposta in uno dei quattro verdetti
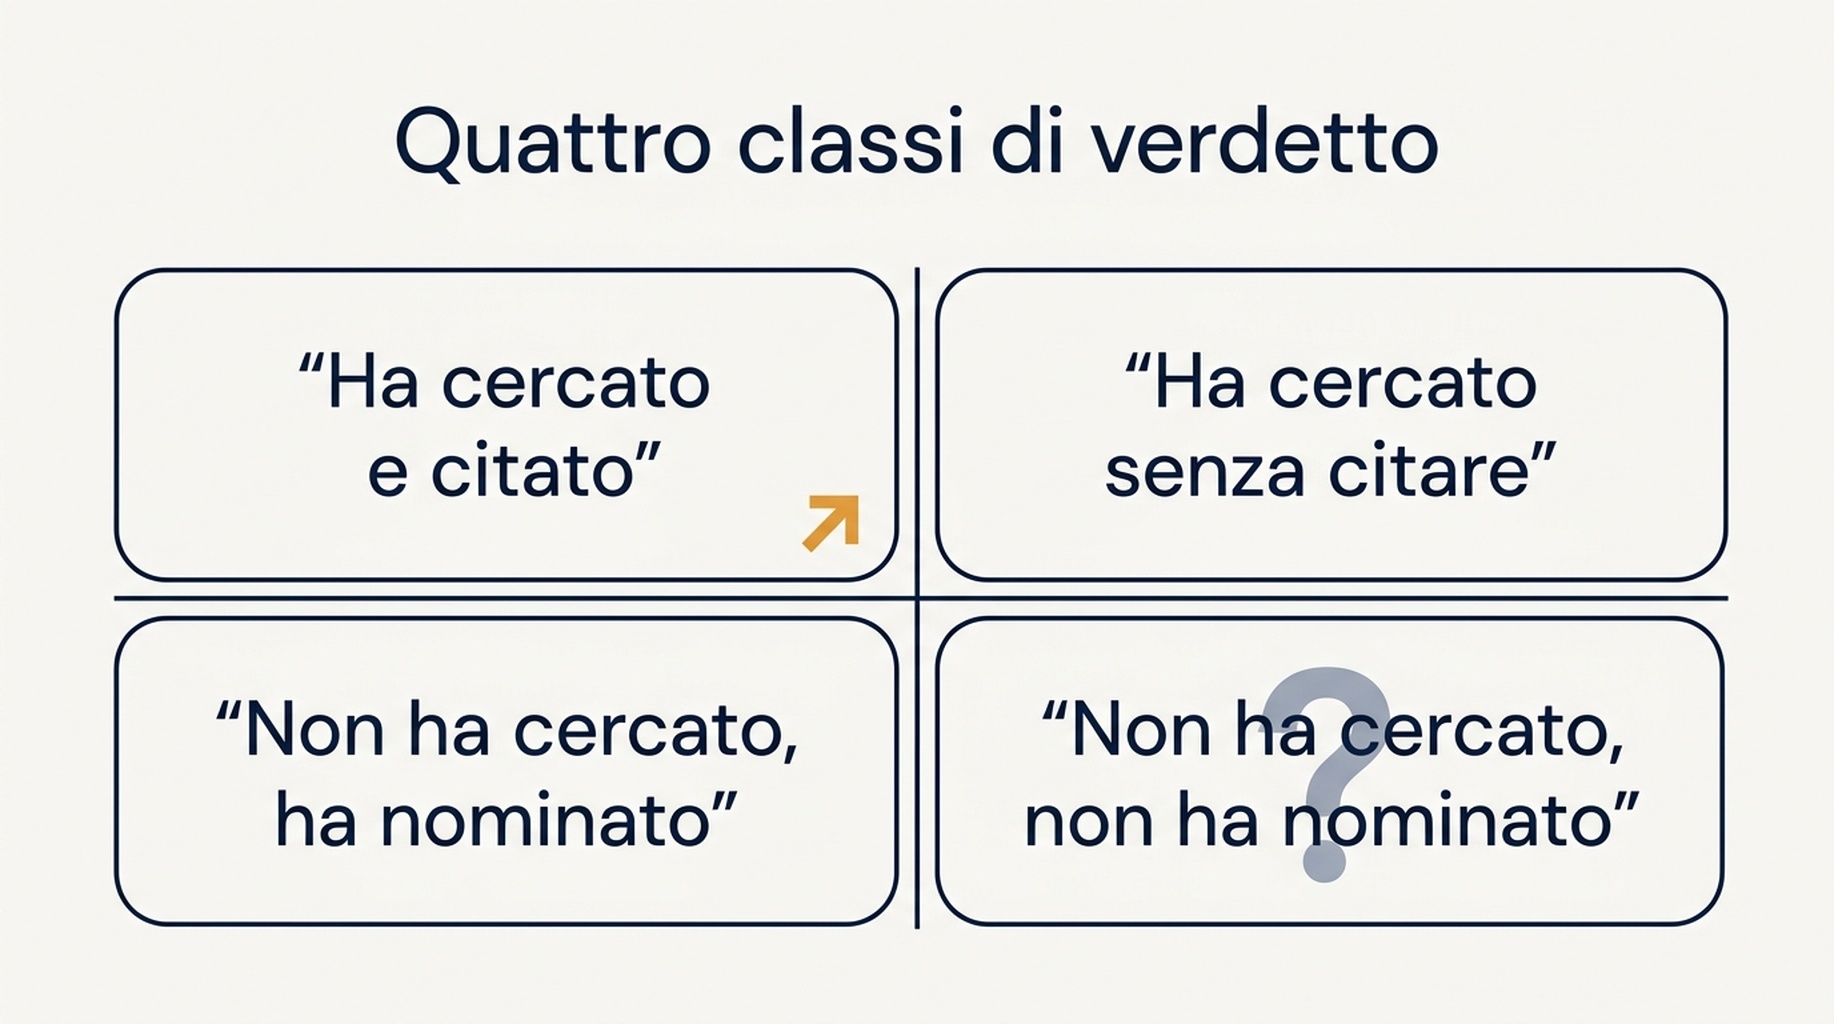
Verdetto | Cosa significa | Cosa fare dopo |
|---|---|---|
Supportata e collegata | ChatGPT ha cercato qualcosa e ha citato il tuo dominio | Proteggi la pagina citata e verifica quale forma di domanda l'ha prodotta |
Supportata, non collegata | Ha cercato, letto il web e consigliato qualcun altro | Il divario è nei contenuti e nella copertura delle fonti, non nella conoscenza del modello |
Non supportata ma nominata | Ha risposto a memoria e ti ha comunque nominato | Niente da correggere. Ripeti più avanti lo stesso prompt per vedere se inizia a cercare |
Non supportata e non nominata | Ha risposto a memoria e non ti ha nominato | Non è ancora un segnale. Correggi il prompt o attendi un'esecuzione supportata |
La quarta riga è l'origine della maggior parte dei falsi allarmi. Nei nostri dati, 13 delle 20 risposte di ChatGPT hanno nominato almeno un fornitore, mentre solo 8 su 20 hanno citato qualcosa: parte delle risposte sembrerà vuota a un controllo che legge solo i link, mentre lo stesso testo sta nominando marchi.
Risultato: un verdetto per prompt, più l'azione. Controllo di qualità: ogni verdetto "invisibile" deve essere legato a una risposta supportata. Se il ragionamento dietro un verdetto non regge in una frase, riesegui il prompt.
Passo 5: ripeti due prompt prima di fidarti di un cambiamento
Esegui almeno due prompt una seconda volta, in una conversazione nuova, e confronta il verdetto, non il conteggio.
Prompt | Prima esecuzione | Seconda esecuzione | Stabile |
|---|---|---|---|
Migliori strumenti di visibilità in IA | supportata, 13 fonti, 6 domini | supportata, 14 fonti, 4 domini | verdetto sì, conteggio no |
Miglior strumento per monitorare le menzioni del marchio | supportata, 8 fonti, 8 domini | supportata, 9 fonti, 5 domini | verdetto sì, conteggio no |
Verifica il mio marchio nelle risposte IA | non supportata, 0 fonti | non supportata, 0 fonti | sì |
Con che frequenza cambiano le risposte IA | non supportata, 0 fonti | non supportata, 0 fonti | sì |
Sui cinque prompt che abbiamo ripetuto, la decisione di cercare ha coinciso con se stessa ogni volta, mentre il numero di domini si è mosso di due o tre. È la calibrazione giusta: tratta il verdetto come segnale e il conteggio come stima con un intervallo.
Risultato: una riga di ripetizione per almeno due prompt. Controllo di qualità: se il verdetto si ribalta tra esecuzioni su un prompt che non è cambiato, segna quel prompt come instabile ed escludilo dal report mese su mese finché non si ripete.
Passo 6: metti il controllo su un calendario
Un controllo di dieci prompt costa circa 0,29 dollari sul modello ChatGPT attuale, più o meno 1,27 dollari al mese con cadenza settimanale. A quel prezzo il lavoro non è la chiamata API, è il criterio di valutazione: affida quindi il job a un agente con regole di raccolta esplicite, non a una richiesta di riassunto.
Passa all'agente questi vincoli:
- Cattura il testo della risposta alla lettera e l'elenco delle fonti alla lettera. Non riassumere nessuno dei due.
- Registra il flag di supporto, la versione del modello e il timestamp su ogni riga.
- Calcola i conteggi nel codice dopo la raccolta, mai dentro il prompt.
- Scrivi in un file datato, così una ripetizione non sovrascrive le prove del mese scorso.
Se già gestisci un agente per i report di ricerca, lo schema di raccolta è lo stesso usato nel monitoraggio SEO e GEO quotidiano con Codex, e la versione da terminale dello stesso ciclo è nel monitoraggio quotidiano con Claude Code. L'unico requisito nuovo qui è il flag di supporto, perché una superficie di chat che non ha cercato non può essere letta come risultato di citazione.
Risultato: un job pianificato che scrive righe datate. Controllo di qualità: apri il file della settimana scorsa e conferma di riuscire a ricostruire il verdetto solo dalle prove conservate.
Verifica: un controllo valido si presenta così
- Ogni riga ha un flag di supporto, una versione del modello e una data.
- Ogni verdetto "invisibile" appartiene a una risposta supportata.
- Almeno due prompt sono stati eseguiti due volte e i loro verdetti confrontati.
- Il testo grezzo della risposta e l'elenco grezzo delle fonti sono conservati accanto ai conteggi.
- L'elenco dei prompt è etichettato per forma, e il report raggruppa i risultati per forma, non per totale.
Limiti
- Una versione del modello, un luogo, l'inglese, un giorno di esecuzioni. Il comportamento di ChatGPT differisce tra versioni.
- La ricerca web è stata attivata via API. L'app consumer può cercare su un insieme di prompt diverso.
- La nomina del marchio è stata misurata con corrispondenza testuale, quindi un nome di prodotto senza il nome dell'azienda può sfuggire.
- Questo controllo misura risposte, non traffico. Il comportamento di referral è una misurazione separata.
Domande frequenti
Perché ChatGPT non dice nulla sul mio marchio?
Verifica prima se ha cercato. Nella nostra esecuzione ha risposto a memoria su 12 dei 20 prompt, senza fonti, e quelle risposte possono nominare un fornitore da dati di addestramento vecchi o non nominare nessuno. Una risposta non supportata non è una prova sulla tua visibilità.
Quanti prompt dovrei controllare in ChatGPT?
Otto-dodici per ciclo bastano per vedere lo schema, purché coprano le forme categoria, confronto, problema e prova. Eseguire cento prompt dà un campione più grande delle stesse quattro forme, non informazione nuova.
Si può controllare senza API?
Sì. Sia il flag di supporto sia la nomina del marchio sono visibili nell'interfaccia, e l'elenco delle fonti sotto una risposta copre la metà della citazione. L'API conta solo quando vuoi righe datate e ripetizioni senza copiare a mano.
Come capisco se un cambiamento è reale?
Ripeti il prompt prima di segnalare un cambiamento. Nelle nostre cinque coppie di ripetizione, la decisione di cercare non si è mai ribaltata, mentre i conteggi delle fonti si sono mossi di due o tre. Un cambio di verdetto su un prompt supportato merita un'indagine. Un cambio di conteggio no.
Vista Auspia: passa il cancello di validità prima di leggere qualunque numero, e riporta il verdetto invece di un conteggio. L'errore più comune che abbiamo trovato non è una citazione mancata, ma una risposta vuota di ChatGPT riportata come invisibilità quando il modello non ha cercato nulla. Sistema prima il flag, e il resto del report diventa confrontabile mese su mese.
Scritto da: Victor Lane