Die Regel, die Google gerade aufgeschrieben hat
Am 26. Oktober 2026 hat Google seinem Leitfaden zur Vermeidung von nutzergeneriertem Spam einen Abschnitt mit zwei Absätzen hinzugefügt. Es ist der kürzeste Teil der Seite und wahrscheinlich der, der die meisten Produkt-Roadmaps verändern wird, weil er eine Frage stellt, die die meisten Teams nie auf eine Folie geschrieben haben: Gehört diese URL in den Google-Index?
Der Abschnitt heißt "Only index content meant for Search" – indexiere nur Inhalte, die für die Suche gedacht sind. Übersetzt steht dort:
Wenn Ihr Dienst Nutzern erlaubt, teilbare Seiten, generierte Ergebnisse oder interaktive Tools zu erstellen, überlegen Sie, ob diese Inhalte dafür gedacht sind, von Suchmaschinen gefunden zu werden, oder nur dafür, von der Person mit dem Link direkt geöffnet zu werden.
Wenn Seiten zum direkten Teilen, zur Zusammenarbeit oder zum praktischen Nutzen erstellt werden und nicht zur Auffindbarkeit in einer öffentlichen Suche, setzen Sie standardmäßig die noindex-Regel durch (mit einem robots-Meta-Tag oder dem HTTP-Header X-Robots-Tag) oder blockieren Sie das Crawling standardmäßig in der robots.txt.
Der Google-Changelog vom selben Tag ist deutlicher, was die Absicht angeht: Der Leitfaden wurde um "Hinweise dazu, wie sich die Indexierung von per Link geteilten Inhalten blockieren und wie sich Missbrauch in der Search Console überwachen lässt" erweitert, damit Plattformen "nutzergenerierte Seiten, die nicht für die Suche gedacht sind, aus dem Index heraushalten und Spam früher erkennen" können.
Das war es. Keine neue manuelle Maßnahme, keine Ankündigung eines Ranking-Systems, keine Liste von Strafen. Was es gibt, ist eine Empfehlung für einen Standardwert – und aus Standardwerten entstehen fast alle Indexierungsunfälle.
Für wen das gedacht ist. Teams, die irgendeine URL ausliefern, die ein Nutzer erzeugen kann: Freigabelinks, gespeicherte Chats, öffentliche Dashboards, Modell-Previews, App-Builds, generierte Berichte, Forum-Threads, Profilseiten, Bewertungsseiten, Anzeigenseiten.
Was am Ende dabei herauskommt. Ein Urteil pro Route für jeden Typ generierter URL, die Steuerung, die die Seite tatsächlich aus dem Index entfernt, und eine Überwachungsregel, die das von Google beschriebene Missbrauchsmuster erkennt.
Zeitaufwand. 45 bis 90 Minuten für einen ersten Durchlauf in einem Produkt. Ein Tag, wenn Sie mehrere URL-Generatoren und kein Routeninventar haben.
So sieht "fertig" aus. Jede generierte Route ist als index, noindex oder privat markiert. Die noindex-Routen liefern die Direktive vom Server, nicht erst nachdem JavaScript gelaufen ist. Die Search Console zeigt diese URLs als wegen noindex ausgeschlossen und nicht als "Indexiert, obwohl durch robots.txt blockiert".
Was sich geändert hat und was nur neu aussieht
Vier Änderungen zählen. Der Rest der Seite ist unverändert, auch die Hinweise vom Dezember 2025, die weiter gelten.
Was Google geändert hat | Der tatsächliche Text | Warum es Sie betrifft |
|---|---|---|
Geltungsbereich des Leitfadens | Er nennt jetzt Hosting-Plattformen "und Tools, die Nutzern erlauben, geteilte Seiten, generierte Inhalte oder Web-Apps zu veröffentlichen" | Wörtlich genommen deckt das KI-Chat-Exporte, Artifact-Seiten, App-Builder und No-Code-Tools ab, nicht nur Foren und Kommentare |
Einheit des Missbrauchs | Spammer können "eine große Anzahl von Seiten oder Websites" erstellen | Google spricht von Menge, nicht von Cleverness. Ein missbräuchliches Konto kann Tausende URLs prägen |
Neuer Abschnitt | "Only index content meant for Search" | Die bisher klarste Aussage, dass noindex ein sinnvoller Standard für nur per Link erreichbare Inhalte ist |
Überwachung | Website oder Subdomain in der Search Console verifizieren, Ausschläge bei der Seitenindexierung und in der Suchleistung beobachten, Alarm auslösen, wenn "wenige Nutzer" einen "großen Teil der indexierbaren URLs" erzeugen | Index-Aufblähung hat jetzt eine benannte Erkennungsmethode – und meist ist das der Vorläufer einer Prüfungsform |
Unverändert bleibt: noindex für Beiträge neuer Nutzer, bis sie Reputation aufgebaut haben, und nofollow oder ugc auf Links in unzuverlässigen Inhalten. Wer beides schon macht, ist dieser Aktualisierung voraus.
Man muss es deutlich sagen, weil die Reaktion auf X dem Dokument vorausgeeilt ist: Das sind Hinweise für Plattformen zum eigenen URL-Bestand. Sie schaffen keinen neuen Verstoß für eine gewöhnliche Marketing-Website und ändern das Ranking keiner Seite. Sie ändern, was im Index stehen sollte.
Ein weiteres Stück Kontext erklärt den Zeitpunkt. Ende Juli 2026 tauchten Freigabelinks und Artifact-Seiten von Claude im Google-Index auf, und Berichte beschrieben damals Krankengeschichten, API-Schlüssel und anderes privates Material, das offenlag, bevor Anthropic die Lücke innerhalb weniger Tage schloss. Dieselbe Berichterstattung nannte öffentliche App-URLs bei Buildern wie Replit und Lovable. Google schreibt selten einen neuen Abschnitt für eine Hypothese. Diese war bereits eingetreten.
Die Frage, die jede generierte URL entscheidet
Googles Test passt in einen Satz, und man kann ihn anwenden, ohne Absichten zu raten: Sind diese Inhalte dafür gedacht, von Suchmaschinen gefunden zu werden, oder nur dafür, von der Person mit dem Link geöffnet zu werden?
Praktisch beantworten vier Signale die Frage. Bewerten Sie die Route, nicht die einzelne Seite.
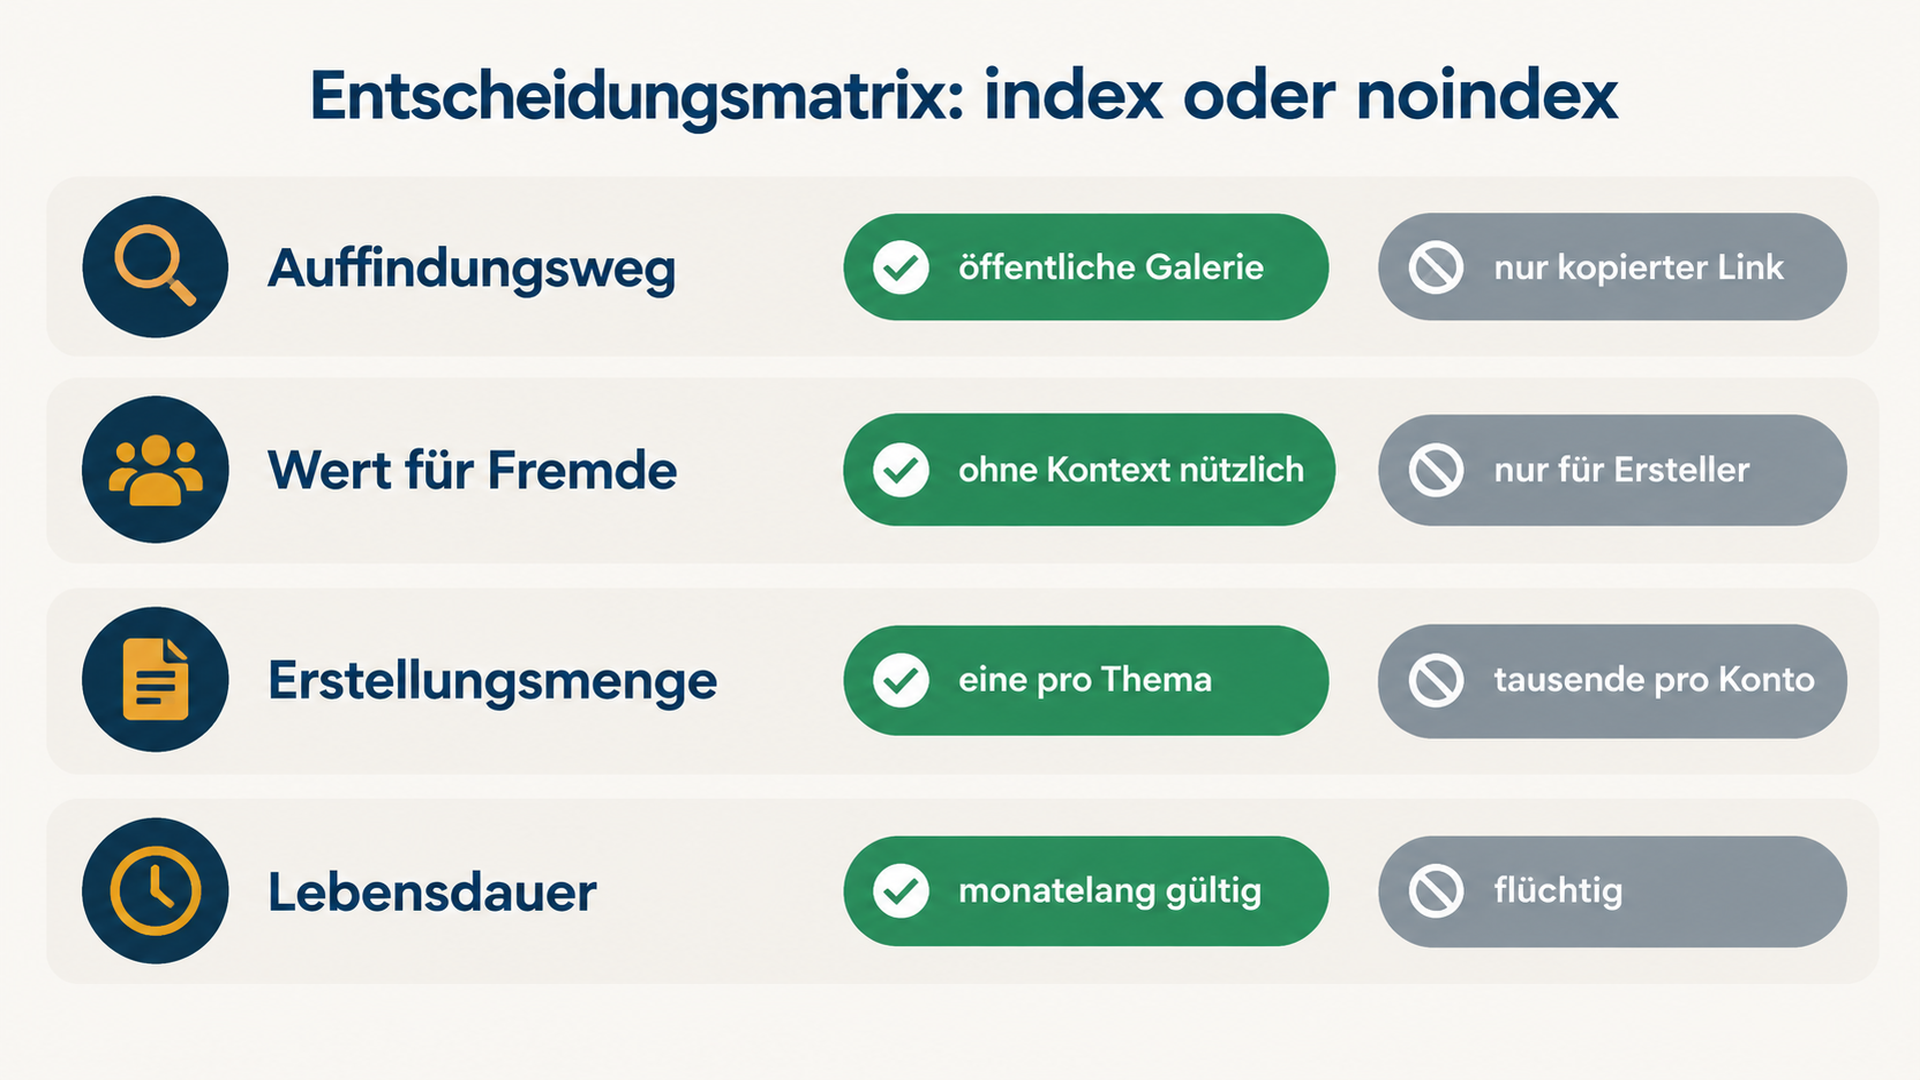
Signal | Spricht für index | Spricht für noindex |
|---|---|---|
Auffindungsweg | Verlinkt aus einer öffentlichen Galerie, Sitemap, Kategorieseite oder einem Profil | Nur über einen kopierten Link oder einen Teilen-Button erreichbar |
Wert für Fremde | Nützlich, ohne die erstellende Person zu kennen | Ergibt nur für Ersteller, Team oder Empfänger Sinn |
Erstellungsmenge | Eine Seite pro Thema oder ein kuratierter Satz | Tausende URLs aus einem Konto, überwiegend fast doppelt |
Lebensdauer | Bleibt monatelang korrekt | Flüchtig: ein Chat, ein Build, ein Entwurf, ein temporärer Export |
Drei von vier Richtung noindex ist ein klares Urteil. Ein gemischtes Ergebnis heißt meistens, dass die Route geteilt werden muss: eine indexierbare öffentliche Galerie und darunter die einzelnen Ergebnisse, die es nicht sind. Diese Teilung ist die häufigste richtige Antwort und die, die am häufigsten übersprungen wird, weil sie zwei Templates statt eines Schalters verlangt.
Ein nützlicher Ablehnungstest: Würde ein Fremder diese URL in einem Suchergebnis ohne Kontext sehen – ergäben Titel und Snippet Sinn? "Chat mit Sam, 24. Okt." ergibt keinen. "Rechnungsvorlage für freiberufliche Designer" schon. Die Ablehnung hat nichts mit Qualität zu tun. Sie hat damit zu tun, ob die Seite zum Gefundenwerden gebaut wurde oder zum Verschicken.
Wählen Sie eine Steuerung, die die URL wirklich entfernt
Hier kann man den neuen Hinweis wörtlich befolgen und trotzdem scheitern. Google bietet im selben Satz zwei Optionen an, und sie sind nicht gleichwertig.
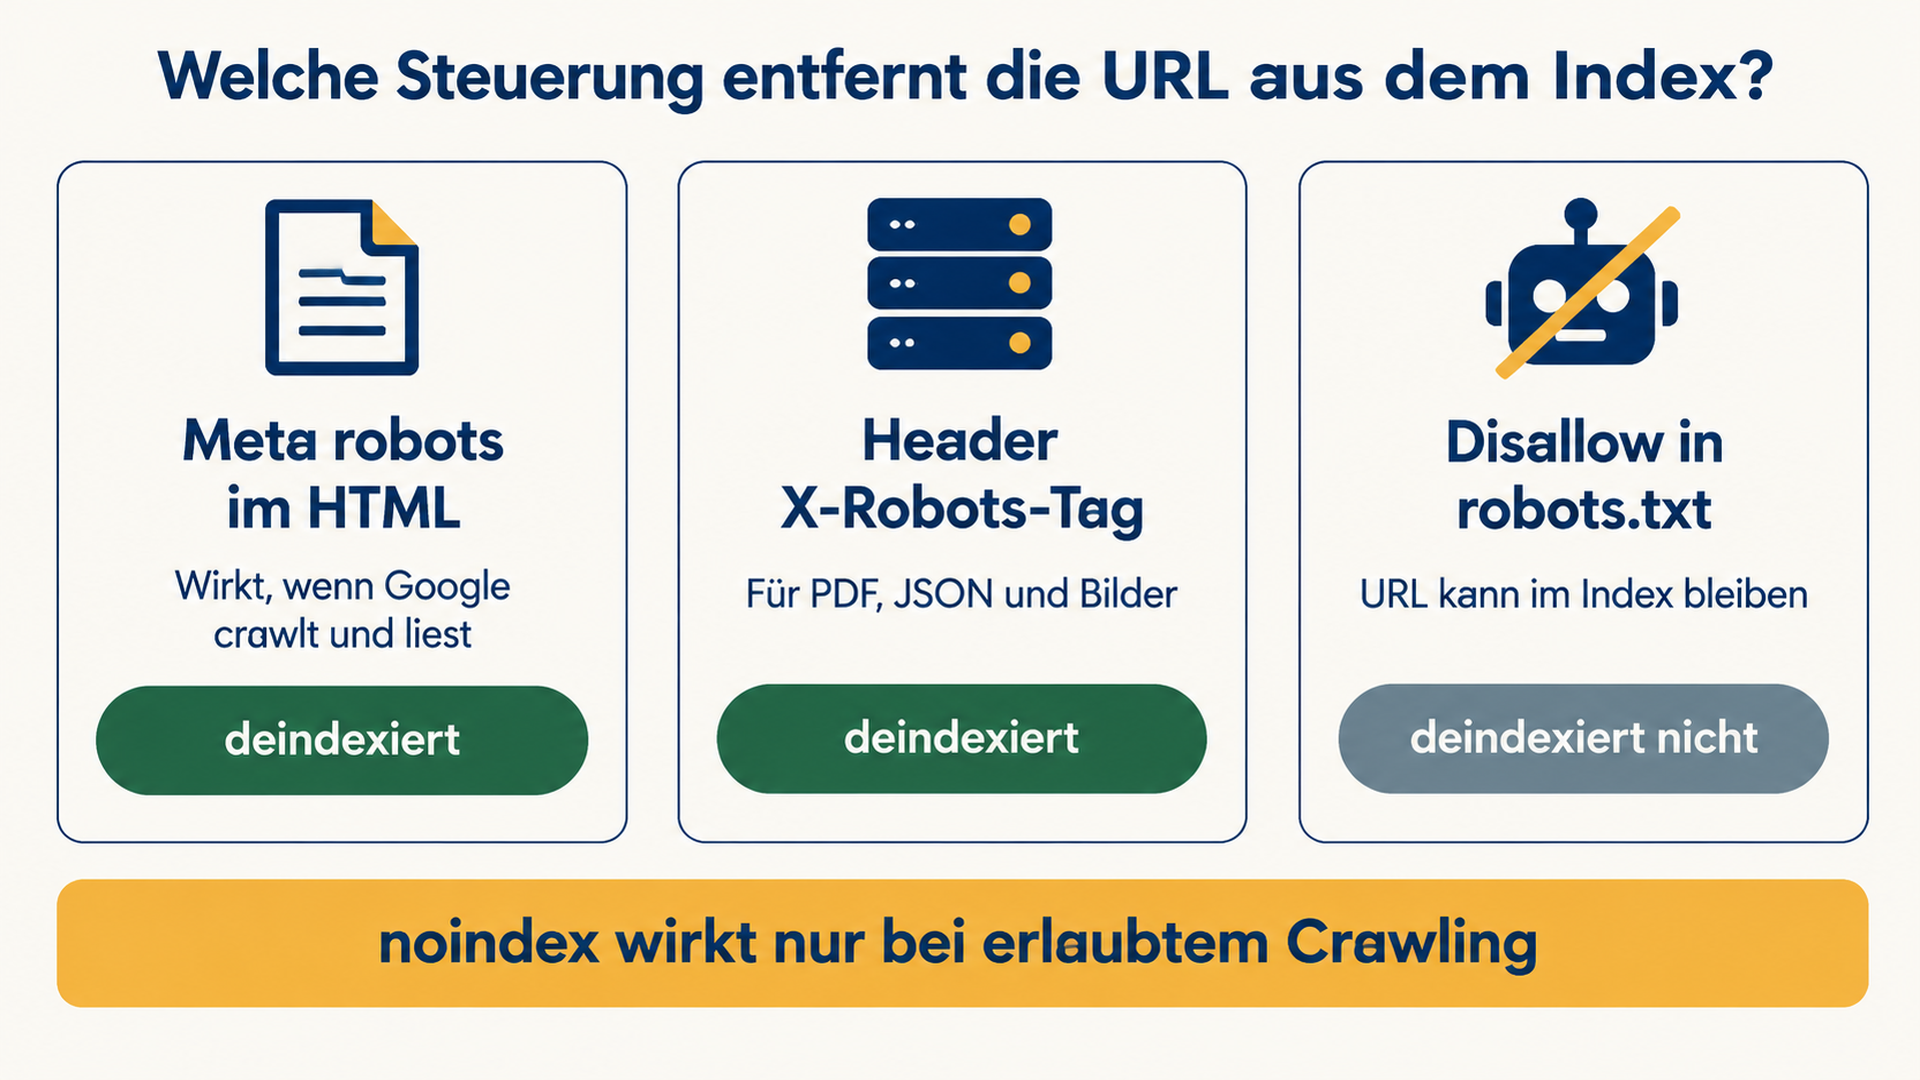
Die robots.txt steuert das Crawling. Sie entfernt keine URL aus dem Index, und Google sagt das selbst in der Einleitung zur robots.txt: Eine dort blockierte Seite "kann weiterhin indexiert bleiben, wenn Links von anderen Websites darauf verweisen" – und in diesem Fall können die URL und möglicherweise der Ankertext ohne Beschreibung in den Ergebnissen erscheinen.
noindex steuert die Indexierung, aber nur, wenn Google die Seite crawlen und die Direktive lesen kann. Die noindex-Dokumentation von Google ist eindeutig: Damit die Regel funktioniert, darf die Seite nicht durch robots.txt blockiert sein, denn sonst "sieht der Crawler die noindex-Regel nie".
Setzt man beide Fakten zusammen, wird die Reihenfolge wichtig.
Steuerung | Entfernt die URL aus dem Index | Wo sie scheitert | Wofür sie taugt |
|---|---|---|---|
Antwort-Header | Ja, sobald Google crawlt und liest | Alles, was durch robots.txt blockiert ist oder hinter einem Login liegt | Nicht-HTML-Antworten (PDF, JSON, Bilder) und Edge- oder CDN-Regeln für viele Routen |
| Ja, sobald Google crawlt und liest | Tags, die per JavaScript nach dem Laden eingefügt werden; Seiten, die robots.txt blockiert | Serverseitig gerenderte HTML-Freigabeseiten |
Disallow in der | Nein | Eine verlinkte URL kann ohne Snippet indexiert bleiben | Crawl-Last senken, nicht Privatsphäre |
Login oder signierte URL | Ja, indem der Zugriff verhindert wird | Verlangt, dass die Seite wirklich privat ist | Alles, was Daten anderer Menschen enthält |
410 nach Ablauf | Ja, mit der Zeit | Langsamer als 404; wirkt nicht, solange die URL noch auflöst | Flüchtige Freigaben und Builds |
Eine Abkürzung, die man meiden sollte: X-Robots-Tag: none ist kein neutraler Wert. Google behandelt ihn als noindex plus nofollow. Manchmal ist das genau richtig, aber Teams kopieren ihn aus einer Proxy-Konfiguration, ohne es zu wissen.
Zweite Abkürzung, die man meiden sollte: Canonical-Tags. Ein Canonical ist ein Hinweis. Wenn die Seite nicht in den Index gehört, schreiben Sie noindex.
Schritt 1: Inventarisieren Sie die Routen, die URLs erzeugen
Man kann nicht klassifizieren, was nicht auf einer Liste steht, und die meisten Teams unterschätzen die Zahl, weil sie an Funktionen denken statt an Routenmuster.
Öffnen Sie den Router oder die URL-Map und listen Sie jedes dynamische Segment auf. Die üblichen Verdächtigen sehen so aus:
/s/:id,/share/:id,/p/:token/chat/:id,/conversation/:id,/thread/:id/u/:handle,/profile/:handle/app/:id,/build/:id,/project/:id/r/:slug,/preview/:token,/report/:id
Prüfen Sie das dann gegen das, was Google bereits weiß, denn Code und Index werden sich widersprechen.
Über die Sitemap. Herunterladen und zählen:
curl -s https://example.com/sitemap.xml | grep -c "<loc>"
curl -s https://example.com/sitemap.xml | grep -oE "https://[^<]+" | sed -E 's#https://[^/]+##' | cut -d/ -f2 | sort | uniq -c | sort -rn
Der zweite Befehl liefert ein grobes Histogramm pro Pfadpräfix. Steht eine generierte Route in Ihrer Sitemap, ist das schon ein Fehler: Eine Sitemap ist eine Liste von Seiten, für die Sie Google um Indexierung bitten.
Über die Search Console. Öffnen Sie den Bericht zur Seitenindexierung, filtern Sie je Kandidatenroute nach URL-Präfix und notieren Sie die Zahlen. Das ist die einzige Quelle, die sagt, was Google mit diesen URLs tatsächlich gemacht hat.
Über Server-Logs. Gruppieren Sie Googlebot-Anfragen nach Präfix:
grep -i "Googlebot" access.log | awk '{print $7}' | cut -d/ -f2 | sort | uniq -c | sort -rn | head -20Erwartetes Ergebnis. Eine Liste von Routenmustern mit einer URL-Zahl daneben, erhoben aus mindestens zwei Quellen.
Qualitätsprüfung. Jede Route, die einem Besucher außerhalb des Teams ein 200 zurückgeben kann, gehört auf die Liste. Weichen Sitemap- und Search-Console-Zahl beim selben Präfix um mehr als ein paar Prozent voneinander ab, klären Sie das, bevor Sie etwas ändern.
Wenn Sie nichts finden. Wahrscheinlich haben Sie einen Client-seitigen Router. Suchen Sie die Routendefinitionen im Frontend statt im Backend und schauen Sie sich den Netzwerk-Tab bei einem echten Freigabelink an.
Schritt 2: Klassifizieren Sie jede Route in einer Tabelle, nicht in einer Besprechung
Schreiben Sie das Urteil dorthin, wo es jemand prüfen kann. Eine Zeile pro Routenmuster reicht.
Route | Erstellt von | Auffindungsweg | Wert für Fremde | Urteil | Steuerung | Verantwortlich |
|---|---|---|---|---|---|---|
| Jeder Nutzer | Nur Link | Keiner | noindex | Header | Plattform |
| Kuratierung | Interne Links, Sitemap | Hoch | index | Keine | Content |
| Jeder Nutzer | Profillinks | Gering, bis aktiv | noindex bis Reputation | Meta | Trust & Safety |
| Jeder Nutzer | Nur Link | Keiner | noindex | Header | Plattform |
| Redaktion | Sitemap | Hoch | index | Keine | Content |
Die Tabelle funktioniert nur, wenn drei Dinge stimmen.
Eine verantwortliche Person pro Zeile. Unklare Zuständigkeit ist der Grund, warum generierte Routen jahrelang indexierbar bleiben.
Schreiben Sie die Steuerung neben das Urteil, nicht danach. "noindex" ist keine Entscheidung, solange niemand weiß, ob das einen Header, eine Template-Änderung oder eine CDN-Regel bedeutet.
Notieren Sie die Ausnahme. Ist eine Route noindex, aber eine kleine Teilmenge sollte öffentlich sein, schreiben Sie die Bedingung für diese Teilmenge jetzt auf. Den Ausschnitt ein halbes Jahr später zu ziehen, ist der Weg, auf dem eine noindex-Regel stillschweigend komplett verschwindet.
Schritt 3: Setzen Sie die Steuerung auf Template-Ebene um
Korrekturen Seite für Seite überleben das nächste Deployment nicht. Setzen Sie die Steuerung dort, wo die Route gerendert wird.
Für HTML-Seiten gehört das Tag in den serverseitig gerenderten Head. Im App Router von Next.js sind das die Metadata; in Astro der Head des Layouts; in Rails oder Django das Layout-Template. Die genaue Syntax ist weniger wichtig als der Ort: Es muss im HTML stehen, das Google erhält, nicht nachträglich durch einen Client-Effekt ergänzt werden.
<meta name="robots" content="noindex">Für alles, was kein HTML ist, gibt es kein Meta-Tag, also nehmen Sie den Header:
X-Robots-Tag: noindexDas deckt PDF-Exporte, JSON-Antworten, generierte Bilder und CSV-Downloads ab. Werden diese Dateien über ein CDN ausgeliefert, setzen Sie den Header am Rand, damit neue Routen die Regel erben.
Für eine ganze Routenfamilie ist eine Middleware-Regel meist sauberer, als jedes Template anzufassen:
// Express-Beispiel: noindex auf allen generierten Freigabe-URLs
app.use(['/s', '/share', '/report'], (req, res, next) => {
  res.set('X-Robots-Tag', 'noindex');
  next();
});
Erwartetes Ergebnis. Ein Deployment, in dem jede als noindex markierte Route die Direktive im ersten Byte zurückgibt, und zwar für anonyme Anfragen.
Qualitätsprüfung. Führen Sie curl -sI gegen die veröffentlichte URL aus. In den Antwort-Headern sollte x-robots-tag: noindex stehen, und curl -s sollte das Meta-Tag im Quelltext zeigen, bevor irgendein Skript läuft.
Rettungsweg. Erscheint das Tag erst nach der JavaScript-Ausführung, verschieben Sie es ins serverseitige Rendering. Kann das Framework keine Head-Tags pro Route rendern, nehmen Sie den Header. Veröffentlichen Sie keinen per JS eingefügten noindex und gehen Sie nicht davon aus, dass er funktioniert: Google beschreibt das Verhalten von gerendertem noindex als unklar.
Zwei weitere Punkte gehören in denselben Pull Request. Entfernen Sie noindex-Routen aus der Sitemap, denn eine URL einzureichen, die Sie nicht indexiert haben wollen, ist ein Widerspruch, den Google zu seinen Gunsten auflöst. Und ergänzen Sie eine Ablaufregel: Wenn ein Freigabelink stirbt, geben Sie 410 zurück, statt eine 200-Seite mit leerem Zustand zu behalten.
Schritt 4: Prüfen Sie, ob Googlebot die Direktive sehen kann
Nichts davon ist verifiziert, bis Sie es so prüfen, wie Google prüft.
Sehen Sie zuerst die Antwort-Header:
curl -sI https://example.com/s/abc123 | grep -i x-robots-tagDann das initiale HTML, bevor ein Skript laufen konnte:
curl -s https://example.com/s/abc123 | grep -i 'name="robots"'Und schließlich: Stellen Sie sicher, dass die robots.txt den Pfad nicht blockiert. Wenn doch, crawlt Google die Seite nie und liest die Direktive nie:
curl -s https://example.com/robots.txtDie Search Console ist die abschließende Prüfung. Fordern Sie die URL-Prüfung unter "URL-Prüfung" an und lesen Sie das Urteil.
Das richtige Ergebnis lautet "Nicht indexiert: durch 'noindex'-Tag ausgeschlossen". Das Ergebnis, das zeigt, dass Sie in die Falle getappt sind, lautet "Indexiert, obwohl durch robots.txt blockiert" – Google hat die URL, kann die Direktive nicht lesen und zeigt sie eventuell weiter an. Erscheint das, entfernen Sie die robots.txt-Regel und lassen Sie noindex die Arbeit machen.
Sie können die Seite auch mit einem Crawler-Simulator so abrufen, wie Googlebot sie sieht. Das ist schneller, als auf einen neuen Crawl zu warten, wenn Sie zwanzig Routen prüfen: Googlebot Spider Simulator.
Erwartetes Ergebnis. Jede noindex-Route zeigt wenige Tage nach dem nächsten Crawl den Status "wegen noindex ausgeschlossen". Nach der Änderung erstellte Routen sollten gar nicht erst im Index erscheinen.
Rettungsweg. Ist eine URL nach zwei Wochen immer noch indexiert, prüfen Sie, ob Google sie crawlen kann, ob die Seite Googlebot ein 200 gibt und ob ein Canonical- oder hreflang-Tag die Suchmaschinen woandershin schickt. Nutzen Sie das Entfernungs-Tool nur als vorübergehende Sperre, während Sie die Ursache beheben; es ersetzt die Direktive nicht.
Wenn die Freigabeseite der Wachstumskanal ist
Manche generierten Seiten sollten indexiert werden, und noindex auf alles wäre ein Schuss ins eigene Knie. Diese Muster sind es wert, geschützt zu werden:
Muster | Warum es in den Index gehört | Leitplanke |
|---|---|---|
Öffentliche Vorlagengalerien | Nutzer veröffentlichen ein Design, andere verwenden es weiter; das Ergebnis ist einzigartig und haltbar | Neue Einreichungen moderieren |
Builder mit öffentlichen Showcase-Seiten | Ein echtes Ergebnis mit "built with"-Credit ist ein Distributionskanal | Showcase-Template von der Marketing-Seite getrennt halten |
Dokumentation, die aus Nutzer-Threads wächst | Eine wiederkehrende Frage verdient eine dauerhafte, redigierte Antwort | Die kuratierte Antwort indexieren, nicht das rohe Gespräch |
Wenn Sie in eine dieser Kategorien fallen, gilt Googles älterer Hinweis weiter und ist der beste Hebel: noindex für Inhalte von Nutzern ohne Reputation und danach freigeben, wenn das Konto eine Historie hat. Das gibt Spamresistenz, ohne die Akquise-Schleife aufzugeben, und ist das Muster, das der Leitfaden vor dieser Aktualisierung empfohlen hat.
Der Test ist für alle drei derselbe. Gewinnt die Seite Impressionen in der Suchleistung für Anfragen, die ein Fremder eintippen würde, gehört sie in den Index. Gewinnt sie Impressionen nur über den eigenen URL-String, gehört sie nicht dorthin.
Es gibt einen Effekt zweiter Ordnung, den man benennen sollte. Öffentliche Freigabe-URLs waren jahrelang eine billige Link-Fläche: eine Seite auf einer Plattform mit starker Domain anlegen, einen Link auf die eigene Website zeigen lassen, das Ganze in zwanzig Properties wiederholen. Patrick Stox zählte in einem Thread über 20 Links von verschiedenen Plattformen. Folgen die Plattformen dem Hinweis, schrumpft diese Fläche. Folgen sie nicht, hat Google jetzt ein Dokument, das es zitieren kann, wenn es das nächste Mal entscheidet, dass diese Seiten Spam sind.
Schritt 5: Instrumentieren Sie das Muster, das Google beschrieben hat
Der Abschnitt zur Überwachung ist der Teil der Aktualisierung, den die meisten Teams überspringen – und genau der, der einen echten Vorfall abfängt, bevor daraus eine manuelle Maßnahme wird.
Vier Prüfungen, jede mit einem Ort zum Nachsehen.
Property in der Search Console. Verifizieren Sie Website oder Subdomain, damit Warnungen zu manuellen Maßnahmen und Sicherheitsproblemen per E-Mail ankommen. Betreiben Sie eine Plattform mit Mieter-Subdomains, verifizieren Sie die Eltern-Domain und mindestens eine Stichprobe der Kinder; eine Warnung, die nirgends ankommt, ist keine Überwachung.
Verlauf der Seitenindexierung. Legen Sie heute den Ausgangswert indexierter URLs pro generierter Route fest und beobachten Sie Sprünge, nicht Rauschen. Die Verdopplung der indexierten URLs einer Route innerhalb einer Woche, die statisch sein sollte, ist das Signal.
Anomalien in der Suchleistung. Filtern Sie nach Anfragen ohne Produktbezug. Spam-Seiten ziehen Spam-Anfragen an, lange bevor sich jemand beschwert.
Verhältnis von Erstellung zu Indexierung. Das ist die Kennzahl, die Google nennt und die fast niemand misst: Wie viele indexierbare URLs kann ein einzelnes Konto pro Tag erzeugen, und welcher Anteil der neuen indexierbaren URLs kommt von den obersten 1 Prozent der Konten. Ein erster Alarm bei dreifachem Median der letzten sieben Tage pro Konto ist willkürlich, aber er funktioniert; justieren Sie ihn an Ihrem Traffic.
Dasselbe Verhältnis taugt als Produkt-Leitplanke. Erlaubt eine Funktion einem Nutzer, pro Tag tausend indexierbare URLs zu erzeugen, ist sie eine Index-Aufblähfunktion – auch wenn noch niemand sie missbraucht.
Was die Aktualisierung wirklich sagt
Nimmt man die Formulierungen weg, argumentiert Google über das Angebot.
Zwanzig Jahre lang hat die Spam-Richtlinie Seiten beschrieben: dünn, abgeschöpft, verschleiert, mit Keywords vollgestopft. Diese Kategorien setzen voraus, dass ein Mensch oder ein Skript entscheidet, eine Seite zu produzieren, und Google entscheidet, ob sie ein Ranking verdient. Generierte Ergebnisse brechen dieses Modell. Eine Produktentscheidung kann eine Million URLs erzeugen, alle technisch einzigartig, alle technisch 200, die meisten ohne Wert für alle, die sie nicht erstellt haben. Google kann sie nicht einzeln bewerten und hat aufgehört, so zu tun.
Die Reaktion teilte sich in zwei Lager. Das erste las es als Warnschuss: Marie Haynes fragte, ob neue manuelle Maßnahmen für KI-Tools und App-Builder kommen würden, und Lily Ray behandelte den Abschnitt als Signal dafür, wogegen Google schon in großem Maßstab vorgeht, mit Verweis auf Claude-Artifacts, ChatGPT-Freigabeseiten und Social-Media-Posts. Das zweite zuckte mit den Schultern. Sorgfältige Teams setzen nutzergenerierte Berichte seit Jahren auf noindex, argumentierten mehrere Antworten, und Googles eigene generierte Seiten seien das größere Problem. Beide Lesarten können stimmen. Relevant wird der Hinweis nicht, weil der Rat neu wäre, sondern weil er jetzt an einer Stelle steht, auf die man sich bei der Durchsetzung berufen kann.
Der Hinweis verschiebt die Entscheidung also in der Kette nach oben. Von Plattformen wird erwartet, dass sie auf Template-Ebene entscheiden, ob eine Klasse von URLs in den Index gehört. Das ist eine Governance-Frage, keine SEO-Frage, und deshalb steht der Rat im Spam-Leitfaden und nicht in der Indexierungsdokumentation.
Für die KI-Suche gilt dieselbe Logik in beide Richtungen. Googles KI-Funktionen speisen sich aus dem Google-Index, eine noindex-Direktive entfernt die Seite also sowohl aus dem Pool als auch aus den blauen Links. Hat eine generierte Seite bisher Zitate in AI Overviews gewonnen, ist damit zu rechnen, dass das aufhört. Für einen Freigabelink ist das meist richtig, für eine Vorlagenseite falsch. Andere KI-Crawler folgen eigenen Regeln, entscheiden Sie also getrennt, welche davon diese Seiten crawlen dürfen.
Die praktische Lehre ist ein Satz, den man in ein Design-Review mitnehmen kann: Jede URL, die ein Nutzer erzeugen kann, ist entweder eine Produktfläche oder eine Index-Verbindlichkeit – und das Template entscheidet, was davon.
Häufige Fragen
Gilt das für eine gewöhnliche Marketing-Website?
Nein, außer Ihre Website erzeugt URLs aus Nutzereingaben. Eine Marketing-Website veröffentlicht eine Reihe von Seiten, von denen ein Mensch entschieden hat, dass es sie geben soll – das Gegenteil des Problems, das der Leitfaden beschreibt. Die Scope-Zeile nennt Hosting-Plattformen und Tools, die Nutzern erlauben, geteilte Seiten, generierte Inhalte oder Web-Apps zu veröffentlichen. Haben Sie Kommentare, ein Forum oder Mitgliederprofile, gilt der ältere Hinweis: nofollow oder ugc auf Links unzuverlässiger Konten und noindex für neue Nutzer, bis sie Reputation aufgebaut haben.
Sollte ich robots.txt oder ein noindex-Tag verwenden?
noindex – und pro Route nur eines von beiden. Googles Satz listet beide Optionen, aber sie tun unterschiedliche Dinge. Ein Disallow in der robots.txt blockiert das Crawling, und eine blockierte, aber von anderswo verlinkte URL kann ohne Snippet in den Ergebnissen bleiben. noindex funktioniert nur, wenn Google die Seite crawlen und lesen kann. Praktisch heißt das: ein Meta-Tag oder ein Antwort-Header, und nie eine robots.txt-Regel auf demselben Pfad.
Kostet noindex auf Freigabeseiten mich Traffic?
Prüfen Sie die Route, bevor Sie entscheiden, nicht danach. Gewinnt eine Seite Impressionen nur über den eigenen URL-String, bringt sie keinen organischen Traffic und das Entfernen kostet nichts. Das Muster, das Traffic verliert, ist das Abschalten einer öffentlichen Galerie zusammen mit den Ergebnissen darin. Lassen Sie die Galerie indexierbar, setzen Sie noindex auf das, was dahinter liegt, und verfolgen Sie die Suchleistung der Galerie-Anfragen vorher und nachher.
Respektieren KI-Suchmaschinen noindex?
Googles KI-Funktionen ja, denn AI Overviews und der AI Mode speisen sich aus demselben Index, eine Direktive entfernt die Seite also sowohl aus den blauen Links als auch aus den KI-Antworten. Andere KI-Crawler sind eine separate Entscheidung. Das Verhalten der Anbieter variiert und ändert sich ohne Changelog; lesen Sie die Dokumentation des jeweiligen Crawlers und rufen Sie die Seite mit dessen User-Agent ab, statt anzunehmen, dass eine Direktive alle abdeckt.
Autor: Grace Miller, Analystin für AI-Search-Risiken bei Auspia. Verfolgt über 200 Richtlinienänderungen. Schreibt über Plattformregeln, Inhaltsrisiken und richtlinienbewusste Optimierung.