Google 這次正式寫下的規則
2026 年 10 月 26 日,Google 在「避免使用者產生垃圾內容」指南中新增了兩段文字。這是整頁最短的一節,卻可能是改動最多產品藍圖的一節,因為它問了一個大多數團隊從未放上簡報的問題:這個 URL 到底該不該進 Google 的索引?
這一節的標題是「Only index content meant for Search(只索引為搜尋而生的內容)」。全文如下:
如果你的服務讓使用者建立可分享的頁面、產生的輸出或互動式工具,請判斷這些內容是希望透過搜尋引擎被找到,或只是讓持有連結的人直接存取。
當頁面是為了直接分享、協作或實用目的而建立,而非為了在公開搜尋中被發現時,請使用 robots meta 標籤或 X-Robots-Tag HTTP 回應標頭套用 noindex 規則,或是在 robots.txt 中預設封鎖爬取。
同日 Google 的更新日誌把意圖講得更直接:指南新增了「封鎖連結分享內容被索引,以及在 Search Console 監控濫用的指引」,讓平台能「把並非為搜尋而生的使用者建立頁面排除在索引之外,並更早偵測垃圾內容」。
就這樣。沒有新的手動處置公告、沒有排名系統發表、沒有懲罰清單。被建議的是一個「預設值」,而索引事故大多來自預設值。
適用對象。 任何會產出使用者可建立之 URL 的團隊:分享連結、儲存的對話、公開儀表板、範本預覽、應用程式建置、產生的報表、論壇討論串、個人檔案頁、評論頁、刊登頁。
讀完你會得到。 針對每種產生型 URL 的路由層級判定、真正能把頁面移出索引的控制方式,以及能抓到 Google 所述濫用模式的監控規則。
時間。 單一產品首次盤點約 45 到 90 分鐘。若有多個 URL 產生器又沒有路由清單,需要一整天。
完成的定義。 每個產生型路由都被標記為 index、noindex 或 private。noindex 路由在伺服器端就回傳指令,而不是等 JavaScript 執行後才出現。Search Console 把這些 URL 顯示為「已被 noindex 標記排除」,而不是「已建立索引,但遭 robots.txt 封鎖」。
改變了什麼,以及什麼只是看起來很新
真正重要的編輯有四處。頁面其餘部分沒變,包括 2025 年 12 月的建議依然適用。
Google 改了什麼 | 實際文字 | 對你的意義 |
|---|---|---|
指南的適用範圍 | 明確納入「讓使用者發佈分享頁面、產生內容或網路應用程式的代管平台與工具」 | 照字面讀,涵蓋 AI 對話匯出、artifact 頁面、應用程式建置器與無程式碼工具,不只是論壇和留言區 |
濫用的單位 | 垃圾內容發送者可能建立「大量頁面或網站」 | Google 談的是量,不是技巧。一個濫用帳號就能量產數千個 URL |
新章節 | 「Only index content meant for Search」 | 至今最明確的表態:對僅供連結存取的內容,noindex 是合理的預設值 |
監控 | 在 Search Console 驗證網站或子網域,觀察頁面索引與搜尋成效的突增;當「少數使用者」產生「大量可索引 URL」時發出警示 | 索引膨脹現在有了具名的偵測方法,而通常名稱出現之後,審查流程就會跟上 |
沒有改變的部分:在使用者累積信譽之前對其貼文套用 noindex,以及在不受信任的內容中對連結加上 nofollow 或 ugc。這兩件事你已經在做,就領先這次更新。
有件事要講清楚,因為 X 上的反應跑在文件前面:這是給平台、關於它們自身 URL 供給的指引。它不會為一般行銷網站創造新的違規,也不會改變任何頁面的排名。它改變的是「索引裡應該存在什麼」。
還有一段背景能解釋時機。2026 年 7 月底,Claude 的分享連結與 artifact 頁面出現在 Google 索引中,當時的報導描述醫療紀錄、API 金鑰等私密資料曝光,Anthropic 在數天內補上缺口。同一批報導也點名 Replit、Lovable 等建置器上的公開應用程式 URL。Google 很少為假設性情境寫新章節。這一節寫的是已經發生過的事。
決定每個產生型 URL 的那個問題
Google 的測試只有一句話,而且不必猜意圖就能套用:這份內容是希望透過搜尋引擎被找到,或只是讓持有連結的人存取?
實務上有四個訊號能回答。評分對象是路由,不是個別頁面。
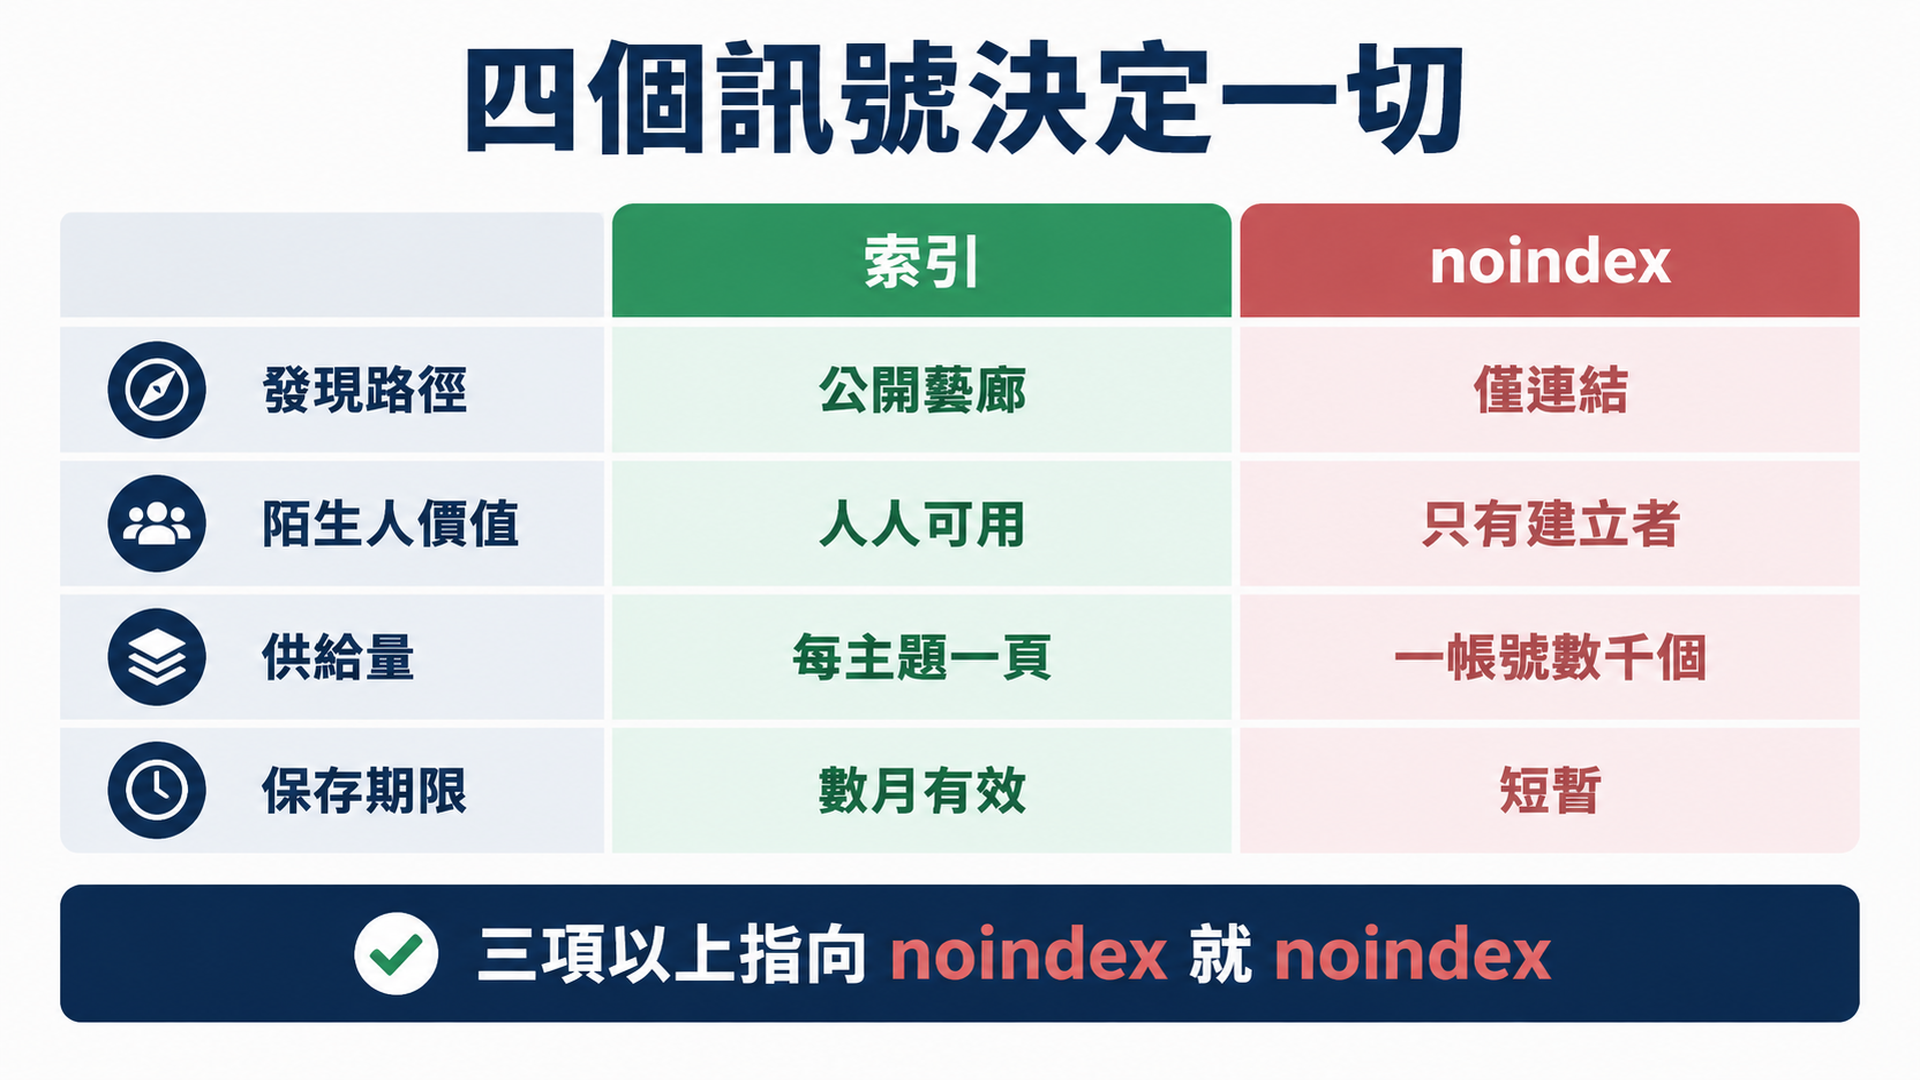
訊號 | 指向索引 | 指向 noindex |
|---|---|---|
發現路徑 | 從公開藝廊、網站地圖、分類頁或個人檔案連結而來 | 只能透過複製的連結或分享按鈕抵達 |
對陌生人的價值 | 不認識建立者也有用 | 只對建立者、其團隊或收件者有意義 |
供給量 | 每個主題一頁,或經策展的一組 | 一個帳號產生數千個 URL,多為近似重複 |
保存期限 | 數個月內維持正確 | 短暫:一次對話、一次建置、一份草稿、一次臨時匯出 |
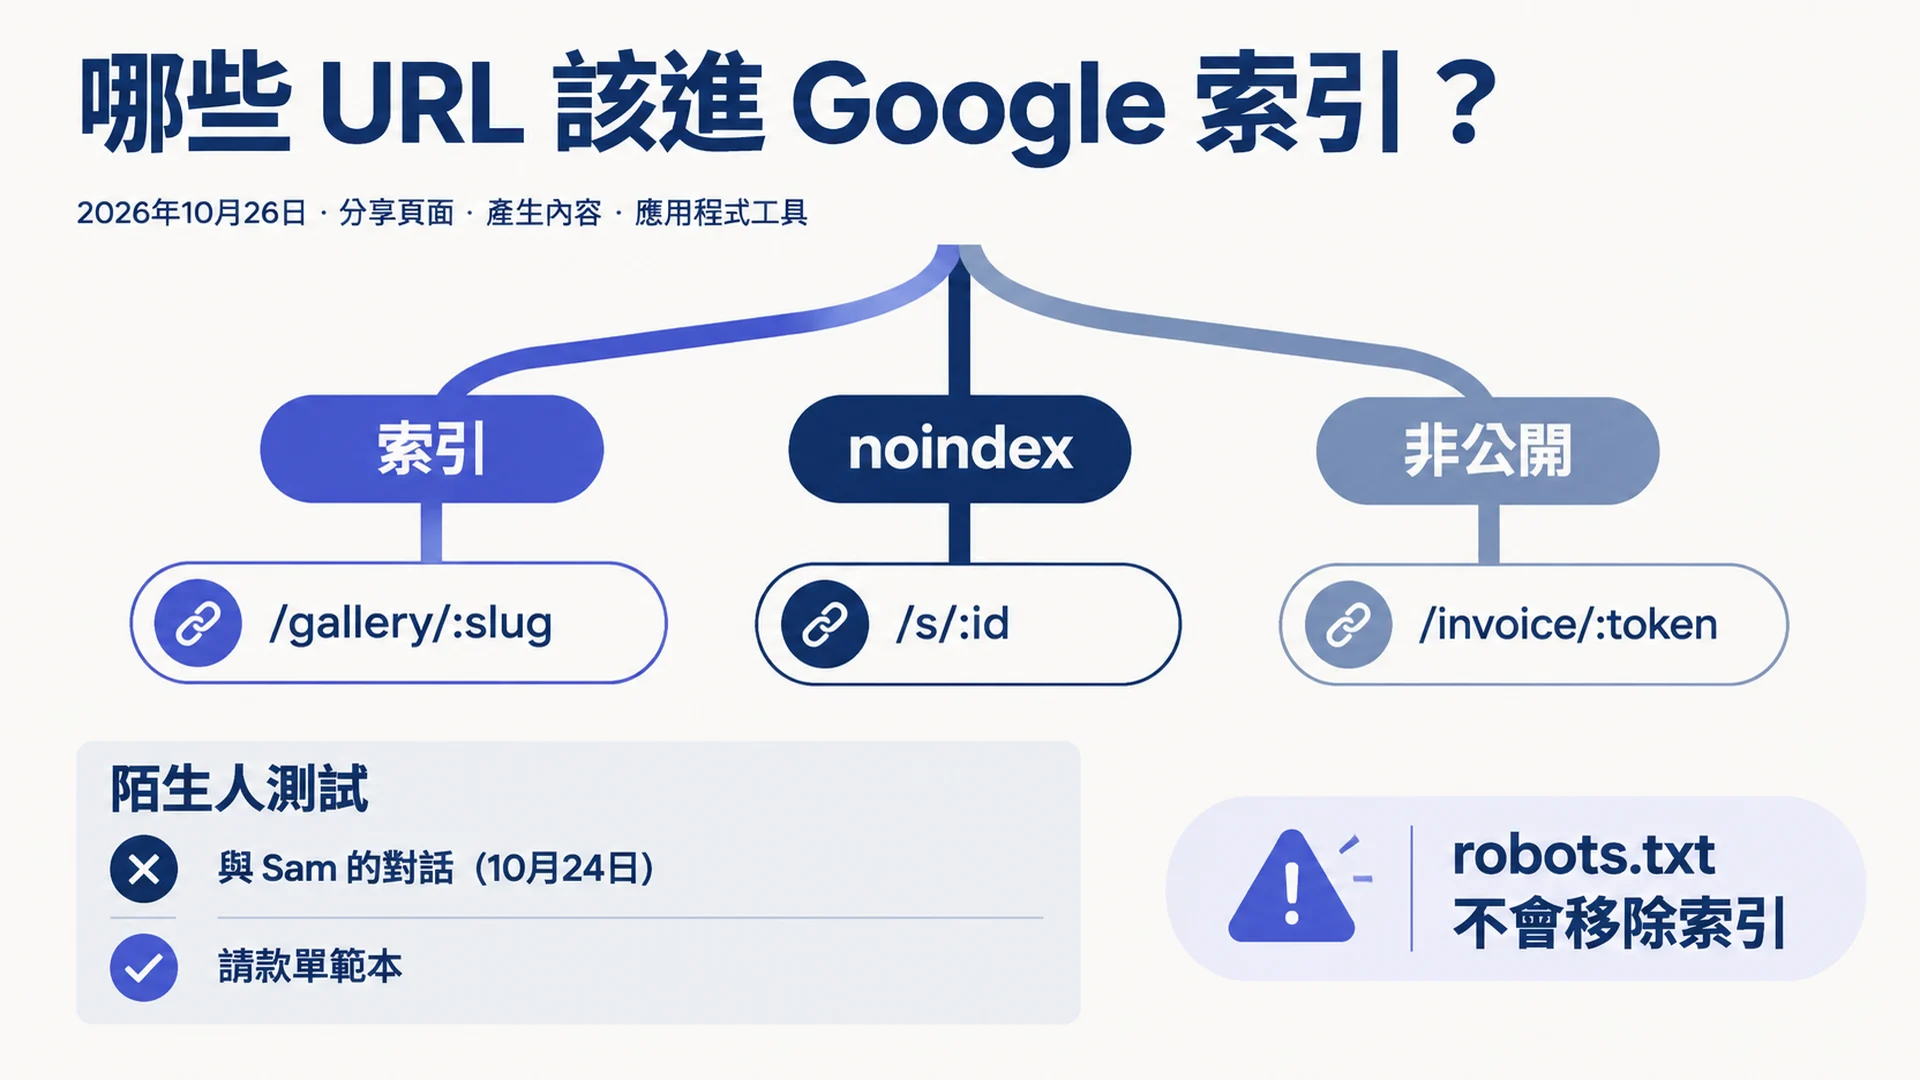
四項中有三項指向 noindex 就是明確答案。結果分歧通常代表這個路由需要拆開:可被索引的公開藝廊,加上不可被索引的個別輸出。這個拆法是常見的正解,也是多數團隊會跳過的答案,因為它需要兩套範本,而不是一個旗標。
有個好用的拒絕測試:陌生人如果在搜尋結果裡看到這個 URL、沒有任何背景,標題與摘要還說得通嗎?「與 Sam 的對話,10 月 24 日」不合格。「給自由接案設計師的請款單範本」合格。不合格的原因無關品質,而是這個頁面是為了被找到而做,還是為了被送出而做。
選擇真正能把 URL 移出索引的控制方式
這裡是可以照字面遵守新指引、結果仍然失敗的地方。Google 在同一句話裡提供兩個選項,而兩者並不等價。
robots.txt 控制爬取。它不會把 URL 移出索引,Google 在 robots.txt 入門文件中就這麼說:被 Disallow 的頁面「若被其他網站連結,仍可能被建立索引」,此時 URL 與指向它的錨點文字可能以無摘要的形式出現在結果中。
noindex 控制索引,但前提是 Google 能取得頁面並讀到指令。Google 的 noindex 文件寫得很明確:規則要生效,頁面絕不能被 robots.txt 封鎖,否則「檢索器永遠看不到 noindex 規則」。
把這兩件事放在一起,順序就變得關鍵。
控制方式 | 能把 URL 移出索引嗎 | 失效的場合 | 適用場景 |
|---|---|---|---|
| 可以,在 Google 爬取並讀到之後 | 被 robots.txt 封鎖的、位於登入之後的 | 非 HTML 回應(PDF、JSON、圖片),以及跨多個路由的邊緣或 CDN 規則 |
HTML head 中的 | 可以,在 Google 爬取並讀到之後 | 載入後才由 JavaScript 注入的標籤;被 robots.txt 封鎖的頁面 | 伺服器端渲染的 HTML 分享頁 |
| 不行 | 被連結的 URL 可能無摘要地留在索引中 | 降低爬取負載,而非保護隱私 |
登入或簽章 URL | 可以,透過阻擋存取 | 頁面必須真的私密 | 任何含有他人資料的內容 |
到期後回傳 410 | 可以,隨時間生效 | 比 404 慢;URL 仍可解析時毫無作用 | 短暫的分享與建置 |
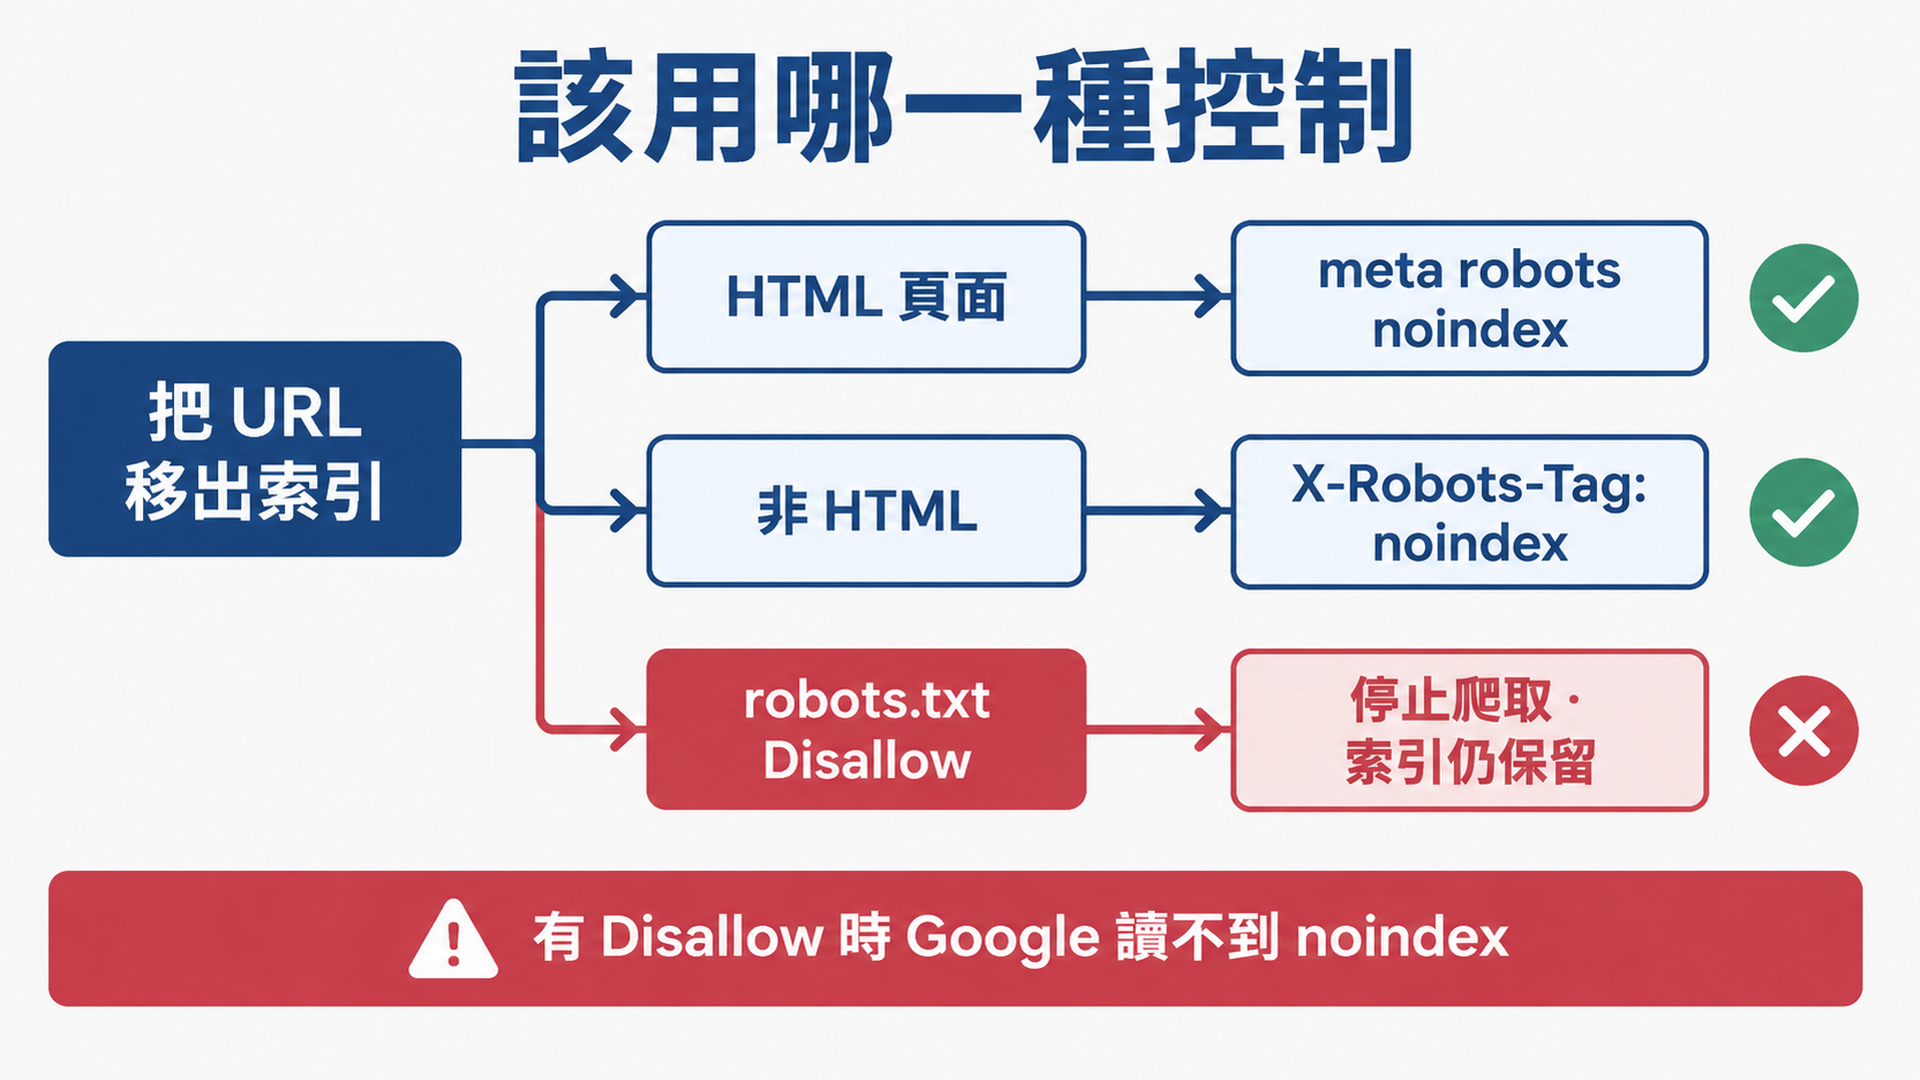
要避開的捷徑之一:X-Robots-Tag: none 不是中性值。Google 會把它視為 noindex 加 nofollow。偶爾這正是你要的,但團隊常從代理設定複製過來,並不知道這件事。
要避開的捷徑之二:canonical 標籤。canonical 是提示。如果這個頁面不該進索引,就寫 noindex。
步驟 1:盤點會量產 URL 的路由
沒列出來的東西無法分類,而多數團隊低估數量,因為他們用功能思考,不是用路由模式思考。
打開路由器或 URL 對照表,列出每一個動態區段。典型的高風險樣式長這樣:
/s/:id、/share/:id、/p/:token/chat/:id、/conversation/:id、/thread/:id/u/:handle、/profile/:handle/app/:id、/build/:id、/project/:id/r/:slug、/preview/:token、/report/:id
接著對照 Google 已經知道的事,因為你的程式碼與索引一定會不一致。
從網站地圖。 抓下來數一數:
curl -s https://example.com/sitemap.xml | grep -c "<loc>"
curl -s https://example.com/sitemap.xml | grep -oE "https://[^<]+" | sed -E 's#https://[^/]+##' | cut -d/ -f2 | sort | uniq -c | sort -rn
第二個指令會給你粗略的路徑前綴直方圖。如果產生型路由出現在網站地圖裡,那本身就是個錯誤:網站地圖是你要求 Google 索引的頁面清單。
從 Search Console。 打開「頁面索引」報表,對每個候選路由用 URL 前綴篩選,記下數量。這是唯一能告訴你 Google 實際怎麼處理這些 URL 的來源。
從伺服器日誌。 依前綴分組 Googlebot 請求:
grep -i "Googlebot" access.log | awk '{print $7}' | cut -d/ -f2 | sort | uniq -c | sort -rn | head -20預期產出。 一份路由樣式清單,每個樣式旁邊有 URL 數量,且至少來自兩個來源。
品質檢查。 任何能對非員工訪客回傳 200 的路由都應該在清單上。同一個前綴下,網站地圖數量與 Search Console 數量若相差超過幾個百分點,先查清楚原因再改任何東西。
什麼都沒找到的話。 你大概用的是客戶端路由器。改在前端搜尋路由定義,而不是後端,並在真實的分享連結上檢查網路面板。
步驟 2:用表格分類每個路由,而不是用會議
把判定寫在可以被審閱的地方。每個路由樣式一列就夠。
路由 | 建立者 | 發現路徑 | 陌生人價值 | 判定 | 控制 | 負責人 |
|---|---|---|---|---|---|---|
| 任何使用者 | 僅連結 | 無 | noindex | 標頭 | 平台 |
| 策展 | 內部連結、網站地圖 | 高 | index | 無 | 內容 |
| 任何使用者 | 個人檔案連結 | 啟用前偏低 | 累積信譽前 noindex | meta 標籤 | 信任與安全 |
| 任何使用者 | 僅連結 | 無 | noindex | 標頭 | 平台 |
| 編輯 | 網站地圖 | 高 | index | 無 | 內容 |
這張表只有在三件事成立時才有用。
每一列指定一位負責人。責任模糊,正是產生型路由能持續好幾年可被索引的原因。
把控制方式寫在判定旁邊,不要留到之後。「noindex」在有人知道它指的是標頭、範本修改還是 CDN 規則之前,都還不是一個決定。
記錄例外。如果某個路由是 noindex,但有一小部分應該公開,現在就寫下那個子集條件。半年後才補例外,正是 noindex 規則被默默整條移除的典型路徑。
步驟 3:在範本層級部署控制
逐頁修補撐不過下一次部署。把控制套用在路由被渲染的地方。
HTML 頁面把標籤放進伺服器端渲染的 head。在 Next.js App Router 是 metadata,在 Astro 是 layout 的 head,在 Rails 或 Django 是 layout 範本。精確語法不如位置重要:它必須出現在 Google 收到的 HTML 裡,而不是由客戶端副作用加上去。
<meta name="robots" content="noindex">不是 HTML 的東西沒有 meta 標籤可用,所以改用標頭:
X-Robots-Tag: noindex這涵蓋 PDF 匯出、JSON 回應、產生的圖片與 CSV 下載。如果這些檔案由 CDN 提供,請在邊緣設定標頭,讓新路由自動繼承。
整個路由家族通常用中介層規則比逐一改範本乾淨:
// Express 範例:把每個產生型分享 URL 設為 noindex
app.use(['/s', '/share', '/report'], (req, res, next) => {
  res.set('X-Robots-Tag', 'noindex');
  next();
});
預期產出。 一次部署,讓所有標記為 noindex 的路由對匿名請求在第一個位元組就回傳指令。
品質檢查。 對上線 URL 執行 curl -sI。回應標頭應該看得到 x-robots-tag: noindex,而 curl -s 應該在任何指令碼執行前的原始碼中看到 meta 標籤。
回復路徑。 如果標籤只在 JavaScript 執行後出現,把它移到伺服器端渲染。若你的框架無法逐路由渲染 head 標籤,改用標頭。不要部署由 JS 注入的 noindex 然後假設它有效;Google 明確表示渲染後的 noindex 行為尚未良好定義。
同一個 pull request 裡還該放兩件事。把 noindex 路由從網站地圖移除,因為提交一個你不想被索引的 URL 是自相矛盾,而 Google 會朝對自己有利的方向解決這個矛盾。以及加上到期規則:分享連結失效時回傳 410,而不是留下一頁空狀態的 200。
步驟 4:驗證 Googlebot 看得到指令
以上全部,在你用 Google 的方式檢查之前都未經驗證。
先看回應標頭:
curl -sI https://example.com/s/abc123 | grep -i x-robots-tag再看任何指令碼有機會執行之前的初始 HTML:
curl -s https://example.com/s/abc123 | grep -i 'name="robots"'最後確認 robots.txt 沒有封鎖該路徑。若有封鎖,Google 永遠不會取得頁面,也永遠不會讀到指令:
curl -s https://example.com/robots.txtSearch Console 是最後一道檢查。在「網址檢查」中要求檢索該 URL,讀取判定。
正確結果是「網頁未建立索引:已遭『noindex』標記排除」。代表你掉進陷阱的結果是「已建立索引,但遭 robots.txt 封鎖」——Google 有這個 URL、讀不到指令,而且可能繼續提供它。看到這個,就移除 robots.txt 規則,讓 noindex 去做它該做的事。
你也可以用檢索器模擬器取得 Googlebot 看到的頁面,在要檢查二十個路由時比等重新爬取快得多:Googlebot Spider Simulator。
預期產出。 下一次爬取後幾天內,每個 noindex 路由都呈現被 noindex 排除的狀態。變更之後才建立的路由則完全不該出現在索引中。
回復路徑。 若某個 URL 兩週後仍在索引中,檢查 Google 是否根本取不到它、它對 Googlebot 是否回傳 200、是否有 canonical 或 hreflang 標籤把搜尋引擎指向別處。移除工具只在修復成因期間做臨時封鎖,不能取代指令本身。
當分享頁面本身就是成長管道
有些產生型頁面應該被索引,一刀切的 noindex 會是自傷。以下這幾類值得保護:
模式 | 為何值得進索引 | 護欄 |
|---|---|---|
公開範本藝廊 | 使用者發佈設計、他人重複使用;輸出獨特且耐久 | 對新投稿做審核 |
具公開展示頁的建置器 | 帶有「built with」標註的真實成果本身就是散播管道 | 展示頁範本與行銷頁分開 |
從使用者討論串長出的文件 | 反覆出現的問題值得一個長期、經過編輯的答案 | 索引策展後的答案,而不是原始對話 |
如果你屬於這幾類,Google 較早的建議依然適用,而且是更好的槓桿:對沒有信譽的使用者內容套用 noindex,帳號有歷史後再解除。這樣既保有獲取循環,又得到抗垃圾能力,也是本次更新前指南就建議的模式。
這三類的測試都一樣。如果頁面能在陌生人會輸入的查詢上取得搜尋成效曝光,它就屬於索引。如果只在自身 URL 字串上取得曝光,就不屬於。
還有一個二階效應值得點名。公開分享 URL 多年來一直是廉價的連結表面:在網域權重高的平台上建立頁面、放一條指向自己網站的連結、在二十個平台上重複。Patrick Stox 在同一個討論串裡數到來自不同平台的 20 多條連結。如果平台遵循指引,這個表面會收窄;如果不遵循,Google 下次判定那些頁面是垃圾內容時,就有一份文件可以引用。
步驟 5:為 Google 描述的模式建立量測
監控章節是多數團隊會跳過的部分,卻也是能在真實事故變成手動處置之前抓到它的部分。
四項檢查,每一項都有該看的地方。
Search Console 所有權。 驗證網站或子網域,讓手動處置與安全性警示以電子郵件送達。如果你經營的是每租戶一個子網域的平台,驗證父項與至少一部分子項資源;送到虛無的警示不算監控。
頁面索引趨勢。 今天就為每個產生型路由的已索引 URL 數量建立基準線,然後觀察階梯式變化,而不是雜訊。一個本該靜態的路由在一週內索引 URL 翻倍,那就是訊號。
搜尋成效異常。 篩選與產品無關的查詢。垃圾頁面在有人投訴之前很久,就會先吸引垃圾查詢。
建立量與索引量的比例。 這是 Google 點名的指標,也是幾乎沒人追蹤的指標:單一帳號每天能產生多少可索引 URL,以及新可索引 URL 中有多少比例來自前 1% 的帳號。以單一帳號達到近七日中位數 3 倍作為起始警示是任意但可用的做法,再依自家流量調整。
同一個比例也能當產品護欄。如果一個功能讓單一使用者每天產生一千個可索引 URL,那它就是索引膨脹功能,不管現在有沒有人濫用。
這次更新真正在說什麼
把措辭剝掉,Google 在談的是供給。
二十年來,垃圾內容政策描述的是頁面:內容稀薄、抄襲拼湊、隱藏偽裝、堆砌關鍵字。那些分類的前提是:有人或某個指令碼決定要產出一個頁面,而 Google 決定它值不值得排名。產生型輸出打破了這個模型。一個產品決策就能造出一百萬個 URL,全部技術上獨特、全部技術上回傳 200,而且大多數對不是建立者的人毫無價值。Google 無法逐一評估,也不再假裝可以。
反應大致分成兩派。第一派讀成警告射擊:Marie Haynes 追問 AI 工具與應用程式建置器是否會接著出現新的手動處置,Lily Ray 把這一節視為 Google 已經在大規模對抗什麼的訊號,並點名 Claude 的 artifact、ChatGPT 分享頁與社群貼文。第二派不以為意:許多謹慎的團隊多年來早就把使用者產生的報表設為 noindex,而且有人主張 Google 自己產生的頁面才是更大的問題。兩種讀法都可能是對的。讓這份指引重要的是:建議本身不新,但它現在寫在一個執法可以指向的地方。
所以指引把判斷往上游推。平台現在被期待在範本層級決定某一類 URL 是否屬於索引。這是治理問題,不是 SEO 問題,也正是這段建議放在垃圾內容指南、而不是索引文件裡的原因。
對 AI 搜尋而言,同樣的邏輯雙向成立。Google 的 AI 功能取自 Google 索引,因此 noindex 指令會把頁面同時從藍色連結與那個池子裡移除。如果某個產生型頁面原本在 AI Overview 中取得引用,預期那些引用會停止。對分享連結而言這通常正確,對範本頁而言通常錯誤。其他 AI 檢索器依自己的規則行事,所以要另外決定你希望哪些檢索器能取得那些頁面。
可以放進設計評審的一句話是:使用者能建立的每一個 URL,不是產品介面就是索引負債,而範本決定它是哪一種。
常見問題
一般行銷網站也適用嗎?
除非你的網站會從使用者輸入產生 URL,否則不適用。行銷網站發佈的是一組由人決定應該存在的頁面,正好與指南描述的問題相反。適用範圍那句話點名的是讓使用者發佈分享頁面、產生內容或網路應用程式的代管平台與工具。若你經營留言、論壇或會員檔案,較早的建議適用:對不受信任帳號的連結加上 nofollow 或 ugc,並在使用者累積信譽前設為 noindex。
該用 robots.txt 還是 noindex 標籤?
用 noindex,而且同一個路由只用其中一種。Google 的句子列出兩個選項,但它們做的是不同的事。robots.txt 的 Disallow 停止爬取,而被封鎖但仍被其他網站連結的 URL 可能無摘要地留在結果中。noindex 只有在 Google 能取得頁面並讀到它時才有效。實務上就是 meta 標籤或回應標頭,而且絕不在同一條路徑上另設 robots.txt 規則。
把分享頁面設為 noindex 會損失流量嗎?
在決定之前檢查路由,而不是決定之後。如果頁面只在自身 URL 字串上取得曝光,它並沒有帶來自然流量,移除它毫無損失。真正會掉流量的模式,是把公開藝廊連同其中的輸出一起撤下。讓藝廊保持可被索引、把後面的東西設為 noindex,並在變更前後觀察藝廊相關查詢的搜尋成效。
AI 搜尋引擎會遵守 noindex 嗎?
Google 的 AI 功能會,因為 AI Overview 與 AI 模式取自同一個索引,指令會把頁面同時從藍色連結與 AI 回答中移除。其他 AI 檢索器是另一個決定。各家行為不同,而且會在沒有更新日誌的情況下改變,所以要讀每個檢索器自己的文件,並用該檢索器的使用者代理取得頁面驗證,而不是假設一個指令就能涵蓋全部。
作者:Grace Miller,Auspia 的 AI 搜尋風險分析師,追蹤 200 多項政策變動。她撰寫平台規則、內容風險與政策導向的優化。