Google が今回書き下したルール
2026 年 10 月 26 日、Google はユーザー生成スパムの防止に関するガイドに 2 段落のセクションを追加しました。ページ全体で最も短い部分でありながら、おそらく最も多くのプロダクト ロードマップを変える部分です。なぜなら、ほとんどのチームがスライドに載せたことのない問いを投げかけているからです。この URL はそもそも Google のインデックスに入れるべきなのか、と。
セクションの見出しは「Only index content meant for Search(検索向けのコンテンツだけをインデックスする)」です。全文は次のとおりです。
サービスがユーザーによる共有可能なページ、生成された出力、インタラクティブなツールを作成できる場合、そのコンテンツが検索エンジンから見つけられることを意図しているのか、リンクを知っている人が直接アクセスするだけなのかを検討してください。
ページが公開検索での発見ではなく、直接の共有、共同作業、実用性のために作られている場合は、robots メタタグまたは X-Robots-Tag HTTP レスポンス ヘッダーを使って noindex ルールを適用するか、robots.txt でデフォルトでクロールをブロックしてください。
同じ日の Google の変更履歴は、意図についてより直接的です。ガイドは「リンク共有されたコンテンツのインデックス登録をブロックする方法と、Search Console で不正行為を監視する方法に関するガイダンス」で更新された、と書かれています。これによりプラットフォームは「検索向けではないユーザー作成ページをインデックスから除外し、スパムをより早く検出できる」ようになります。
以上です。新しい手動措置の告知も、ランキング システムの発表も、ペナルティの一覧もありません。推奨されたのは「デフォルト」であり、インデックスの事故のほとんどはデフォルトから生まれます。
対象読者。 ユーザーが生成できる URL を出荷しているすべてのチームです。共有リンク、保存されたチャット、公開ダッシュボード、テンプレートのプレビュー、アプリのビルド、生成レポート、フォーラムのスレッド、プロフィール ページ、レビュー ページ、リスティング ページなどが該当します。
この記事を読み終えると得られるもの。 生成 URL の種類ごとのルート単位の判定、実際にインデックスから外す制御、そして Google が示した不正行為パターンを捕まえる監視ルールです。
所要時間。 1 つのプロダクトの初回パスで 45〜90 分。URL 生成機能が複数あり、ルートの棚卸しができていない場合は 1 日。
完了の定義。 すべての生成ルートが index、noindex、private のいずれかに分類されている。noindex のルートは JavaScript の実行後ではなく、サーバーサイドでディレクティブを返している。Search Console でそれらの URL が「robots.txt によりブロックされましたが、インデックスに登録されました」ではなく「noindex タグにより除外されました」と表示されている。
変わったこと、変わって見えるだけのこと
重要な編集は 4 点です。ページの他の部分は変わっておらず、2025 年 12 月の助言も引き続き有効です。
Google が変えたもの | 実際のテキスト | あなたにとって重要な理由 |
|---|---|---|
ガイドの適用範囲 | 「共有ページ、生成コンテンツ、ウェブアプリをユーザーが公開できるようにするホスティング プラットフォームおよびツール」が明記された | 文字どおり読めば、フォーラムやコメント欄だけでなく、AI チャットのエクスポート、アーティファクト ページ、アプリ ビルダー、ノーコード ツールも対象になる |
不正行為の単位 | スパマーは「大量のページまたはサイト」を作成しうる | Google が語っているのは巧妙さではなく量。1 つの不正アカウントが数千の URL を鋳造できる |
新セクション | 「Only index content meant for Search」 | リンク限定のコンテンツにとって noindex が妥当なデフォルトである、というこれまでで最も明確な表明 |
監視 | Search Console でサイトまたはサブドメインを確認し、ページのインデックス登録と検索パフォーマンスの急増を監視する。「少数のユーザー」が「インデックス可能な URL の大部分」を生み出したらアラートを出す | インデックスの肥大化に検出方法の名前が付いた。通常、名前が付いた後にレビューの仕組みが続く |
変わっていないこと。実績を積むまでの新規ユーザーの投稿への noindex、および信頼できないコンテンツ内のリンクへの nofollow または ugc の付与です。この 2 つをすでに実践しているなら、今回の更新より一歩先にいます。
はっきり書いておきます。X 上の反応は文書そのものより先に走りましたが、これはプラットフォーム自身の URL 供給に関するガイダンスです。通常のマーケティング サイトに新しい違反を創設するものではなく、どのページのランキングも変えません。変わるのは、インデックスに何が存在すべきかという点です。
時期を説明する文脈がもう 1 つあります。2026 年 7 月末、Claude の共有リンクとアーティファクト ページが Google のインデックスに現れ、当時の報道は、Anthropic が数日で塞ぐ前に医療記録や API キーなどの非公開情報が露出していたと伝えました。同じ報道は Replit や Lovable といったビルダー上の公開アプリ URL も指摘しています。Google が仮定の話のために新しいセクションを書くことはほとんどありません。これはすでに出荷されてしまった話でした。
生成 URL すべてを決める 1 つの問い
Google のテストは 1 文で示されており、意図を推測せずに適用できます。このコンテンツは検索エンジンから見つけられることを意図しているのか、リンクを持っている人だけがアクセスするものなのか。
実務では 4 つのシグナルが答えを出します。採点するのは個々のページではなく、ルートです。
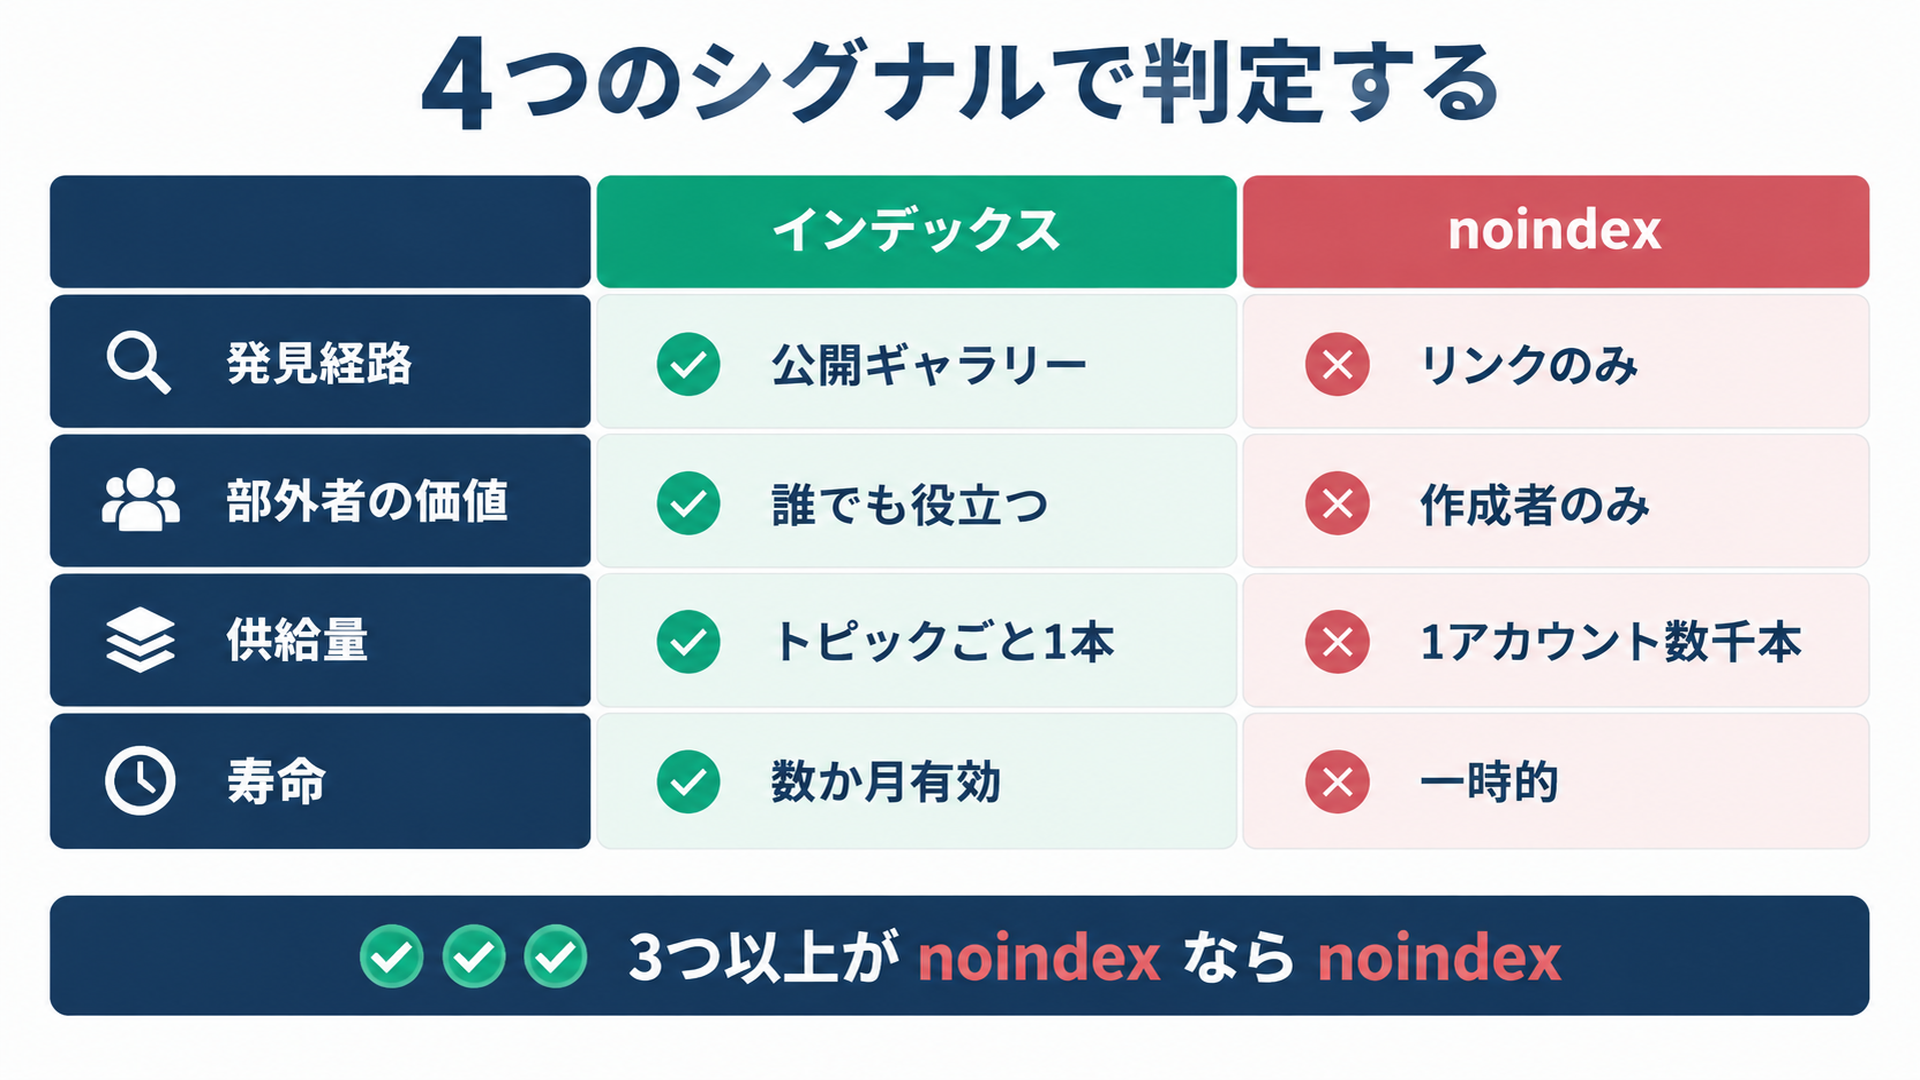
シグナル | インデックス方向 | noindex 方向 |
|---|---|---|
発見経路 | 公開ギャラリー、サイトマップ、カテゴリ ページ、プロフィールからリンクされている | コピーしたリンクや共有ボタンからしか到達できない |
部外者にとっての価値 | 作成者を知らなくても役に立つ | 作成者本人、そのチーム、または受け取った人にしか意味がない |
供給量 | トピックごとに 1 ページ、または厳選されたセット | 1 アカウントから数千の URL、その大半がほぼ重複 |
寿命 | 数か月にわたって正確であり続ける | 一時的。チャット、ビルド、下書き、一時的なエクスポート |
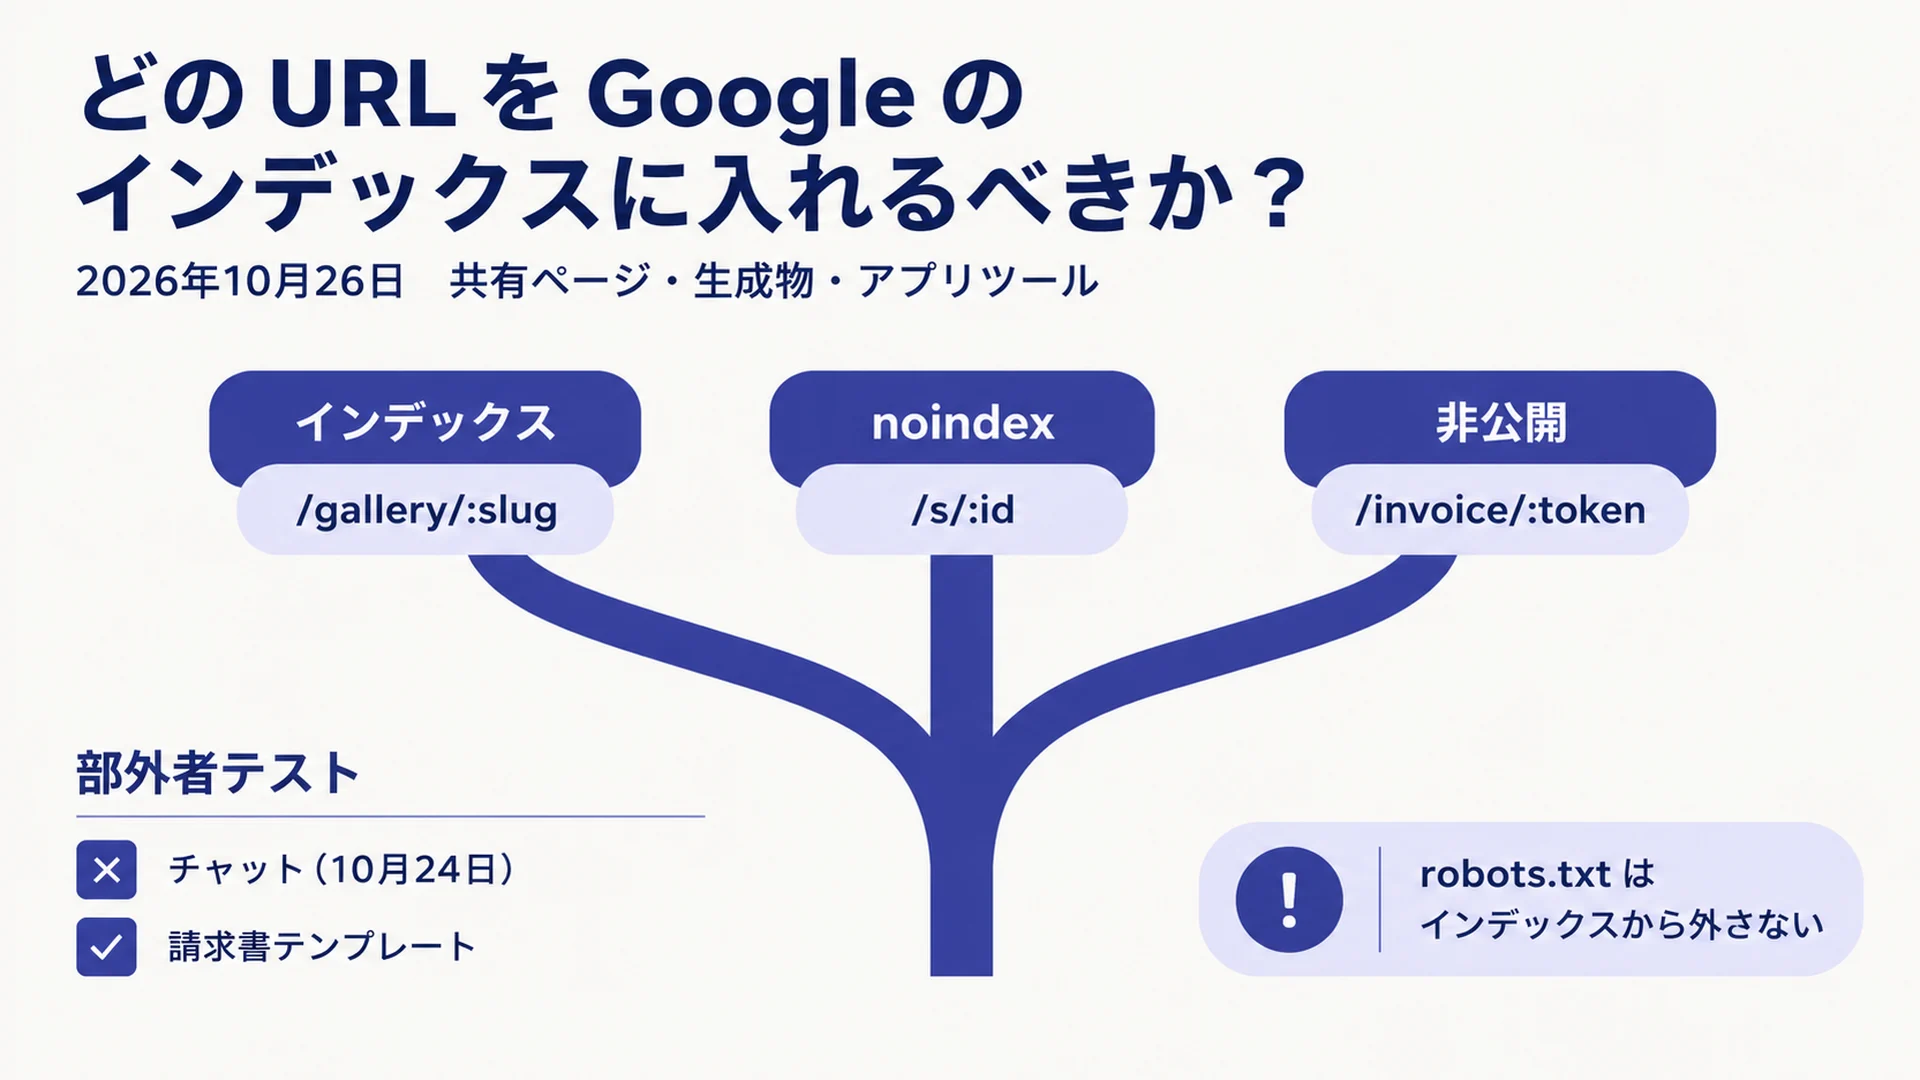
4 つのうち 3 つが noindex を指していれば明確です。結果が割れる場合は通常、ルートを分割する必要があります。インデックス可能な公開ギャラリーと、そうではない個々の出力を分けるのです。この分割が最もよくある正解であり、同時に最も見落とされる答えでもあります。フラグ 1 つではなくテンプレート 2 つが必要になるからです。
有用な拒否テストがあります。部外者が検索結果でこの URL を文脈なしに見たとき、タイトルとスニペットは意味をなすでしょうか。「Sam とのチャット、10 月 24 日」は不合格です。「フリーランス デザイナー向け請求書テンプレート」は合格です。不合格の原因は品質ではありません。そのページが見つけられるように作られたのか、送られるように作られたのかという点です。
実際に URL を外す制御を選ぶ
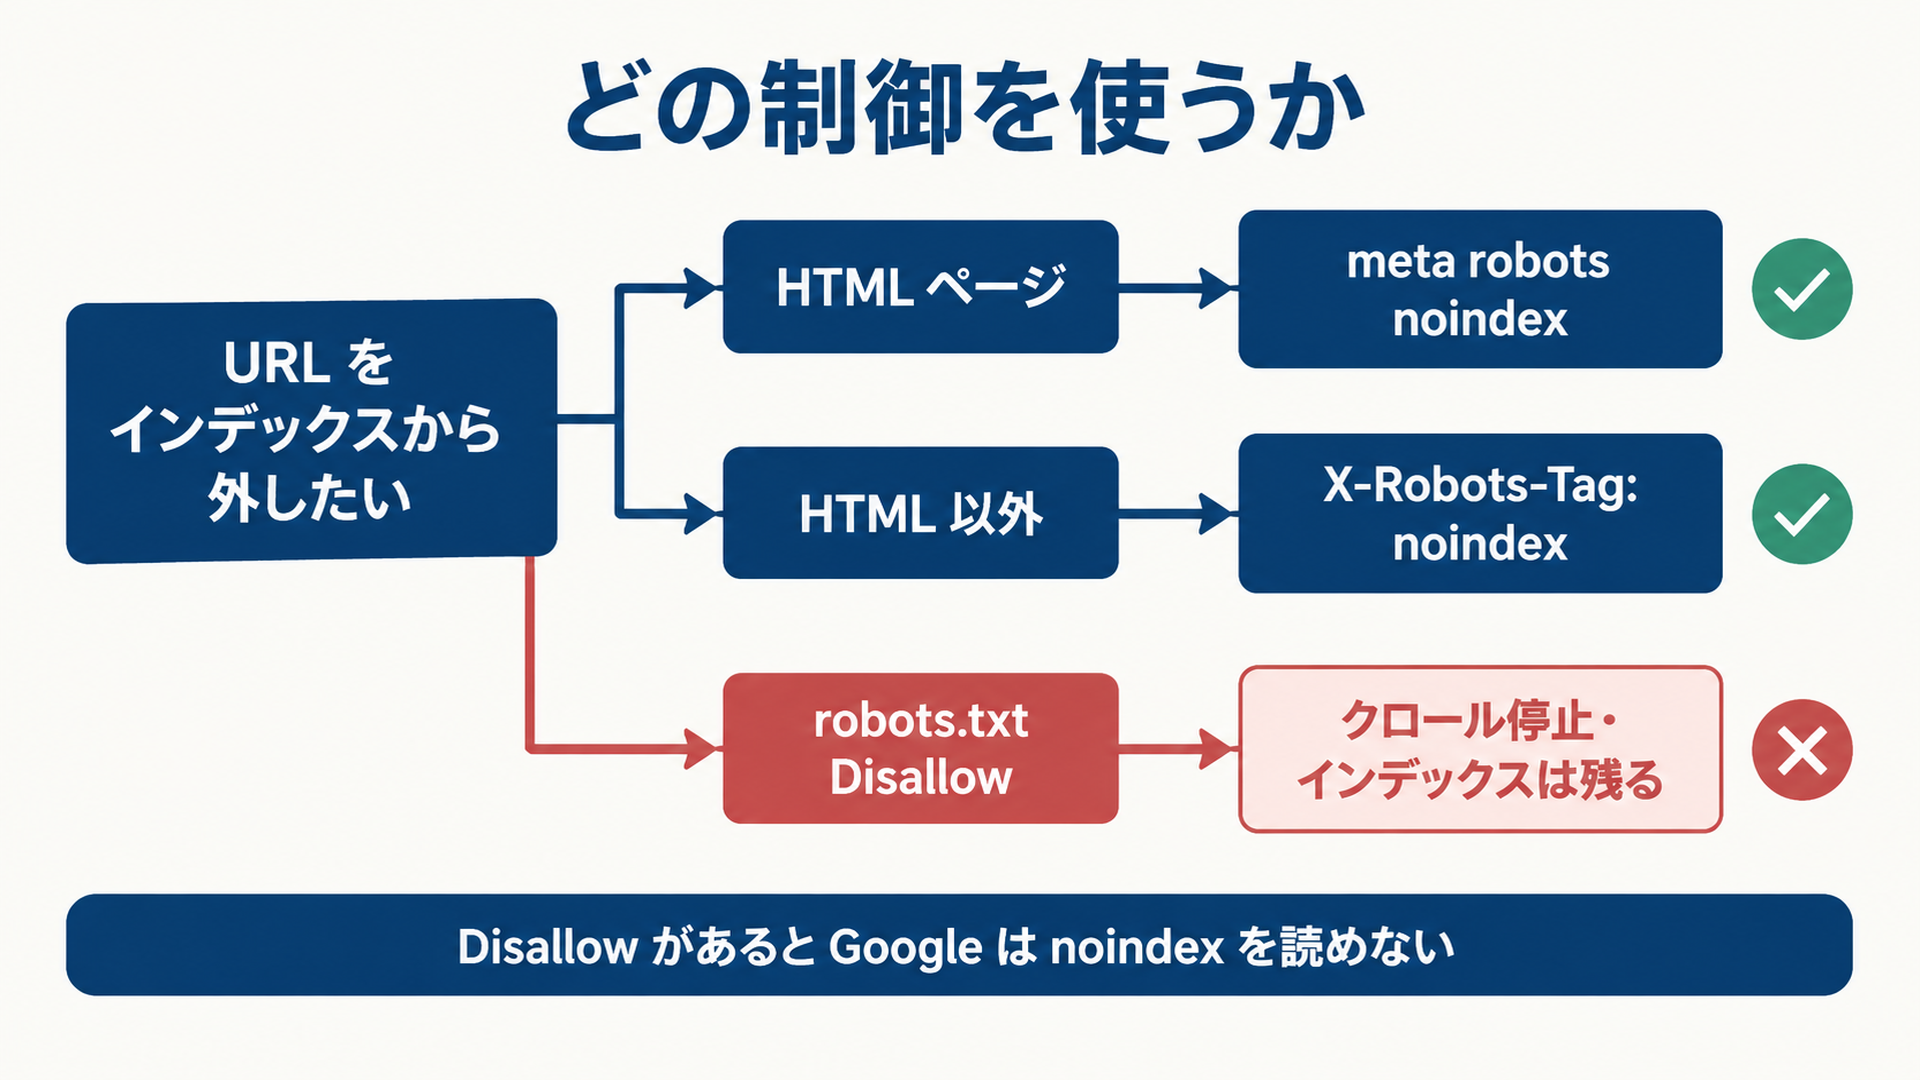
ここが、新しいガイダンスに文字どおり従っても失敗できる箇所です。Google は同じ文の中で 2 つの選択肢を挙げていますが、両者は等価ではありません。
robots.txt はクロールを制御します。URL をインデックスから外すことはできません。Google も robots.txt の導入文でそう述べています。そこに Disallow されたページでも「他のサイトからリンクされていればインデックスに登録される可能性がある」と。その場合、URL と、それを指すアンカー テキストが、説明なしで検索結果に現れることがあります。
noindex はインデックス登録を制御しますが、Google がページを取得してディレクティブを読める場合に限ります。Google の noindex ドキュメントは明確です。ルールを有効にするには、ページが robots.txt でブロックされていてはならない。そうでなければ「クローラは noindex ルールを決して見ない」からです。
この 2 つの事実を合わせると、順序が重要になります。
制御 | URL をインデックスから外すか | 失敗する場所 | 使う場面 |
|---|---|---|---|
| はい。Google がクロールして読んだ後 | robots.txt でブロックされているもの、ログインの背後にあるもの | 非 HTML レスポンス(PDF、JSON、画像)、および多数のルートにまたがるエッジや CDN のルール |
HTML の head にある | はい。Google がクロールして読んだ後 | 読み込み後に JavaScript で挿入されるタグ、robots.txt でブロックされたページ | サーバーサイド レンダリングされた HTML の共有ページ |
| いいえ | リンクされた URL はスニペットなしでインデックスに残りうる | クロール負荷の軽減。プライバシー保護ではない |
ログインまたは署名付き URL | はい。アクセス自体を防ぐことで | ページが本当に非公開である必要がある | 他人のデータを含むすべてのもの |
期限切れ後の 410 | はい。時間をかけて | 404 より遅い。URL が解決する間は何もしない | 一時的な共有とビルド |
避けるべき近道が 1 つ。X-Robots-Tag: none は中立な値ではありません。Google はこれを noindex と nofollow として扱います。意図的に使う場面もありますが、チームはそれを知らずにプロキシ設定からコピーしてしまいます。
避けるべき近道がもう 1 つ。canonical タグです。canonical はヒントです。そのページがインデックスに入るべきでないなら、noindex と書いてください。
ステップ 1:URL を生み出すルートを棚卸しする
列挙していないものは分類できません。そしてほとんどのチームは、ルート パターンではなく機能単位で考えるため、その数を過小評価します。
ルーター、または URL マップを開き、すべての動的セグメントを列挙してください。典型的な該当例は次のとおりです。
/s/:id、/share/:id、/p/:token/chat/:id、/conversation/:id、/thread/:id/u/:handle、/profile/:handle/app/:id、/build/:id、/project/:id/r/:slug、/preview/:token、/report/:id
そのうえで、Google がすでに把握している内容と突き合わせます。コードとインデックスは食い違うからです。
サイトマップから。 取得して中身を数えます。
curl -s https://example.com/sitemap.xml | grep -c "<loc>"
curl -s https://example.com/sitemap.xml | grep -oE "https://[^<]+" | sed -E 's#https://[^/]+##' | cut -d/ -f2 | sort | uniq -c | sort -rn
2 番目のコマンドはパスのプレフィックス別の粗いヒストグラムを与えます。生成ルートがサイトマップに現れているなら、それ自体がバグです。サイトマップは Google にインデックスしてほしいページの一覧だからです。
Search Console から。 [ページのインデックス登録] レポートを開き、候補ルートごとに URL プレフィックスで絞り込んで件数を記録します。Google がそれらの URL を実際にどう扱ったかを教えてくれる唯一の情報源です。
サーバー ログから。 Googlebot のリクエストをプレフィックス別に集計します。
grep -i "Googlebot" access.log | awk '{print $7}' | cut -d/ -f2 | sort | uniq -c | sort -rn | head -20期待される出力。 ルート パターンの一覧と、それぞれの URL 件数。少なくとも 2 つの情報源から得たもの。
品質チェック。 スタッフ以外の訪問者に対して 200 を返しうるルートはすべて一覧に入っているべきです。同じプレフィックスでサイトマップの件数と Search Console の件数が数 % 以上食い違う場合は、何かを変更する前に原因を突き止めてください。
何も見つからない場合。 クライアントサイド ルーターの可能性が高いです。バックエンドではなくフロントエンドでルート定義を検索し、実際の共有リンクでネットワーク タブを確認してください。
ステップ 2:会議ではなく表でルートを分類する
判定はレビューできる場所に書き留めます。ルート パターンごとに 1 行で十分です。
ルート | 作成者 | 発見経路 | 部外者にとっての価値 | 判定 | 制御 | 担当 |
|---|---|---|---|---|---|---|
| 全ユーザー | リンクのみ | なし | noindex | ヘッダー | プラットフォーム |
| 厳選 | 内部リンク、サイトマップ | 高 | index | なし | コンテンツ |
| 全ユーザー | プロフィール リンク | 活性化までは低 | 実績が付くまで noindex | メタタグ | 信頼と安全 |
| 全ユーザー | リンクのみ | なし | noindex | ヘッダー | プラットフォーム |
| 編集者 | サイトマップ | 高 | index | なし | コンテンツ |
この表は 3 つの条件が満たされたときにだけ機能します。
行ごとに担当者を 1 人決めること。担当が曖昧なことが、生成ルートが何年もインデックス可能なまま残る理由です。
制御を後回しにせず、判定の隣に書くこと。「noindex」は、それがヘッダーなのか、テンプレートの変更なのか、CDN のルールなのかを誰かが把握するまでは決定ではありません。
例外を記録すること。ルートが noindex でも、ごく一部だけ公開すべきなら、そのサブセット条件を今書いてください。半年後に例外を後付けするのが、noindex ルールがこっそり全部外される典型的な経路です。
ステップ 3:テンプレートの階層で制御を出荷する
ページ単位の修正は次のデプロイで生き残りません。制御はルートがレンダリングされる場所に適用します。
HTML ページの場合、 タグはサーバーサイド レンダリングされた head に置きます。Next.js の App Router ではメタデータ、Astro ではレイアウトの head、Rails や Django ではレイアウト テンプレートです。正確な構文よりも場所が重要です。Google が受け取る HTML に含まれていなければならず、クライアントサイドの副作用で追加されてはいけません。
<meta name="robots" content="noindex">HTML でないものについては、 メタタグは存在しないのでヘッダーを使います。
X-Robots-Tag: noindexこれで PDF のエクスポート、JSON レスポンス、生成画像、CSV ダウンロードがカバーされます。それらのファイルが CDN から配信されている場合は、新しいルートが自動的に継承するようエッジでヘッダーを設定してください。
ルート ファミリー全体については、 通常はすべてのテンプレートに触るよりミドルウェアのルールのほうがすっきりします。
// Express の例: 生成された共有 URL をすべて noindex にする
app.use(['/s', '/share', '/report'], (req, res, next) => {
  res.set('X-Robots-Tag', 'noindex');
  next();
});
期待される出力。 noindex と記したすべてのルートが、匿名リクエストに対して最初のバイトでディレクティブを返すデプロイ。
品質チェック。 公開 URL に対して curl -sI を実行します。レスポンス ヘッダーに x-robots-tag: noindex が見えるはずで、curl -s でスクリプトが動く前のソースにメタタグが見えるはずです。
復旧手順。 タグが JavaScript の実行後にしか現れないなら、サーバー レンダリングに移してください。フレームワークがルートごとの head タグのレンダリングに対応していない場合は、代わりにヘッダーを使ってください。JS で挿入した noindex を出荷して動くと仮定しないこと。Google はレンダリング後の noindex の挙動を明確に定義されていないと説明しています。
同じプルリクエストに入れるべきものがもう 2 つあります。noindex ルートをサイトマップから削除すること。インデックスされたくない URL を送信するのは矛盾であり、Google はその矛盾を自分に有利に解決します。そして有効期限のルールを追加すること。共有リンクが切れたら、空の状態のまま 200 のページを残すのではなく 410 を返してください。
ステップ 4:Googlebot がディレクティブを見られるか検証する
ここまでのすべては、Google と同じ方法で確認するまで未検証です。
まずレスポンス ヘッダーを確認します。
curl -sI https://example.com/s/abc123 | grep -i x-robots-tag次に、スクリプトが動く前の初期 HTML を確認します。
curl -s https://example.com/s/abc123 | grep -i 'name="robots"'最後に、robots.txt がそのパスをブロックしていないことを確かめます。ブロックしていれば、Google はページを取得せず、ディレクティブも読みません。
curl -s https://example.com/robots.txt最終確認は Search Console です。[URL 検査] でその URL をリクエストし、判定を読みます。
正しい結果は「ページはインデックスに登録されていません: 'noindex' タグにより除外されました」です。罠にはまっていることを示す結果は「robots.txt によりブロックされましたが、インデックスに登録されました」です。Google は URL を把握しているがディレクティブを読めず、配信を続ける可能性があります。これが出たら robots.txt のルールを外し、noindex に仕事をさせてください。
クローラ シミュレータを使えば、Googlebot から見たページを取得することもできます。20 本のルートを確認するときに再クロールを待つより速い方法です。Googlebot Spider Simulator。
期待される出力。 次のクロールから数日以内に、noindex のすべてのルートが noindex による除外状態を示す。変更後に作られたルートはそもそもインデックスに現れない。
復旧手順。 2 週間経っても URL がインデックスに残る場合は、Google がその URL を取得できるか、Googlebot に対して 200 を返しているか、canonical や hreflang タグが検索エンジンを別の場所に向けていないかを確認してください。削除ツールは原因を直す間の一時的なブロックにのみ使い、ディレクティブの代わりにはなりません。
共有ページが成長チャネルである場合
インデックスされるべき生成ページもあり、一律の noindex は自らを傷つける行為になります。守る価値のあるのは次のようなものです。
パターン | インデックスに値する理由 | ガードレール |
|---|---|---|
公開テンプレート ギャラリー | ユーザーがデザインを公開し、他の人が再利用する。出力は独自で長持ちする | 新規投稿をモデレーションする |
公開ショーケース ページを持つビルダー | 「built with」クレジット付きの実物は流通チャネルになる | ショーケースのテンプレートをマーケティング ページと分けておく |
ユーザーのスレッドから育つドキュメント | 繰り返し出る質問には、恒久的で編集された回答が値する | 厳選された回答をインデックスし、生の会話はそうしない |
これらのカテゴリのいずれかに当てはまるなら、Google の以前の助言が引き続き有効で、そちらのほうが効きます。実績のないユーザーのコンテンツを noindex にし、アカウントに履歴ができたら解除する。これで獲得ループを手放さずにスパム耐性が得られます。今回の更新前からガイドが勧めていたパターンです。
3 つすべてに共通するテストは同じです。部外者が入力しそうなクエリで検索パフォーマンスに表示回数が付くなら、それはインデックスに入るべきです。自分自身の URL 文字列だけでしか表示回数が付かないなら、入るべきではありません。
二次的な効果にも触れておきます。公開共有 URL は何年も前から安価なリンク面でした。ドメインの強いプラットフォームでページを作り、自分のサイトへのリンクを置き、それを 20 の物件で繰り返す。Patrick Stox は同じスレッドで、異なるプラットフォームから 20 以上のリンクを数えていました。プラットフォームがガイダンスに従えば、この面は狭まります。従わなければ、Google は次にそれらのページをスパムと判断するときに引用できる文書を手に入れたことになります。
ステップ 5:Google が示したパターンを計測する
監視のセクションは、多くのチームが飛ばす部分であり、本物のインシデントが手動措置になる前に捕まえる部分でもあります。
4 つのチェックと、それぞれの確認場所です。
Search Console の所有権確認。 サイトまたはサブドメインを確認し、手動措置とセキュリティのアラートがメールで届くようにします。テナントごとにサブドメインを発行するプラットフォームを運営しているなら、親と少なくとも一部の子プロパティを確認してください。どこにも届かないアラートは監視ではありません。
ページのインデックス登録の推移。 生成ルートごとのインデックス済み URL 数を今日ベースライン化し、ノイズではなく段階的な変化を監視します。本来静的であるべきルートで 1 週間にインデックス済み URL が倍になったら、それがシグナルです。
検索パフォーマンスの異常。 プロダクトと無関係なクエリで絞り込みます。スパム ページは、誰かが通報するずっと前にスパム クエリを引き寄せます。
作成数とインデックス数の比率。 これが Google が名指しした指標であり、ほとんど誰も追跡していない指標です。1 つのアカウントが 1 日に生成できるインデックス可能 URL は何本か、新しいインデックス可能 URL のうち上位 1% のアカウントが占める割合はどれか。単一アカウントについて直近 7 日間の中央値の 3 倍でアラートを出す、という出発点は恣意的ですが実用的です。自社のトラフィックに合わせて調整してください。
同じ比率はプロダクトのガードレールとしても機能します。ある機能が 1 ユーザーに 1 日 1,000 本のインデックス可能 URL を生成させるなら、まだ誰も悪用していなくても、それはインデックス肥大化機能です。
今回の更新が本当に言っていること
文言を剥がすと、Google は供給についての議論をしています。
20 年間、スパム ポリシーはページを記述してきました。薄い、スクレイピング、クローキング、キーワード詰め込み。それらのカテゴリは、人間かスクリプトがページを作ることを決め、Google がそれがランクに値するかを決める、という前提に立っています。生成された出力はそのモデルを壊します。1 つのプロダクト判断が 100 万本の URL を生み、そのすべてが技術的にはユニークで、技術的には 200 を返し、その大半が作成者以外には無価値です。Google はそれらを 1 本ずつ評価できませんし、できるふりをやめました。
反応は 2 つの陣営に落ち着きました。1 つは警告射撃と読みました。Marie Haynes は AI ツールやアプリ ビルダーに対する新しい手動措置が続くのかと問い、Lily Ray はこのセクションを、Google がすでに大規模に戦っているものについてのシグナルとして扱い、Claude のアーティファクト、ChatGPT の共有ページ、ソーシャル投稿を名指ししました。もう 1 つは肩をすくめました。慎重なチームは何年も前からユーザー生成レポートを noindex にしてきた、という返信が複数あり、Google 自身の生成ページこそがより大きな問題だとも言われました。どちらの読み方も真になりえます。このガイダンスが重要なのは、助言が新しいからではなく、執行が指し示せる場所に今書かれたからです。
つまりガイダンスは判断を上流に移します。プラットフォームは今、あるクラスの URL がインデックスに入るべきかをテンプレートの階層で決めることを期待されています。これはガバナンスの問いであり、SEO の問いではありません。だから助言がインデックス登録のドキュメントではなくスパム ガイドに置かれているのです。
AI 検索についても、同じ論理が双方向に当てはまります。Google の AI 機能は Google のインデックスを引くので、noindex ディレクティブは青いリンクからだけでなく、そのプールからもページを外します。生成ページが AI Overview で引用を獲得していたなら、それは止まる見込みです。共有リンクにとっては通常正しく、テンプレート ページにとっては通常誤りです。他の AI クローラは独自のルールに従うので、それらにページを取得させたいかは別途決めてください。
実務的な持ち帰りは、デザイン レビューにそのまま置ける 1 文です。ユーザーが作成できるすべての URL は、プロダクトの面かインデックスの負債のどちらかであり、どちらになるかはテンプレートが決める。
FAQ
通常のマーケティング サイトにも当てはまりますか?
ユーザー入力から URL を生成していない限り、当てはまりません。マーケティング サイトは、人が存在すべきと決めたページ群を公開するもので、ガイドが説明する問題とは正反対です。適用範囲の行は、共有ページ、生成コンテンツ、ウェブアプリをユーザーが公開できるようにするホスティング プラットフォームとツールを名指ししています。コメント欄、フォーラム、会員プロフィールを運営しているなら、以前の助言が当てはまります。信頼できないアカウントからのリンクに nofollow または ugc を付け、実績を積むまでの新規ユーザーは noindex にすることです。
robots.txt と noindex タグのどちらを使うべきですか?
noindex です。そして、あるルートではどちらか一方だけを使ってください。Google の文は両方の選択肢を挙げていますが、役割が違います。robots.txt の Disallow はクロールを止め、ブロックされていても他所からリンクされている URL はスニペットなしで結果に残りえます。noindex は Google がページを取得して読める場合にのみ機能します。実際にはメタタグかレスポンス ヘッダーであり、同じパスに robots.txt のルールを置いてはいけません。
共有ページを noindex にするとトラフィックを失いますか?
決める前に、決定した後ではなく、ルートを確認してください。ページが自分自身の URL 文字列だけでしか表示回数を得ていないなら、オーガニック トラフィックを生んでおらず、外しても失うものはありません。トラフィックを失うパターンは、公開ギャラリーをその中の出力ごと撤去することです。ギャラリーはインデックス可能なままにし、その背後にあるものを noindex にし、ギャラリーのクエリについて変更前後で検索パフォーマンスを確認してください。
AI 検索エンジンは noindex を尊重しますか?
Google の AI 機能は尊重します。AI Overview と AI モードは同じインデックスを引くので、ディレクティブは青いリンクからも AI の回答からもページを外します。他の AI クローラは別の判断です。ベンダーの挙動は異なり、変更履歴なしに変わります。それぞれのクローラのドキュメントを読み、1 つのディレクティブですべてをカバーできると仮定せず、そのクローラのユーザー エージェントでページを取得して確認してください。
著者: Grace Miller、Auspia の AI 検索リスク アナリスト。200 以上のポリシー変更を追跡。プラットフォームのルール、コンテンツ リスク、ポリシーを踏まえた最適化について執筆しています。