La règle que Google vient d'écrire
Le 26 octobre 2026, Google a ajouté une section de deux paragraphes à son guide sur la façon d'éviter le spam généré par les utilisateurs. C'est la partie la plus courte de la page et probablement celle qui va changer le plus de feuilles de route produit, parce qu'elle pose une question que la plupart des équipes n'ont jamais mise sur une slide : cette URL a-t-elle sa place dans l'index Google ?
La section s'intitule « Only index content meant for Search » — n'indexez que le contenu destiné à la recherche. Traduite, elle dit ceci :
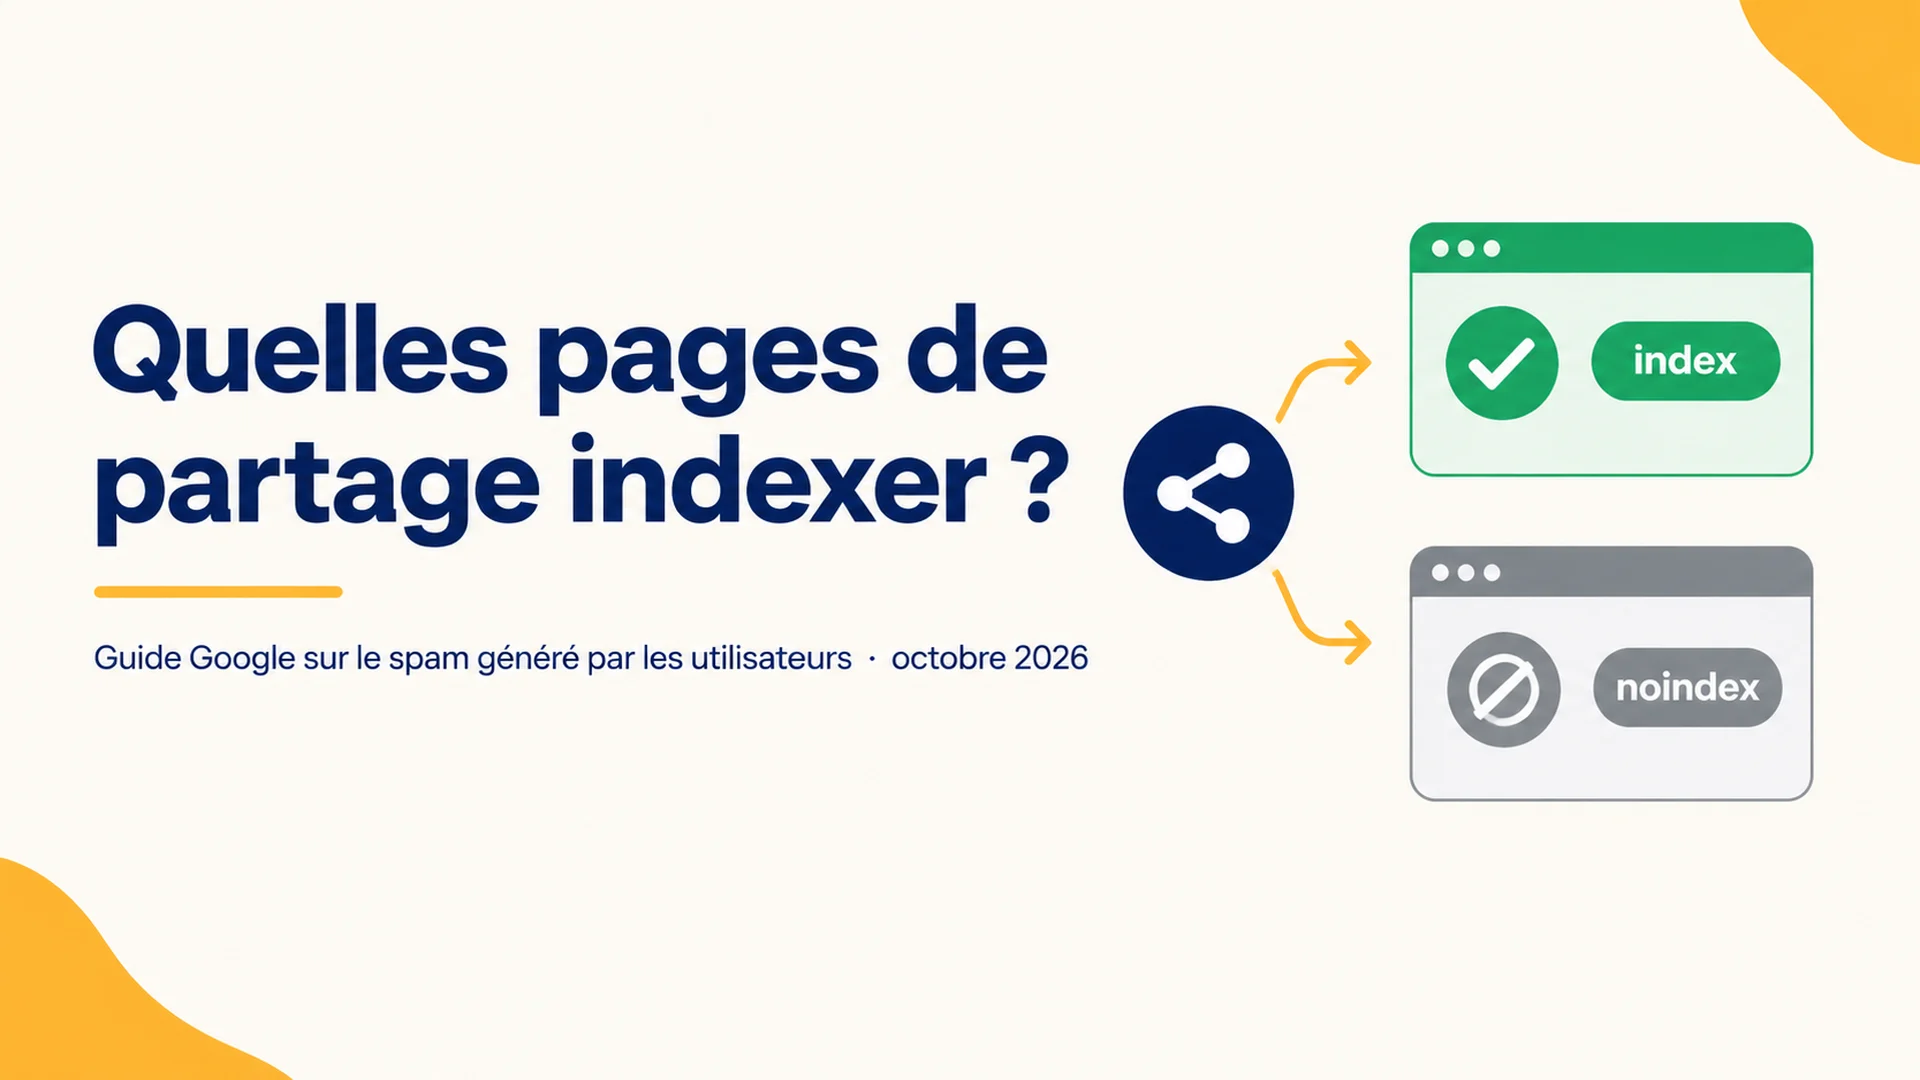
Si votre service permet aux utilisateurs de créer des pages partageables, des résultats générés ou des outils interactifs, demandez-vous si ce contenu est destiné à être trouvé par les moteurs de recherche ou seulement à être ouvert directement par la personne qui détient le lien.
Lorsque les pages sont créées pour un partage direct, la collaboration ou l'utilité, et non pour être découvertes dans une recherche publique, appliquez la règle noindex par défaut (avec une balise meta robots ou l'en-tête HTTP X-Robots-Tag) ou bloquez l'exploration dans le robots.txt.
Le journal des modifications de Google, le même jour, est plus explicite sur l'intention : le guide a été enrichi de « conseils sur la façon de bloquer l'indexation du contenu partagé par lien et de surveiller les abus dans la Search Console », afin que les plateformes puissent « garder hors de l'index les pages créées par les utilisateurs qui ne sont pas destinées à la recherche et détecter le spam plus tôt ».
C'est tout. Aucune nouvelle action manuelle, aucune annonce de système de classement, aucune liste de sanctions. Il y a une recommandation de valeur par défaut — et c'est des valeurs par défaut que naissent presque tous les accidents d'indexation.
À qui cela s'adresse. Aux équipes qui publient n'importe quelle URL qu'un utilisateur peut générer : liens de partage, conversations sauvegardées, tableaux de bord publics, aperçus de modèles, builds d'applications, rapports générés, fils de forum, pages de profil, pages d'avis, pages d'annonces.
Ce que vous obtenez. Un verdict par route pour chaque type d'URL générée, le contrôle qui retire réellement la page de l'index, et une règle de surveillance qui capte le schéma d'abus décrit par Google.
Durée. De 45 à 90 minutes pour une première passe sur un produit. Une journée si vous avez plusieurs générateurs d'URL et aucun inventaire des routes.
À quoi ressemble « terminé ». Chaque route générée est marquée index, noindex ou privée. Les routes noindex renvoient la directive depuis le serveur, pas après l'exécution de JavaScript. La Search Console affiche ces URL comme exclues par noindex, et non comme « Indexée, malgré le blocage par robots.txt ».
Ce qui a changé, et ce qui ne fait qu'en avoir l'air
Quatre modifications comptent. Le reste de la page n'a pas bougé, y compris les conseils de décembre 2025, qui restent valables.
Ce que Google a changé | Le texte réel | Pourquoi cela vous concerne |
|---|---|---|
Périmètre du guide | Il nomme désormais les plateformes d'hébergement « et les outils qui permettent aux utilisateurs de publier des pages partagées, du contenu généré ou des applications web » | Au pied de la lettre, cela couvre les exports de chat IA, les pages d'artefacts, les constructeurs d'applications et les outils no-code, pas seulement les forums et les commentaires |
Unité de l'abus | Les spammeurs peuvent créer « un grand nombre de pages ou de sites » | Google parle de volume, pas d'astuce. Un compte abusif peut frapper des milliers d'URL |
Section nouvelle | « Only index content meant for Search » | C'est l'affirmation la plus claire à ce jour que noindex est une valeur par défaut raisonnable pour du contenu accessible uniquement par lien |
Surveillance | Vérifier le site ou le sous-domaine dans la Search Console, suivre les pics dans l'indexation des pages et les performances de recherche, alerter quand « peu d'utilisateurs » produisent « une grande partie des URL indexables » | Le gonflement de l'index dispose désormais d'une méthode de détection nommée — et c'est généralement ce qui précède une forme de révision |
Ce qui n'a pas changé : le noindex sur les publications des nouveaux utilisateurs jusqu'à ce qu'ils acquièrent une réputation, et nofollow ou ugc sur les liens dans du contenu peu fiable. Si vous faites déjà les deux, vous êtes en avance sur cette mise à jour.
Il faut le dire clairement, parce que la réaction sur X a devancé le document : ce sont des conseils destinés aux plateformes, à propos de leur propre stock d'URL. Ils ne créent pas de nouvelle infraction pour un site marketing ordinaire et ne modifient le classement d'aucune page. Ils modifient ce qui devrait exister dans l'index.
Un autre élément de contexte explique le moment. Fin juillet 2026, les liens de partage et les pages d'artefacts de Claude sont apparus dans l'index Google, et les articles de l'époque décrivaient des dossiers médicaux, des clés d'API et d'autres documents privés exposés avant qu'Anthropic ne referme la faille en quelques jours. La même couverture signalait des URL publiques d'applications chez des constructeurs comme Replit et Lovable. Google écrit rarement une nouvelle section pour une hypothèse. Celle-ci s'était déjà produite.
La question qui tranche pour chaque URL générée
Le test de Google tient en une phrase, et on peut l'appliquer sans deviner les intentions : ce contenu est-il destiné à être trouvé par les moteurs de recherche, ou seulement à être ouvert par la personne qui détient le lien ?
En pratique, quatre signaux répondent. Évaluez la route, pas la page individuelle.
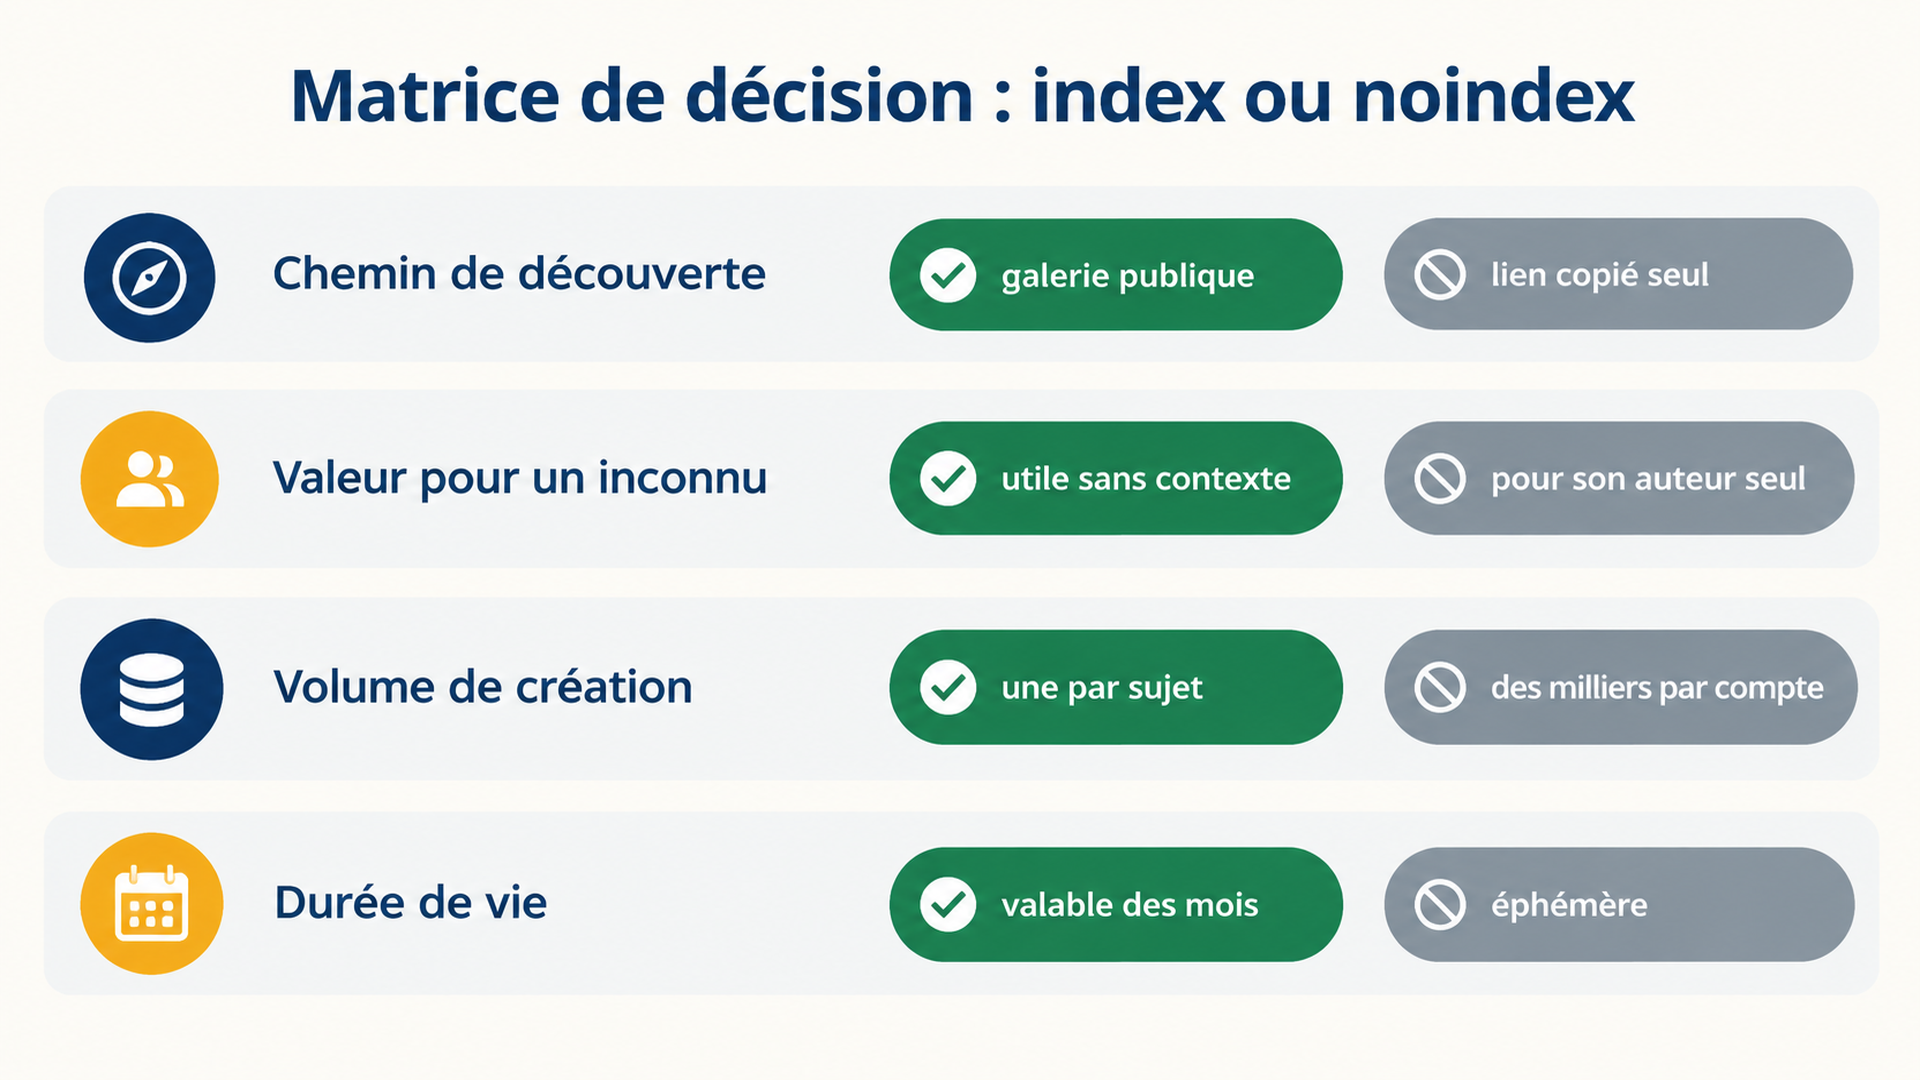
Signal | Pousse à indexer | Pousse à noindex |
|---|---|---|
Chemin de découverte | Liée depuis une galerie publique, un sitemap, une page de catégorie ou un profil | Atteignable uniquement par un lien copié ou un bouton de partage |
Valeur pour un inconnu | Utile sans connaître la personne qui l'a créée | N'a de sens que pour le créateur, son équipe ou le destinataire |
Volume de création | Une page par sujet, ou un ensemble éditorialisé | Des milliers d'URL issues d'un compte, pour la plupart quasi identiques |
Durée de vie | Reste exacte pendant des mois | Éphémère : une conversation, un build, un brouillon, un export temporaire |
Trois signaux sur quatre en faveur du noindex, le verdict est net. Un résultat mitigé signifie généralement que la route doit être scindée : une galerie publique indexable, et en dessous les résultats individuels, qui ne le sont pas. Cette séparation est la bonne réponse la plus courante, et aussi la plus souvent sautée, parce qu'elle demande deux gabarits au lieu d'un drapeau.
Un test de rejet utile : si un inconnu voyait cette URL dans un résultat de recherche sans contexte, le titre et l'extrait auraient-ils un sens ? « Conversation avec Sam, 24 oct. » n'en a pas. « Modèle de facture pour designers indépendants » en a un. Le rejet ne porte pas sur la qualité. Il porte sur le fait que la page a été faite pour être trouvée ou faite pour être envoyée.
Choisissez un contrôle qui retire vraiment l'URL
C'est ici qu'on peut suivre le nouveau conseil à la lettre et échouer malgré tout. Google propose deux options dans la même phrase, et elles ne sont pas équivalentes.
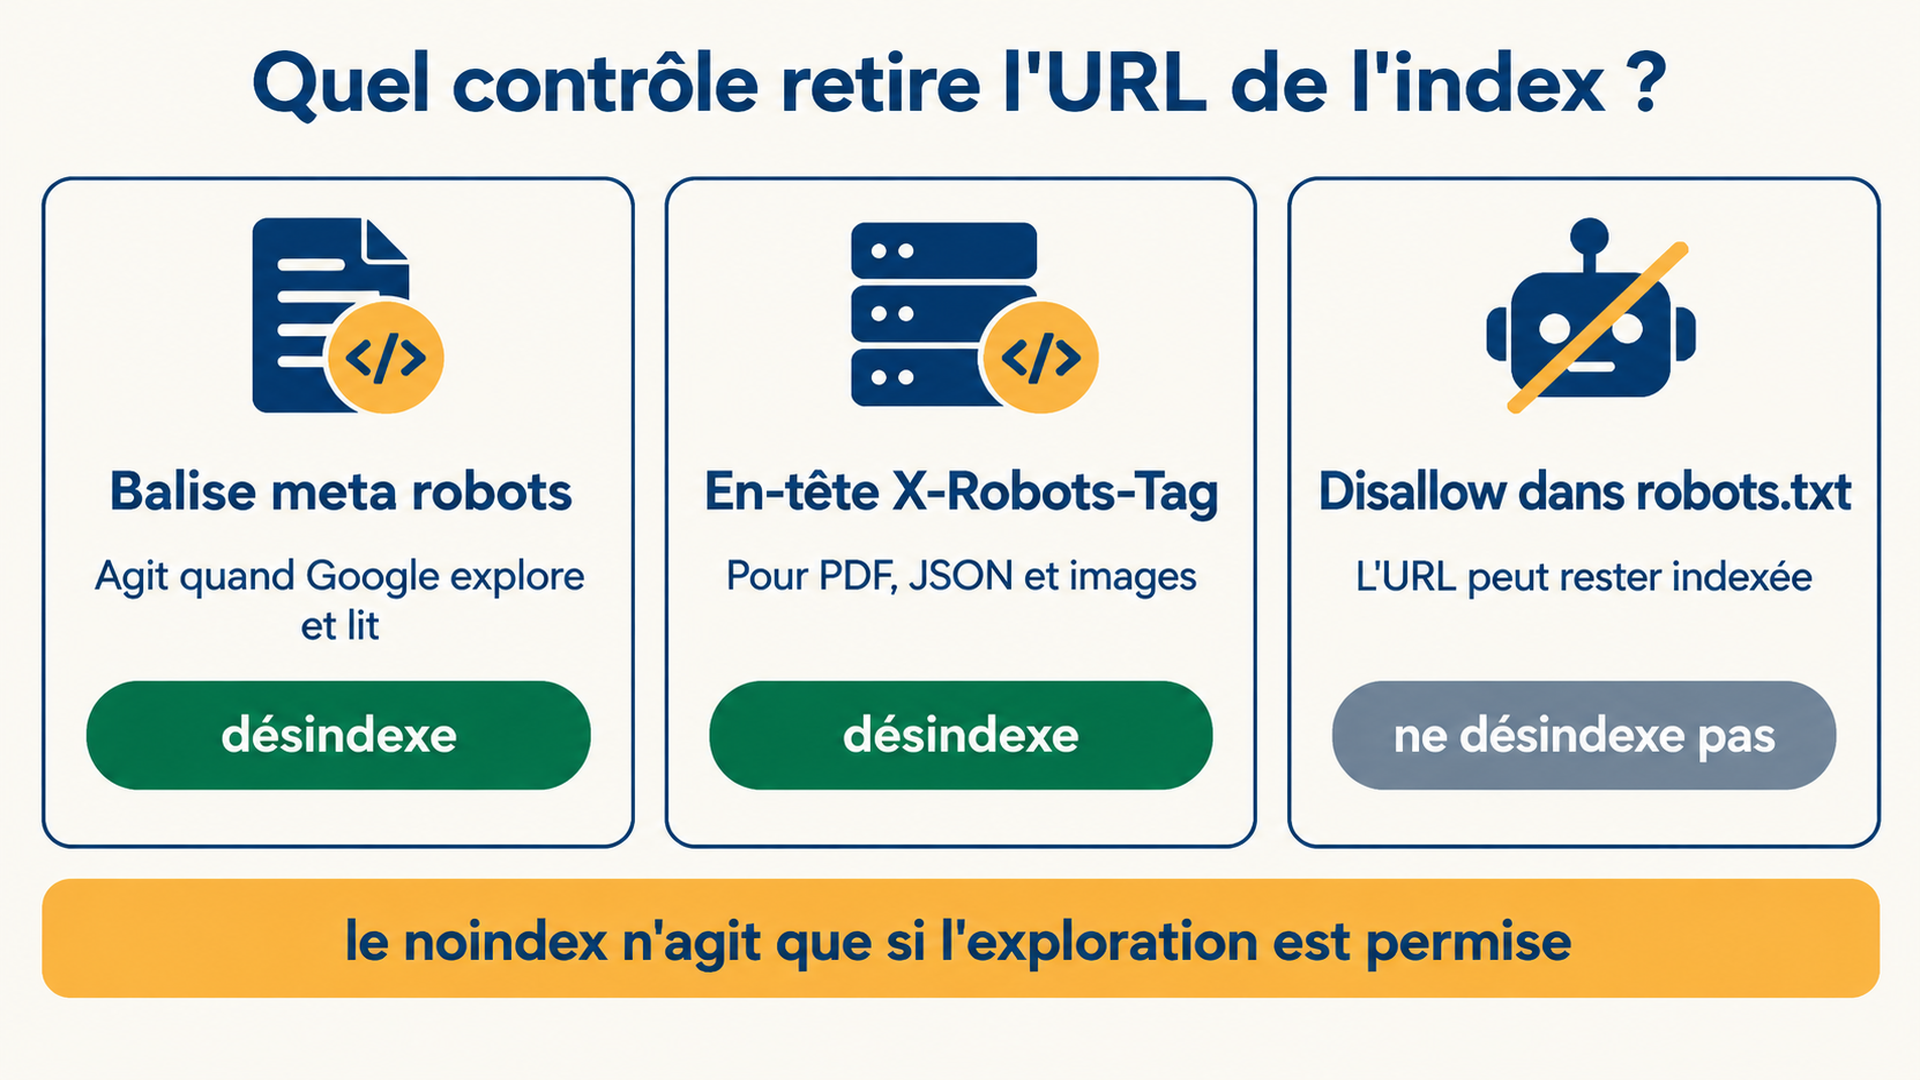
Le robots.txt contrôle l'exploration. Il ne retire pas une URL de l'index, et Google le dit lui-même dans l'introduction du robots.txt : une page bloquée de cette manière « peut rester indexée si des liens d'autres sites pointent vers elle » — et dans ce cas, l'URL et éventuellement le texte d'ancre peuvent apparaître dans les résultats sans description.
Le noindex contrôle l'indexation, mais seulement si Google peut explorer la page et lire la directive. La documentation noindex de Google est explicite : pour que la règle fonctionne, la page ne doit pas être bloquée par le robots.txt, car sinon « l'explorateur ne verra jamais la règle noindex ».
Croisez les deux faits et l'ordre devient déterminant.
Contrôle | Retire l'URL de l'index | Où il échoue | À utiliser pour |
|---|---|---|---|
En-tête de réponse | Oui, une fois que Google explore et lit | Tout ce qui est bloqué par le robots.txt ou derrière une connexion | Réponses non HTML (PDF, JSON, images) et règles edge ou CDN pour de nombreuses routes |
| Oui, une fois que Google explore et lit | Balises injectées par JavaScript après le chargement ; pages bloquées par le robots.txt | Pages de partage HTML rendues côté serveur |
Disallow dans le | Non | Une URL liée peut rester indexée sans extrait | Réduire la charge d'exploration, pas la confidentialité |
Connexion ou URL signée | Oui, en empêchant l'accès | Exige que la page soit réellement privée | Tout ce qui contient les données d'autres personnes |
410 après expiration | Oui, avec le temps | Plus lent que le 404 ; sans effet tant que l'URL répond encore | Partages et builds éphémères |
Un raccourci à éviter : X-Robots-Tag: none n'est pas une valeur neutre. Google le traite comme noindex plus nofollow. C'est parfois ce que vous voulez, mais les équipes le copient d'une configuration de proxy sans le savoir.
Deuxième raccourci à éviter : les balises canonical. Un canonical est une indication. Si la page n'a pas sa place dans l'index, écrivez noindex.
Étape 1 : inventoriez les routes qui créent des URL
On ne peut pas classer ce qui n'est pas listé, et la plupart des équipes sous-estiment le décompte parce qu'elles pensent en fonctionnalités plutôt qu'en schémas de route.
Ouvrez le routeur, ou la carte des URL, et listez chaque segment dynamique. Les suspects habituels ressemblent à ceci :
/s/:id,/share/:id,/p/:token/chat/:id,/conversation/:id,/thread/:id/u/:handle,/profile/:handle/app/:id,/build/:id,/project/:id/r/:slug,/preview/:token,/report/:id
Confrontez ensuite cela à ce que Google sait déjà, car le code et l'index vont diverger.
Via le sitemap. Téléchargez et comptez :
curl -s https://example.com/sitemap.xml | grep -c "<loc>"
curl -s https://example.com/sitemap.xml | grep -oE "https://[^<]+" | sed -E 's#https://[^/]+##' | cut -d/ -f2 | sort | uniq -c | sort -rn
La seconde commande donne un histogramme approximatif par préfixe de chemin. Si une route générée figure dans votre sitemap, c'est déjà un bug : un sitemap est une liste de pages que vous demandez à Google d'indexer.
Via la Search Console. Ouvrez le rapport sur l'indexation des pages, filtrez par préfixe d'URL pour chaque route candidate et notez les chiffres. C'est la seule source qui dit ce que Google a réellement fait de ces URL.
Via les logs serveur. Regroupez les requêtes Googlebot par préfixe :
grep -i "Googlebot" access.log | awk '{print $7}' | cut -d/ -f2 | sort | uniq -c | sort -rn | head -20Résultat attendu. Une liste de schémas de route avec un nombre d'URL à côté de chacun, issue d'au moins deux sources.
Contrôle qualité. Toute route susceptible de renvoyer un 200 à un visiteur hors équipe doit figurer sur la liste. Si les décomptes du sitemap et de la Search Console divergent de plus de quelques pour cent sur le même préfixe, comprenez pourquoi avant de changer quoi que ce soit.
Si vous ne trouvez rien. Vous avez probablement un routeur côté client. Cherchez les définitions de route dans le frontend plutôt que dans le backend, et regardez l'onglet réseau sur un vrai lien de partage.
Étape 2 : classez chaque route dans un tableau, pas en réunion
Écrivez le verdict là où quelqu'un peut le relire. Une ligne par schéma de route suffit.
Route | Créée par | Chemin de découverte | Valeur pour un inconnu | Verdict | Contrôle | Responsable |
|---|---|---|---|---|---|---|
| Tout utilisateur | Lien seul | Aucune | noindex | En-tête | Plateforme |
| Éditorialisation | Liens internes, sitemap | Élevée | index | Aucun | Contenu |
| Tout utilisateur | Liens de profil | Faible tant qu'inactif | noindex jusqu'à réputation | Meta | Confiance et sécurité |
| Tout utilisateur | Lien seul | Aucune | noindex | En-tête | Plateforme |
| Rédaction | Sitemap | Élevée | index | Aucun | Contenu |
Le tableau ne fonctionne que si trois choses sont vraies.
Une personne responsable par ligne. Une propriété floue est la raison pour laquelle les routes générées restent indexables pendant des années.
Écrivez le contrôle à côté du verdict, pas après. « noindex » n'est pas une décision tant que personne ne sait si cela signifie un en-tête, une modification de gabarit ou une règle CDN.
Notez l'exception. Si une route est en noindex mais qu'un petit sous-ensemble devrait être public, écrivez la condition de ce sous-ensemble maintenant. Faire le tri six mois plus tard, c'est ainsi qu'une règle de noindex finit par être supprimée entièrement, en silence.
Étape 3 : déployez le contrôle au niveau du gabarit
Les corrections page par page ne survivent pas au déploiement suivant. Appliquez le contrôle là où la route est rendue.
Pour les pages HTML, placez la balise dans le head rendu côté serveur. Dans l'App Router de Next.js, ce sont les metadata ; dans Astro, le head du layout ; dans Rails ou Django, le gabarit de layout. La syntaxe exacte compte moins que l'endroit : elle doit figurer dans le HTML que Google reçoit, pas être ajoutée par un effet côté client.
<meta name="robots" content="noindex">Pour tout ce qui n'est pas du HTML, il n'existe pas de balise meta, donc utilisez l'en-tête :
X-Robots-Tag: noindexCela couvre les exports PDF, les réponses JSON, les images générées et les téléchargements CSV. Si ces fichiers sont servis par un CDN, définissez l'en-tête en périphérie pour que les nouvelles routes héritent de la règle.
Pour une famille entière de routes, une règle de middleware est souvent plus propre que de toucher chaque gabarit :
// Exemple Express : noindex sur toutes les URL de partage générées
app.use(['/s', '/share', '/report'], (req, res, next) => {
  res.set('X-Robots-Tag', 'noindex');
  next();
});
Résultat attendu. Un déploiement où chaque route marquée noindex renvoie la directive dès le premier octet, pour les requêtes anonymes.
Contrôle qualité. Lancez curl -sI sur l'URL publiée. Vous devriez voir x-robots-tag: noindex dans les en-têtes de réponse, et curl -s devrait montrer la balise meta dans le code source, avant l'exécution du moindre script.
Voie de secours. Si la balise n'apparaît qu'après l'exécution de JavaScript, déplacez-la vers le rendu côté serveur. Si le framework ne rend pas de balises head par route, utilisez l'en-tête. Ne publiez pas un noindex injecté en JS en supposant qu'il fonctionne : Google décrit le comportement du noindex rendu comme mal défini.
Deux autres choses appartiennent à la même pull request. Retirez les routes noindex du sitemap, car soumettre une URL que vous ne voulez pas voir indexée est une contradiction que Google tranche en sa faveur. Et ajoutez une règle d'expiration : quand un lien de partage meurt, renvoyez 410 au lieu de conserver une page 200 à l'état vide.
Étape 4 : vérifiez que Googlebot voit la directive
Rien de tout cela n'est vérifié tant que vous ne le contrôlez pas comme Google le fait.
Regardez d'abord les en-têtes de réponse :
curl -sI https://example.com/s/abc123 | grep -i x-robots-tagPuis le HTML initial, avant qu'un script ait pu s'exécuter :
curl -s https://example.com/s/abc123 | grep -i 'name="robots"'Enfin, assurez-vous que le robots.txt ne bloque pas le chemin. S'il le bloque, Google n'explorera jamais la page et ne lira jamais la directive :
curl -s https://example.com/robots.txtLa Search Console est le contrôle final. Demandez l'inspection de l'URL dans « Inspection d'URL » et lisez le verdict.
Le résultat correct est « Page non indexée : exclue par la balise "noindex" ». Le résultat qui montre que vous êtes tombé dans le piège est « Indexée, malgré le blocage par robots.txt » — Google a l'URL, ne peut pas lire la directive et peut continuer à l'afficher. Si cela apparaît, retirez la règle du robots.txt et laissez le noindex faire le travail.
Vous pouvez aussi récupérer la page telle que Googlebot la voit avec un simulateur d'explorateur, plus rapide qu'attendre une nouvelle exploration quand vous vérifiez vingt routes : Googlebot Spider Simulator.
Résultat attendu. Chaque route noindex affiche le statut d'exclusion par noindex quelques jours après l'exploration suivante. Les routes créées après la modification ne devraient pas apparaître du tout dans l'index.
Voie de secours. Si une URL reste indexée après deux semaines, vérifiez que Google peut l'explorer, que la page renvoie un 200 à Googlebot et qu'aucune balise canonical ou hreflang n'envoie les moteurs de recherche ailleurs. Utilisez l'outil de suppressions seulement comme blocage temporaire le temps de corriger la cause ; il ne remplace pas la directive.
Quand la page de partage est le canal de croissance
Certaines pages générées doivent être indexées, et mettre noindex partout serait se tirer une balle dans le pied. Voici celles qui méritent d'être protégées :
Schéma | Pourquoi il mérite l'index | Garde-fou |
|---|---|---|
Galeries publiques de modèles | Les utilisateurs publient un design, d'autres le réutilisent ; le résultat est unique et durable | Modérer les nouvelles soumissions |
Constructeurs avec pages vitrines publiques | Un résultat réel avec un crédit « built with » est un canal de distribution | Garder le gabarit vitrine séparé de la page marketing |
Documentation qui grandit à partir de fils d'utilisateurs | Une question récurrente mérite une réponse permanente et éditée | Indexer la réponse éditée, pas la conversation brute |
Si vous êtes dans l'une de ces catégories, le conseil plus ancien de Google reste valable et constitue le meilleur levier : noindex sur le contenu des utilisateurs sans réputation, puis ouverture quand le compte a un historique. Cela apporte une résistance au spam sans abandonner la boucle d'acquisition, et c'est le schéma que le guide recommandait avant cette mise à jour.
Le test est le même pour les trois. Si la page gagne des impressions dans les performances de recherche pour des requêtes qu'un inconnu taperait, elle appartient à l'index. Si elle ne gagne des impressions que sur sa propre chaîne d'URL et rien d'autre, elle n'y appartient pas.
Il y a un effet de second ordre à nommer. Les URL de partage publiques ont longtemps été une surface de liens bon marché : créer une page sur une plateforme à forte autorité de domaine, pointer un lien vers son propre site, répéter sur vingt propriétés. Patrick Stox a compté plus de 20 liens de plateformes différentes dans un même fil. Si les plateformes suivent le conseil, cette surface se réduit. Si elles ne le suivent pas, Google dispose désormais d'un document à citer la prochaine fois qu'il décidera que ces pages sont du spam.
Étape 5 : instrumentez le schéma que Google a décrit
La section sur la surveillance est la partie de la mise à jour que la plupart des équipes vont sauter, et c'est précisément celle qui attrape un incident réel avant qu'il ne devienne une action manuelle.
Quatre contrôles, chacun avec un endroit où regarder.
Propriété dans la Search Console. Vérifiez le site ou le sous-domaine pour que les alertes d'action manuelle et de sécurité arrivent par e-mail. Si vous exploitez une plateforme avec des sous-domaines par locataire, vérifiez le parent et au moins un échantillon des enfants ; une alerte qui n'arrive nulle part n'est pas de la surveillance.
Tendance de l'indexation des pages. Établissez aujourd'hui la référence des URL indexées par route générée et surveillez les changements en marche d'escalier, pas le bruit. Doubler le nombre d'URL indexées en une semaine sur une route censée être statique, c'est le signal.
Anomalies dans les performances de recherche. Filtrez sur des requêtes sans rapport avec le produit. Les pages de spam attirent les requêtes de spam bien avant que quiconque se plaigne.
Ratio création/indexation. C'est la métrique que Google nomme et que presque personne ne mesure : combien d'URL indexables un seul compte peut produire par jour, et quelle part des nouvelles URL indexables vient du 1 % de comptes les plus productifs. Une alerte initiale à 3 fois la médiane des sept derniers jours pour un compte est arbitraire, mais elle fonctionne ; ajustez-la à votre trafic.
Le même ratio sert de garde-fou produit. Si une fonctionnalité permet à un utilisateur de générer mille URL indexables par jour, c'est une fonctionnalité de gonflement d'index, même si personne n'en abuse encore.
Ce que la mise à jour dit vraiment
Retirez la formulation et Google discute de l'offre.
Pendant vingt ans, la politique anti-spam a décrit des pages : minces, aspirées, masquées, bourrées de mots-clés. Ces catégories supposent qu'un humain ou un script décide de produire une page et que Google décide si elle mérite de se classer. Les résultats générés brisent ce modèle. Une décision produit peut créer un million d'URL, toutes techniquement uniques, toutes techniquement en 200, la plupart sans valeur pour qui ne les a pas créées. Google ne peut pas les évaluer une par une et a cessé de prétendre le contraire.
La réaction s'est divisée en deux camps. Le premier l'a lu comme un coup de semonce : Marie Haynes s'est demandée si de nouvelles actions manuelles allaient viser les outils d'IA et les constructeurs d'applications, et Lily Ray a traité la section comme le signe de ce que Google combat déjà à grande échelle, citant les artefacts de Claude, les pages de partage de ChatGPT et les posts sur les réseaux sociaux. Le second a haussé les épaules. Les équipes soigneuses mettent les rapports générés par les utilisateurs en noindex depuis des années, ont répondu plusieurs voix, et les propres pages générées de Google sont le problème plus important. Les deux lectures peuvent être vraies. Ce qui rend le conseil pertinent, ce n'est pas sa nouveauté, mais le fait qu'il est désormais écrit quelque part où l'application de la politique peut s'appuyer.
Le conseil déplace donc la décision plus haut dans la chaîne. On attend des plateformes qu'elles décident, au niveau du gabarit, si une classe d'URL appartient à l'index. C'est une question de gouvernance, pas de SEO, et c'est pourquoi le conseil figure dans le guide anti-spam et non dans la documentation d'indexation.
Pour la recherche IA, la même logique joue dans les deux sens. Les fonctionnalités IA de Google puisent dans l'index Google, donc une directive noindex retire la page à la fois du vivier et des liens bleus. Si une page générée gagnait des citations dans les AI Overviews, attendez-vous à ce que cela cesse. C'est généralement juste pour un lien de partage et faux pour une page de modèle. Les autres robots IA suivent leurs propres règles, décidez donc séparément lesquels vous autorisez à explorer ces pages.
La leçon pratique tient en une phrase qu'on peut emporter en revue de design : toute URL qu'un utilisateur peut créer est soit une surface produit, soit un passif d'index, et c'est le gabarit qui tranche.
Questions fréquentes
Cela s'applique-t-il à un site marketing ordinaire ?
Non, sauf si votre site génère des URL à partir de saisies utilisateur. Un site marketing publie un ensemble de pages dont une personne a décidé qu'elles devaient exister, l'inverse du problème décrit par le guide. La ligne de périmètre nomme les plateformes d'hébergement et les outils qui permettent aux utilisateurs de publier des pages partagées, du contenu généré ou des applications web. Si vous avez des commentaires, un forum ou des profils de membres, le conseil plus ancien s'applique : nofollow ou ugc sur les liens des comptes peu fiables et noindex pour les nouveaux utilisateurs jusqu'à ce qu'ils acquièrent une réputation.
Faut-il utiliser le robots.txt ou une balise noindex ?
Noindex, et un seul des deux par route. La phrase de Google liste les deux options, mais elles font des choses différentes. Un Disallow dans le robots.txt bloque l'exploration, et une URL bloquée mais liée depuis ailleurs peut rester dans les résultats sans extrait. Le noindex ne fonctionne que si Google peut explorer la page et la lire. Concrètement, cela signifie une balise meta ou un en-tête de réponse, et jamais une règle robots.txt sur le même chemin.
Mettre les pages de partage en noindex va-t-il me coûter du trafic ?
Vérifiez la route avant de décider, pas après. Si une page ne gagne des impressions que sur sa propre chaîne d'URL, elle n'apporte pas de trafic organique et la retirer ne coûte rien. Le schéma qui perd du trafic, c'est de faire tomber une galerie publique avec les résultats qu'elle contient. Gardez la galerie indexable, mettez noindex sur ce qui est derrière elle, et suivez les performances de recherche des requêtes de la galerie avant et après.
Les moteurs de recherche IA respectent-ils noindex ?
Les fonctionnalités IA de Google oui, car les AI Overviews et le AI Mode puisent dans le même index, donc la directive retire la page à la fois des liens bleus et des réponses IA. Les autres robots IA relèvent d'une décision distincte. Le comportement des fournisseurs varie et change sans journal des modifications ; lisez la documentation de chaque robot et récupérez la page avec son user agent plutôt que de supposer qu'une directive les couvre tous.
Autrice : Grace Miller, analyste des risques liés à la recherche IA chez Auspia. Suit plus de 200 changements de politique. Écrit sur les règles des plateformes, le risque de contenu et l'optimisation consciente des politiques.