Google 这次写下的那条规则
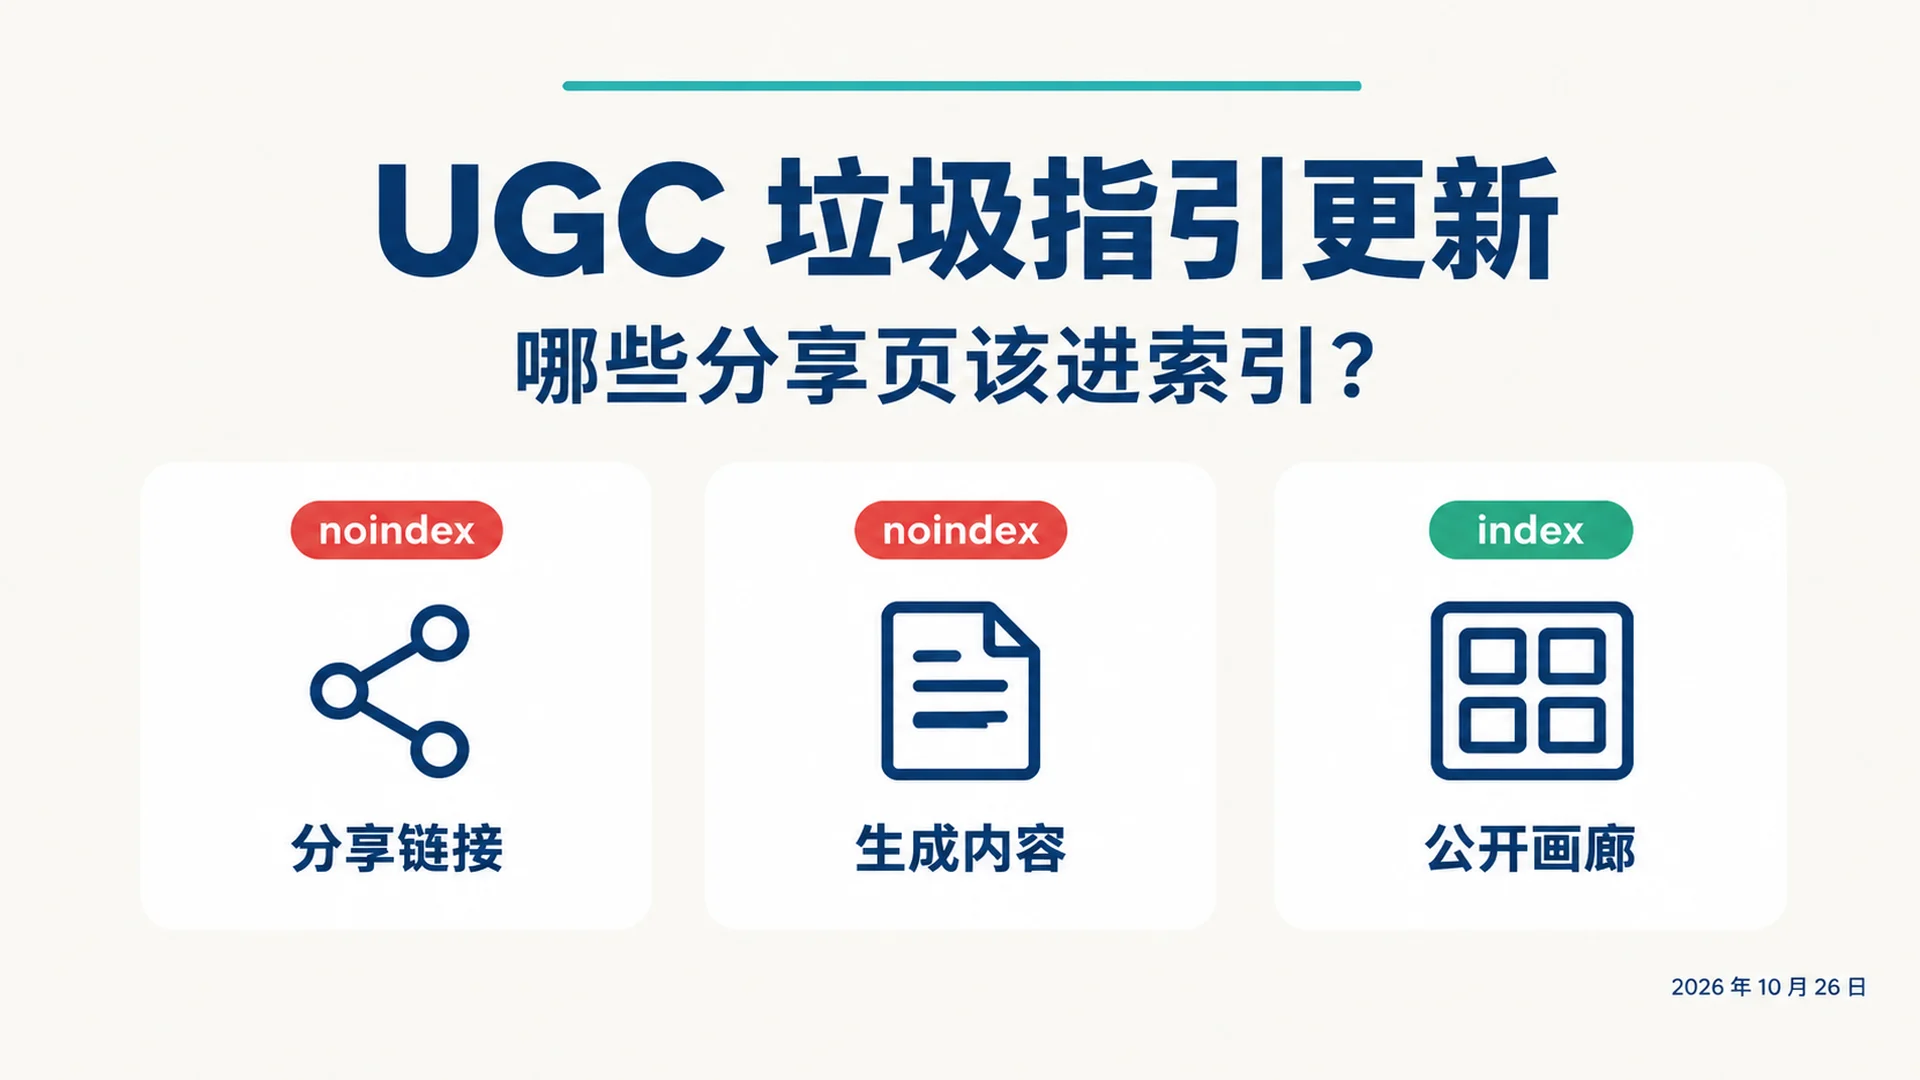
2026 年 10 月 26 日,Google 在《防止用户生成垃圾内容》这份文档里加了两段话。这是全页最短的部分,却可能是最影响产品路线图的部分——因为它问了一个大多数团队从没放上过评审会的问题:这个 URL 到底该不该进 Google 的索引?
新增章节叫 "Only index content meant for Search"(只索引为搜索而存在的内容)。原文是:
If your service lets users create shareable pages, generated outputs, or interactive tools, consider whether that content is meant to be found through search engines or only accessed directly by people with a link. When pages are created for direct sharing, collaboration, or utility rather than public search discovery, apply the noindex rule (using a robots meta tag or X-Robots-Tag HTTP response header) or block crawling in robots.txt by default.
翻成人话:如果你的服务让用户生成可分享页面、生成内容或交互式工具,先判断这些内容是想被搜到,还是只想让拿到链接的人看到。如果它们是为了分享、协作或当工具用,而不是给公众搜索发现,就默认 noindex(用 robots meta 标签或 X-Robots-Tag 响应头),或者在 robots.txt 里默认禁止抓取。
同一天的官方更新日志说得更直白:这次改动的目的是帮平台把「本就不为搜索而建的用户页面」挡在索引之外,并且更早发现垃圾内容。
就这样。没有新的人工处罚,没有排名系统更新,也没有处罚清单。Google 只是建议了一个默认值——而大多数索引事故,恰恰出在默认值上。
适合谁看。 任何会让用户生成 URL 的团队:分享链接、保存的对话、公开看板、模板预览、应用构建、自动生成的报告、论坛帖、个人主页、评价页、列表页。
做完你会得到。 每一类生成 URL 都有明确结论;一个真能把页面从索引里拿掉的控制手段;一条能抓住 Google 所述滥用模式的监控规则。
时间。 单个产品第一遍 45 到 90 分钟。如果有好几个 URL 生成器、又没有路由清单,按一天算。
算完成的标准。 每条生成路由都标成了索引 / noindex / 私有;noindex 的路由在服务端就返回指令,而不是等 JavaScript 跑完;Search Console 里显示的是「已被 noindex 排除」,而不是「已编入索引,但被 robots.txt 屏蔽」。
变了什么,什么只是看起来新
真正改动的是四处。文档其余部分没动,包括 2025 年 12 月就写下的那条建议,现在依然有效。
改动 | 原文要点 | 对你的实际影响 |
|---|---|---|
指南覆盖范围 | 现在点名「让用户发布分享页、生成内容或 Web 应用的工具」 | 照字面读,AI 对话导出、artifact 页面、应用生成器、无代码工具都落在里面,不再只是论坛和评论区 |
滥用的计量单位 | 垃圾制造者可能批量生成「大量页面或站点」 | Google 描述的是量,不是技巧。一个滥用账号就能造出上千个 URL |
新增章节 | “Only index content meant for Search” | 目前最明确的一次表态:只能靠链接访问的内容,noindex 是合理默认 |
监控建议 | 验证站点或子域;盯网页索引与搜索效果报告的异常尖峰;当「少数用户」产出「大量可索引 URL」时告警 | 索引膨胀第一次有了明确的检测方法,而检测方法通常先于执法出现 |
没变的两条:新用户发布的内容先 noindex,等有了信誉再放开;不可信内容里的链接加 nofollow 或 ugc。这两条你已经在做的话,就已经领先这次更新了。
有一点要说清楚,因为 X 上的反应跑得比文档快:这是写给平台方的、关于自家 URL 供给的指引。它没有给普通营销站增加新的违规项,也不改变任何页面的排名。它改变的是——哪些东西应该存在于索引里。
还有一个背景能解释时间点。2026 年 7 月底,Claude 的分享链接和 artifact 页面出现在 Google 索引里,当时的报道提到有病历、API key 这类内容被暴露,Anthropic 在几天内补上了。同一批报道还把矛头指向 Replit、Lovable 这类构建工具上的公开 app URL。Google 很少为一个假设新增章节——这次这个假设已经上线了。
决定每个生成 URL 的那个问题
Google 的判据只有一句话:这些内容是想被搜索引擎发现,还是只想让拿着链接的人访问?
落到操作上,四个信号基本能定下来。要评的是路由,不是单个页面。
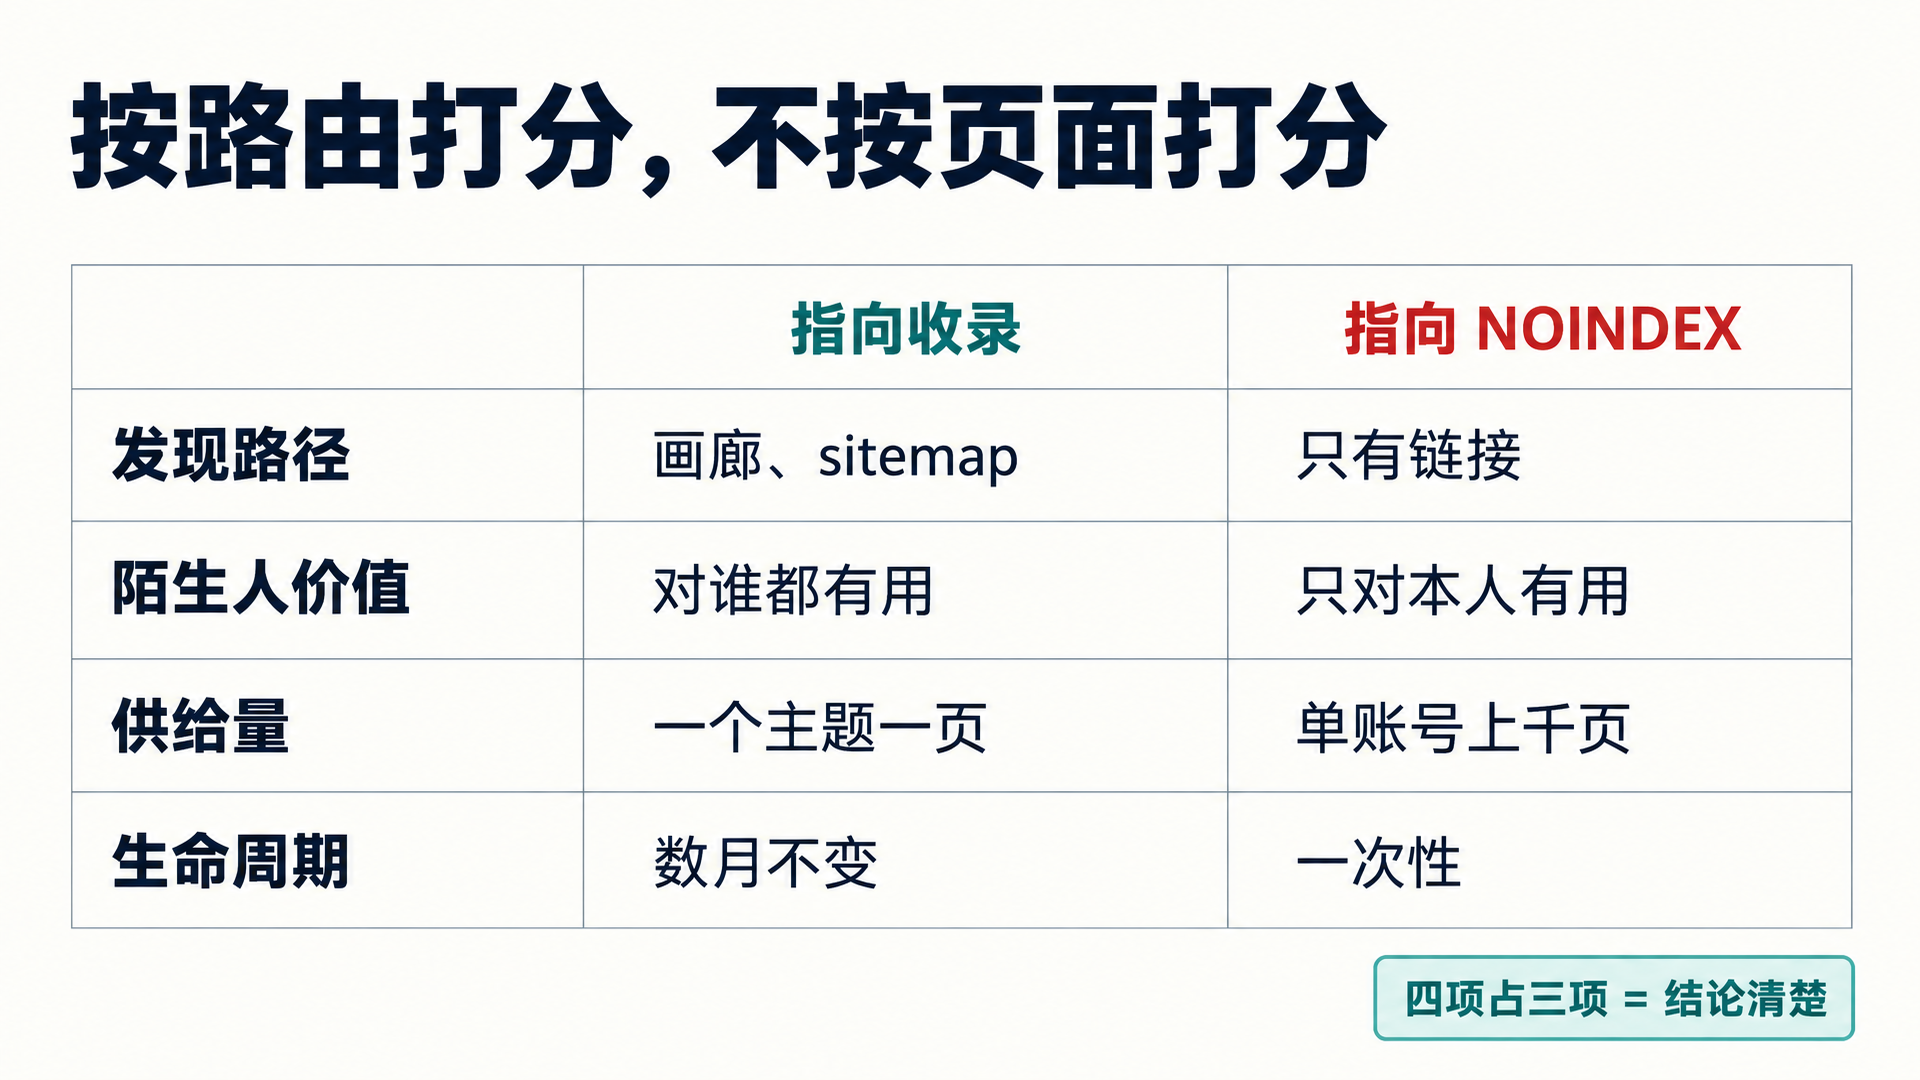
信号 | 指向收录 | 指向 noindex |
|---|---|---|
发现路径 | 有公开画廊、sitemap、分类页或个人主页链过去 | 只能靠复制链接或分享按钮到达 |
对陌生人的价值 | 不认识作者也用得上 | 只对创建者、其团队或收件人有意义 |
供给量 | 一题一页,或人工策展的一组 | 一个账号产生上千个 URL,大多是近重复 |
生命周期 | 几个月内仍然准确 | 一次性的:一段对话、一次构建、一份草稿、临时导出 |
四条里三条指向 noindex,结论就很清楚了。结论混杂的,通常意味着这条路由需要拆开:公开画廊可以收录,单个产出不收录。这是最常见的正确答案,也是最容易被跳过的一个——因为它要求两套模板,而不是加一个开关。
还有个更省事的反问:陌生人只看到搜索结果里的标题和摘要,能看明白这是什么吗?「与 Sam 的对话,10 月 24 日」不合格;「自由设计师发票模板」合格。这不是质量问题,是这个页面当初是造来被找到的,还是造来被发出去的。
选一个真能把 URL 拿掉的控制手段
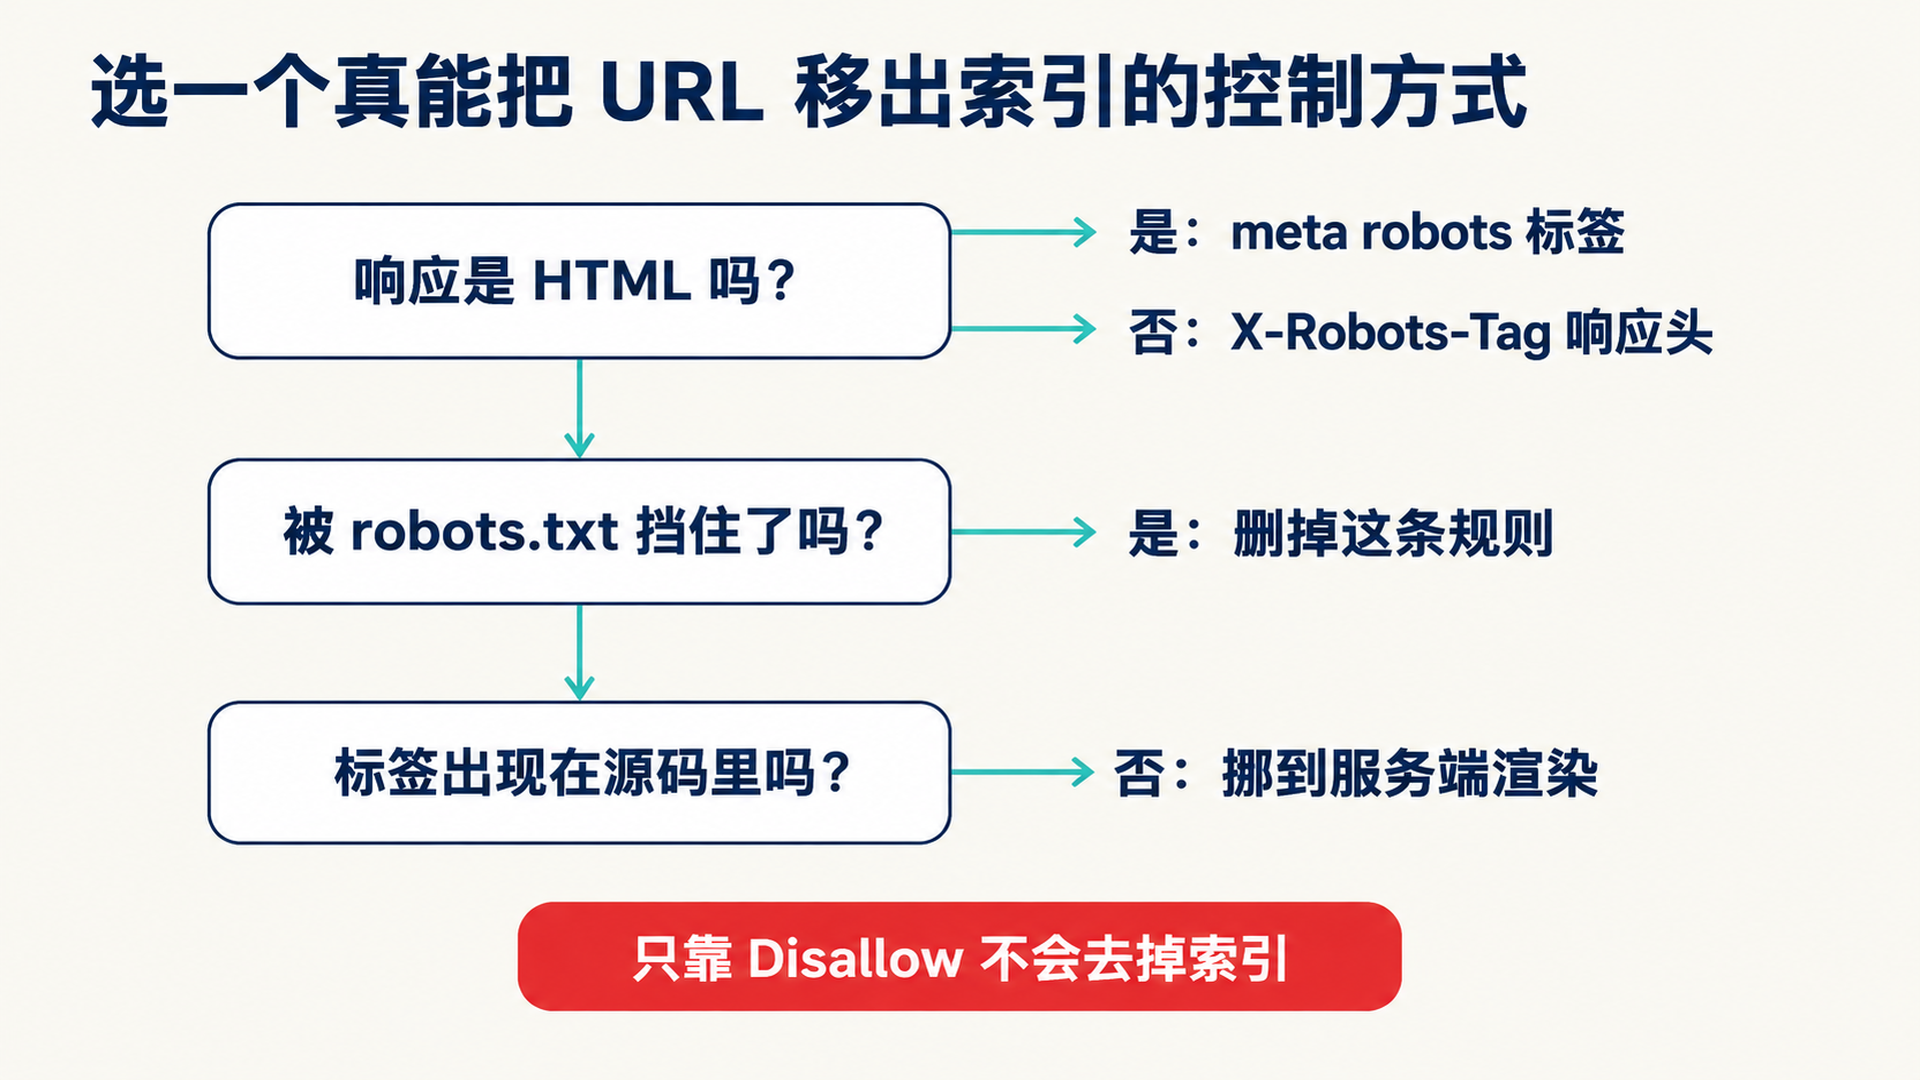
接下来的地方,最容易出现「照着文档做,但还是没生效」。Google 在同一句话里给了两个选项,而这两个选项并不等价。
robots.txt 管的是抓取,不管收录。Google 自己在 robots.txt 入门文档里写了:被 Disallow 的页面,只要别处有链接指向它,仍然可能被索引——此时 URL、甚至指向它的锚文本都可能出现在结果里,只是没有摘要。
noindex 管的是收录,但前提是 Google 能抓到页面、读到这条指令。noindex 文档写得很明确:这条规则要生效,页面不能被 robots.txt 挡住,否则「爬虫永远看不到 noindex」。
把两句话拼起来,顺序就出来了:
控制手段 | 能把 URL 从索引拿掉吗 | 在哪里失效 | 适合用在哪 |
|---|---|---|---|
| 能,前提是 Google 抓到并读到 | 被 robots.txt 挡住、或在登录之后 | 非 HTML 响应(PDF、JSON、图片),以及用 CDN 或边缘规则批量覆盖多条路由 |
HTML head 里的 | 能,前提是 Google 抓到并读到 | 由 JavaScript 后注入的标签;被 robots.txt 挡住的页面 | 服务端渲染的 HTML 分享页 |
| 不能 | 有外链的 URL 仍可能留在索引里,只是没有摘要 | 降低抓取压力,不是隐私控制 |
登录墙或签名 URL | 能,直接从访问层面切断 | 需要页面真的是私有的 | 含他人数据的任何页面 |
过期后返回 410 | 能,需要时间 | 比 404 慢;只要 URL 还在正常返回就没用 | 一次性分享与构建产物 |
一个要避开的偷懒做法:X-Robots-Tag: none 不是中性值。Google 把 none 等同于 noindex 加 nofollow。偶尔你确实要这个,但很多团队是从代理配置里直接抄过来的,并不知道自己写了什么。
第二个要避开的偷懒做法:canonical。canonical 只是提示。如果这个页面不该进索引,就直接说 noindex。
第一步:盘清会批量生成 URL 的路由
没列出来的东西没法分类。多数团队会低估自己的数量,因为他们按功能数,而不是按路由模式数。
打开路由表,把所有动态段列出来。常见的长这样:
/s/:id、/share/:id、/p/:token/chat/:id、/conversation/:id、/thread/:id/u/:handle、/profile/:handle/app/:id、/build/:id、/project/:id/r/:slug、/preview/:token、/report/:id
然后拿 Google 已知的情况对一遍,因为代码里的路由和索引里的 URL 一定会不一致。
从 sitemap 看。 拉下来数一数:
curl -s https://example.com/sitemap.xml | grep -c "<loc>"
curl -s https://example.com/sitemap.xml | grep -oE "https://[^<]+" | sed -E 's#https://[^/]+##' | cut -d/ -f2 | sort | uniq -c | sort -rn
第二条命令给出一个粗略的路径前缀分布。如果某条生成路由出现在 sitemap 里,本身就是个 bug:sitemap 是你主动请 Google 收录的页面清单。
从 Search Console 看。 打开网页索引报告(Page Indexing),按 URL 前缀筛选每条候选路由,记下数量。这是唯一能告诉你 Google 实际怎么处理这些 URL 的信息源。
从服务器日志看。 按路径前缀聚合 Googlebot 请求:
grep -i "Googlebot" access.log | awk '{print $7}' | cut -d/ -f2 | sort | uniq -c | sort -rn | head -20预期产出: 一张路由模式清单,每条后面跟着 URL 数量,且至少来自两个信息源。
质量检查: 任何对非员工访客会返回 200 的路由,都该在清单上。如果同一条前缀在 sitemap 和 Search Console 里的数量差了几个百分点以上,先查清楚原因再动手。
如果什么都没找到: 你的路由大概率在前端。去前端代码里搜路由定义,而不是后端,再打开一条真实分享链接看网络请求。
第二步:在一张表里给每条路由定性,别在会里定
把结论写下来,写在能被复核的地方。一条路由模式一行就够。
路由 | 谁创建 | 发现路径 | 对陌生人的价值 | 结论 | 控制手段 | 负责人 |
|---|---|---|---|---|---|---|
| 任意用户 | 只有链接 | 无 | noindex | 响应头 | 平台 |
| 人工策展 | 站内链接、sitemap | 高 | 收录 | 无 | 内容 |
| 任意用户 | 个人主页链接 | 活跃后才高 | 有信誉前 noindex | meta | 风控 |
| 任意用户 | 只有链接 | 无 | noindex | 响应头 | 平台 |
| 编辑 | sitemap | 高 | 收录 | 无 | 内容 |
这张表要能落地,得满足三件事。
每行有且只有一个负责人。责任不清,是生成路由在索引里躺好几年的主要原因。
控制手段跟结论写在同一行,不要留到后面补。「noindex」在没人知道它意味着响应头、模板改动还是 CDN 规则之前,不算一个决定。
把例外写下来。如果某条路由整体 noindex、但其中一小部分应该公开,现在就写清这部分的条件。六个月后再回头补一个白名单,通常的结果是整条 noindex 规则被悄悄删掉。
第三步:控制手段要落在模板层
一页一页改的东西活不过下一次发版。把控制加在渲染这条路由的地方。
HTML 页面,把标签放进服务端渲染的 head。Next.js App Router 里是 metadata,Astro 里是布局的 head,Rails 或 Django 里是 layout 模板。具体语法不重要,位置才重要:它必须在 Google 收到的 HTML 里,而不是客户端 effect 加上去的。
<meta name="robots" content="noindex">非 HTML 的东西根本没有 meta 标签可加,用响应头:
X-Robots-Tag: noindex覆盖 PDF 导出、JSON 响应、生成的图片、CSV 下载。如果这些文件由 CDN 提供,就在边缘层设置,让新路由天然继承。
一整类路由,中间件通常比逐个改模板更干净:
// Express 示例:给所有生成的分享 URL 加 noindex
app.use(['/s', '/share', '/report'], (req, res, next) => {
  res.set('X-Robots-Tag', 'noindex');
  next();
});
预期产出: 发版后,所有标了 noindex 的路由在匿名请求的第一个字节里就带上这条指令。
质量检查: 用 curl -sI 打线上 URL,响应头里应该有 x-robots-tag: noindex;用 curl -s 看源码,meta 标签应该在,且在任何脚本执行之前就在。
出错怎么退: 如果标签只在 JavaScript 执行后才出现,把它挪进服务端渲染。框架做不到按路由渲染 head,就改用响应头。别抱着「JS 注入的 noindex 应该也算」的侥幸——Google 明确说过,对渲染后才出现的 noindex,行为并不确定。
同一个 PR 里还应该带上两件事。把 noindex 的路由从 sitemap 里删掉——一边请 Google 收录、一边不想让它被收录,这种矛盾 Google 会按它的方式解决。另外补一条过期规则:分享链接失效时返回 410,而不是留一个 200 的空状态页。
第四步:确认 Googlebot 真能看到这条指令
上面所有内容,没按 Google 的方式验证过,就等于没做。
先看响应头:
curl -sI https://example.com/s/abc123 | grep -i x-robots-tag再看初始 HTML,要赶在任何脚本执行之前:
curl -s https://example.com/s/abc123 | grep -i 'name="robots"'最后确认 robots.txt 没有挡住这条路径。挡住了,Google 就不会来抓,也就永远读不到这条指令:
curl -s https://example.com/robots.txt然后去 Search Console,用网址检查(URL Inspection)请求抓取,看结论。
正确的结果是「网页未编入索引:已被 noindex 标记排除」。说明你踩了坑的结果是「已编入索引,但被 robots.txt 屏蔽」——Google 手里有这个 URL,读不到指令,还可能继续把它放出去。看到这个就撤掉 robots.txt 规则,让 noindex 去干活。
也可以用爬虫模拟器直接看 Googlebot 拿到的是什么,检查二十条路由时比等重新抓取快得多:Googlebot 爬虫模拟器。
预期产出: 每条 noindex 路由在下一轮抓取后的几天内显示为「已被 noindex 排除」。规则上线后新建的路由,一开始就不该出现在索引里。
出错怎么退: 两周后还在索引里,就依次查三件事:Google 到底抓不抓得到;页面返回给 Googlebot 的是不是 200;有没有 canonical 或 hreflang 把搜索引擎指向别处。移除工具只用来在修因期间做临时屏蔽,它替代不了指令本身。
当分享页本身就是增长渠道
有些生成页面是该被收录的,一刀切 noindex 等于自己砍自己。这三类值得保住:
模式 | 为什么该进索引 | 配套约束 |
|---|---|---|
公开模板画廊 | 用户发布设计、别人复用,产出唯一且长期有效 | 对新提交做审核 |
带公开作品页的生成器 | 一个真实结果加上「用 X 做的」,本身就是分发渠道 | 作品模板与营销页保持区分 |
从用户帖子里长出来的文档 | 反复被问的问题值得有一个长期、编辑过的答案 | 收录整理后的答案,不是原始对话 |
如果你属于其中一类,Google 更早的那条建议反而更好用:对没有信誉的用户先 noindex,等账号有历史再放开。这样既挡垃圾,又不放弃获客链路,也是这次更新之前文档就推荐的模式。
三类的判断标准是同一个。这个页面在搜索效果报告里拿到的曝光,来自陌生人会输入的查询,它就该在索引里;只来自它自己的那串 URL,就不该。
还有一个二阶效应值得点名。带公开 URL 的分享页,多年来一直是个廉价的外链面:在域名权重高的平台上建一个页面,指向自己的站,换二十个平台重复一遍。Ahrefs 的 Patrick Stox 在同一条公告的回复里说,这个办法能从不同平台拿到 20 多个链接。平台照做,这个面就收窄;不照做,Google 下次决定把这些页面当垃圾处理时,手里就多了一份能引用的文档。
第五步:把 Google 点名的滥用模式做成监控
监控这一段,是这次更新里最容易被跳过的部分,也是真出事时能提前拦住人工处罚的部分。
四项检查,各有各的查看位置。
Search Console 归属。 验证站点或子域,让人工处罚和安全问题告警能发到邮箱。如果你跑的是多租户子域的平台,验证主域,再抽验一部分子域;告警发不到人的监控不算监控。
网页索引趋势。 今天先给每条生成路由的已收录数量记一个基线,之后看阶跃,别看噪声。一条本该稳定的路由,一周内收录数翻倍,就是信号。
搜索效果异常。 筛出与产品无关的查询词。垃圾页面吸引垃圾查询,这比有人来投诉早得多。
创建与收录比。 这是 Google 点名的指标,也是几乎没人跟踪的一个:单个账号每天能产出多少可索引 URL,新增可索引 URL 里有多大比例来自前 1% 的账号。给单账号设一条「超过过去七天中位数 3 倍就告警」的初值,数字是拍的,但能用,之后按自己的流量校准。
同一个比值也可以当产品侧的护栏。一个功能让单个用户一天生成一千个可索引 URL,不管有没有人滥用,它本身就是个索引膨胀功能。
这条更新真正在说什么
撇开措辞,Google 在谈的是供给。
过去二十年,垃圾政策描述的都是页面:内容单薄、抓取拼凑、伪装、堆词。这些类别默认了一个前提——有人或脚本决定生产一个页面,Google 再决定它配不配排名。生成式产出把这个模型打破了。一个产品决策就能造出上百万个 URL,技术上个个唯一、个个返回 200,而除了创建者本人,它们对谁都没用。Google 没法一个一个评估,它也已经不打算再假装可以。
从业者的反应大致分成两派。一派当成警告:Marie Haynes 直接问,这是不是意味着针对 AI 工具和应用生成平台的新一轮人工处罚要来了;Lily Ray 则把它读成信号,认为这说明 Google 已经在跟这类东西打规模战,她列出的第一批嫌疑对象是 Claude artifacts、ChatGPT 的分享页和社交帖子。另一派耸耸肩:认真做的团队几年前就把用户生成的报告 noindex 了,回复里不少人认为,真正大量生产这类页面的是 Google 自己。两种读法都成立。这条指引的分量不在于建议有多新,而在于它现在写进了文档,执法的时候可以指着它说话。
所以指引把决定权上移了。平台现在要在模板层决定:某一类 URL 到底该不该进索引。这是治理问题,不是 SEO 问题——也正因为如此,这段建议放在了垃圾指南里,而不是索引文档里。
对 AI 搜索,这套逻辑在两个方向上都成立。Google 的 AI 功能取用的是 Google 索引,所以 noindex 会把页面同时从蓝链和 AI 结果池里拿掉。一个原本能在 AI Overviews 里被引用的生成页面,加完 noindex 就该预期引用消失。对分享链接来说这通常是对的,对模板页来说通常是错的。其他 AI 爬虫各按各的规则来,所以哪些爬虫你希望它能抓到这些页面,要单独决定。
落到一句话,可以直接放进设计评审:用户能创建的每一个 URL,要么是产品界面,要么是索引负债,由模板决定是哪一种。
常见问题
这条指引会管到普通的企业官网吗?
不会,除非你的站点会根据用户输入生成 URL。企业官网发布的是"有人决定它应该存在"的那批页面,跟指南描述的问题正好相反。范围那句话点名的是托管平台,以及"让用户发布共享页面、生成内容或 Web 应用的工具"。如果你有评论区、论坛或会员主页,适用的是指南里更早的那部分建议:对不可信账号的链接加 nofollow 或 ugc,新用户的内容先 noindex,等攒出信誉再放开。
到底该用 robots.txt 还是 noindex?
用 noindex,而且同一条路由上只能二选一。Google 那句话把两个选项并列写出来,但它们干的是不同的事。robots.txt 的 Disallow 只是挡住抓取,一个被挡住、却被别处链到的 URL 照样能留在结果里,只是没有摘要。noindex 只有在 Google 能抓到页面、读到指令时才生效。所以落地就是 meta 标签或响应头,同一条路径上不要再叠 robots.txt 规则。
给分享页加 noindex 会掉流量吗?
先看数据再决定,别反过来。如果一个页面只在搜索自己那串 URL 时有展现,它本来就没在带自然流量,去掉不损失什么。真正会掉流量的是把公开画廊连同里面的产出一起下掉。画廊保持可索引,它身后的页面加 noindex,再对比改动前后画廊相关关键词的搜索表现。
AI 搜索引擎会遵守 noindex 吗?
Google 的 AI 功能会。AI Overviews 和 AI 模式取用的是同一个索引,所以 noindex 会同时把页面从蓝链和 AI 回答里拿掉。其他 AI 爬虫是另一个问题。各家行为不一样,改起来也不发更新日志,所以要看每一家自己的文档,并用对应爬虫的 UA 实际取一次页面,别指望一条指令就全覆盖。
作者:Grace Miller,Auspia AI 搜索风险分析师,跟踪 200+ 次平台政策变动。Grace 主要写平台规则、内容风险,以及合规前提下的优化。