每一份 AI 品牌監測計畫都從一份提示詞清單開始,而幾乎每一份清單都是照著團隊已經相信的事情寫出來的。二十個提示詞感覺夠周全,五十個感覺已經窮盡。沒有人去檢查這份清單是否還在發現新東西。
我們在 2026 年 9 月把二十個提示詞跑在三個 AI 介面上,只追蹤一件事:來源出自哪裡。不是我們的品牌有沒有被提到,而是答案拉進來的全部網域集合。如果提示詞清單已經完整,那麼再加提示詞就應該找不到新來源了。事實並非如此。
我們測了什麼
項目 | 設定 |
|---|---|
提示詞 | 20 個關於 AI 可見性工具的購買者問題 |
介面 | ChatGPT(gpt-5)、Gemini 2.5 Flash、Perplexity(sonar),均開啟聯網檢索 |
收集到的答案 | 60 條 |
發現的不同來源 | 432 個網域 |
單輪完整執行的成本 | 1,444 美元 |
重複覆蓋 | 同一天把 5 個提示詞各跑兩遍 |
我們把 60 條答案各自當作對來源宇宙的一次觀測,統計的是不同網域,而不是引用位次。Gemini 在 20 條答案裡回傳了 989 條來源標註,但其中很多指向同一個頁面,所以網域數才是這裡誠實的單位。標註層面的資料在AI 可見性檢查器分析裡。
結論 1:清單永遠不會收口
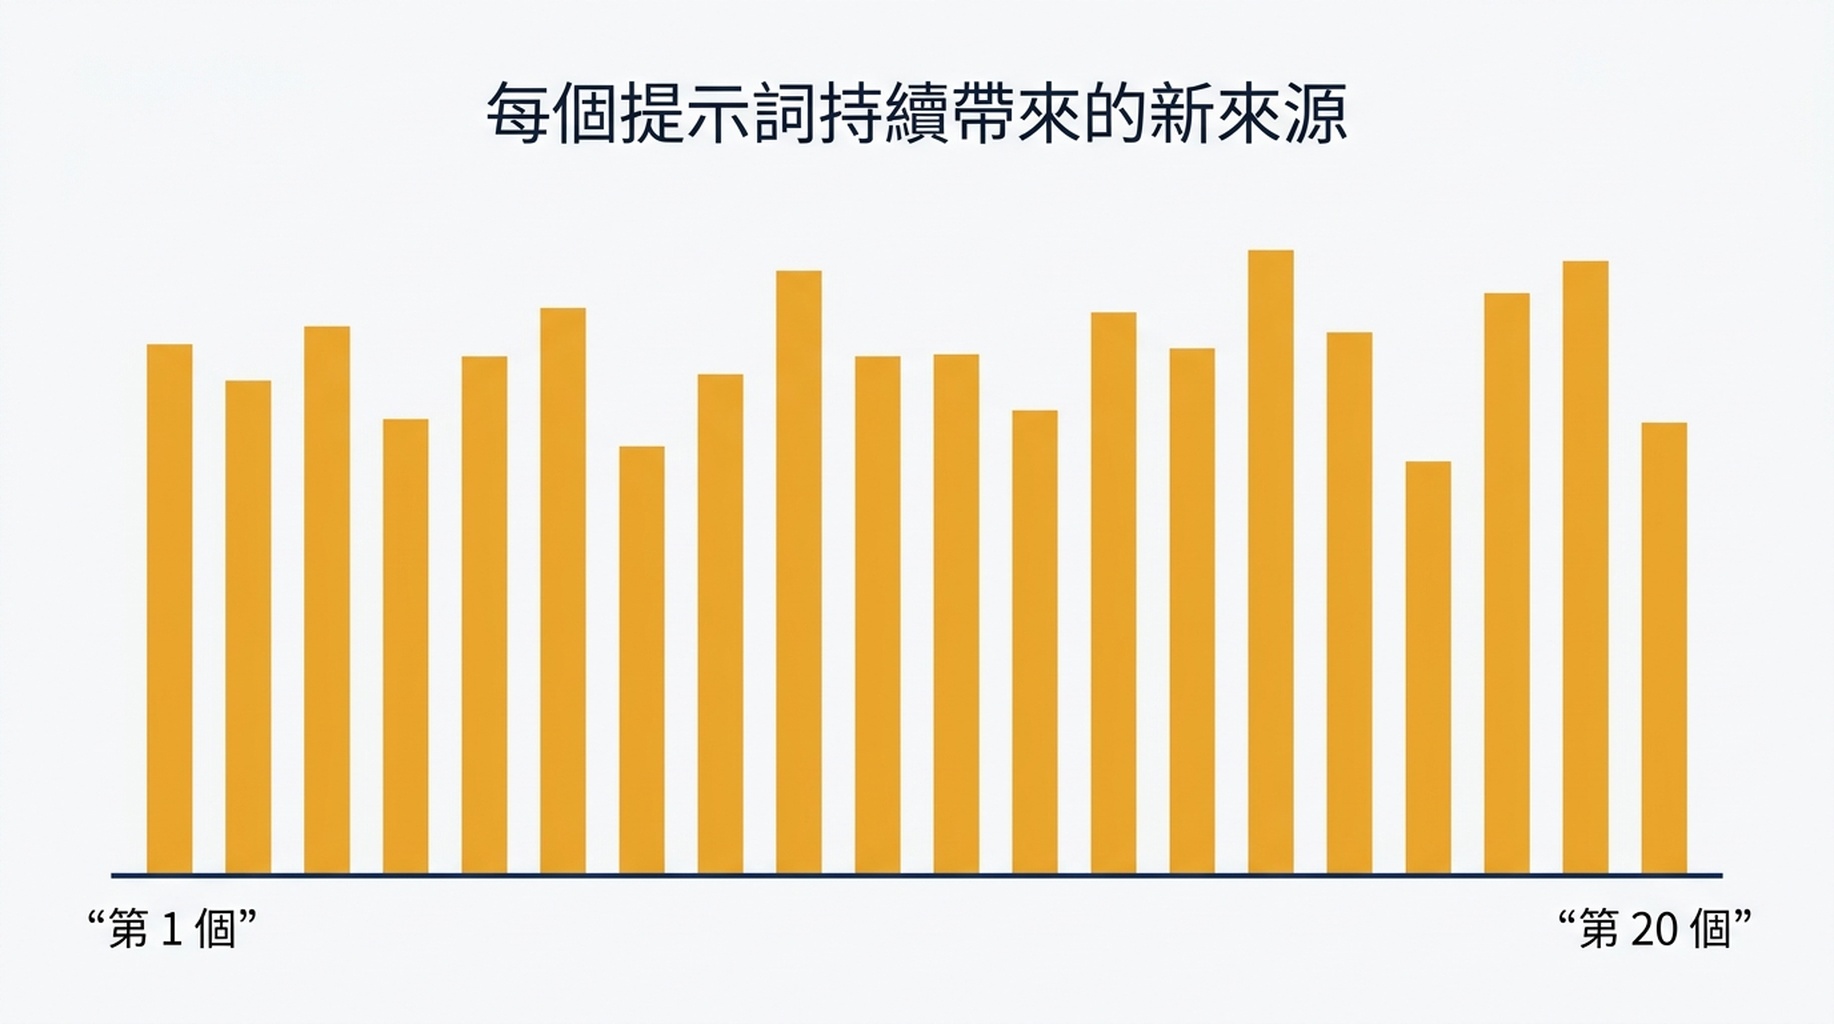
決定一套監測方案該怎麼搭的正是這一部分。每跑完一個提示詞,我們就把它的新網域併入此前找到的全部結果。
已跑提示詞數 | 發現的不同來源 | 占 20 個提示詞總數的比例 |
|---|---|---|
1 | 34 | 8% |
3 | 91 | 21% |
5 | 134 | 31% |
10 | 235 | 54% |
15 | 336 | 78% |
20 | 432 | 100% |
最後一個提示詞仍然帶來了 14 個此前任何提示詞都沒翻出來過的網域。二十個提示詞中,最小的邊際增量是 14,最大是 34。在這個區間裡沒有任何一個點,能讓多加一個提示詞變得不划算。也就是說,提示詞清單不是你收集完成的樣本,而是你要一直往下抽的樣本。
說成實務版本:一份憑記憶寫出的五個提示詞清單,大約覆蓋二十個提示詞所覆蓋範圍的三分之一。會察覺到品類變化的那套監測方案,和每個月重複回報同樣五個答案的那套方案,差距就在這裡。
結論 2:每個介面看到的,是同一空間裡不同的三分之一
432 個網域分布得並不均勻。每個介面觸及的是同一批問題裡不同的切片。
介面 | 不同來源 | 占 432 的比例 | 每條答案的來源中位數 |
|---|---|---|---|
ChatGPT | 47 | 11% | 0 |
Gemini 2.5 Flash | 184 | 43% | 12 |
Perplexity | 285 | 66% | 19 |
Gemini 和 Perplexity 兩者就找到了 432 個網域中的 400 個,也就是說 ChatGPT 補上了 32 個別的介面都沒翻出來的網域。在 ChatGPT 沒有檢索的那 12 個提示詞上,這個介面貢獻為零,它的中位數之所以是 0 就是這個原因。
對監測來說,這個結論並不舒服。如果你的追蹤工具只盯一個介面,你跑的不是三介面方案的縮小版,你回報的是另一個來源群體,而「我們這個月被引用得更多了嗎」的答案,可能只是「我們什麼都沒改,是介面變了」。我們在答案層面測過同一個效應,見 AI 可見性追蹤器的執行變異。
結論 3:兩個介面很少在同一個提示詞上達成一致
我們比較了 Gemini 和 Perplexity 在同一天、同一語言下、針對同一提示詞給出的來源清單。
- 兩份清單平均只共享 2.5 個網域,而各自大約有 20 個。
- 平均 Jaccard 重合度為 0.089。
- 在 ChatGPT 也回傳了來源的那 8 個提示詞裡,只有 3 個能讓三個介面共享哪怕一個網域,三方最大重合為 2 個網域。
- 三個介面在單一提示詞上完全一致的情況從未發生過。
同一個問題的兩條答案,是用幾乎不相交的頁面集合拼出來的。這是我們找到的、反對單介面回報最有力的論據,同時也是個好消息:一個新頁面被撿起來的機會,遠比單份來源清單所暗示的要多。
結論 4:大多數來源只出現一次
432 個網域的分布極其不均。
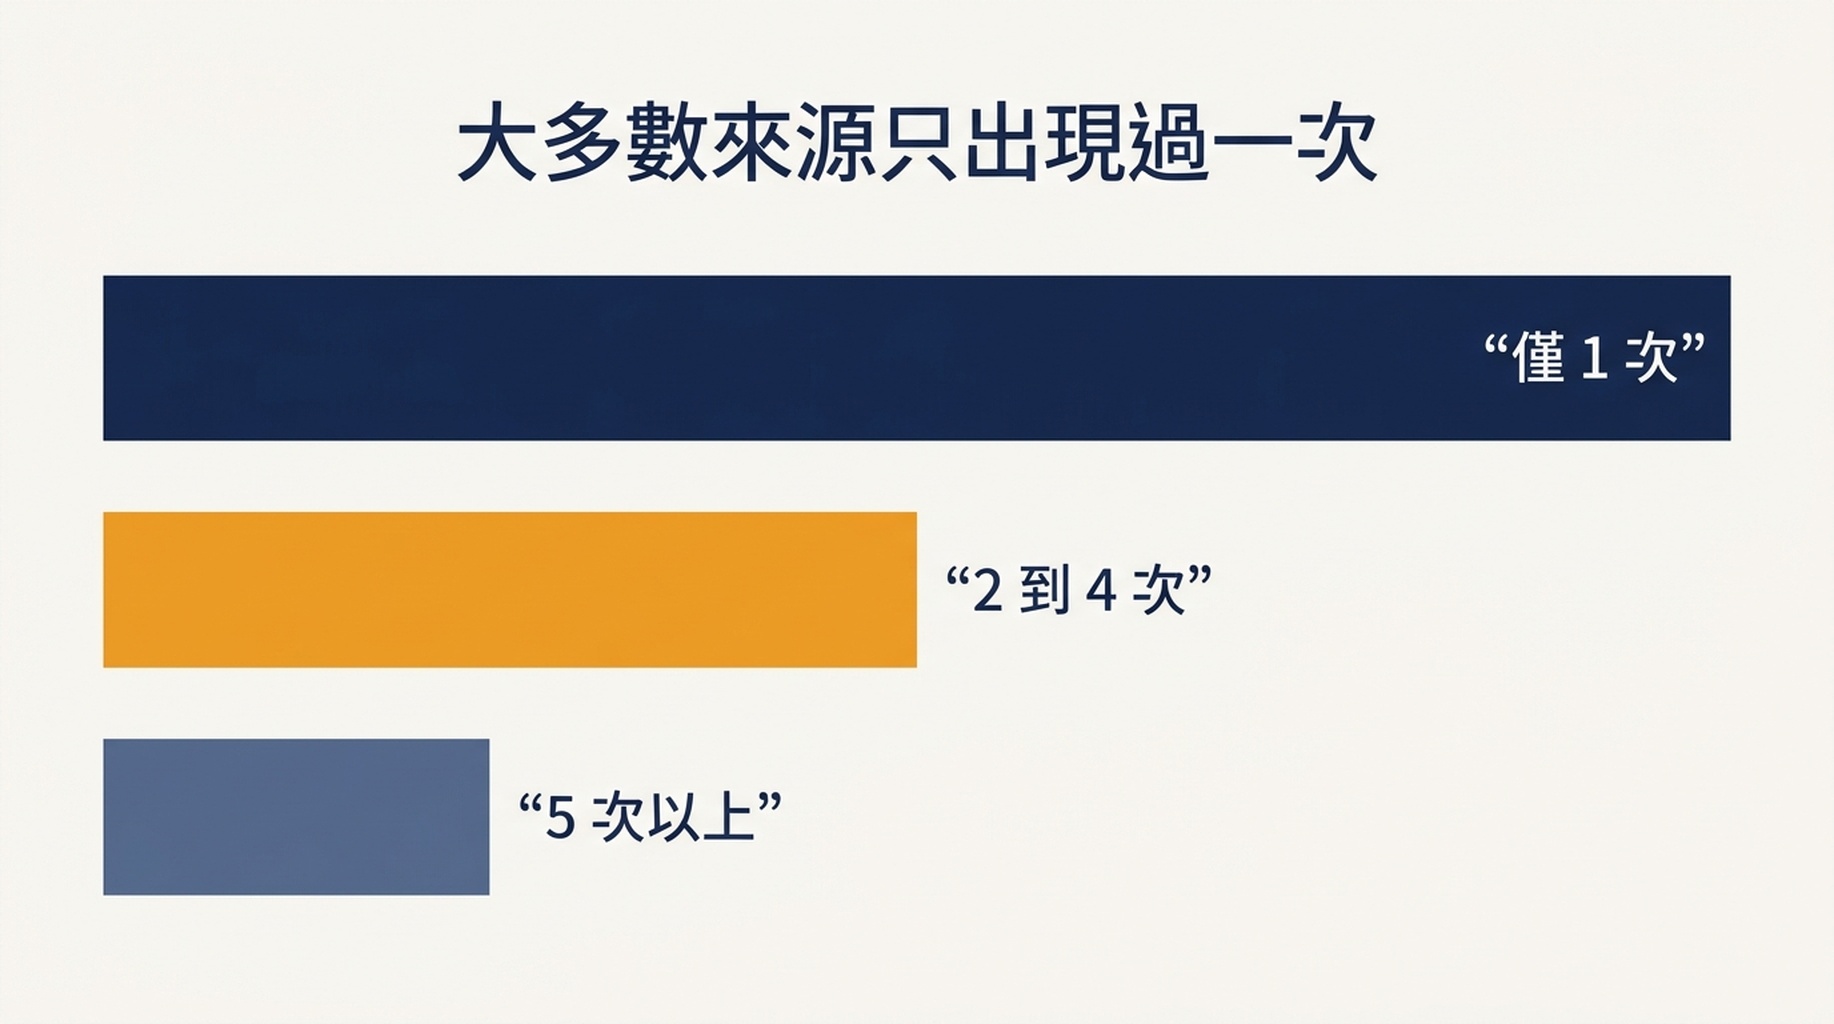
- 432 個網域中有 324 個,也就是 75%,在 60 條答案裡恰好只出現一次。
- 只在 5 條及以上答案裡出現過的網域只有 17 個。
- 反覆出現的核心部分既小又可預測:ahrefs.com 出現在 16 條答案裡,semrush.com 15 條,reddit.com 14 條,接著是 frase.io 的 9 條,再往下是一簇各 6 個的集合,包括 otterly.ai、tryprofound.com、llmpulse.ai、cognizo.ai 和 searchenginejournal.com。
這把監測工作劈成兩半,而這兩半想要不同的節奏。反覆出現的核心是需要勤複查的那一層,因為那裡的變化意味著共享來源真的變了。只出現一次的尾部是需要抽樣的那一層,因為在整個宇宙裡,有 75% 的東西在重複出現之前都是雜訊。
不用完整清單,該監測什麼
層 | 放進什麼 | 節奏 | 每月資料成本 |
|---|---|---|---|
第 1 層:反覆出現的核心 | 反覆出現的 17 個網域,加上你自己的網域和最接近的三個競品 | 每週在一個介面上跑 | Perplexity 上 0.48 美元,Gemini 上 3.23 美元 |
第 2 層:提示詞面板 | 15 到 20 個提示詞,涵蓋品類、對比、定價與問題陳述 | 每月在三個介面上跑 | 每輪 1.44 美元 |
第 3 層:提示詞發現 | 每月新增 5 個提示詞,寫自業務通話與支援工單 | 每季複核一次,然後提拔或丟棄 | 已包含在月度執行裡 |
這套東西跑下來,有三條規則浮出來。
- 記錄提示詞的類別,而不只是提示詞。我們最寬的一條答案來自一個關於「到底怎樣才能被引用」的提示詞,而不是工具對比;最窄的一條反而來自對比。不同類別的行為不一樣,而你要回報的是類別。
- 每條記錄裡都保留介面名。沒有介面名的引用數無法比較,因為清單長度能差三倍。
- 輪換發現用的提示詞。二十個提示詞找到了 432 個網域,而這條曲線說明換另外二十個會找到另外幾百個。提拔與退役是唯一能讓面板保持誠實的機制。
在這裡成本不是限制。二十個提示詞跑滿三個介面花了 1,444 美元,所以一套月度方案的資料成本一年大約 17 美元,複核時間另計。限制在於複核時間才是更貴的那一半,這也是為什麼分層結構比清單長度更重要。Google 自家的 AI 介面完全不在這份面板裡,它需要另一種量具,我們在 AI Overview 追蹤器裡做過說明。
限制
- 一天、一個地區、英語、三個介面、每個介面一個模型版本。
- 網域計數會剔除同一條答案內部的重複,所以一個被引用五次的頁面只算一次。
- 提示詞類別是我們自己劃分的,不是任何外部分類法。
- 成本數字只涵蓋答案生成。
- ChatGPT 的貢獻被它沒有檢索的那 12 個提示詞壓低了,這是那個介面的性質,不是提示詞集合的性質。
常見問題
AI 品牌監測需要多少個提示詞?
我們的資料裡沒有完成點。二十個提示詞找到了 432 個來源,而第二十個仍然新增了 14 個。選一個你每月複核得來的面板規模,然後把精力花在提示詞品質與輪換上,而不是清單長度上。
我應該監測一個 AI 介面還是多個?
多個,而且要分開回報。最重的兩個介面每個提示詞平均只共享 2.5 個來源,三方完全一致從未發生。單介面方案測的是那個介面,不是你的品類。
只出現一次的網域值得追蹤嗎?
只值得當作一次觀察。432 個網域裡有 324 個只出現過一次,所以單次出現更接近雜訊而不是訊號。等它在第二條答案裡出現,最好還是在第二個介面上出現,再把它提拔到反覆出現的層。
面板應該多久跑一次?
完整面板每月一次,反覆出現的核心每週一次。反覆清單夠短,在一個便宜的介面上跑一次週更,每月花不到五十美分,而新來源是在月度那一輪裡進來的。
Auspia 觀點:別再按「感覺夠不夠周全」來決定提示詞清單的規模,開始測量它什麼時候不再發現新東西。在我們的資料裡這個點始終沒有到來,這意味著正確的規劃單位是提示詞類別與輪換,而不是一份更長的名單。把反覆出現的來源分層,對尾部做抽樣,並給你回報的每一個數字都帶上介面名。
作者:艾蓮娜·蕭