Todo plano de monitoramento de marca em IA começa com uma lista de prompts, e quase toda lista é montada a partir do que a equipe já acredita. Vinte prompts parecem criteriosos. Cinquenta parecem exaustivos. Ninguém verifica se a lista ainda está descobrindo alguma coisa.
Em setembro de 2026 rodamos vinte prompts em três superfícies de IA e acompanhamos uma coisa: de onde vinham as fontes. Não menções à nossa marca, mas o conjunto completo de domínios que as respostas puxaram. Se a lista de prompts estivesse completa, acrescentar prompts deveria parar de encontrar fontes novas. Não parou.
O que medimos
Item | Configuração |
|---|---|
Prompts | 20 perguntas de comprador sobre ferramentas de visibilidade em IA |
Superfícies | ChatGPT (gpt-5), Gemini 2.5 Flash, Perplexity (sonar), com busca na web ativada |
Respostas coletadas | 60 |
Fontes distintas encontradas | 432 domínios |
Custo de uma passagem completa | 1.444 dólares |
Cobertura repetida | 5 prompts rodados duas vezes no mesmo dia |
Tratamos cada uma das 60 respostas como uma observação do universo de fontes e contamos domínios distintos, não slots de citação. O Gemini devolveu 989 anotações de fonte nas suas 20 respostas, mas muitas apontavam para a mesma página, então a contagem de domínios é a unidade honesta aqui. Os dados no nível de anotação estão na análise do verificador de visibilidade em IA.
Resultado 1: a lista nunca fecha
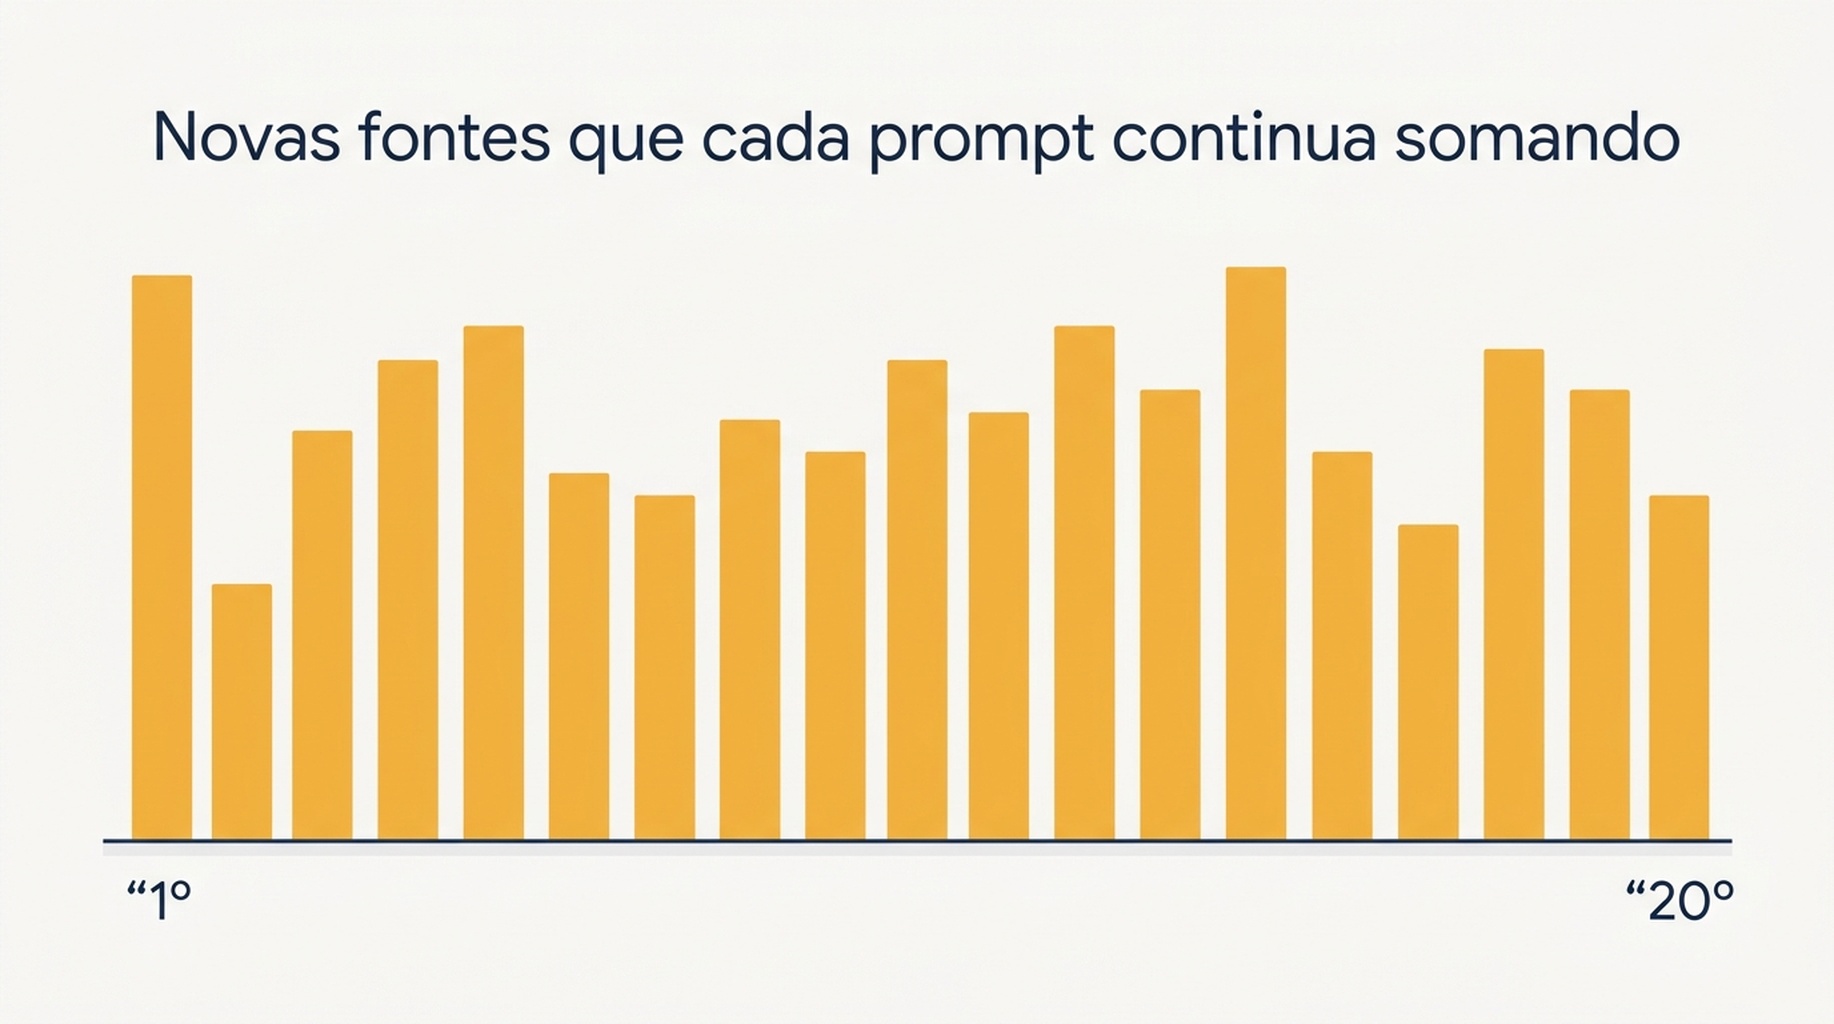
É esta parte que decide como um programa de monitoramento deve ser construído. Depois de cada prompt, somávamos seus domínios novos a tudo o que já tinha sido encontrado.
Prompts rodados | Fontes distintas encontradas | Fatia do total dos 20 prompts |
|---|---|---|
1 | 34 | 8 por cento |
3 | 91 | 21 por cento |
5 | 134 | 31 por cento |
10 | 235 | 54 por cento |
15 | 336 | 78 por cento |
20 | 432 | 100 por cento |
O último prompt acrescentou 14 domínios que nenhum prompt anterior tinha revelado. O menor ganho marginal ao longo dos 20 prompts foi 14, e o maior foi 34. Não há, nesse intervalo, nenhum ponto em que mais um prompt deixe de se pagar, o que significa que uma lista de prompts não é uma amostra que se completa, e sim uma amostra que se continua tirando.
A versão prática: uma lista de cinco prompts escrita de memória cobre cerca de um terço do que vinte prompts cobrem. É essa a diferença entre um programa de monitoramento que percebe mudança de categoria e um que reporta as mesmas cinco respostas todo mês.
Resultado 2: cada superfície enxerga um terço diferente do mesmo espaço
Os 432 domínios não se distribuíram de forma uniforme. Cada superfície alcançou uma fatia diferente do mesmo conjunto de perguntas.
Superfície | Fontes distintas | Fatia dos 432 | Mediana de fontes por resposta |
|---|---|---|---|
ChatGPT | 47 | 11 por cento | 0 |
Gemini 2.5 Flash | 184 | 43 por cento | 12 |
Perplexity | 285 | 66 por cento | 19 |
Gemini e Perplexity juntos encontraram 400 dos 432 domínios, ou seja, o ChatGPT acrescentou 32 domínios que nenhuma outra superfície revelou. Nos 12 prompts em que o ChatGPT não buscou, essa superfície não contribuiu em nada, e é por isso que sua mediana é zero.
A consequência para o monitoramento é desconfortável. Se o seu rastreador observa uma única superfície, você não está rodando uma versão menor de um programa de três superfícies. Você está reportando outra população de fontes, e a resposta a "estamos sendo citados mais neste mês" pode ser simplesmente "não mudamos nada e a superfície mudou". Medimos o mesmo efeito no nível da resposta em variação de execução do rastreador de visibilidade em IA.
Resultado 3: duas superfícies raramente concordam no mesmo prompt
Comparamos as listas de fontes que Gemini e Perplexity produziram para o mesmo prompt, no mesmo dia e no mesmo idioma.
- As duas listas compartilharam em média 2,5 domínios, de cerca de vinte em cada uma.
- A sobreposição média de Jaccard foi de 0,089.
- E em apenas 3 dos 8 prompts em que o ChatGPT também devolveu fontes as três superfícies compartilharam ao menos um domínio, com a maior sobreposição tripla em 2 domínios.
- Concordância total das três superfícies em um único prompt nunca aconteceu.
Duas respostas para a mesma pergunta, montadas a partir de conjuntos de páginas quase disjuntos. É o argumento mais forte que encontramos contra o relatório de superfície única, e também é uma boa notícia: uma página nova tem muito mais chances de ser capturada do que uma única lista de fontes sugere.
Resultado 4: a maioria das fontes aparece uma vez
Os 432 domínios são distribuídos de forma extremamente desigual.
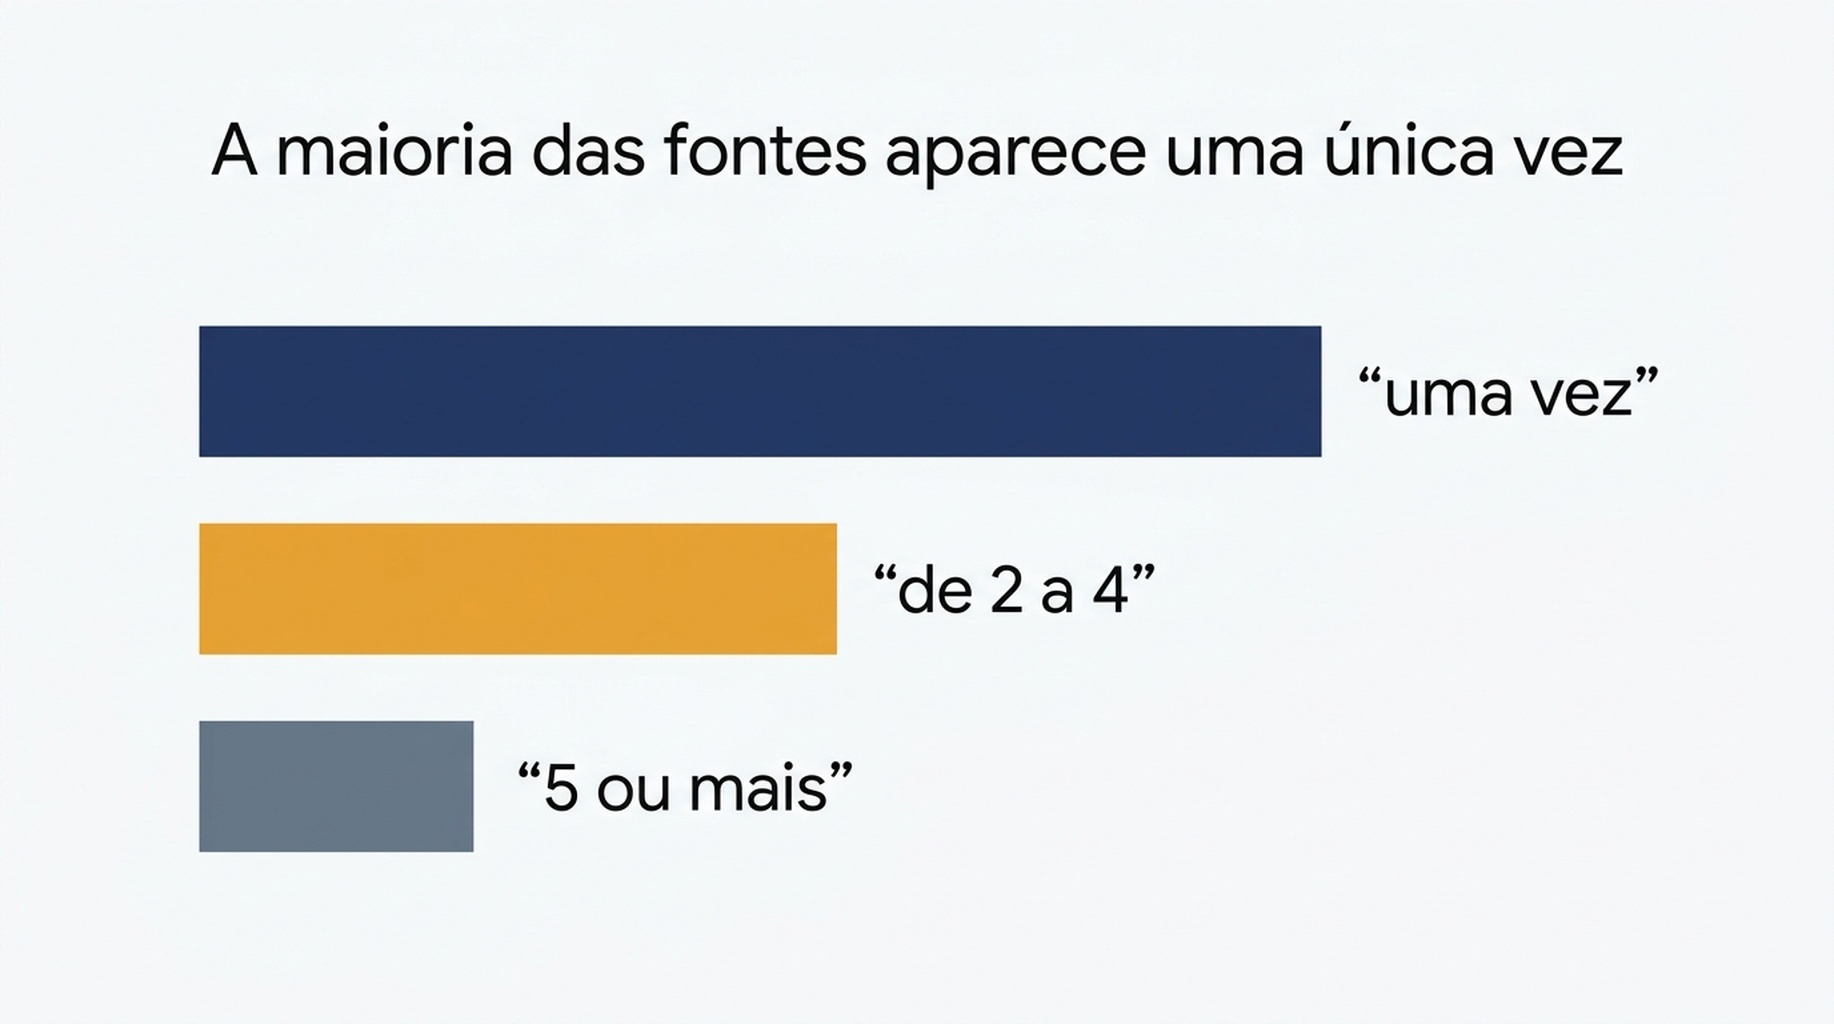
- 324 dos 432 domínios, ou 75 por cento, apareceram em exatamente uma das 60 respostas.
- Apenas 17 domínios apareceram em 5 respostas ou mais.
- O núcleo recorrente é pequeno e previsível: ahrefs.com em 16 respostas, semrush.com em 15, reddit.com em 14, depois frase.io com 9, e um agrupamento em 6 que inclui otterly.ai, tryprofound.com, llmpulse.ai, cognizo.ai e searchenginejournal.com.
Isso divide o trabalho de monitoramento em dois, e as duas metades querem cadências diferentes. O núcleo recorrente é a camada que se revisa com frequência, porque uma mudança ali é uma mudança real numa fonte compartilhada. A cauda de aparições únicas é a camada que se amostra, porque 75 por cento do universo é ruído até se repetir.
O que monitorar em vez de uma lista completa
Camada | O que entra nela | Cadência | Custo mensal de dados |
|---|---|---|---|
Camada 1: núcleo recorrente | Os 17 domínios que se repetem, mais o seu domínio e os três concorrentes mais próximos | Semanal em uma superfície | 0,48 dólar no Perplexity, 3,23 dólares no Gemini |
Camada 2: painel de prompts | De 15 a 20 prompts cobrindo categoria, comparação, preço e formulação de problema | Mensal nas três superfícies | 1,44 dólar por passagem |
Camada 3: descoberta de prompts | 5 prompts novos por mês, escritos a partir de ligações de vendas e tickets de suporte | Revisão trimestral, depois promoção ou descarte | Incluído na passagem mensal |
Três regras saíram dessa rodagem.
- Registre a classe do prompt, não apenas o prompt. Nossa resposta mais ampla veio de um prompt sobre como ser citado, e não de uma comparação de ferramentas, e a mais estreita veio justamente de uma comparação. As classes se comportam de formas diferentes, e é a classe que você reporta.
- Mantenha a superfície em cada registro. Uma contagem de citações sem o nome da superfície não é comparável, porque os comprimentos das listas variam por um fator de três.
- Gire os prompts de descoberta. Vinte prompts encontraram 432 domínios, e a curva diz que outros vinte encontrariam outras centenas. Promoção e aposentadoria são o único mecanismo que mantém o painel honesto.
O custo não é a restrição aqui. Uma passagem completa de vinte prompts nas três superfícies custou 1.444 dólares, então um programa mensal fica em cerca de 17 dólares por ano em dados, antes do tempo de revisão. A restrição é que o tempo de revisão é a metade cara, e por isso a estrutura de camadas importa mais que o comprimento da lista. A própria superfície de IA do Google não está neste painel e exige outro instrumento, como explica o nosso rastreador de AI Overview.
Limites
- Um dia, um local, inglês, três superfícies, uma versão de modelo para cada.
- A contagem de domínios remove duplicatas dentro de uma resposta, então uma página citada cinco vezes conta uma vez.
- As classes de prompt foram atribuídas por nós, não por qualquer taxonomia externa.
- Os números de custo cobrem apenas a geração de respostas.
- A contribuição do ChatGPT está deprimida pelos 12 prompts em que ele não buscou, e isso é uma propriedade daquela superfície, não do conjunto de prompts.
Perguntas frequentes
Quantos prompts eu preciso para monitoramento de marca em IA?
Não existe ponto de conclusão nos nossos dados. Vinte prompts encontraram 432 fontes e o vigésimo ainda acrescentou 14 novas. Escolha um tamanho de painel que você consiga revisar todo mês e gaste o esforço na qualidade e na rotação dos prompts, não no comprimento da lista.
Devo monitorar uma superfície de IA ou várias?
Várias, e reportá-las separadamente. As duas superfícies mais pesadas compartilharam em média 2,5 fontes por prompt, e a concordância tripla completa nunca aconteceu. Um programa de superfície única mede aquela superfície, não a sua categoria.
Um domínio que aparece uma vez vale a pena ser rastreado?
Só como observação. 324 dos 432 domínios apareceram uma vez, então uma aparição única está mais perto de ruído do que de sinal. Promova um domínio para a camada recorrente depois que ele aparecer numa segunda resposta, de preferência numa segunda superfície.
Com que frequência o painel deve rodar?
Mensal para o painel completo, semanal para o núcleo recorrente. A lista recorrente é curta o bastante para que uma passagem semanal numa superfície barata custe menos de cinquenta centavos por mês, e é na passagem mensal que novas fontes entram.
Visão da Auspia: pare de dimensionar listas de prompts pela sensação de rigor e comece a medir quando elas deixam de encontrar qualquer coisa. Nos nossos dados esse ponto nunca chegou, o que significa que a unidade certa de planejamento são as classes de prompt e a rotação, não uma lista mais longa. Estratifique as fontes recorrentes, amostre a cauda e mantenha o nome da superfície colado a cada número que você reporta.
Autor: Elena Shaw