Setiap pelan pemantauan jenama dalam AI bermula dengan senarai prompt, dan hampir setiap senarai itu dibina daripada apa yang pasukan sudah percaya. Dua puluh prompt nampak teliti. Lima puluh nampak lengkap. Tiada siapa menyemak sama ada senarai itu masih menemui sesuatu.
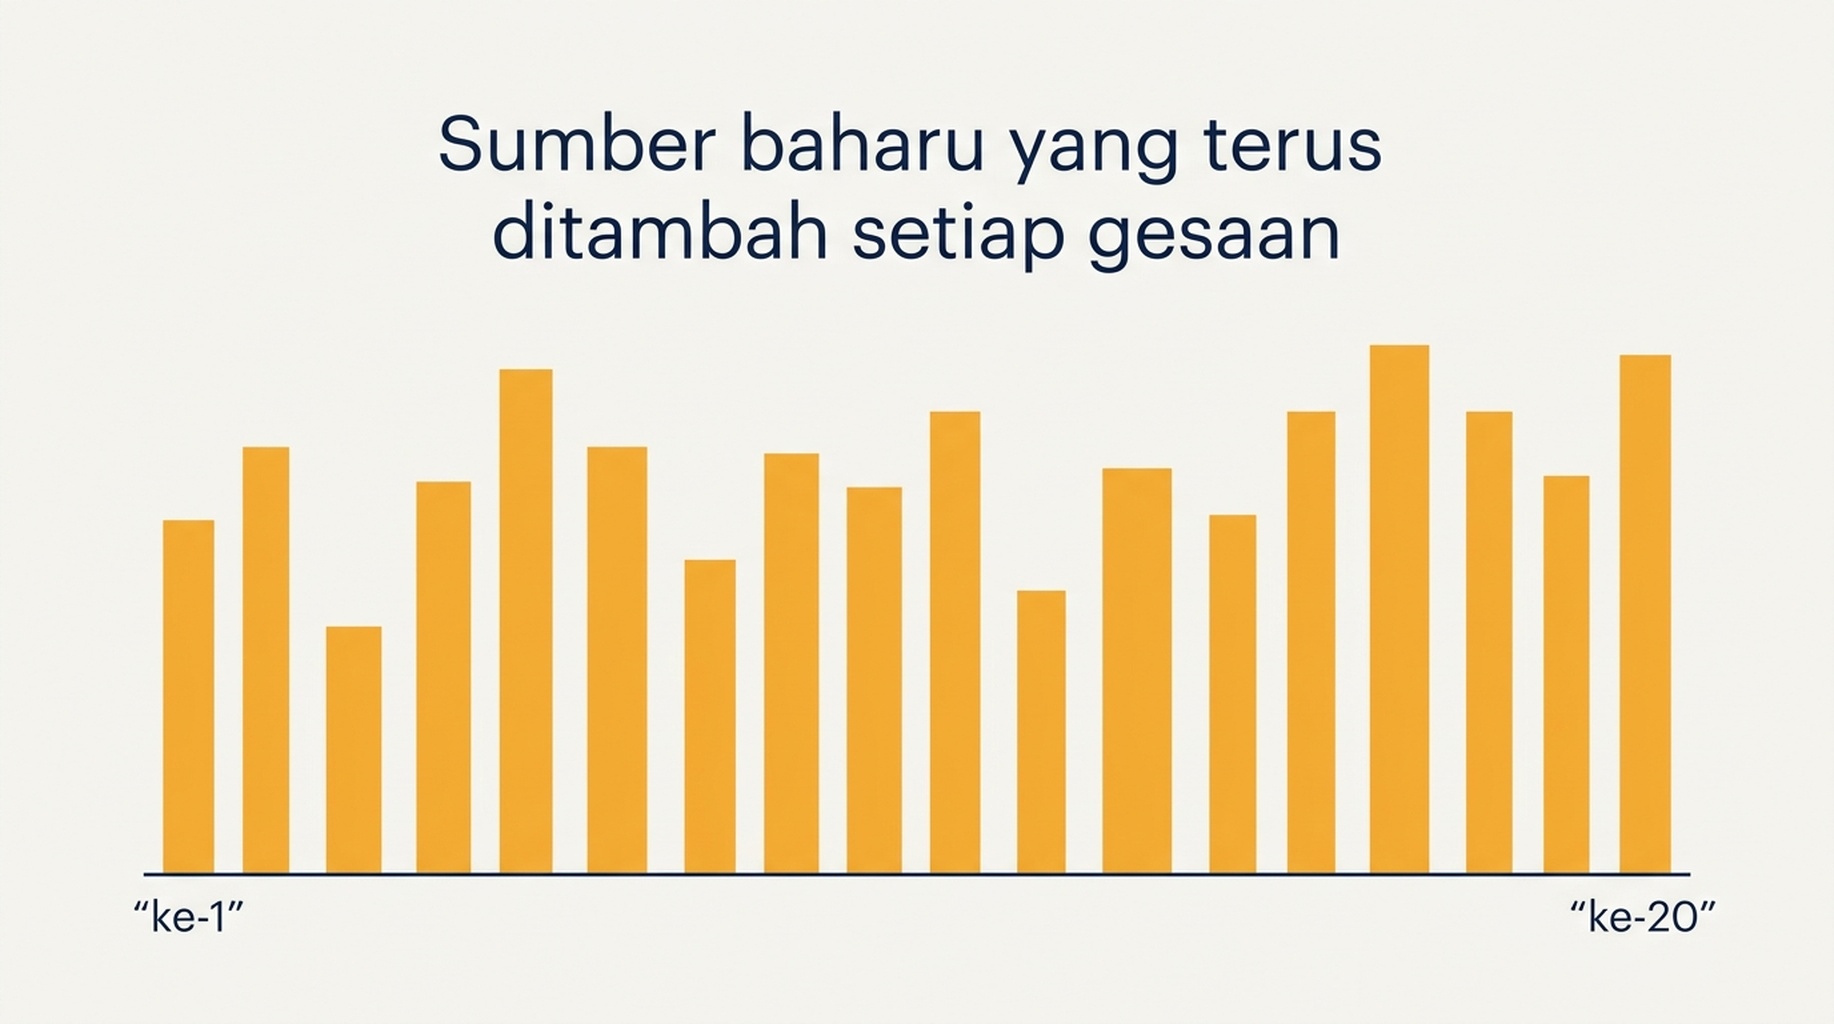
Pada September 2026 kami menjalankan dua puluh prompt merentas tiga permukaan AI dan menjejaki satu perkara sahaja: dari mana sumbernya datang. Bukan sebutan jenama kami, tetapi keseluruhan set domain yang ditarik oleh jawapan. Jika senarai prompt itu lengkap, menambah prompt sepatutnya berhenti menemui sumber baharu. Ia tidak berhenti.
Apa yang kami ukur
Perkara | Tetapan |
|---|---|
Prompt | 20 soalan pembeli tentang alat keterlihatan AI |
Permukaan | ChatGPT (gpt-5), Gemini 2.5 Flash, Perplexity (sonar), carian web dihidupkan |
Jawapan dikumpul | 60 |
Sumber berbeza ditemui | 432 domain |
Kos satu pusingan penuh | 1.444 dolar |
Liputan berulang | 5 prompt dijalankan dua kali pada hari yang sama |
Kami menganggap setiap satu daripada 60 jawapan sebagai satu pemerhatian ke atas alam sumber dan mengira domain berbeza, bukan slot petikan. Gemini memulangkan 989 anotasi sumber pada 20 jawapannya, tetapi banyak daripadanya menunjuk ke halaman yang sama, jadi kiraan domain ialah unit yang jujur di sini. Data pada peringkat anotasi ada dalam analisis pemeriksa keterlihatan AI.
Hasil 1: senarai itu tidak pernah tertutup
Bahagian inilah yang menentukan cara sesuatu program pemantauan perlu dibina. Selepas setiap prompt, kami menambah domain baharunya kepada semua yang telah ditemui sebelum itu.
Prompt dijalankan | Sumber berbeza ditemui | Bahagian daripada jumlah 20 prompt |
|---|---|---|
1 | 34 | 8 peratus |
3 | 91 | 21 peratus |
5 | 134 | 31 peratus |
10 | 235 | 54 peratus |
15 | 336 | 78 peratus |
20 | 432 | 100 peratus |
Prompt terakhir menambah 14 domain yang tidak pernah muncul melalui mana-mana prompt sebelumnya. Keuntungan marginal terkecil sepanjang 20 prompt ialah 14, dan terbesar 34. Tiada titik dalam julat itu di mana satu prompt tambahan berhenti membayar balik kosnya, yang bermaksud senarai prompt bukan sampel yang anda lengkapkan, tetapi sampel yang anda terus tarik.
Versi praktikalnya: senarai lima prompt yang ditulis dari ingatan meliputi kira-kira satu pertiga daripada apa yang diliputi dua puluh prompt. Di situlah jurang antara program pemantauan yang perasan perubahan kategori dan program yang melaporkan lima jawapan yang sama setiap bulan.
Hasil 2: setiap permukaan melihat satu pertiga yang berbeza daripada ruang yang sama
432 domain itu tidak bertaburan sama rata. Setiap permukaan mencapai hirisan yang berbeza daripada set soalan yang sama.
Permukaan | Sumber berbeza | Bahagian daripada 432 | Median sumber setiap jawapan |
|---|---|---|---|
ChatGPT | 47 | 11 peratus | 0 |
Gemini 2.5 Flash | 184 | 43 peratus | 12 |
Perplexity | 285 | 66 peratus | 19 |
Gemini dan Perplexity bersama-sama menemui 400 daripada 432 domain, jadi ChatGPT menambah 32 domain yang tidak muncul melalui permukaan lain. Pada 12 prompt yang ChatGPT tidak membuat carian, permukaan itu tidak menyumbang apa-apa, dan itulah sebabnya mediannya sifar.
Kesannya kepada pemantauan tidak selesa. Jika penjejak anda memerhati satu permukaan sahaja, anda tidak menjalankan versi kecil bagi program tiga permukaan. Anda melaporkan populasi sumber yang berbeza, dan jawapan kepada "adakah kami dipetik lebih banyak bulan ini" boleh jadi sekadar "kami tidak mengubah apa-apa, permukaan itulah yang berubah". Kami mengukur kesan yang sama pada peringkat jawapan dalam kebolehubahan jalannya penjejak keterlihatan AI.
Hasil 3: dua permukaan jarang bersetuju pada prompt yang sama
Kami membandingkan senarai sumber yang dihasilkan Gemini dan Perplexity untuk prompt yang sama, pada hari yang sama dan dalam bahasa yang sama.
- Kedua-dua senarai berkongsi purata 2,5 domain daripada kira-kira dua puluh setiap satu.
- Purata pertindihan Jaccard ialah 0,089.
- Dan hanya pada 3 daripada 8 prompt yang ChatGPT juga memulangkan sumber, ketiga-tiga permukaan berkongsi sekurang-kurangnya satu domain, dengan pertindihan tiga hala terbesar dua domain.
- Persetujuan penuh ketiga-tiga permukaan pada satu prompt tidak pernah berlaku.
Dua jawapan kepada soalan yang sama, dibina daripada set halaman yang hampir terpisah. Itulah hujah paling kuat yang kami temui menentang pelaporan daripada satu permukaan, dan ia juga berita baik: satu halaman baharu mempunyai lebih banyak peluang untuk diambil berbanding apa yang disiratkan oleh satu senarai sumber.
Hasil 4: kebanyakan sumber muncul sekali sahaja
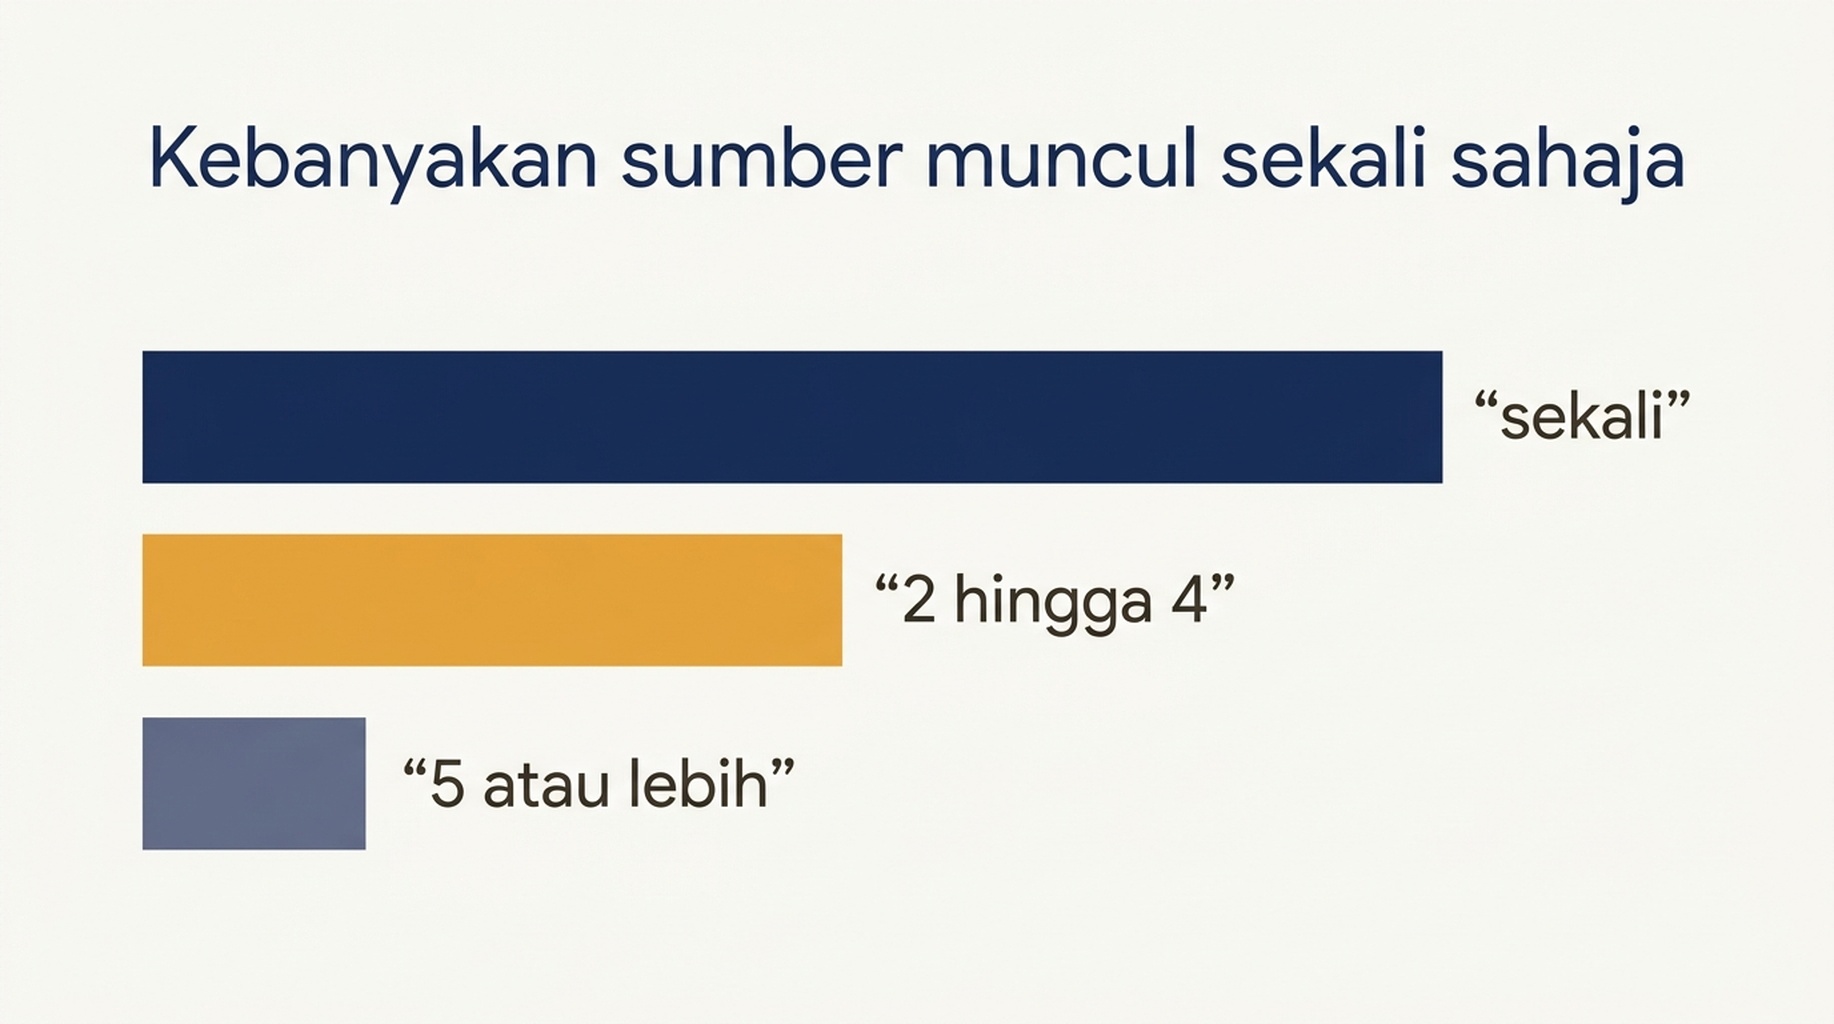
432 domain itu bertaburan amat tidak seimbang.
- 324 daripada 432 domain, iaitu 75 peratus, muncul dalam tepat satu daripada 60 jawapan.
- Hanya 17 domain muncul dalam 5 jawapan atau lebih.
- Teras berulang itu kecil dan boleh dijangka: ahrefs.com dalam 16 jawapan, semrush.com dalam 15, reddit.com dalam 14, kemudian frase.io pada 9, dan satu kelompok pada 6 yang merangkumi otterly.ai, tryprofound.com, llmpulse.ai, cognizo.ai dan searchenginejournal.com.
Ini membahagikan kerja pemantauan kepada dua, dan kedua-dua bahagian mahukan kadar yang berbeza. Teras berulang ialah lapisan yang kerap disemak semula, kerana perubahan di situ ialah anjakan sebenar dalam sumber yang dikongsi. Ekor kemunculan sekali ialah lapisan yang disampel, kerana 75 peratus alam ini ialah hingar sehingga ia berulang.
Apa yang perlu dipantau sebagai ganti senarai lengkap
Lapisan | Apa isinya | Kadar | Kos data bulanan |
|---|---|---|---|
Lapisan 1: teras berulang | 17 domain berulang itu, ditambah domain anda dan tiga pesaing terdekat | Mingguan pada satu permukaan | 0,48 dolar pada Perplexity, 3,23 dolar pada Gemini |
Lapisan 2: panel prompt | 15 hingga 20 prompt yang merangkumi kategori, perbandingan, harga dan rumusan masalah | Bulanan pada ketiga-tiga permukaan | 1,44 dolar setiap pusingan |
Lapisan 3: penemuan prompt | 5 prompt baharu sebulan, ditulis daripada panggilan jualan dan tiket sokongan | Semakan setiap suku tahun, kemudian naik taraf atau buang | Termasuk dalam pusingan bulanan |
Tiga peraturan muncul daripada pusingan ini.
- Catat kelas prompt, bukan sekadar prompt. Jawapan kami yang paling luas datang daripada prompt tentang cara untuk dipetik sama sekali, bukan daripada perbandingan alat, dan yang paling sempit datang daripada perbandingan. Setiap kelas berkelakuan berbeza, dan yang dilaporkan ialah kelas itu.
- Simpan nama permukaan dalam setiap rekod. Bilangan petikan tanpa nama permukaan tidak boleh dibandingkan, kerana panjang senarai berbeza dengan faktor tiga.
- Putarkan prompt penemuan. Dua puluh prompt menemui 432 domain, dan lengkungnya mengatakan dua puluh yang lain akan menemui beberapa ratus yang berbeza. Naik taraf dan persaraan ialah satu-satunya mekanisme yang memastikan panel itu jujur.
Kos bukanlah kekangan di sini. Satu pusingan penuh dua puluh prompt pada tiga permukaan berharga 1.444 dolar, jadi program bulanan berlegar sekitar 17 dolar setahun untuk data, sebelum masa semakan. Kekangannya ialah masa semakan itulah separuh yang mahal, dan itulah sebabnya struktur berlapis lebih penting daripada panjang senarai. Permukaan AI milik Google langsung tiada dalam panel ini dan memerlukan alat ukur lain, seperti yang dijelaskan oleh penjejak AI Overview kami.
Batasan
- Satu hari, satu lokasi, bahasa Inggeris, tiga permukaan, satu versi model bagi setiap satu.
- Kiraan domain membuang pertindihan dalam satu jawapan, jadi halaman yang dipetik lima kali dikira sekali.
- Kelas prompt kami tetapkan sendiri, bukan oleh mana-mana taksonomi luar.
- Angka kos hanya meliputi penjanaan jawapan.
- Sumbangan ChatGPT ditindih oleh 12 prompt yang ia tidak membuat carian, dan itu sifat permukaan tersebut, bukan sifat set prompt.
Soalan lazim
Berapa banyak prompt yang saya perlukan untuk pemantauan jenama dalam AI?
Tiada titik kesempurnaan dalam data kami. Dua puluh prompt menemui 432 sumber dan yang kedua puluh masih menambah 14 sumber baharu. Pilih saiz panel yang mampu anda semak setiap bulan, kemudian belanjakan usaha pada kualiti prompt dan putarannya, bukan pada panjang senarai.
Perlukah saya memantau satu permukaan AI atau beberapa?
Beberapa, dan laporkan secara berasingan. Dua permukaan paling berat hanya berkongsi purata 2,5 sumber setiap prompt, dan persetujuan tiga hala penuh tidak pernah berlaku. Program satu permukaan mengukur permukaan itu, bukan kategori anda.
Adakah domain yang muncul sekali sahaja berbaloi dijejaki?
Hanya sebagai pemerhatian. 324 daripada 432 domain muncul sekali, jadi kemunculan tunggal lebih dekat kepada hingar daripada isyarat. Naik taraf domain ke lapisan berulang selepas ia muncul dalam jawapan kedua, sebaik-baiknya pada permukaan kedua.
Berapa kerap panel itu perlu dijalankan?
Bulanan untuk panel penuh, mingguan untuk teras berulang. Senarai berulang itu cukup pendek sehingga pusingan mingguan pada permukaan yang murah berharga bawah lima puluh sen sebulan, dan pusingan bulananlah tempat sumber baharu masuk.
Pandangan Auspia: berhentilah mensaiz senarai prompt berdasarkan betapa telitinya ia terasa dan mulakan mengukur bila ia berhenti menemui apa-apa. Dalam data kami titik itu tidak pernah tiba, yang bermaksud unit perancangan yang betul ialah kelas prompt dan putaran, bukan satu senarai yang lebih panjang. Lapiskan sumber berulang, sampelkan ekornya, dan lekatkan nama permukaan pada setiap angka yang anda laporkan.
Penulis: Elena Shaw