Każdy plan monitoringu marki w AI zaczyna się od listy promptów, a niemal każda taka lista powstaje z tego, w co zespół już wierzy. Dwadzieścia promptów brzmi rzetelnie. Pięćdziesiąt brzmi wyczerpująco. Nikt nie sprawdza, czy lista wciąż cokolwiek odkrywa.
We wrześniu 2026 roku przepuściliśmy dwadzieścia promptów przez trzy powierzchnie AI i śledziliśmy jedno: skąd pochodzą źródła. Nie wzmianki o naszej marce, ale cały zbiór domen, które przyciągnęły odpowiedzi. Jeśli lista promptów jest kompletna, dodawanie kolejnych powinno przestać znajdować nowe źródła. Tak się nie stało.
Co mierzyliśmy
Pozycja | Ustawienie |
|---|---|
Prompty | 20 pytań kupujących o narzędzia widoczności w AI |
Powierzchnie | ChatGPT (gpt-5), Gemini 2.5 Flash, Perplexity (sonar), z włączonym wyszukiwaniem w sieci |
Zebrane odpowiedzi | 60 |
Znalezione różne źródła | 432 domeny |
Koszt jednego pełnego przebiegu | 1 444 dolary |
Powtarzalne pokrycie | 5 promptów uruchomionych dwa razy tego samego dnia |
Każdą z 60 odpowiedzi potraktowaliśmy jako jedną obserwację wszechświata źródeł i liczyliśmy różne domeny, a nie sloty cytowań. Gemini zwrócił 989 adnotacji źródeł w swoich 20 odpowiedziach, ale wiele z nich wskazywało tę samą stronę, więc uczciwą jednostką jest tu liczba domen. Dane na poziomie adnotacji są w analizie sprawdzacza widoczności w AI.
Wynik 1: lista nigdy się nie zamyka
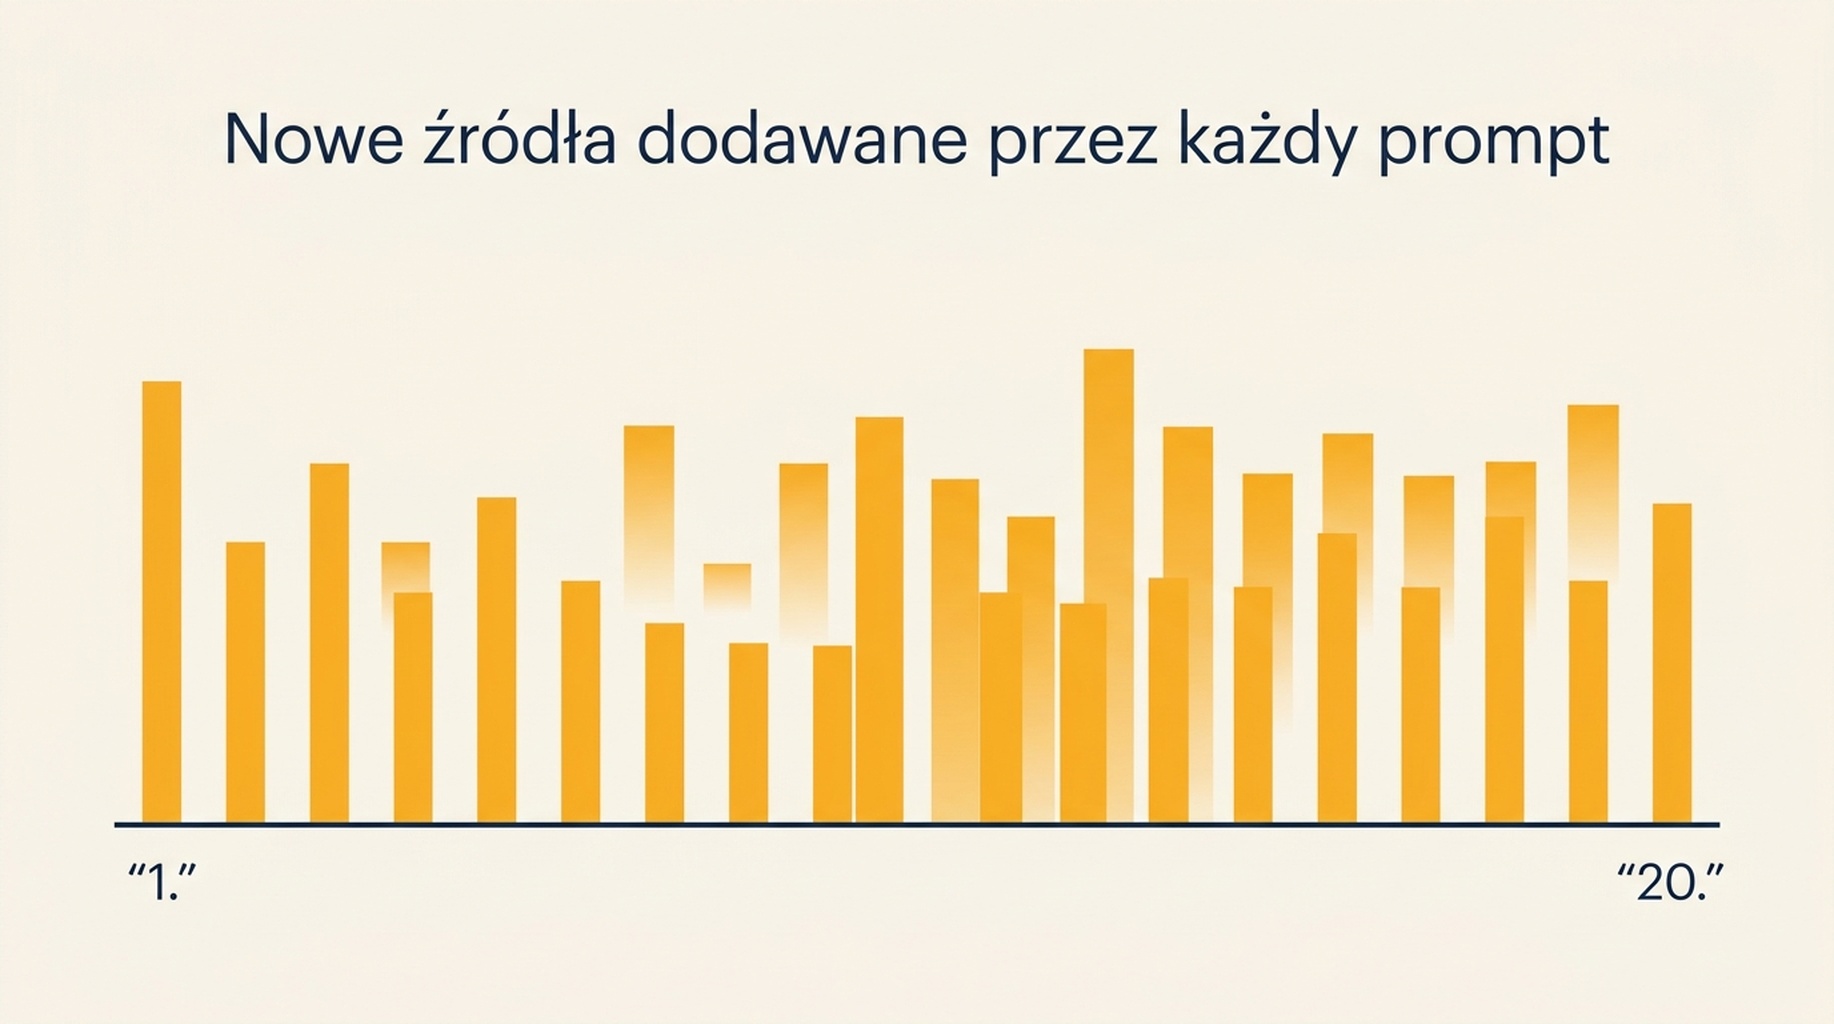
Właśnie ta część decyduje o tym, jak zbudować program monitoringu. Po każdym promptcie dodawaliśmy jego nowe domeny do wszystkiego, co znaleziono wcześniej.
Uruchomione prompty | Znalezione różne źródła | Udział w sumie z 20 promptów |
|---|---|---|
1 | 34 | 8 procent |
3 | 91 | 21 procent |
5 | 134 | 31 procent |
10 | 235 | 54 procent |
15 | 336 | 78 procent |
20 | 432 | 100 procent |
Ostatni prompt dodał 14 domen, których nie pokazał żaden wcześniejszy. Najmniejszy przyrost krańcowy w całych 20 promptach wyniósł 14, największy 34. W tym zakresie nie ma punktu, w którym kolejny prompt przestaje się zwracać, co oznacza, że lista promptów nie jest próbką, którą się uzupełnia, lecz próbką, którą się dalej losuje.
Wersja praktyczna: lista pięciu promptów napisana z pamięci pokrywa około jednej trzeciej tego, co pokrywa dwadzieścia. Na tym polega różnica między programem monitoringu, który zauważa zmianę kategorii, a programem, który co miesiąc raportuje te same pięć odpowiedzi.
Wynik 2: każda powierzchnia widzi inną trzecią część tej samej przestrzeni
432 domeny nie rozłożyły się równomiernie. Każda powierzchnia dotarła do innego wycinka tego samego zestawu pytań.
Powierzchnia | Różne źródła | Udział w 432 | Mediana źródeł na odpowiedź |
|---|---|---|---|
ChatGPT | 47 | 11 procent | 0 |
Gemini 2.5 Flash | 184 | 43 procent | 12 |
Perplexity | 285 | 66 procent | 19 |
Gemini i Perplexity razem znalazły 400 z 432 domen, czyli ChatGPT dodał 32 domeny, których nie pokazała żadna inna powierzchnia. W tych 12 promptach, w których ChatGPT nie szukał, ta powierzchnia nie wniosła zupełnie nic, i dlatego jej mediana wynosi zero.
Wniosek dla monitoringu jest niewygodny. Jeśli twoje narzędzie śledzi jedną powierzchnię, nie uruchamiasz pomniejszonej wersji programu z trzema powierzchniami. Raportujesz o innej populacji źródeł, a odpowiedź na pytanie „czy w tym miesiącu cytują nas częściej” może brzmieć po prostu „nic nie zmieniliśmy, zmieniła się powierzchnia”. Ten sam efekt zmierzyliśmy na poziomie odpowiedzi w rozrzucie przebiegów trackera widoczności w AI.
Wynik 3: dwie powierzchnie rzadko zgadzają się co do tego samego promptu
Porównaliśmy listy źródeł, które Gemini i Perplexity wygenerowały dla tego samego promptu, tego samego dnia, w tym samym języku.
- Obie listy dzieliły średnio 2,5 domeny z około dwudziestu w każdej.
- Średnie pokrycie Jaccarda wyniosło 0,089.
- I tylko w 3 z 8 promptów, w których ChatGPT również zwrócił źródła, wszystkie trzy powierzchnie podzieliły choć jedną domenę, a największe potrójne pokrycie wyniosło 2 domeny.
- Pełna zgodność wszystkich trzech powierzchni na jednym promptcie nie zdarzyła się ani razu.
Dwie odpowiedzi na to samo pytanie, zbudowane z niemal rozłącznych zbiorów stron. To najmocniejszy argument przeciw raportowaniu z jednej powierzchni, jaki znaleźliśmy, a zarazem dobra wiadomość: nowa strona ma znacznie więcej szans na podchwycenie, niż sugeruje pojedyncza lista źródeł.
Wynik 4: większość źródeł pojawia się raz
432 domeny rozkładają się skrajnie nierówno.
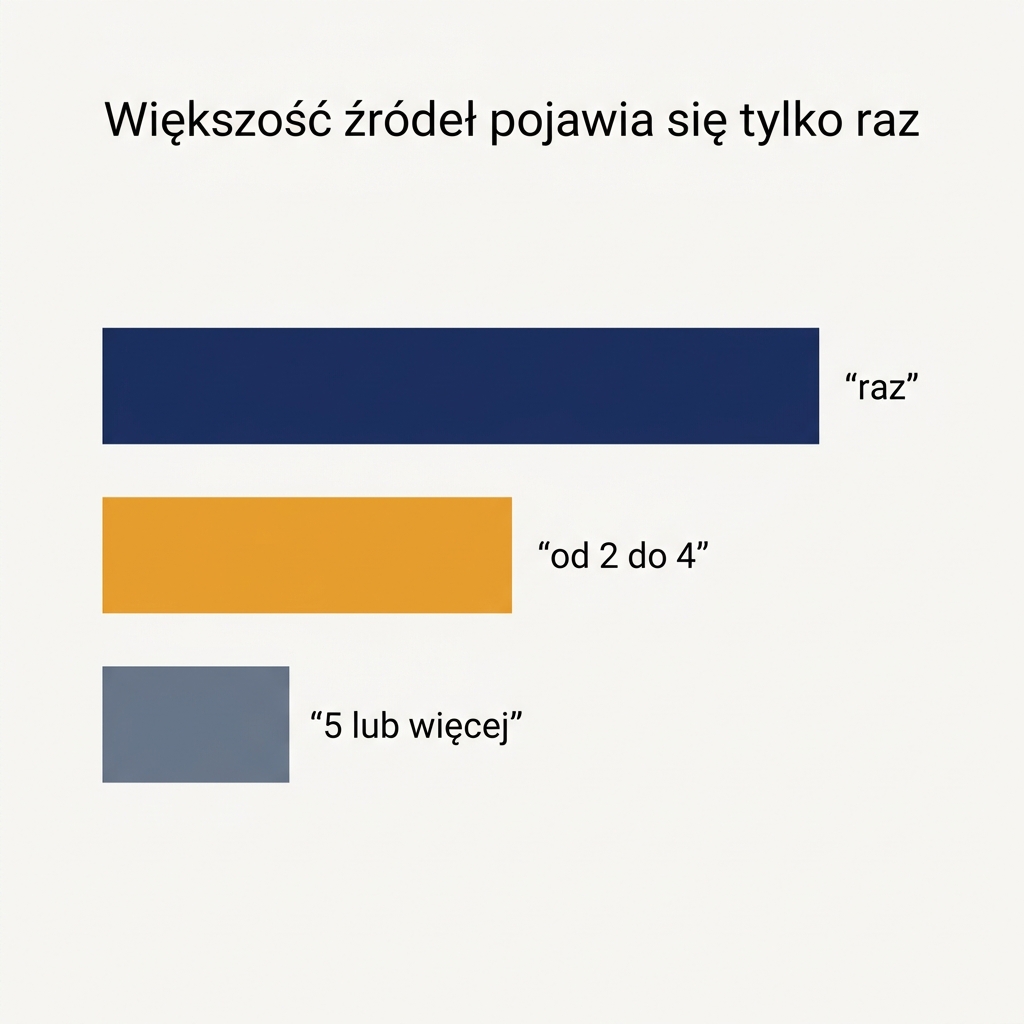
- 324 z 432 domen, czyli 75 procent, pojawiły się dokładnie w jednej z 60 odpowiedzi.
- Tylko 17 domen pojawiło się w 5 odpowiedziach lub więcej.
- Powtarzający się rdzeń jest mały i przewidywalny: ahrefs.com w 16 odpowiedziach, semrush.com w 15, reddit.com w 14, potem frase.io z 9 i klaster po 6, obejmujący otterly.ai, tryprofound.com, llmpulse.ai, cognizo.ai i searchenginejournal.com.
To dzieli pracę monitoringową na pół i obie połowy chcą innego rytmu. Powtarzający się rdzeń to warstwa sprawdzana często, bo zmiana tam oznacza realną zmianę we wspólnym źródle. Ogon jednorazowych wystąpień to warstwa próbkowana, bo 75 procent wszechświata jest szumem, dopóki się nie powtórzy.
Co monitorować zamiast kompletnej listy
Warstwa | Co wchodzi | Rytm | Miesięczny koszt danych |
|---|---|---|---|
Warstwa 1: powtarzający się rdzeń | 17 powtarzających się domen plus twoja domena i trzech najbliższych konkurentów | Co tydzień na jednej powierzchni | 0,48 dolara na Perplexity, 3,23 dolara na Gemini |
Warstwa 2: panel promptów | Od 15 do 20 promptów obejmujących kategorię, porównanie, cenę i sformułowanie problemu | Co miesiąc na wszystkich trzech powierzchniach | 1,44 dolara za przebieg |
Warstwa 3: odkrywanie promptów | 5 nowych promptów miesięcznie, pisanych z rozmów sprzedażowych i zgłoszeń do wsparcia | Przegląd kwartalny, potem awans albo odrzucenie | Wliczone w przebieg miesięczny |
Z tego przebiegu wyszły trzy zasady.
- Zapisuj klasę promptu, nie tylko sam prompt. Nasza najszersza odpowiedź przyszła z promptu o tym, jak w ogóle zostać cytowanym, a nie z porównania narzędzi, a najwęższa właśnie z porównania. Klasy zachowują się różnie, a raportuje się klasę.
- Zachowaj powierzchnię w każdym zapisie. Liczba cytowań bez nazwy powierzchni nie jest porównywalna, bo długości list różnią się trzykrotnie.
- Rotuj prompty odkrywające. Dwadzieścia promptów znalazło 432 domeny, a krzywa mówi, że inne dwadzieścia znajdzie inne kilkaset. Awans i wycofanie to jedyny mechanizm, który utrzymuje panel w uczciwości.
Koszt nie jest tu ograniczeniem. Pełny przebieg dwudziestu promptów po trzech powierzchniach kosztował 1 444 dolary, więc miesięczny program to około 17 dolarów rocznie na dane, nie licząc czasu przeglądu. Ograniczeniem jest to, że czas przeglądu jest tą droższą połową, dlatego struktura warstw ważniejsza jest niż długość listy. Własna powierzchnia Google w ogóle nie wchodzi do tego panelu i wymaga innego przyrządu, co wyjaśnia nasz tracker AI Overview.
Ograniczenia
- Jeden dzień, jedno miejsce, angielski, trzy powierzchnie, po jednej wersji modelu na każdą.
- Liczenie domen usuwa powtórzenia wewnątrz odpowiedzi, więc strona cytowana pięć razy liczy się raz.
- Klasy promptów przypisaliśmy sami, a nie według jakiejkolwiek zewnętrznej taksonomii.
- Liczby kosztowe obejmują wyłącznie generowanie odpowiedzi.
- Wkład ChatGPT jest zaniżony przez 12 promptów, w których nie szukał, a to właściwość tej powierzchni, nie zestawu promptów.
Częste pytania
Ile promptów potrzebuję do monitoringu marki w AI?
W naszych danych nie ma punktu ukończenia. Dwadzieścia promptów znalazło 432 źródła, a dwudziesty wciąż dodał 14 nowych. Wybierz rozmiar panelu, który możesz przeglądać co miesiąc, a wysiłek przeznacz na jakość promptów i rotację, nie na długość listy.
Monitorować jedną powierzchnię AI czy kilka?
Kilka, i raportować je osobno. Dwie najcięższe powierzchnie dzieliły średnio 2,5 źródła na prompt, a pełna potrójna zgodność nie zdarzyła się ani razu. Program z jedną powierzchnią mierzy tę powierzchnię, nie twoją kategorię.
Czy domena, która pojawiła się raz, jest warta śledzenia?
Tylko jako obserwacja. 324 z 432 domen pojawiły się raz, więc pojedyncze wystąpienie bliższe jest szumowi niż sygnałowi. Awansuj domenę do warstwy powtarzających się, gdy pojawi się w drugiej odpowiedzi, najlepiej na drugiej powierzchni.
Jak często uruchamiać panel?
Co miesiąc dla pełnego panelu, co tydzień dla powtarzającego się rdzenia. Lista powtarzających się jest dość krótka, by tygodniowy przebieg na jednej taniej powierzchni kosztował poniżej pięćdziesięciu centów miesięcznie, a nowe źródła wchodzą właśnie w przebiegu miesięcznym.
Spojrzenie Auspia: przestańcie ustalać rozmiar listy promptów po tym, jak rzetelnie się ją odczuwa, i zacznijcie mierzyć, kiedy przestaje cokolwiek znajdować. W naszych danych ten punkt nigdy nie nadszedł, co znaczy, że właściwą jednostką planowania są klasy promptów i rotacja, a nie jedna dłuższa lista. Podzielcie powtarzające się źródła na warstwy, próbkujcie ogon i trzymajcie nazwę powierzchni przy każdym raportowanym numerze.
Autor: Elena Shaw