Любой план мониторинга бренда в ИИ начинается со списка запросов, и почти каждый список собран из того, во что команда уже верит. Двадцать запросов кажутся основательными. Пятьдесят кажутся исчерпывающими. Никто не проверяет, находит ли список хоть что-то новое.
В сентябре 2026 года мы прогнали двадцать запросов по трём поверхностям ИИ и отслеживали одно: откуда пришли источники. Не упоминания нашего бренда, а весь набор доменов, которые втянули ответы. Если список запросов полон, добавление новых запросов должно перестать находить новые источники. Этого не произошло.
Что мы измеряли
Пункт | Настройка |
|---|---|
Запросы | 20 покупательских вопросов об инструментах видимости в ИИ |
Поверхности | ChatGPT (gpt-5), Gemini 2.5 Flash, Perplexity (sonar), с включённым веб-поиском |
Собрано ответов | 60 |
Найдено разных источников | 432 домена |
Стоимость одного полного прогона | 1 444 доллара |
Повторное покрытие | 5 запросов прогнаны дважды в один день |
Мы рассматривали каждый из 60 ответов как одно наблюдение вселенной источников и считали разные домены, а не слоты цитирования. Gemini вернул 989 аннотаций источников на свои 20 ответов, но многие из них указывали на одну и ту же страницу, поэтому честной единицей здесь является число доменов. Данные на уровне аннотаций — в разборе чекера видимости в ИИ.
Результат 1: список никогда не закрывается
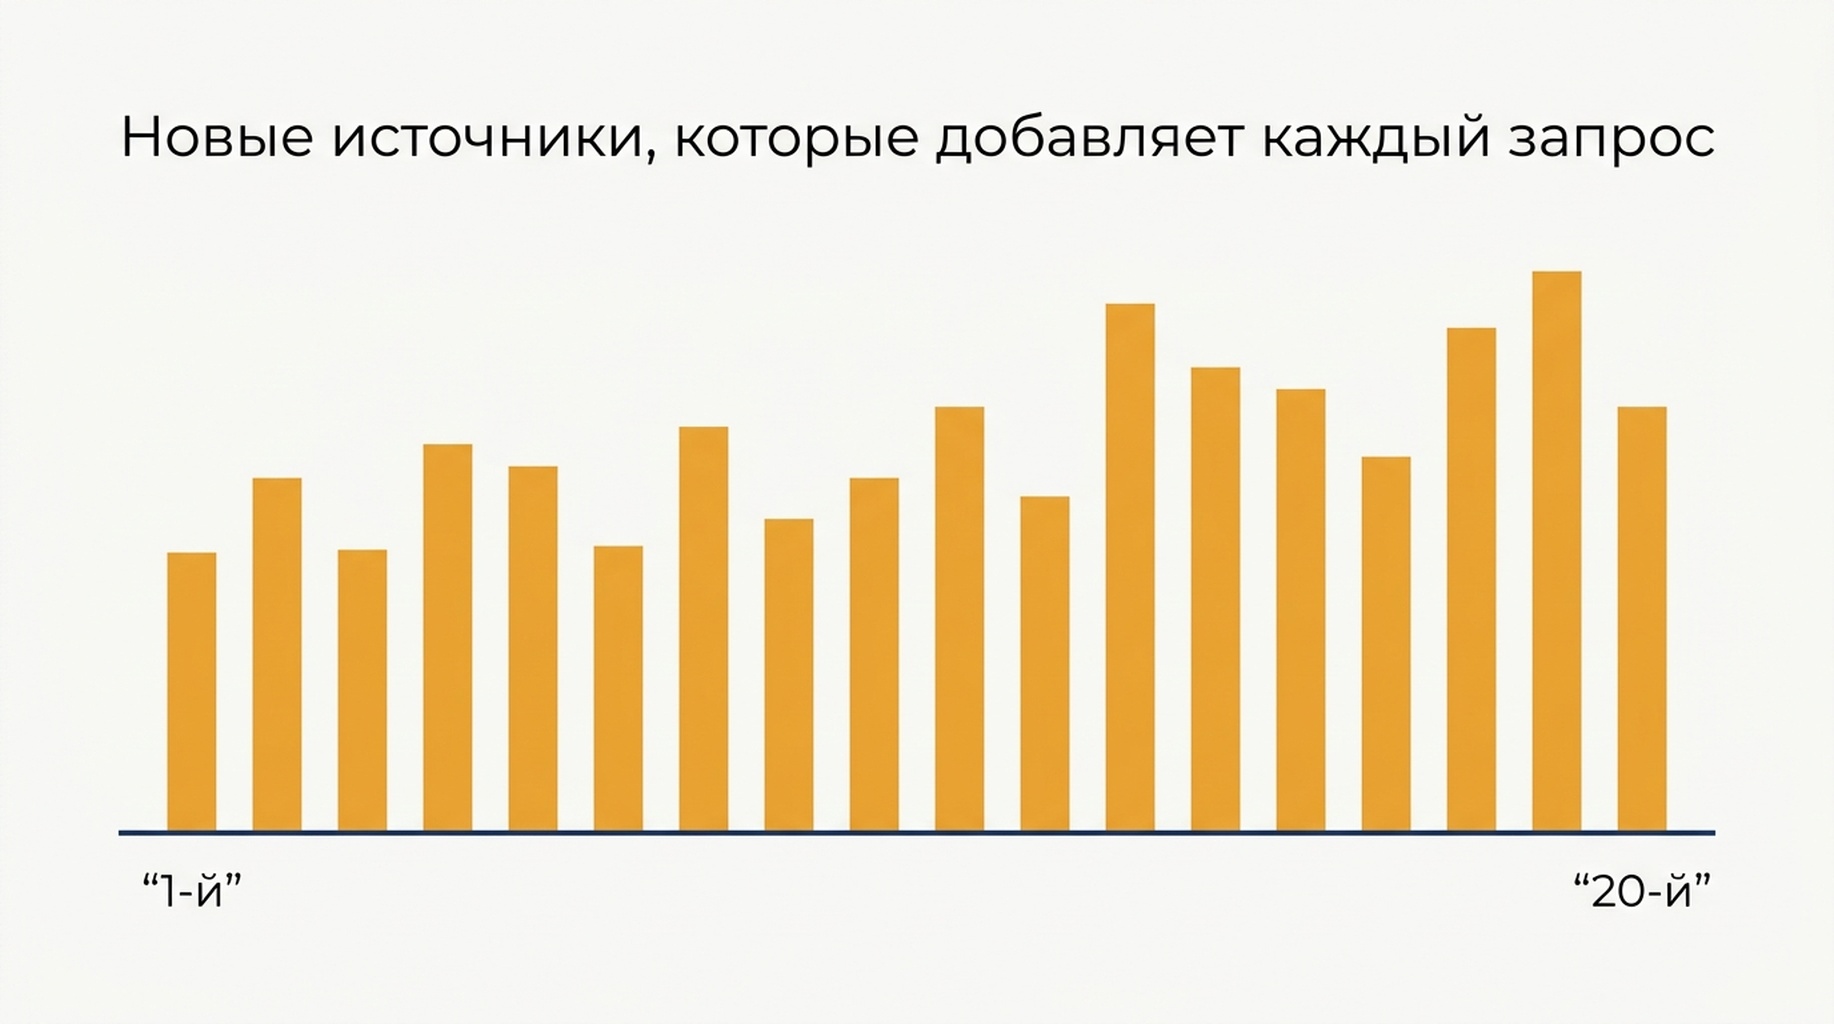
Именно эта часть определяет, как должна быть построена программа мониторинга. После каждого запроса мы добавляли его новые домены ко всему найденному ранее.
Прогнано запросов | Найдено разных источников | Доля от итога по 20 запросам |
|---|---|---|
1 | 34 | 8 процентов |
3 | 91 | 21 процент |
5 | 134 | 31 процент |
10 | 235 | 54 процента |
15 | 336 | 78 процентов |
20 | 432 | 100 процентов |
Последний запрос добавил 14 доменов, которых не показал ни один предыдущий. Наименьший предельный прирост по всем 20 запросам составил 14, наибольший — 34. В этом диапазоне нет точки, где ещё один запрос перестаёт окупаться, а значит список запросов — это не выборка, которую вы завершаете, а выборка, которую вы продолжаете тянуть.
Практическая версия: список из пяти запросов, написанный по памяти, покрывает примерно треть того, что покрывают двадцать. В этом и разрыв между программой мониторинга, которая замечает смену категории, и программой, которая каждый месяц отчитывается об одних и тех же пяти ответах.
Результат 2: каждая поверхность видит свою треть одного и того же пространства
432 домена распределились неравномерно. Каждая поверхность дотянулась до своего среза одного и того же набора вопросов.
Поверхность | Разных источников | Доля от 432 | Медиана источников на ответ |
|---|---|---|---|
ChatGPT | 47 | 11 процентов | 0 |
Gemini 2.5 Flash | 184 | 43 процента | 12 |
Perplexity | 285 | 66 процентов | 19 |
Gemini и Perplexity вдвоём нашли 400 из 432 доменов, то есть ChatGPT добавил 32 домена, которых не показала ни одна другая поверхность. На тех 12 запросах, где ChatGPT не искал, эта поверхность не дала вообще ничего, и именно поэтому её медиана равна нулю.
Вывод для мониторинга неуютен. Если ваш трекер следит за одной поверхностью, вы не запускаете уменьшенную версию программы с тремя поверхностями. Вы отчитываетесь о другой популяции источников, и ответ на вопрос «нас стали цитировать чаще в этом месяце» может быть просто «мы ничего не меняли, изменилась поверхность». Тот же эффект на уровне ответов мы измеряли в разбросе прогонов трекера видимости в ИИ.
Результат 3: две поверхности редко сходятся на одном запросе
Мы сравнили списки источников, которые Gemini и Perplexity выдали на один и тот же запрос, в один день, на одном языке.
- Два списка делили в среднем 2,5 домена из примерно двадцати у каждого.
- Среднее пересечение по Жаккару составило 0,089.
- И лишь на 3 из 8 запросов, где ChatGPT тоже вернул источники, все три поверхности разделили хотя бы один домен, а наибольшее тройное пересечение составило 2 домена.
- Полного совпадения всех трёх поверхностей на одном запросе не случилось ни разу.
Два ответа на один вопрос, собранные из почти непересекающихся наборов страниц. Это самый сильный аргумент против отчётности по одной поверхности, который мы нашли, и одновременно хорошая новость: у новой страницы гораздо больше шансов быть подхваченной, чем предполагает один список источников.
Результат 4: большинство источников появляется один раз
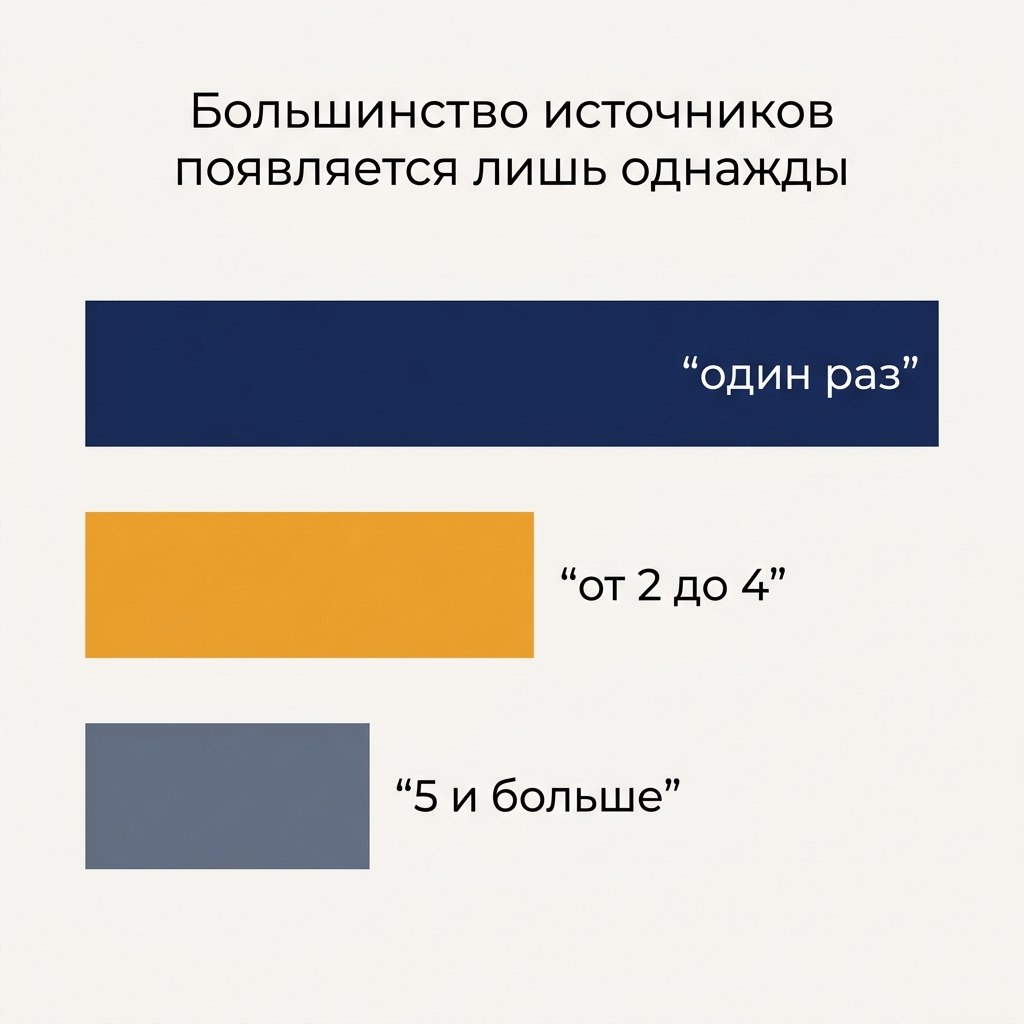
432 домена распределены крайне неравномерно.
- 324 домена из 432, то есть 75 процентов, появились ровно в одном из 60 ответов.
- Всего 17 доменов появились в 5 ответах и более.
- Повторяющееся ядро мало и предсказуемо: ahrefs.com в 16 ответах, semrush.com в 15, reddit.com в 14, затем frase.io с 9 и кластер по 6, включающий otterly.ai, tryprofound.com, llmpulse.ai, cognizo.ai и searchenginejournal.com.
Это расщепляет работу по мониторингу надвое, и обеим половинам нужен свой ритм. Повторяющееся ядро — тот слой, который перепроверяют часто, потому что изменение там означает реальный сдвиг в общем источнике. Хвост из однократных появлений — тот слой, который семплируют, потому что 75 процентов вселенной остаются шумом, пока не повторятся.
Что мониторить вместо полного списка
Слой | Что в него входит | Ритм | Месячная стоимость данных |
|---|---|---|---|
Слой 1: повторяющееся ядро | 17 повторяющихся доменов плюс ваш домен и три ближайших конкурента | Еженедельно на одной поверхности | 0,48 доллара на Perplexity, 3,23 доллара на Gemini |
Слой 2: панель запросов | От 15 до 20 запросов, покрывающих категорию, сравнение, цену и формулировку проблемы | Ежемесячно по всем трём поверхностям | 1,44 доллара за прогон |
Слой 3: обнаружение запросов | 5 новых запросов в месяц, написанных из звонков отдела продаж и обращений в поддержку | Квартальный пересмотр, затем повышение или отбрасывание | Входит в месячный прогон |
Три правила вышли из этого прогона.
- Записывайте класс запроса, а не только сам запрос. Наш самый широкий ответ пришёл от запроса о том, как вообще добиться цитирования, а не от сравнения инструментов, а самый узкий — как раз от сравнения. Классы ведут себя по-разному, и отчитываться нужно о классе.
- Сохраняйте поверхность в каждой записи. Число цитирований без имени поверхности несравнимо, потому что длины списков различаются втрое.
- Ротируйте запросы для обнаружения. Двадцать запросов нашли 432 домена, и кривая говорит, что другие двадцать найдут другие несколько сотен. Повышение и вывод из оборота — единственный механизм, который держит панель честной.
Стоимость здесь не ограничение. Полный прогон двадцати запросов по трём поверхностям стоил 1 444 доллара, так что месячная программа обходится примерно в 17 долларов в год на данные, без времени на разбор. Ограничение в том, что время на разбор и есть дорогая половина, поэтому структура слоёв важнее длины списка. Собственная поверхность Google в эту панель вообще не входит и требует другого инструмента, как объясняет наш трекер AI Overview.
Ограничения
- Один день, одно место, английский язык, три поверхности, по одной версии модели на каждую.
- Подсчёт доменов убирает повторы внутри ответа, поэтому страница, процитированная пять раз, считается один раз.
- Классы запросов мы назначили сами, а не по какой-либо внешней таксономии.
- Цифры стоимости покрывают только генерацию ответов.
- Вклад ChatGPT занижен из-за 12 запросов, где он не искал, и это свойство той поверхности, а не набора запросов.
Частые вопросы
Сколько запросов нужно для мониторинга бренда в ИИ?
В наших данных нет точки завершения. Двадцать запросов нашли 432 источника, и двадцатый всё ещё добавил 14 новых. Выберите размер панели, который вы сможете разбирать ежемесячно, а усилие тратьте на качество запросов и их ротацию, а не на длину списка.
Следить за одной поверхностью ИИ или за несколькими?
За несколькими, и отчитываться о них раздельно. Две самые тяжёлые поверхности делили в среднем 2,5 источника на запрос, а полного тройного совпадения не случилось ни разу. Программа с одной поверхностью измеряет эту поверхность, а не вашу категорию.
Стоит ли отслеживать домен, который появился один раз?
Только как наблюдение. 324 домена из 432 появились один раз, так что единичное появление ближе к шуму, чем к сигналу. Повышайте домен до слоя повторяющихся после того, как он появится во втором ответе, желательно на второй поверхности.
Как часто запускать панель?
Ежемесячно для полной панели, еженедельно для повторяющегося ядра. Список повторяющихся достаточно короток, чтобы недельный прогон на одной дешёвой поверхности стоил меньше пятидесяти центов в месяц, а новые источники входят именно в месячный прогон.
Взгляд Auspia: перестаньте определять размер списка запросов по тому, насколько основательным он кажется, и начните измерять, когда он перестаёт что-либо находить. В наших данных эта точка так и не наступила, а значит правильная единица планирования — это классы запросов и ротация, а не один более длинный список. Разделите повторяющиеся источники по слоям, семплируйте хвост и держите имя поверхности рядом с каждым числом, о котором отчитываетесь.
Автор: Елена Шоу