每一份 AI 品牌监测计划都从一份提示词清单开始,而几乎每一份清单都是照着团队已有的想法写出来的。二十个提示词感觉足够周全,五十个感觉已经穷尽。没有人去检查这份清单是否还在发现新东西。
我们在 2026 年 9 月把二十个提示词跑在三个 AI 界面上,只追踪一件事:来源出自哪里。不是我们的品牌有没有被提到,而是答案拉进来的全部域名集合。如果提示词清单已经完整,那么再加提示词就应该找不到新来源了。事实并非如此。
我们测了什么
项目 | 设置 |
|---|---|
提示词 | 20 个关于 AI 可见性工具的购买者问题 |
界面 | ChatGPT(gpt-5)、Gemini 2.5 Flash、Perplexity(sonar),均开启联网检索 |
收集到的答案 | 60 条 |
发现的不同来源 | 432 个域名 |
单轮完整运行的成本 | 1,444 美元 |
重复覆盖 | 同一天把 5 个提示词各跑两遍 |
我们把 60 条答案各自当作对来源宇宙的一次观测,统计的是不同域名,而不是引用位次。Gemini 在 20 条答案里返回了 989 条来源标注,但其中很多指向同一个页面,所以域名数才是这里诚实的单位。标注层面的数据在AI 可见性检查器分析里。
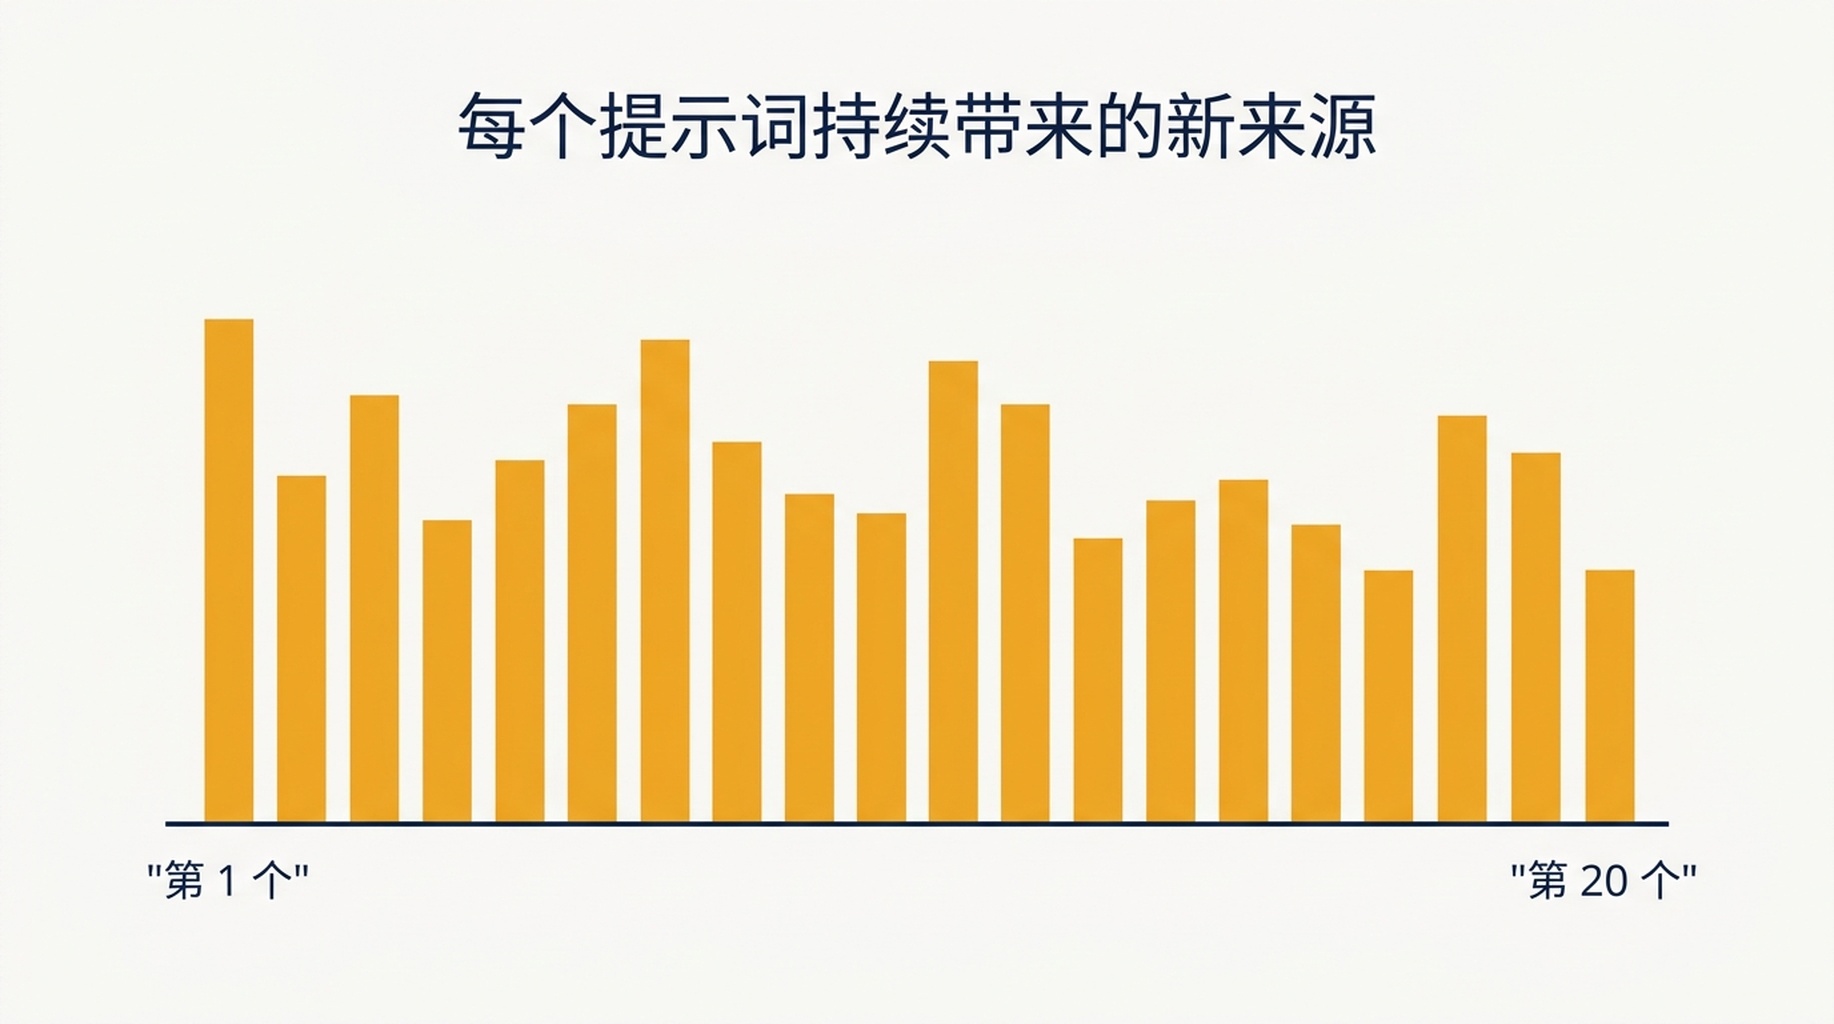
结论 1:清单永远不会收口
决定一套监测方案该怎么搭的正是这一部分。每跑完一个提示词,我们就把它的新域名并入此前找到的全部结果。
已跑提示词数 | 发现的不同来源 | 占 20 个提示词总数的比例 |
|---|---|---|
1 | 34 | 8% |
3 | 91 | 21% |
5 | 134 | 31% |
10 | 235 | 54% |
15 | 336 | 78% |
20 | 432 | 100% |
最后一个提示词仍然带来了 14 个此前任何提示词都没翻出来过的域名。二十个提示词中,最小的边际增量是 14,最大是 34。在这个区间里没有任何一个点,能让多加一个提示词变得不划算。也就是说,提示词清单不是你收集完成的样本,而是你要一直往下抽的样本。
说成实操版本:一份凭记忆写出的五个提示词清单,大约覆盖二十个提示词所覆盖范围的三分之一。会察觉到品类变化的那套监测方案,和每个月重复汇报同样五个答案的那套方案,差距就在这里。
结论 2:每个界面看到的,是同一空间里不同的三分之一
432 个域名分布得并不均匀。每个界面触及的是同一批问题里不同的切片。
界面 | 不同来源 | 占 432 的比例 | 每条答案的来源中位数 |
|---|---|---|---|
ChatGPT | 47 | 11% | 0 |
Gemini 2.5 Flash | 184 | 43% | 12 |
Perplexity | 285 | 66% | 19 |
Gemini 和 Perplexity 两者就找到了 432 个域名中的 400 个,也就是说 ChatGPT 补上了 32 个别的界面都没翻出来的域名。在 ChatGPT 没有检索的那 12 个提示词上,这个界面贡献为零,它的中位数之所以是 0 就是这个原因。
对监测来说,这个结论并不舒服。如果你的追踪工具只盯一个界面,你跑的不是三界面方案的缩小版,你汇报的是另一个来源群体,而"我们这个月被引用得更多了吗"的答案,可能只是"我们什么都没改,是界面变了"。我们在答案层面测过同一个效应,见 AI 可见性追踪器的运行波动。
结论 3:两个界面很少在同一个提示词上达成一致
我们比较了 Gemini 和 Perplexity 在同一天、同一语言下、针对同一提示词给出的来源清单。
- 两份清单平均只共享 2.5 个域名,而各自大约有 20 个。
- 平均杰卡德重合度为 0.089。
- 在 ChatGPT 也返回了来源的那 8 个提示词里,只有 3 个能让三个界面共享哪怕一个域名,三方最大重合为 2 个域名。
- 三个界面在单个提示词上完全一致的情况从未发生过。
同一个问题的两条答案,是用几乎不相交的页面集合拼出来的。这是我们找到的、反对单界面汇报最有力的论据,同时也是个好消息:一个新页面被捡起来的机会,远比单份来源清单所暗示的要多。
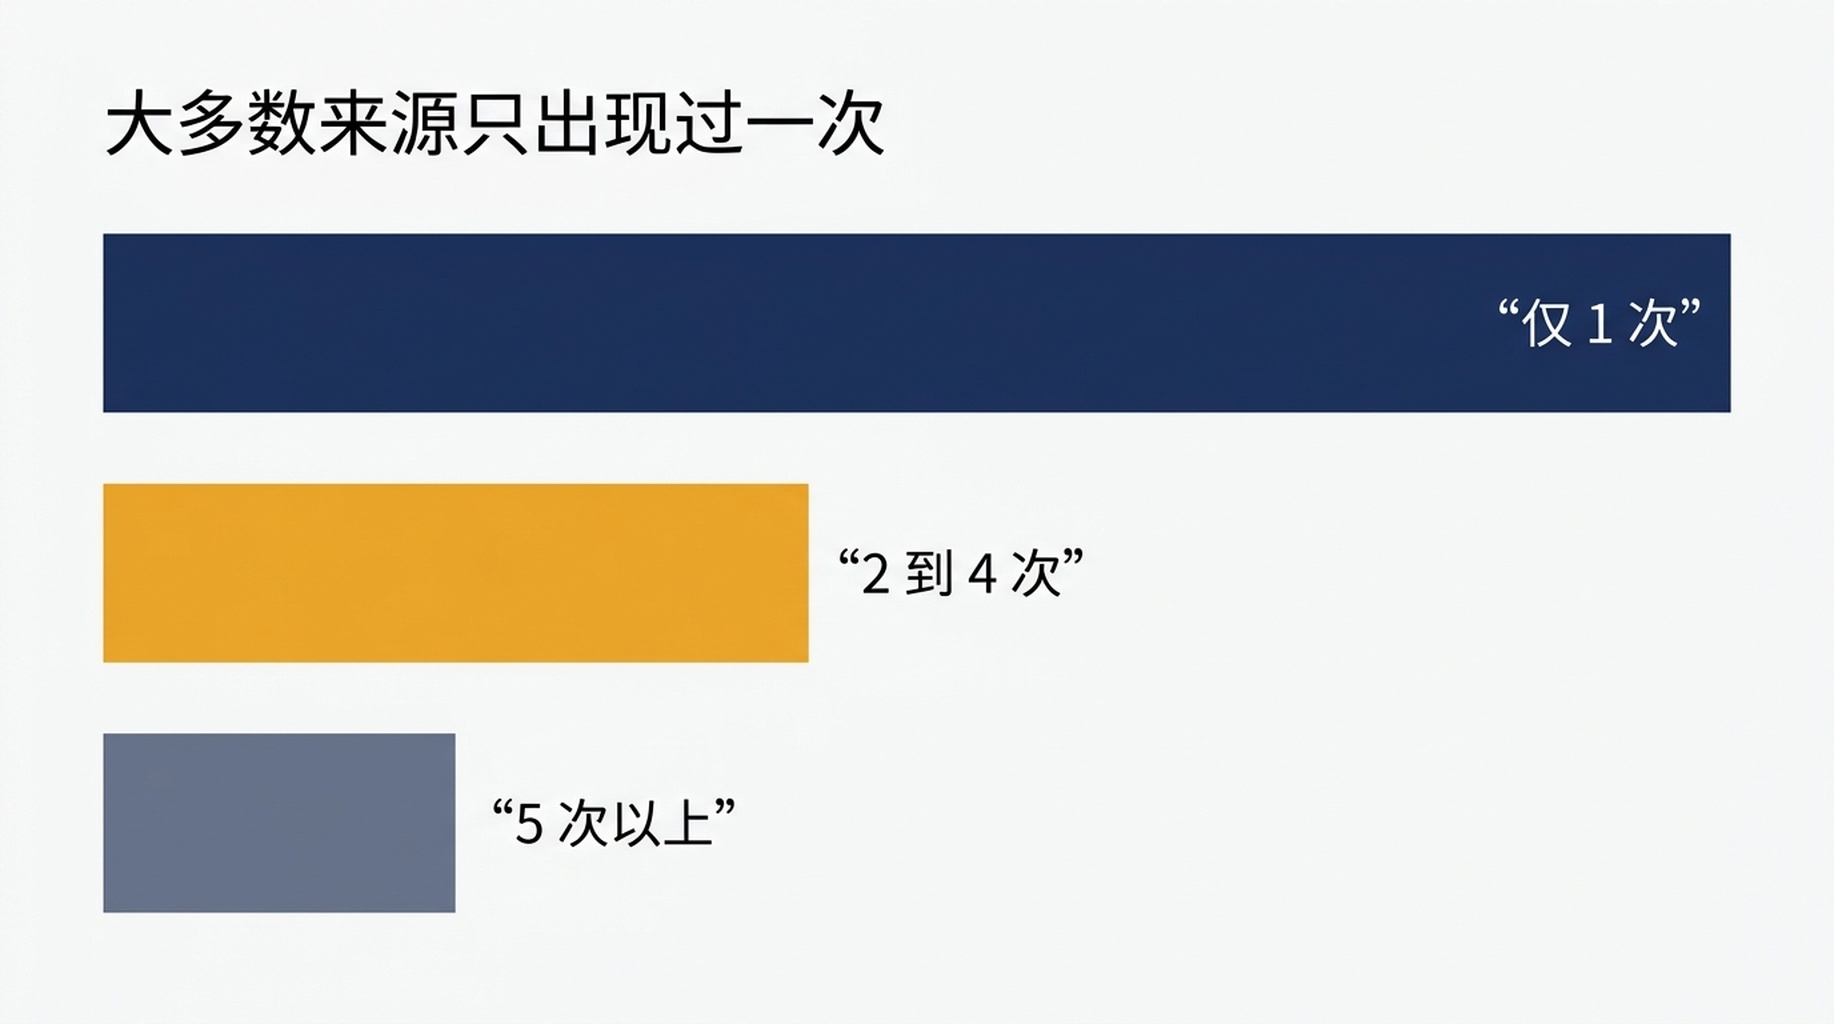
结论 4:大多数来源只出现一次
432 个域名的分布极其不均。
- 432 个域名中有 324 个,也就是 75%,在 60 条答案里恰好只出现一次。
- 只在 5 条及以上答案里出现过的域名只有 17 个。
- 反复出现的核心部分既小又可预测:ahrefs.com 出现在 16 条答案里,semrush.com 15 条,reddit.com 14 条,接着是 frase.io 的 9 条,再往下是一簇各 6 个的集合,包括 otterly.ai、tryprofound.com、llmpulse.ai、cognizo.ai 和 searchenginejournal.com。
这把监测工作劈成两半,而这两半想要不同的节奏。反复出现的核心是需要勤复查的那一层,因为那里的变化意味着共享来源真的变了。只出现一次的尾部是需要抽样的那一层,因为在整个宇宙里,有 75% 的东西在重复出现之前都是噪声。
不用完整清单,该监测什么
层 | 放进什么 | 节奏 | 每月数据成本 |
|---|---|---|---|
第 1 层:反复出现的核心 | 反复出现的 17 个域名,加上你自己的域名和最接近的三个竞品 | 每周在一个界面上跑 | Perplexity 上 0.48 美元,Gemini 上 3.23 美元 |
第 2 层:提示词面板 | 15 到 20 个提示词,覆盖品类、对比、定价和问题表述 | 每月在三个界面上跑 | 每轮 1.44 美元 |
第 3 层:提示词发现 | 每月新增 5 个提示词,写自销售通话和支持工单 | 每季度复核一次,然后提拔或丢弃 | 已包含在月度运行里 |
这套东西跑下来,有三条规则浮出来。
- 记录提示词的类别,而不只是提示词。我们最宽的一条答案来自一个关于"到底怎么才能被引用"的提示词,而不是工具对比;最窄的一条反而来自对比。不同类别的行为不一样,而你要汇报的是类别。
- 每条记录里都保留界面名。没有界面名的引用数不可比较,因为清单长度能差三倍。
- 轮换发现用的提示词。二十个提示词找到了 432 个域名,而这条曲线说明换另外二十个会找到另外几百个。提拔与退役是唯一能让面板保持诚实的机制。
在这里成本不是约束。二十个提示词跑满三个界面花了 1,444 美元,所以一套月度方案的数据成本一年大约 17 美元,复核时间另算。约束在于复核时间才是更贵的那一半,这也是为什么分层结构比清单长度更重要。Google 自家的 AI 界面完全不在这份面板里,它需要另一种量具,我们在 AI Overview 追踪器里做过说明。
局限
- 一天、一个地区、英语、三个界面、每个界面一个模型版本。
- 域名计数会剔除同一条答案内部的重复,所以一个被引用五次的页面只算一次。
- 提示词类别是我们自己划分的,不是任何外部分类法。
- 成本数字只覆盖答案生成。
- ChatGPT 的贡献被它没有检索的那 12 个提示词压低了,这是那个界面的性质,不是提示词集合的性质。
常见问题
AI 品牌监测需要多少个提示词?
我们的数据里没有完成点。二十个提示词找到了 432 个来源,而第二十个仍然新增了 14 个。选一个你每月复核得过来的面板规模,然后把精力花在提示词质量和轮换上,而不是清单长度上。
我应该监测一个 AI 界面还是多个?
多个,而且要分开汇报。最重的两个界面每个提示词平均只共享 2.5 个来源,三方完全一致从未发生。单界面方案测的是那个界面,不是你的品类。
只出现一次的域名值得追踪吗?
只值得当作一次观察。432 个域名里有 324 个只出现过一次,所以单次出现更接近噪声而不是信号。等它在第二条答案里出现,最好还是在第二个界面上出现,再把它提拔到反复出现的层。
面板应该多久跑一次?
完整面板每月一次,反复出现的核心每周一次。反复清单足够短,在一个便宜的界面上跑一次周更,每月花不到五十美分,而新来源是在月度那一轮里进来的。
Auspia 观点:别再按"感觉够不够周全"来决定提示词清单的规模,开始测量它什么时候不再发现新东西。在我们的数据里这个点始终没有到来,这意味着正确的规划单位是提示词类别和轮换,而不是一份更长的清单。把反复出现的来源分层,对尾部做抽样,并给你汇报的每一个数字都带上界面名。
作者:埃琳娜·肖