AIブランド監視の計画はどれもプロンプト一覧から始まり、その一覧はたいていチームがすでに信じていることから作られます。20個あれば網羅した気になり、50個あれば徹底した気になります。その一覧が今も何かを見つけ続けているかどうかを確かめる人はいません。
私たちは2026年9月に20個のプロンプトを3つのAI面で実行し、1つだけを追いました。情報源がどこから来たかです。自社ブランドが言及されたかではなく、回答が引き込んだドメインの集合全体です。プロンプト一覧が完成しているなら、プロンプトを足しても新しい情報源は見つからなくなるはずです。そうはなりませんでした。
何を測ったか
項目 | 設定 |
|---|---|
プロンプト | AI可視性ツールに関する購買者の質問20件 |
面 | ChatGPT(gpt-5)、Gemini 2.5 Flash、Perplexity(sonar)、ウェブ検索有効 |
収集した回答 | 60 |
見つかった異なる情報源 | 432ドメイン |
1回の通し実行のコスト | 1,444ドル |
反復での網羅 | 5つのプロンプトを同日に2回実行 |
60件の回答をそれぞれ情報源の宇宙の1観測として扱い、引用スロットではなく異なるドメインを数えました。Geminiは20件の回答で989件の情報源アノテーションを返しましたが、その多くは同じページを指していたため、ここではドメイン数が正直な単位です。アノテーション単位のデータはAI可視性チェッカーの分析にあります。
結果1:一覧は決して閉じない
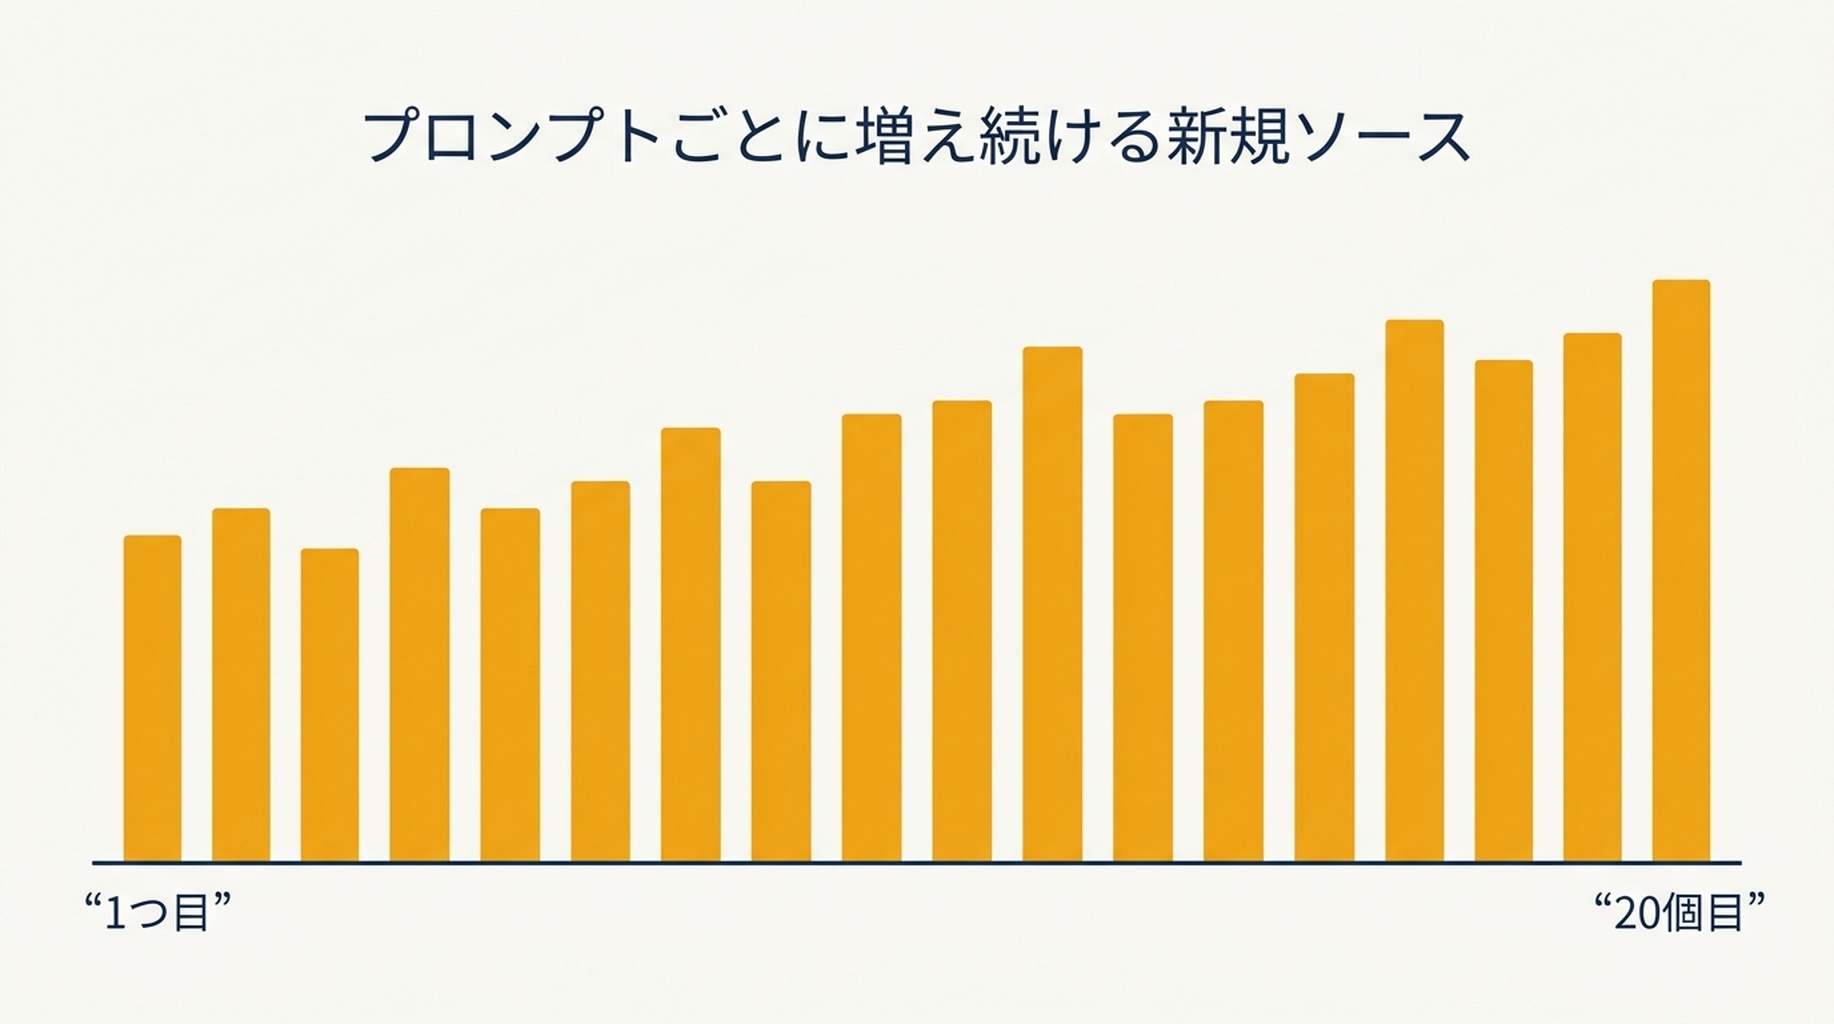
監視プログラムの組み方を決めるのはこの部分です。各プロンプトの後、その新規ドメインをそれまでに見つかったすべてに足し込んでいきました。
実行したプロンプト数 | 見つかった異なる情報源 | 20プロンプト合計に占める割合 |
|---|---|---|
1 | 34 | 8パーセント |
3 | 91 | 21パーセント |
5 | 134 | 31パーセント |
10 | 235 | 54パーセント |
15 | 336 | 78パーセント |
20 | 432 | 100パーセント |
最後のプロンプトは、それ以前のどのプロンプトも拾わなかった14ドメインを追加しました。20プロンプト全体で最小の限界利得は14、最大は34でした。この範囲のどこにも、もう1つプロンプトを足すことが元を取れなくなる点はありません。つまりプロンプト一覧は完成させる標本ではなく、引き続ける標本です。
実務的な言い方をすれば、記憶から作った5つのプロンプト一覧は、20プロンプトが覆う範囲のおよそ3分の1を覆います。カテゴリの変化に気づく監視プログラムと、毎月同じ5つの回答を報告するプログラムの差はそこにあります。
結果2:それぞれの面は同じ空間の別の3分の1を見ている
432ドメインは均等に分布していませんでした。それぞれの面が、同じ質問セットの別の断片に届いていました。
面 | 異なる情報源 | 432に占める割合 | 回答あたりの情報源の中央値 |
|---|---|---|---|
ChatGPT | 47 | 11パーセント | 0 |
Gemini 2.5 Flash | 184 | 43パーセント | 12 |
Perplexity | 285 | 66パーセント | 19 |
GeminiとPerplexityだけで432ドメインのうち400を見つけたので、ChatGPTは他が拾わなかった32ドメインを追加したことになります。ChatGPTが検索しなかった12のプロンプトでは、その面はまったく寄与しておらず、中央値が0なのはそのためです。
監視にとっての帰結は居心地のよいものではありません。追跡ツールが1つの面だけを見ているなら、それは3面構成の縮小版を回しているのではありません。別の情報源集団を報告しているのであり、「今月は引用が増えたか」への答えは、単に「こちらは何も変えていないが面が変わった」であるかもしれません。同じ効果を回答レベルで測ったのがAI可視性トラッカーの実行変動です。
結果3:2つの面が同じプロンプトで一致することはまれ
同じ日、同じ言語で、GeminiとPerplexityが同じプロンプトに対して出した情報源リストを比較しました。
- 2つのリストが共有したドメインは平均2.5で、それぞれおよそ20件のうちの2.5件でした。
- 平均ジャッカード重複度は0.089でした。
- ChatGPTも情報源を返した8つのプロンプトのうち、3面すべてが1つでもドメインを共有したのはわずか3つで、3面の最大重複は2ドメインでした。
- 1つのプロンプトで3面すべてが完全に一致することは一度もありませんでした。
同じ質問への2つの回答が、ほぼ互いに素なページ集合から組み立てられています。これは私たちが見つけた単一面報告への最も強い反論であり、同時に良い知らせでもあります。新しいページは、単一の情報源リストが示唆するよりもはるかに多く拾われる機会を持っています。
結果4:ほとんどの情報源は一度しか現れない
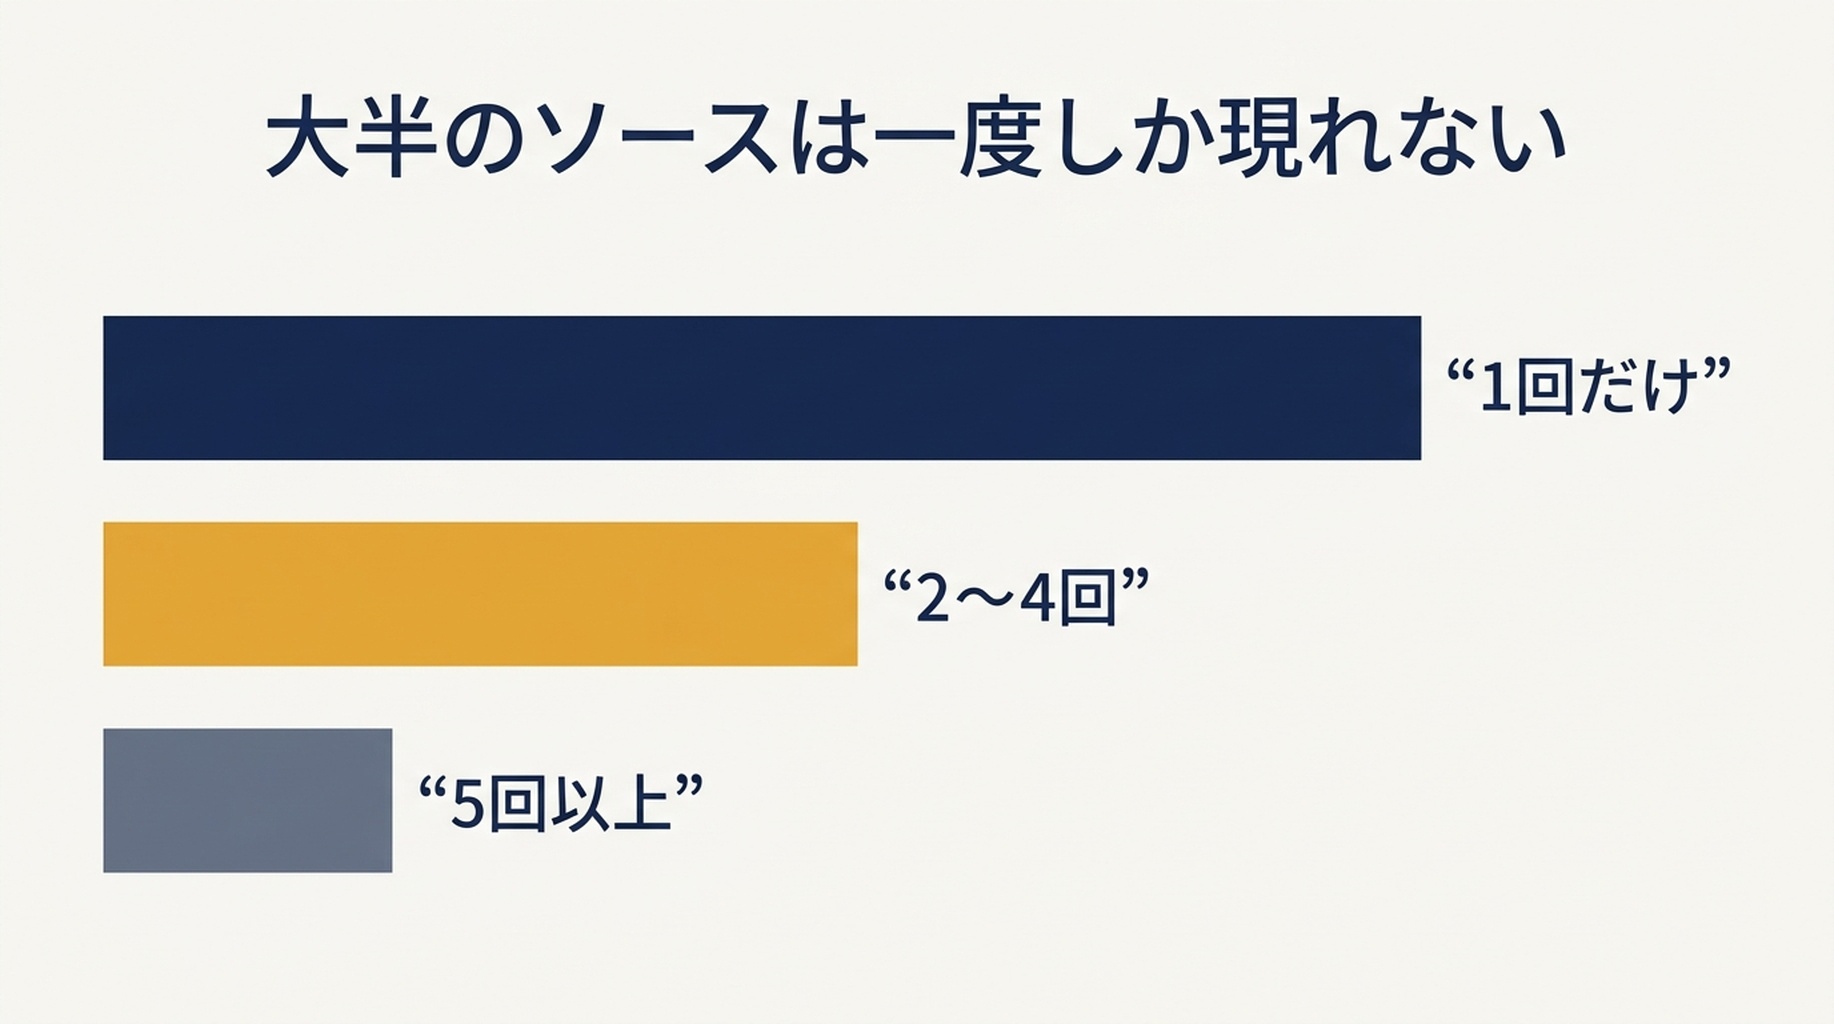
432ドメインは極端に不均等に分布しています。
- 432ドメインのうち324、つまり75パーセントが、60件の回答のうちちょうど1件に現れました。
- 5件以上の回答に現れたドメインは17だけでした。
- 繰り返し現れる中核は小さく予測可能です。ahrefs.comが16件の回答、semrush.comが15件、reddit.comが14件、続いてfrase.ioが9件、そしてotterly.ai、tryprofound.com、llmpulse.ai、cognizo.ai、searchenginejournal.comを含む6件の集まりがあります。
これにより監視の仕事は2つに分かれ、2つの半分は別の頻度を求めます。繰り返し現れる中核は頻繁に見直す層です。そこでの変化は共有された情報源の本当の変化だからです。一度きりの裾は標本抽出する層です。宇宙の75パーセントは、繰り返されるまではノイズだからです。
完全な一覧の代わりに何を監視するか
層 | 何を入れるか | 頻度 | 月間データコスト |
|---|---|---|---|
層1:繰り返し現れる中核 | 繰り返す17ドメインに、自社ドメインと最も近い競合3社を加えたもの | 1つの面で毎週 | Perplexityで0.48ドル、Geminiで3.23ドル |
層2:プロンプトパネル | カテゴリ、比較、価格、問題設定を覆う15〜20のプロンプト | 3面すべてで毎月 | 1回あたり1.44ドル |
層3:プロンプト発見 | 営業の通話とサポートチケットから書く毎月5つの新規プロンプト | 四半期ごとに見直し、その後昇格か削除 | 月次パスに含まれる |
これを回して3つのルールが出てきました。
- プロンプトそのものではなくプロンプト種別を記録する。最も広い回答はツール比較ではなく、そもそも引用されるにはどうするかというプロンプトから出て、最も狭い回答は比較から出ました。種別ごとに振る舞いが異なり、報告すべきなのは種別です。
- すべての記録に面を残す。面名のない引用数は比較できません。リストの長さが3倍違うからです。
- 発見用のプロンプトを回転させる。20プロンプトが432ドメインを見つけ、その曲線は別の20なら別の数百を見つけると言っています。昇格と引退だけがパネルを正直に保つ仕組みです。
ここでコストは制約ではありません。20プロンプトの3面通し実行は1,444ドルだったので、月次のプログラムはデータで年およそ17ドルです。レビュー時間を別にすれば。制約はレビュー時間が高い側の半分であることで、だからこそ一覧の長さよりも層の構成が重要です。Google自身のAI面はこのパネルには一切入っておらず、別の計器が必要です。AI Overviewトラッカーで説明しています。
限界
- 1日、1地域、英語、3面、それぞれ1つのモデル版。
- ドメイン数は回答内の重複を除くので、5回引用されたページも1回と数えます。
- プロンプト種別は外部の分類ではなく私たちが割り当てました。
- コストの数字は回答生成のみを覆います。
- ChatGPTの寄与は検索しなかった12プロンプトによって押し下げられており、これはプロンプトセットではなくその面の性質です。
よくある質問
AIブランド監視にはいくつのプロンプトが必要ですか?
私たちのデータに完了点はありません。20プロンプトが432の情報源を見つけ、20番目はまだ14の新規を追加しました。毎月レビューできるパネルサイズを選び、そのうえで工数を一覧の長さではなくプロンプトの質と回転に使ってください。
AI面は1つ監視すればよいですか、複数ですか?
複数で、しかも別々に報告してください。最も重い2つの面は1プロンプトあたり平均2.5の情報源しか共有せず、3面完全一致は一度も起きませんでした。単一面のプログラムはその面を測っているのであって、カテゴリを測っているのではありません。
一度しか現れないドメインは追う価値がありますか?
観察としてのみです。432ドメインのうち324が一度しか現れなかったので、1回の出現は信号というよりノイズに近いものです。2件目の回答、できれば別の面で現れてから繰り返し層に昇格させてください。
パネルはどのくらいの頻度で回すべきですか?
全体パネルは毎月、繰り返し中核は毎週です。繰り返しリストは短いので、安い面1つでの週次パスは月50セント未満で済み、新しい情報源が入るのは月次パスのほうです。
Auspia の見解:プロンプト一覧の大きさを徹底した感じで決めるのをやめ、いつ見つからなくなるかを測り始めてください。私たちのデータではその点は訪れず、つまり計画の正しい単位は1つの長い一覧ではなくプロンプト種別と回転です。繰り返す情報源を層に分け、裾は標本抽出し、報告するすべての数値に面の名前を添えてください。
執筆: エレナ・ショー