Jeder Plan für KI-Markenmonitoring beginnt mit einer Prompt-Liste, und fast jede Liste entsteht aus dem, woran das Team ohnehin schon glaubt. Zwanzig Prompts wirken gründlich. Fünfzig wirken erschöpfend. Niemand prüft, ob die Liste überhaupt noch etwas entdeckt.
Im September 2026 haben wir zwanzig Prompts über drei KI-Oberflächen laufen lassen und genau eines verfolgt: woher die Quellen kamen. Nicht Erwähnungen unserer Marke, sondern die vollständige Menge an Domains, die die Antworten herangezogen haben. Wäre die Prompt-Liste vollständig, dürfte das Hinzufügen weiterer Prompts keine neuen Quellen mehr finden. Das tat es nicht.
Was wir gemessen haben
Punkt | Einstellung |
|---|---|
Prompts | 20 Käuferfragen zu Werkzeugen für KI-Sichtbarkeit |
Oberflächen | ChatGPT (gpt-5), Gemini 2.5 Flash, Perplexity (sonar), Websuche aktiviert |
Gesammelte Antworten | 60 |
Gefundene verschiedene Quellen | 432 Domains |
Kosten eines vollständigen Durchlaufs | 1.444 Dollar |
Wiederholte Abdeckung | 5 Prompts am selben Tag zweimal ausgeführt |
Wir behandelten jede der 60 Antworten als eine Beobachtung des Quellenuniversums und zählten verschiedene Domains, nicht Zitationsplätze. Gemini lieferte über seine 20 Antworten 989 Quellenannotationen, doch viele davon zeigten auf dieselbe Seite, weshalb die Domainzahl hier die ehrliche Einheit ist. Die Daten auf Annotationsebene stehen in der Analyse des KI-Sichtbarkeitsprüfers.
Ergebnis 1: Die Liste schließt sich nie
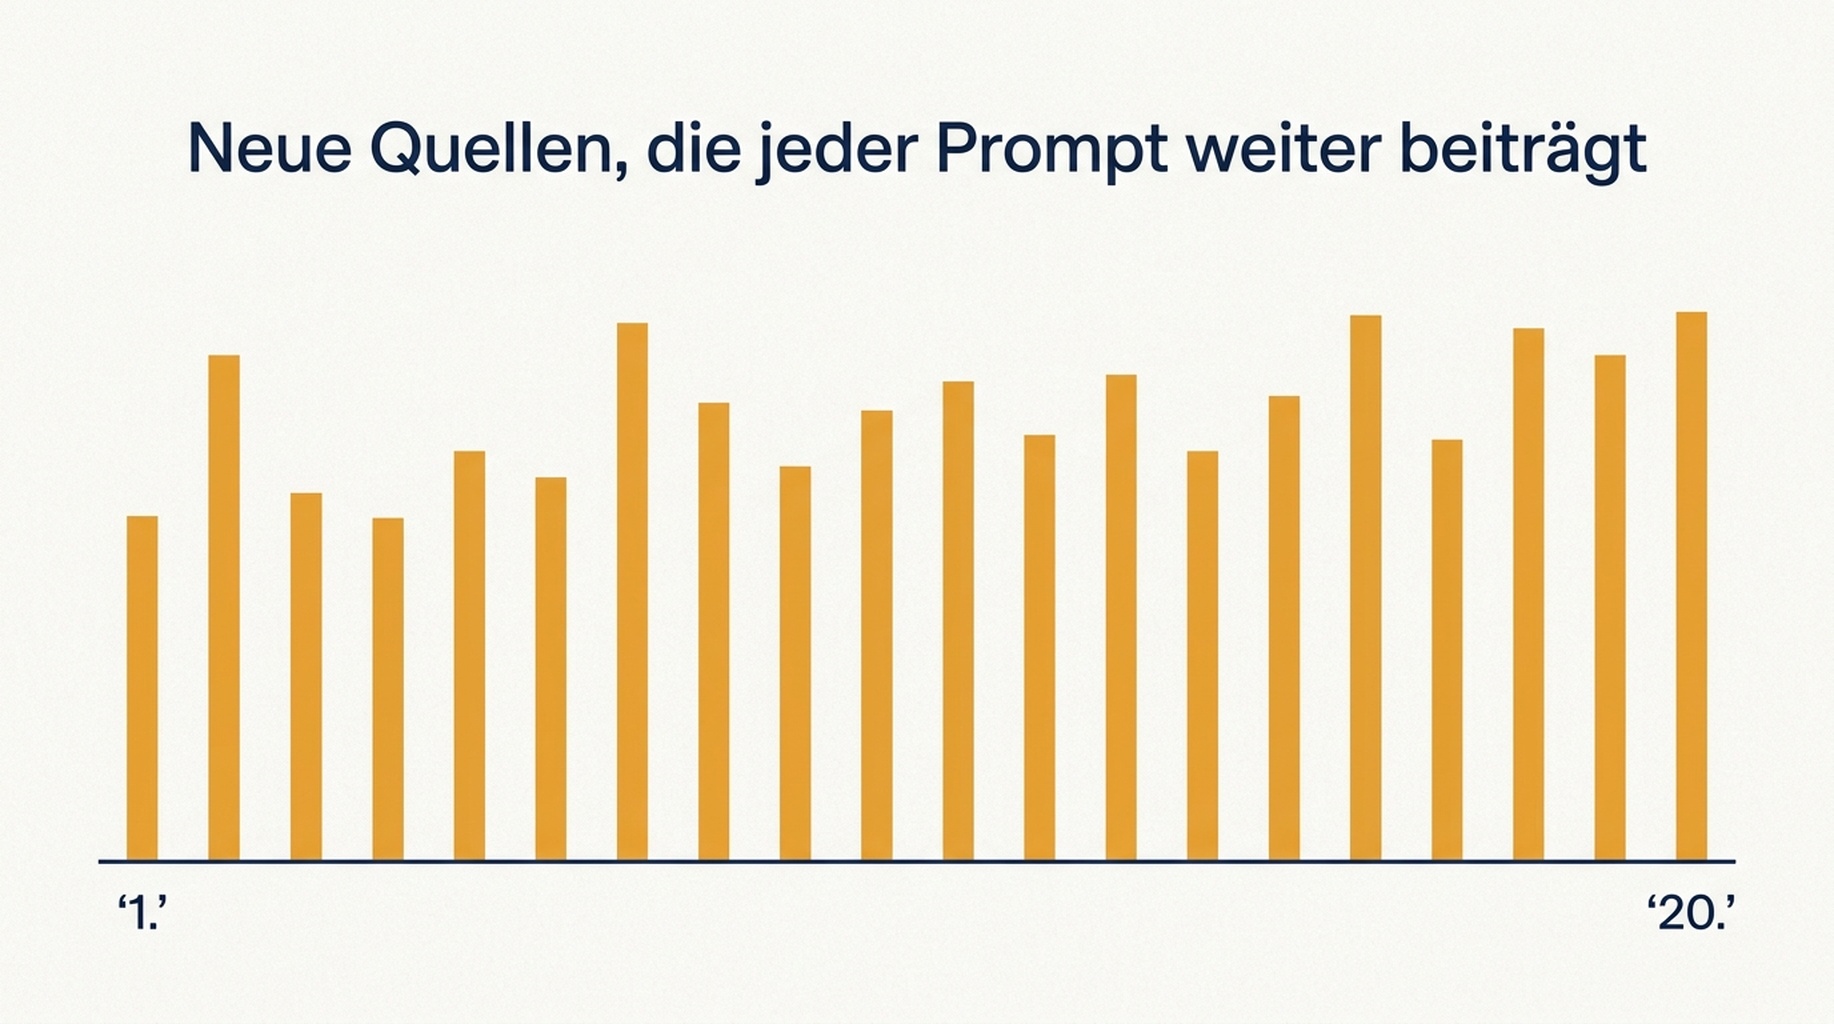
Genau dieser Teil entscheidet, wie ein Monitoring-Programm aufgebaut sein sollte. Nach jedem Prompt addierten wir seine neuen Domains zu allem, was bis dahin gefunden worden war.
Ausgeführte Prompts | Gefundene verschiedene Quellen | Anteil an der Summe der 20 Prompts |
|---|---|---|
1 | 34 | 8 Prozent |
3 | 91 | 21 Prozent |
5 | 134 | 31 Prozent |
10 | 235 | 54 Prozent |
15 | 336 | 78 Prozent |
20 | 432 | 100 Prozent |
Der letzte Prompt fügte 14 Domains hinzu, die kein früherer Prompt zutage gebracht hatte. Der kleinste Grenzgewinn über alle 20 Prompts betrug 14, der größte 34. In diesem Bereich gibt es keinen Punkt, an dem ein weiterer Prompt sich nicht mehr bezahlt macht, was bedeutet: Eine Prompt-Liste ist keine Stichprobe, die man abschließt, sondern eine, die man weiter zieht.
Die praktische Fassung: Eine aus dem Gedächtnis geschriebene Liste mit fünf Prompts deckt rund ein Drittel dessen ab, was zwanzig Prompts abdecken. Darin liegt der Unterschied zwischen einem Monitoring-Programm, das einen Kategorienwechsel bemerkt, und einem, das jeden Monat dieselben fünf Antworten meldet.
Ergebnis 2: Jede Oberfläche sieht ein anderes Drittel desselben Raums
Die 432 Domains verteilten sich nicht gleichmäßig. Jede Oberfläche erreichte einen anderen Ausschnitt desselben Fragensatzes.
Oberfläche | Verschiedene Quellen | Anteil an den 432 | Median der Quellen pro Antwort |
|---|---|---|---|
ChatGPT | 47 | 11 Prozent | 0 |
Gemini 2.5 Flash | 184 | 43 Prozent | 12 |
Perplexity | 285 | 66 Prozent | 19 |
Gemini und Perplexity fanden zusammen 400 der 432 Domains, das heißt, ChatGPT ergänzte 32 Domains, die keine andere Oberfläche zutage brachte. Bei den 12 Prompts, bei denen ChatGPT nicht suchte, trug diese Oberfläche gar nichts bei, und deshalb ist ihr Median null.
Die Konsequenz für das Monitoring ist unangenehm. Wenn Ihr Tracker eine einzige Oberfläche beobachtet, betreiben Sie nicht eine kleinere Version eines Drei-Oberflächen-Programms. Sie berichten über eine andere Quellenpopulation, und die Antwort auf „werden wir diesen Monat häufiger zitiert" kann schlicht lauten: „Wir haben nichts geändert, die Oberfläche hat sich geändert." Denselben Effekt haben wir auf Antwortebene in der Streuung der Durchläufe des KI-Sichtbarkeitstrackers gemessen.
Ergebnis 3: Zwei Oberflächen sind sich beim selben Prompt selten einig
Wir verglichen die Quellenlisten, die Gemini und Perplexity für denselben Prompt, am selben Tag und in derselben Sprache erzeugten.
- Die beiden Listen teilten im Mittel 2,5 Domains von je etwa zwanzig.
- Die mittlere Jaccard-Überlappung lag bei 0,089.
- Und nur bei 3 der 8 Prompts, bei denen auch ChatGPT Quellen zurückgab, teilten alle drei Oberflächen auch nur eine Domain, wobei die größte dreifache Überlappung 2 Domains betrug.
- Vollständige Einigkeit aller drei Oberflächen bei einem einzelnen Prompt kam nie vor.
Zwei Antworten auf dieselbe Frage, gebaut aus nahezu disjunkten Seitenmengen. Das ist das stärkste Argument gegen Berichte aus einer einzigen Oberfläche, das wir gefunden haben, und zugleich eine gute Nachricht: Eine neue Seite hat weit mehr Chancen, aufgegriffen zu werden, als eine einzelne Quellenliste nahelegt.
Ergebnis 4: Die meisten Quellen erscheinen einmal
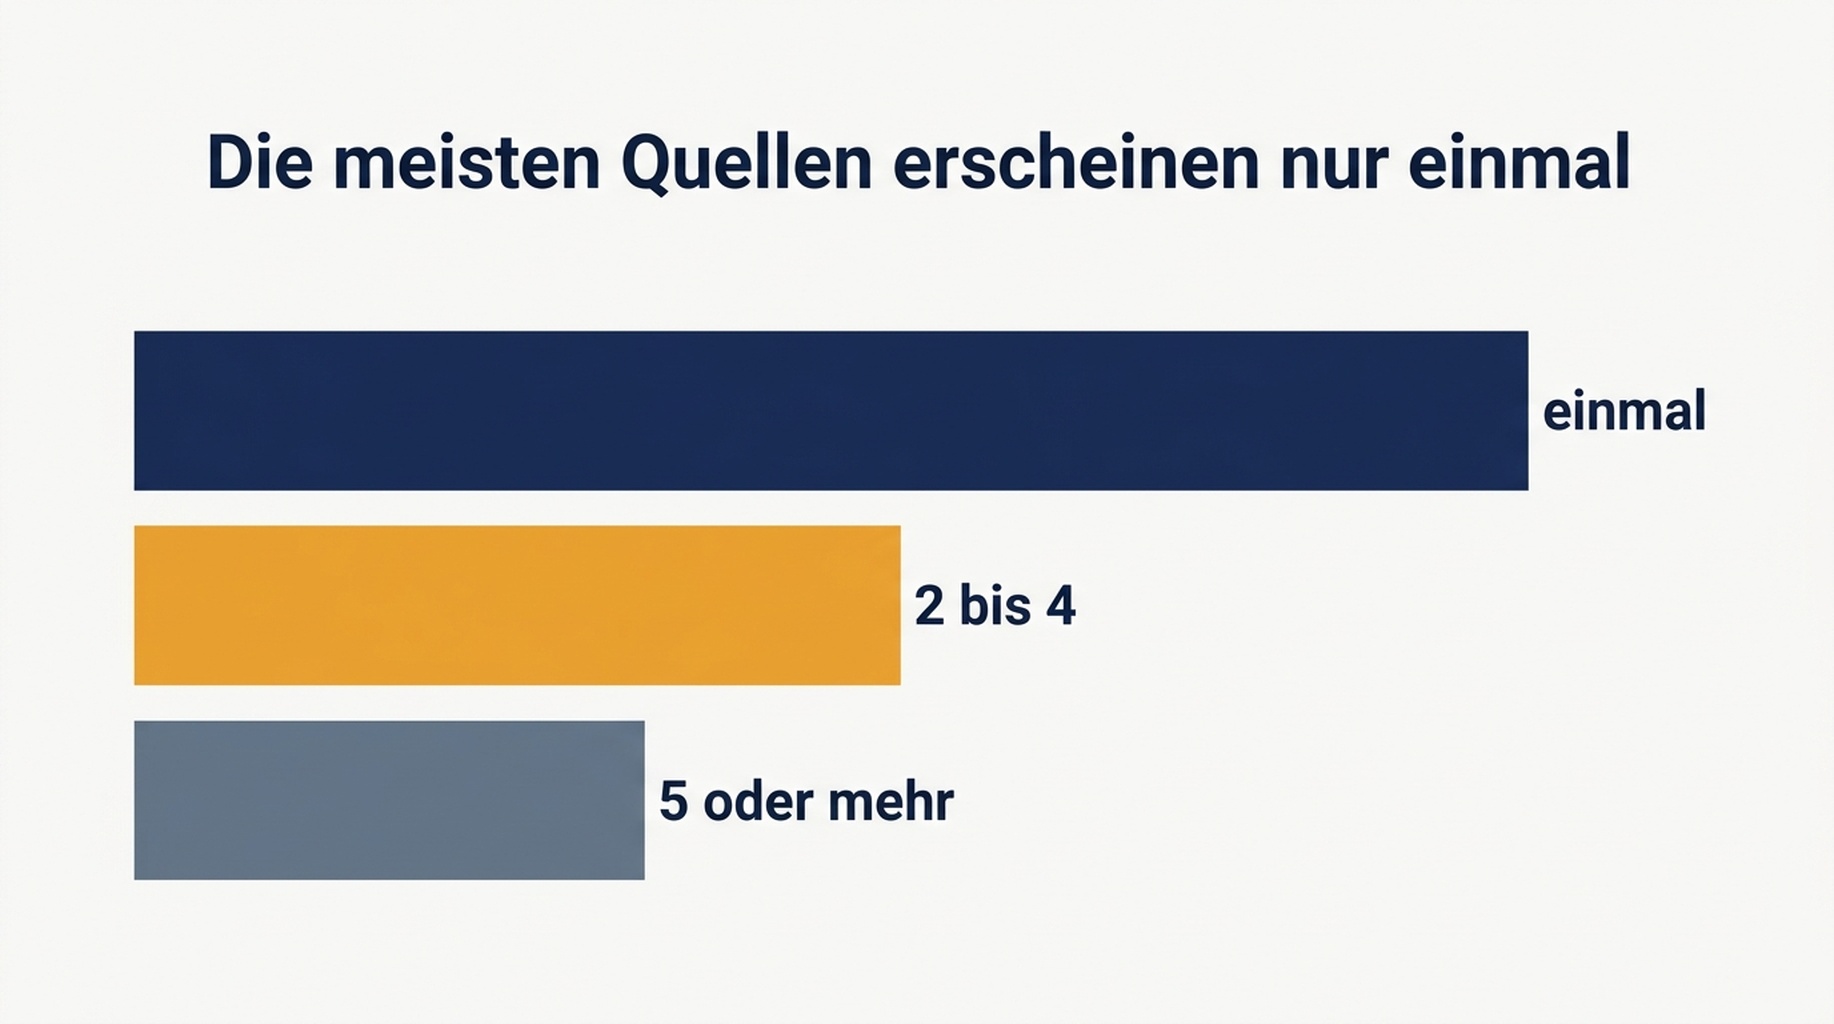
Die 432 Domains sind extrem ungleich verteilt.
- 324 der 432 Domains, also 75 Prozent, erschienen in genau einer der 60 Antworten.
- Nur 17 Domains erschienen in 5 oder mehr Antworten.
- Der wiederkehrende Kern ist klein und vorhersagbar: ahrefs.com in 16 Antworten, semrush.com in 15, reddit.com in 14, dann frase.io mit 9 und ein Cluster bei 6, zu dem otterly.ai, tryprofound.com, llmpulse.ai, cognizo.ai und searchenginejournal.com gehören.
Das teilt die Monitoring-Arbeit in zwei Hälften, und beide wollen unterschiedliche Takte. Der wiederkehrende Kern ist die Schicht, die häufig geprüft wird, weil eine Änderung dort eine echte Verschiebung in einer geteilten Quelle ist. Der Schweif aus Einmalerscheinungen ist die Schicht, die beprobt wird, weil 75 Prozent des Universums Rauschen sind, bis sie sich wiederholen.
Was statt einer vollständigen Liste überwacht werden sollte
Schicht | Was hineingehört | Takt | Monatliche Datenkosten |
|---|---|---|---|
Schicht 1: wiederkehrender Kern | Die 17 wiederkehrenden Domains plus Ihre eigene Domain und Ihre drei nächsten Wettbewerber | Wöchentlich auf einer Oberfläche | 0,48 Dollar bei Perplexity, 3,23 Dollar bei Gemini |
Schicht 2: Prompt-Panel | 15 bis 20 Prompts zu Kategorie, Vergleich, Preis und Problemformulierung | Monatlich über alle drei Oberflächen | 1,44 Dollar pro Durchlauf |
Schicht 3: Prompt-Entdeckung | 5 neue Prompts pro Monat, geschrieben aus Vertriebsgesprächen und Support-Tickets | Quartalsweise Prüfung, dann Beförderung oder Streichung | Im monatlichen Durchlauf enthalten |
Drei Regeln sind aus diesem Durchlauf hervorgegangen.
- Erfassen Sie die Prompt-Klasse, nicht nur den Prompt. Unsere breiteste Antwort kam aus einem Prompt darüber, wie man überhaupt zitiert wird, nicht aus einem Werkzeugvergleich, und die engste kam gerade aus einem Vergleich. Klassen verhalten sich unterschiedlich, und berichtet wird die Klasse.
- Behalten Sie die Oberfläche in jedem Datensatz. Eine Zitationszahl ohne Oberflächennamen ist nicht vergleichbar, weil die Listenlängen um den Faktor drei schwanken.
- Rotieren Sie die Entdeckungs-Prompts. Zwanzig Prompts fanden 432 Domains, und die Kurve sagt, dass andere zwanzig andere paar hundert finden würden. Beförderung und Ausmusterung sind der einzige Mechanismus, der das Panel ehrlich hält.
Die Kosten sind hier nicht die Einschränkung. Ein vollständiger Durchlauf mit zwanzig Prompts über drei Oberflächen kostete 1.444 Dollar, ein Monatsprogramm liegt also bei rund 17 Dollar pro Jahr an Daten, ohne Prüfzeit. Die Einschränkung ist, dass die Prüfzeit die teurere Hälfte ist, weshalb die Schichtstruktur wichtiger ist als die Listenlänge. Googles eigene KI-Oberfläche fehlt in diesem Panel völlig und braucht ein anderes Instrument, wie unser AI-Overview-Tracker erklärt.
Grenzen
- Ein Tag, ein Ort, Englisch, drei Oberflächen, je eine Modellversion.
- Die Domainzählung entfernt Duplikate innerhalb einer Antwort, eine fünfmal zitierte Seite zählt also einmal.
- Die Prompt-Klassen haben wir selbst vergeben, nicht nach einer externen Taxonomie.
- Die Kostenzahlen decken nur die Antworterzeugung ab.
- Der Beitrag von ChatGPT ist durch die 12 Prompts gedrückt, bei denen es nicht suchte, und das ist eine Eigenschaft jener Oberfläche, nicht des Prompt-Sets.
Häufige Fragen
Wie viele Prompts brauche ich für KI-Markenmonitoring?
In unseren Daten gibt es keinen Abschlusspunkt. Zwanzig Prompts fanden 432 Quellen, und der zwanzigste fügte immer noch 14 neue hinzu. Wählen Sie eine Panelgröße, die Sie monatlich prüfen können, und stecken Sie den Aufwand in Prompt-Qualität und Rotation statt in Listenlänge.
Sollte ich eine KI-Oberfläche überwachen oder mehrere?
Mehrere, und getrennt berichten. Die zwei schwersten Oberflächen teilten im Mittel 2,5 Quellen pro Prompt, und vollständige dreifache Einigkeit kam nie vor. Ein Programm mit einer Oberfläche misst diese Oberfläche, nicht Ihre Kategorie.
Lohnt es sich, eine Domain zu verfolgen, die einmal erscheint?
Nur als Beobachtung. 324 von 432 Domains erschienen einmal, ein einmaliges Auftreten liegt also näher am Rauschen als am Signal. Befördern Sie eine Domain erst in die wiederkehrende Schicht, nachdem sie in einer zweiten Antwort aufgetaucht ist, möglichst auf einer zweiten Oberfläche.
Wie oft sollte das Panel laufen?
Monatlich für das volle Panel, wöchentlich für den wiederkehrenden Kern. Die Wiederkehrliste ist kurz genug, dass ein wöchentlicher Durchlauf auf einer günstigen Oberfläche unter fünfzig Cent im Monat kostet, und im monatlichen Durchlauf kommen neue Quellen hinzu.
Auspia-Sicht: Hört auf, Prompt-Listen danach zu bemessen, wie gründlich sie sich anfühlen, und beginnt zu messen, wann sie aufhören, etwas zu finden. In unseren Daten kam dieser Punkt nie, was bedeutet, dass die richtige Planungseinheit Prompt-Klassen und Rotation sind, nicht eine längere Liste. Schichtet Sie die wiederkehrenden Quellen, beproben Sie den Schweif, und lassen Sie den Oberflächennamen an jeder Zahl kleben, über die Sie berichten.
Autor: Elena Shaw