Ogni piano di monitoraggio del marchio nell'IA comincia con un elenco di prompt, e quasi tutti gli elenchi nascono da ciò che il team crede già. Venti prompt sembrano accurati. Cinquanta sembrano esaustivi. Nessuno verifica se l'elenco stia ancora scoprendo qualcosa.
A settembre 2026 abbiamo eseguito venti prompt su tre superfici IA e abbiamo seguito una sola cosa: da dove arrivavano le fonti. Non le menzioni del nostro marchio, ma l'insieme completo dei domini che le risposte hanno tirato in ballo. Se l'elenco di prompt fosse completo, aggiungere prompt dovrebbe smettere di trovare fonti nuove. Non è successo.
Che cosa abbiamo misurato
Voce | Impostazione |
|---|---|
Prompt | 20 domande da acquirente sugli strumenti di visibilità nell'IA |
Superfici | ChatGPT (gpt-5), Gemini 2.5 Flash, Perplexity (sonar), con ricerca web attiva |
Risposte raccolte | 60 |
Fonti distinte trovate | 432 domini |
Costo di una passata completa | 1.444 dollari |
Copertura ripetuta | 5 prompt eseguiti due volte nello stesso giorno |
Abbiamo trattato ciascuna delle 60 risposte come un'osservazione dell'universo delle fonti e contato i domini distinti, non gli slot di citazione. Gemini ha restituito 989 annotazioni di fonte sulle sue 20 risposte, ma molte puntavano alla stessa pagina, quindi il conteggio dei domini è l'unità onesta qui. I dati a livello di annotazione sono nell'analisi del verificatore di visibilità IA.
Risultato 1: l'elenco non si chiude mai
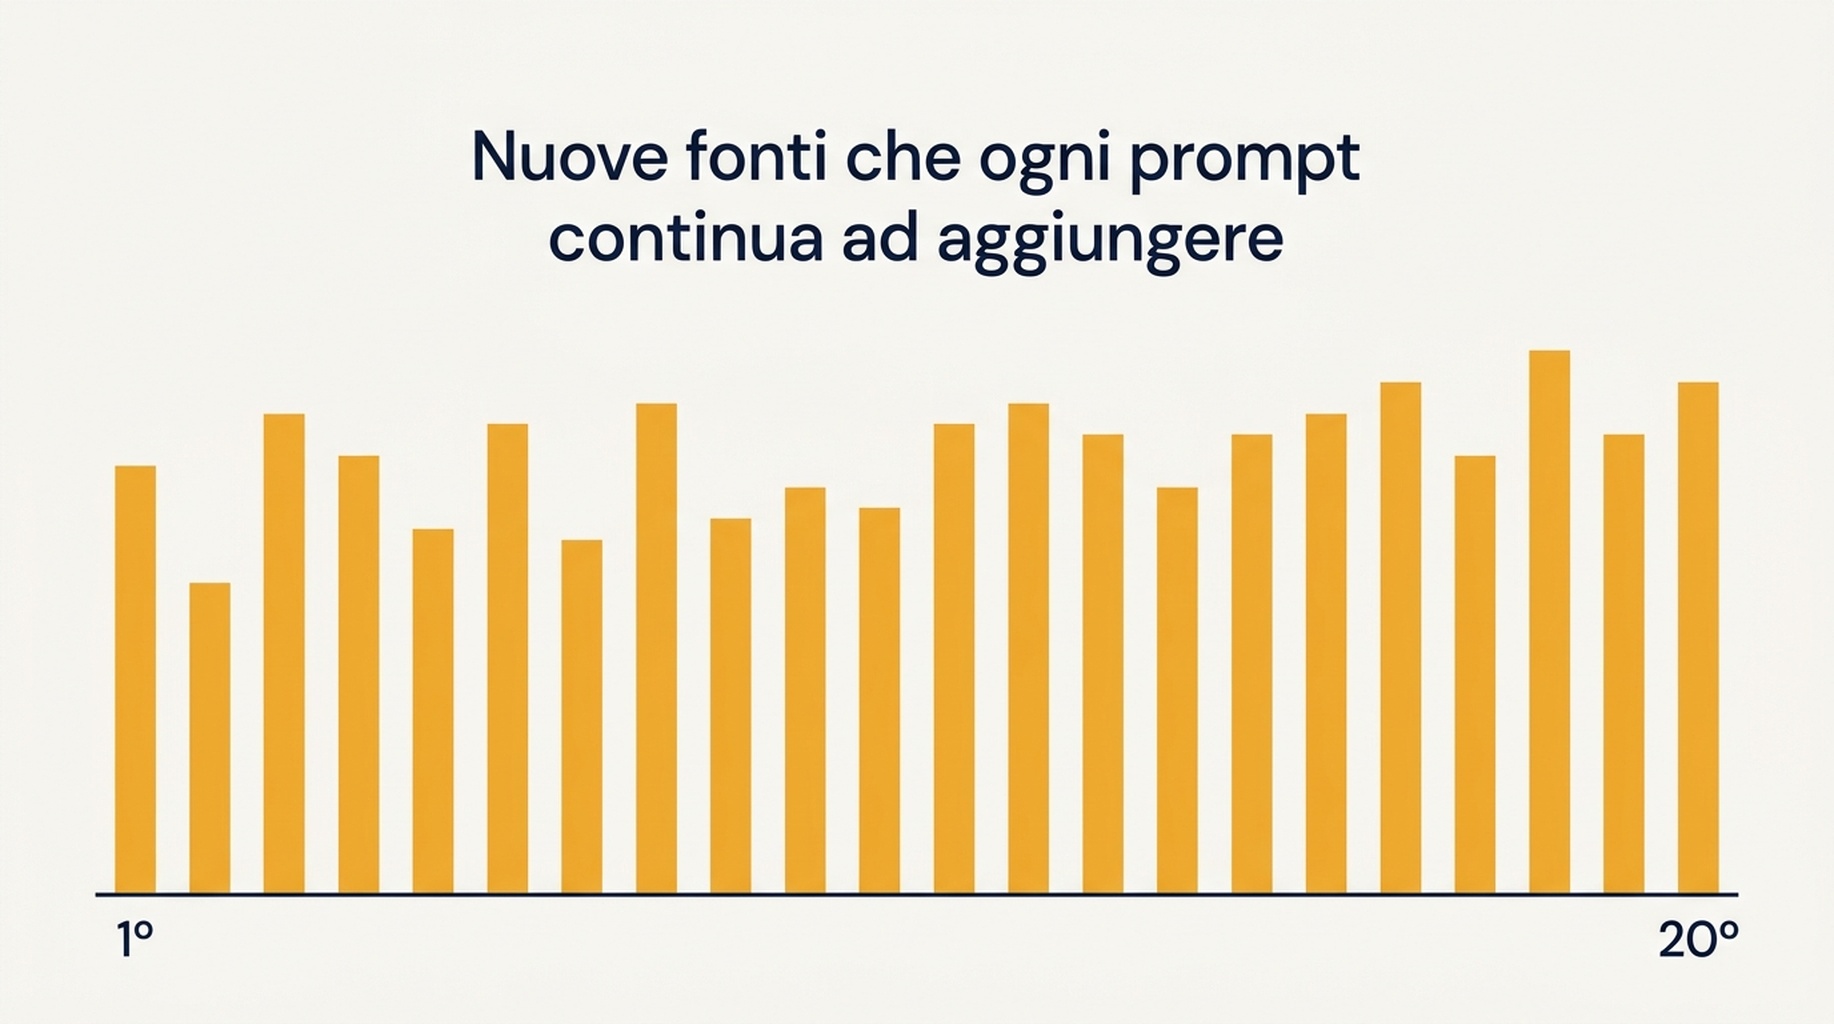
È questa la parte che decide come va costruito un programma di monitoraggio. Dopo ogni prompt sommavamo i suoi nuovi domini a tutto ciò che era stato trovato fino a quel momento.
Prompt eseguiti | Fonti distinte trovate | Quota sul totale dei 20 prompt |
|---|---|---|
1 | 34 | 8 per cento |
3 | 91 | 21 per cento |
5 | 134 | 31 per cento |
10 | 235 | 54 per cento |
15 | 336 | 78 per cento |
20 | 432 | 100 per cento |
L'ultimo prompt ha aggiunto 14 domini che nessun prompt precedente aveva fatto emergere. Il guadagno marginale più piccolo lungo i 20 prompt è stato 14, il più grande 34. Non esiste, in quell'intervallo, un punto in cui un prompt in più smetta di ripagarsi, il che significa che un elenco di prompt non è un campione che si completa, ma un campione che si continua a estrarre.
La versione pratica: un elenco di cinque prompt scritto a memoria copre circa un terzo di ciò che coprono venti prompt. È lì la differenza tra un programma di monitoraggio che si accorge di un cambio di categoria e uno che riporta le stesse cinque risposte ogni mese.
Risultato 2: ogni superficie vede un terzo diverso dello stesso spazio
I 432 domini non si sono distribuiti in modo uniforme. Ogni superficie ha raggiunto una fetta diversa dello stesso insieme di domande.
Superficie | Fonti distinte | Quota sui 432 | Mediana delle fonti per risposta |
|---|---|---|---|
ChatGPT | 47 | 11 per cento | 0 |
Gemini 2.5 Flash | 184 | 43 per cento | 12 |
Perplexity | 285 | 66 per cento | 19 |
Gemini e Perplexity insieme hanno trovato 400 dei 432 domini, quindi ChatGPT ha aggiunto 32 domini che nessun'altra superficie ha fatto emergere. Nei 12 prompt in cui ChatGPT non ha cercato, quella superficie non ha contribuito affatto, ed è per questo che la sua mediana è zero.
La conseguenza per il monitoraggio è scomoda. Se il tuo strumento osserva una sola superficie, non stai eseguendo una versione ridotta di un programma a tre superfici. Stai riportando una popolazione di fonti diversa, e la risposta a "questo mese ci citano di più" può semplicemente essere "non abbiamo cambiato nulla, è cambiata la superficie". Abbiamo misurato lo stesso effetto a livello di risposta nella variabilità di esecuzione del tracker di visibilità IA.
Risultato 3: due superfici raramente concordano sullo stesso prompt
Abbiamo confrontato gli elenchi di fonti che Gemini e Perplexity hanno prodotto per lo stesso prompt, nello stesso giorno e nella stessa lingua.
- I due elenchi condividevano in media 2,5 domini su una ventina ciascuno.
- La sovrapposizione media di Jaccard era 0,089.
- E solo in 3 degli 8 prompt in cui anche ChatGPT restituiva fonti le tre superfici condividevano almeno un dominio, con la maggiore sovrapposizione tripla a 2 domini.
- L'accordo totale delle tre superfici su un singolo prompt non si è mai verificato.
Due risposte alla stessa domanda, costruite su insiemi di pagine quasi disgiunti. È l'argomento più forte che abbiamo trovato contro il reporting da una sola superficie, ed è anche una buona notizia: una pagina nuova ha molte più probabilità di essere ripresa di quanto lasci intendere un unico elenco di fonti.
Risultato 4: la maggior parte delle fonti compare una volta sola
I 432 domini sono distribuiti in modo estremamente disomogeneo.
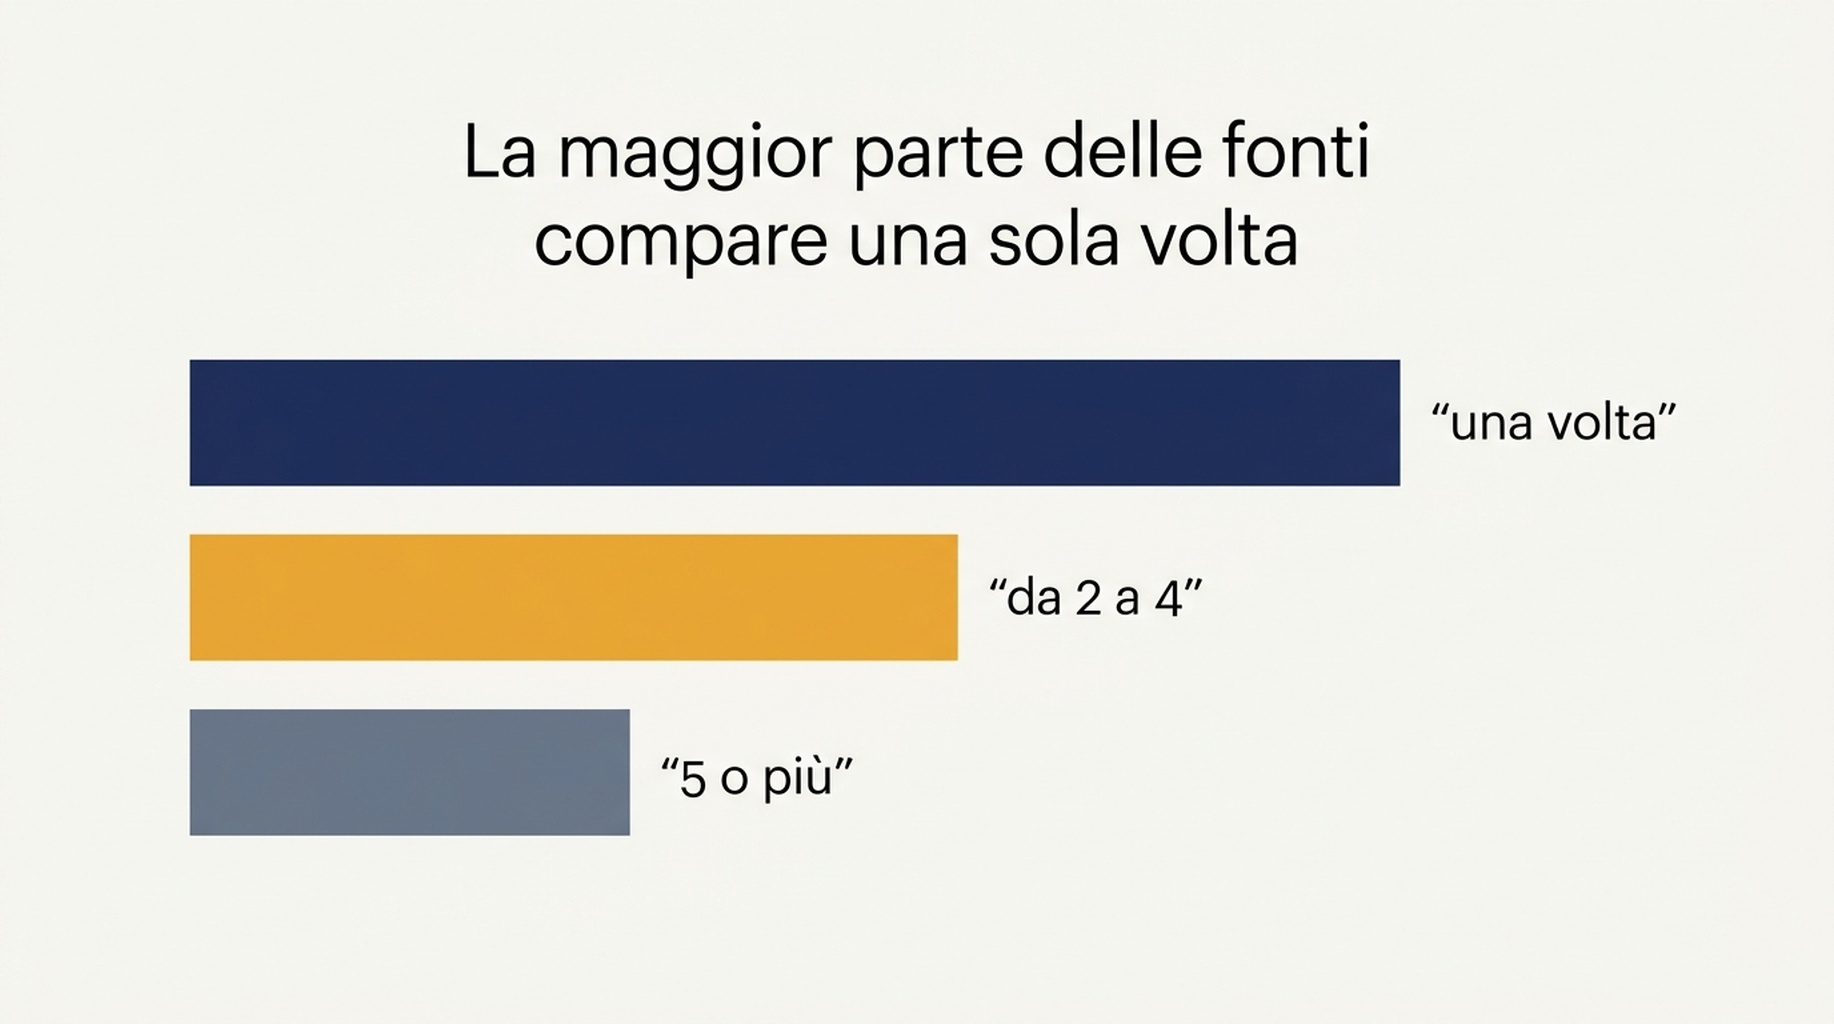
- 324 dei 432 domini, cioè il 75 per cento, sono comparsi in esattamente una delle 60 risposte.
- Solo 17 domini sono comparsi in 5 risposte o più.
- Il nucleo ricorrente è piccolo e prevedibile: ahrefs.com in 16 risposte, semrush.com in 15, reddit.com in 14, poi frase.io a 9, e un gruppo a 6 che comprende otterly.ai, tryprofound.com, llmpulse.ai, cognizo.ai e searchenginejournal.com.
Questo spacca il lavoro di monitoraggio in due, e le due metà vogliono cadenze diverse. Il nucleo ricorrente è lo strato che si ricontrolla spesso, perché un cambiamento lì è uno spostamento reale in una fonte condivisa. La coda delle comparse singole è lo strato che si campiona, perché il 75 per cento dell'universo è rumore finché non si ripete.
Che cosa monitorare al posto di un elenco completo
Strato | Che cosa contiene | Cadenza | Costo mensile dei dati |
|---|---|---|---|
Strato 1: nucleo ricorrente | I 17 domini ricorrenti, più il tuo dominio e i tre concorrenti più vicini | Settimanale su una superficie | 0,48 dollari su Perplexity, 3,23 dollari su Gemini |
Strato 2: panel di prompt | Da 15 a 20 prompt che coprono categoria, confronto, prezzo e formulazione del problema | Mensile sulle tre superfici | 1,44 dollari per passata |
Strato 3: scoperta dei prompt | 5 prompt nuovi al mese, scritti a partire dalle chiamate commerciali e dai ticket di assistenza | Revisione trimestrale, poi promozione o scarto | Incluso nella passata mensile |
Da questa esecuzione sono uscite tre regole.
- Registra la classe del prompt, non solo il prompt. La nostra risposta più ampia è venuta da un prompt su come essere citati, non da un confronto tra strumenti, e la più stretta è venuta proprio da un confronto. Le classi si comportano in modo diverso, e ciò che si riporta è la classe.
- Tieni la superficie in ogni record. Un numero di citazioni senza il nome della superficie non è confrontabile, perché la lunghezza degli elenchi varia di un fattore tre.
- Ruota i prompt di scoperta. Venti prompt hanno trovato 432 domini, e la curva dice che altri venti ne troverebbero altre centinaia. Promozione e dismissione sono l'unico meccanismo che tiene onesto il panel.
Il costo non è il vincolo qui. Una passata completa di venti prompt su tre superfici è costata 1.444 dollari, quindi un programma mensile si aggira sui 17 dollari all'anno di dati, prima del tempo di revisione. Il vincolo è che il tempo di revisione è la metà costosa, ed è per questo che la struttura a strati conta più della lunghezza dell'elenco. La superficie IA di Google non è affatto in questo panel e richiede un altro strumento, come spiega il nostro tracker di AI Overview.
Limiti
- Un giorno, una località, l'inglese, tre superfici, una versione di modello per ciascuna.
- Il conteggio dei domini elimina i duplicati dentro una risposta, quindi una pagina citata cinque volte conta una volta.
- Le classi di prompt le abbiamo assegnate noi, non una tassonomia esterna.
- I numeri di costo coprono solo la generazione delle risposte.
- Il contributo di ChatGPT è compresso dai 12 prompt in cui non ha cercato, e quella è una proprietà di quella superficie, non dell'insieme di prompt.
Domande frequenti
Quanti prompt servono per il monitoraggio del marchio nell'IA?
Non c'è un punto di arrivo nei nostri dati. Venti prompt hanno trovato 432 fonti e il ventesimo ne ha comunque aggiunte 14 nuove. Scegli una dimensione del panel che riesci a rivedere ogni mese, poi investi lo sforzo sulla qualità e sulla rotazione dei prompt, non sulla lunghezza dell'elenco.
Devo monitorare una superficie IA o più di una?
Più di una, e riportarle separatamente. Le due superfici più pesanti condividevano in media 2,5 fonti per prompt, e l'accordo triplo completo non si è mai verificato. Un programma a superficie singola misura quella superficie, non la tua categoria.
Vale la pena seguire un dominio che compare una volta sola?
Solo come osservazione. 324 dei 432 domini sono comparsi una volta, quindi una comparsa singola è più vicina al rumore che al segnale. Promuovi un dominio allo strato ricorrente dopo che è comparso in una seconda risposta, meglio se su una seconda superficie.
Con che frequenza deve girare il panel?
Mensile per il panel completo, settimanale per il nucleo ricorrente. L'elenco ricorrente è abbastanza corto perché una passata settimanale su una superficie economica costi meno di cinquanta centesimi al mese, ed è la passata mensile il punto in cui entrano fonti nuove.
Vista Auspia: smettete di dimensionare gli elenchi di prompt su quanto sembrano accurati e cominciate a misurare quando smettono di trovare qualcosa. Nei nostri dati quel punto non è mai arrivato, il che significa che l'unità di pianificazione giusta sono le classi di prompt e la rotazione, non un elenco più lungo. Stratificate le fonti ricorrenti, campionate la coda e tenete il nome della superficie attaccato a ogni numero che riportate.
Scritto da: Elena Shaw