Tout plan de veille de marque dans l'IA commence par une liste de prompts, et presque toutes ces listes sont construites à partir de ce que l'équipe croit déjà. Vingt prompts semblent sérieux. Cinquante semblent exhaustifs. Personne ne vérifie si la liste découvre encore quelque chose.
En septembre 2026, nous avons lancé vingt prompts sur trois surfaces d'IA et suivi une seule chose : d'où venaient les sources. Pas les mentions de notre marque, mais l'ensemble complet des domaines que les réponses ont mobilisés. Si la liste de prompts était complète, ajouter des prompts devrait cesser de trouver de nouvelles sources. Ce n'est pas ce qui s'est passé.
Ce que nous avons mesuré
Élément | Réglage |
|---|---|
Prompts | 20 questions d'acheteur sur les outils de visibilité dans l'IA |
Surfaces | ChatGPT (gpt-5), Gemini 2.5 Flash, Perplexity (sonar), recherche web activée |
Réponses collectées | 60 |
Sources distinctes trouvées | 432 domaines |
Coût d'une passe complète | 1 444 dollars |
Couverture répétée | 5 prompts exécutés deux fois le même jour |
Nous avons traité chacune des 60 réponses comme une observation de l'univers des sources et compté les domaines distincts, pas les emplacements de citation. Gemini a renvoyé 989 annotations de source sur ses 20 réponses, mais beaucoup pointaient vers la même page, si bien que le nombre de domaines est l'unité honnête ici. Les données au niveau des annotations se trouvent dans l'analyse du vérificateur de visibilité IA.
Résultat 1 : la liste ne se ferme jamais
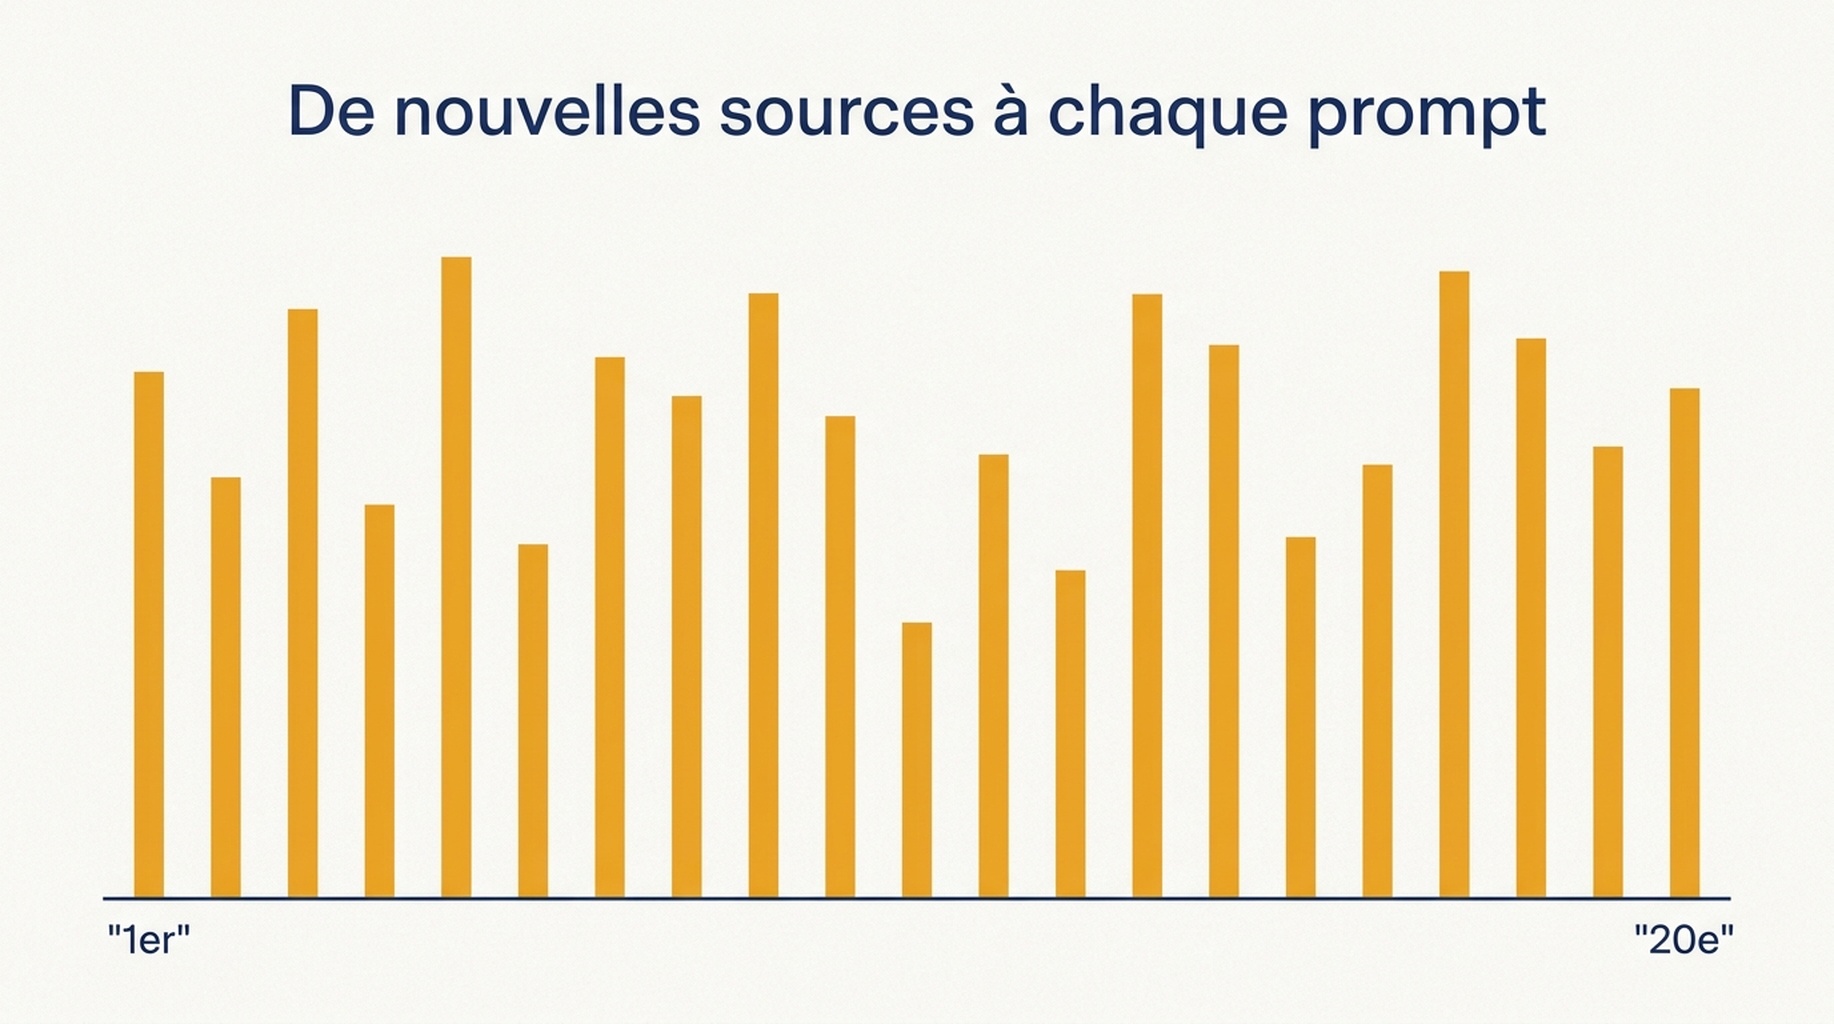
C'est cette partie qui décide de la manière de construire un programme de veille. Après chaque prompt, nous ajoutions ses nouveaux domaines à tout ce qui avait été trouvé jusque-là.
Prompts exécutés | Sources distinctes trouvées | Part du total des 20 prompts |
|---|---|---|
1 | 34 | 8 pour cent |
3 | 91 | 21 pour cent |
5 | 134 | 31 pour cent |
10 | 235 | 54 pour cent |
15 | 336 | 78 pour cent |
20 | 432 | 100 pour cent |
Le dernier prompt a ajouté 14 domaines qu'aucun prompt précédent n'avait fait apparaître. Le plus petit gain marginal sur les 20 prompts a été de 14, le plus grand de 34. Il n'existe dans cette plage aucun point où un prompt supplémentaire cesse d'être rentable, ce qui signifie qu'une liste de prompts n'est pas un échantillon que l'on complète, mais un échantillon que l'on continue de tirer.
La version pratique : une liste de cinq prompts écrite de mémoire couvre environ un tiers de ce que couvrent vingt prompts. C'est là l'écart entre un programme de veille qui remarque un changement de catégorie et un programme qui rapporte les mêmes cinq réponses chaque mois.
Résultat 2 : chaque surface voit un tiers différent du même espace
Les 432 domaines ne se sont pas répartis uniformément. Chaque surface a atteint une tranche différente du même ensemble de questions.
Surface | Sources distinctes | Part des 432 | Médiane des sources par réponse |
|---|---|---|---|
ChatGPT | 47 | 11 pour cent | 0 |
Gemini 2.5 Flash | 184 | 43 pour cent | 12 |
Perplexity | 285 | 66 pour cent | 19 |
Gemini et Perplexity ont trouvé à eux deux 400 des 432 domaines, ce qui signifie que ChatGPT a ajouté 32 domaines qu'aucune autre surface n'a fait apparaître. Sur les 12 prompts où ChatGPT n'a pas cherché, cette surface n'a rien apporté du tout, et c'est pourquoi sa médiane est nulle.
La conséquence pour la veille est inconfortable. Si votre outil de suivi n'observe qu'une seule surface, vous ne faites pas tourner une version réduite d'un programme à trois surfaces. Vous rendez compte d'une autre population de sources, et la réponse à « sommes-nous cités davantage ce mois-ci » peut simplement être « nous n'avons rien changé, c'est la surface qui a changé ». Nous avons mesuré le même effet au niveau des réponses dans la variance d'exécution du traqueur de visibilité IA.
Résultat 3 : deux surfaces s'accordent rarement sur le même prompt
Nous avons comparé les listes de sources que Gemini et Perplexity ont produites pour le même prompt, le même jour, dans la même langue.
- Les deux listes partageaient en moyenne 2,5 domaines sur une vingtaine chacune.
- Le recouvrement moyen de Jaccard était de 0,089.
- Et sur seulement 3 des 8 prompts où ChatGPT a aussi renvoyé des sources, les trois surfaces ont partagé ne serait-ce qu'un domaine, le plus grand recouvrement triple atteignant 2 domaines.
- L'accord complet des trois surfaces sur un même prompt n'est jamais arrivé.
Deux réponses à la même question, construites à partir d'ensembles de pages presque disjoints. C'est l'argument le plus fort que nous ayons trouvé contre le reporting sur une seule surface, et c'est aussi une bonne nouvelle : une nouvelle page a bien plus de chances d'être reprise qu'une liste de sources unique ne le laisse croire.
Résultat 4 : la plupart des sources n'apparaissent qu'une fois
Les 432 domaines sont extrêmement inégalement répartis.
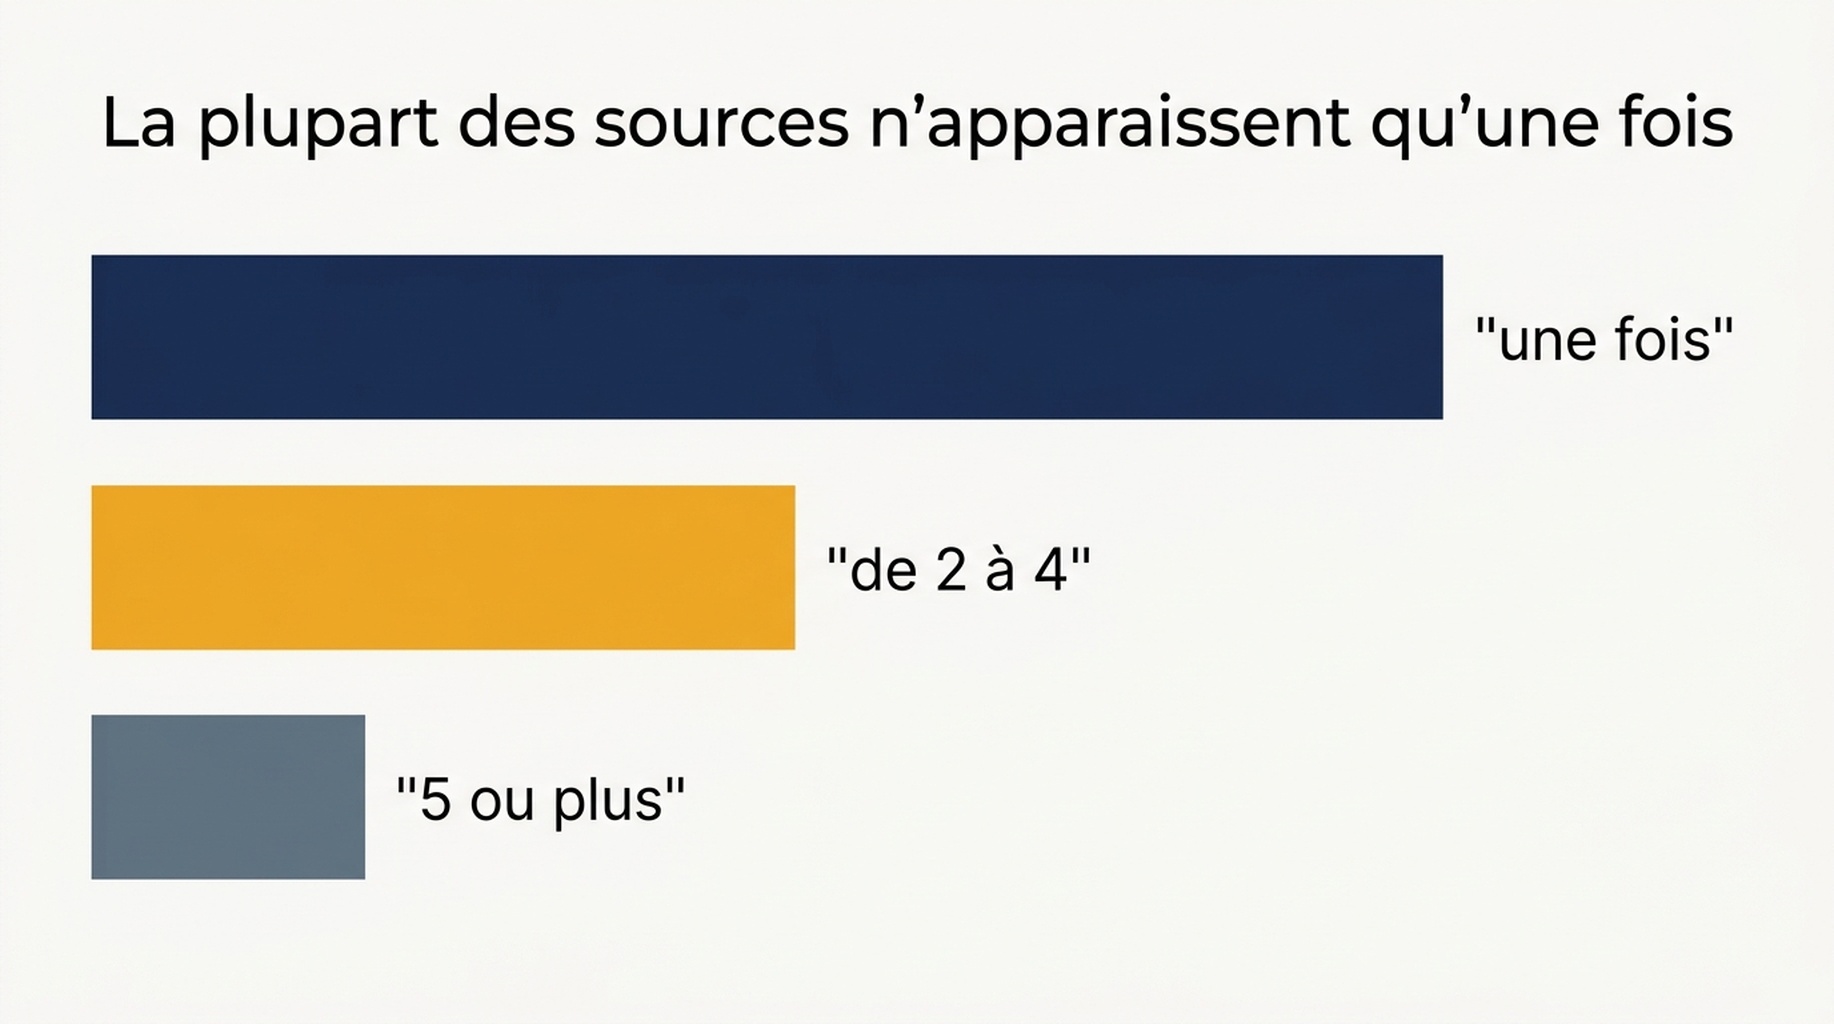
- 324 des 432 domaines, soit 75 pour cent, sont apparus dans exactement une des 60 réponses.
- Seuls 17 domaines sont apparus dans 5 réponses ou plus.
- Le noyau récurrent est petit et prévisible : ahrefs.com dans 16 réponses, semrush.com dans 15, reddit.com dans 14, puis frase.io à 9, et un groupe à 6 comprenant otterly.ai, tryprofound.com, llmpulse.ai, cognizo.ai et searchenginejournal.com.
Cela scinde le travail de veille en deux, et les deux moitiés veulent des rythmes différents. Le noyau récurrent est la couche que l'on revérifie souvent, parce qu'un changement y est un vrai déplacement dans une source partagée. La queue des apparitions uniques est la couche que l'on échantillonne, parce que 75 pour cent de l'univers est du bruit tant qu'il ne se répète pas.
Quoi surveiller à la place d'une liste complète
Couche | Ce qu'elle contient | Rythme | Coût mensuel des données |
|---|---|---|---|
Couche 1 : noyau récurrent | Les 17 domaines récurrents, plus votre domaine et vos trois concurrents les plus proches | Hebdomadaire sur une surface | 0,48 dollar sur Perplexity, 3,23 dollars sur Gemini |
Couche 2 : panel de prompts | 15 à 20 prompts couvrant catégorie, comparaison, prix et formulation du problème | Mensuel sur les trois surfaces | 1,44 dollar par passe |
Couche 3 : découverte de prompts | 5 nouveaux prompts par mois, écrits à partir des appels commerciaux et des tickets de support | Revue trimestrielle, puis promotion ou abandon | Inclus dans la passe mensuelle |
Trois règles sont sorties de cette exécution.
- Consignez la classe du prompt, pas seulement le prompt. Notre réponse la plus large venait d'un prompt sur la manière d'être cité, pas d'une comparaison d'outils, et la plus étroite venait justement d'une comparaison. Les classes se comportent différemment, et c'est la classe que l'on rapporte.
- Gardez la surface dans chaque enregistrement. Un nombre de citations sans le nom de la surface n'est pas comparable, car la longueur des listes varie d'un facteur trois.
- Faites tourner les prompts de découverte. Vingt prompts ont trouvé 432 domaines, et la courbe dit que vingt autres en trouveraient quelques centaines d'autres. La promotion et la mise au rebut sont le seul mécanisme qui garde le panel honnête.
Le coût n'est pas la contrainte ici. Une passe complète de vingt prompts sur trois surfaces a coûté 1 444 dollars, donc un programme mensuel revient à environ 17 dollars par an en données, hors temps de revue. La contrainte, c'est que le temps de revue est la moitié coûteuse, et c'est pourquoi la structure en couches compte plus que la longueur de la liste. La surface IA de Google n'est pas du tout dans ce panel et exige un autre instrument, comme l'explique notre traqueur AI Overview.
Limites
- Un jour, un lieu, l'anglais, trois surfaces, une version de modèle pour chacune.
- Le comptage des domaines supprime les doublons à l'intérieur d'une réponse, donc une page citée cinq fois compte une fois.
- Les classes de prompts ont été attribuées par nous, et non par une taxonomie externe.
- Les chiffres de coût ne couvrent que la génération des réponses.
- La contribution de ChatGPT est tirée vers le bas par les 12 prompts où il n'a pas cherché, et c'est une propriété de cette surface, pas du jeu de prompts.
Questions fréquentes
De combien de prompts ai-je besoin pour la veille de marque dans l'IA ?
Il n'y a pas de point d'achèvement dans nos données. Vingt prompts ont trouvé 432 sources et le vingtième en a encore ajouté 14. Choisissez une taille de panel que vous pouvez revoir chaque mois, puis investissez l'effort dans la qualité et la rotation des prompts plutôt que dans la longueur de la liste.
Faut-il surveiller une surface d'IA ou plusieurs ?
Plusieurs, et les rapporter séparément. Les deux surfaces les plus lourdes partageaient en moyenne 2,5 sources par prompt, et l'accord triple complet n'est jamais arrivé. Un programme à surface unique mesure cette surface, pas votre catégorie.
Un domaine qui apparaît une fois vaut-il la peine d'être suivi ?
Seulement comme observation. 324 des 432 domaines sont apparus une fois, donc une apparition unique est plus proche du bruit que du signal. Promouvez un domaine dans la couche récurrente après son apparition dans une deuxième réponse, idéalement sur une deuxième surface.
À quelle fréquence le panel doit-il tourner ?
Mensuellement pour le panel complet, hebdomadairement pour le noyau récurrent. La liste des récurrents est assez courte pour qu'une passe hebdomadaire sur une surface bon marché coûte moins de cinquante centimes par mois, et c'est la passe mensuelle qui fait entrer les nouvelles sources.
Point de vue Auspia : cessez de dimensionner les listes de prompts à la sensation de sérieux qu'elles procurent et commencez à mesurer quand elles cessent de trouver quoi que ce soit. Dans nos données, ce point n'est jamais arrivé, ce qui signifie que la bonne unité de planification est la classe de prompt et la rotation, pas une liste plus longue. Stratifiez les sources récurrentes, échantillonnez la queue, et gardez le nom de la surface collé à chaque chiffre que vous rapportez.
Auteur : Elena Shaw