Mọi kế hoạch giám sát thương hiệu trên AI đều bắt đầu bằng một danh sách prompt, và gần như mọi danh sách đều được dựng từ những gì đội ngũ đã tin sẵn. Hai mươi prompt có vẻ kỹ lưỡng. Năm mươi prompt có vẻ đầy đủ. Không ai kiểm tra xem danh sách còn khám phá được gì nữa hay không.
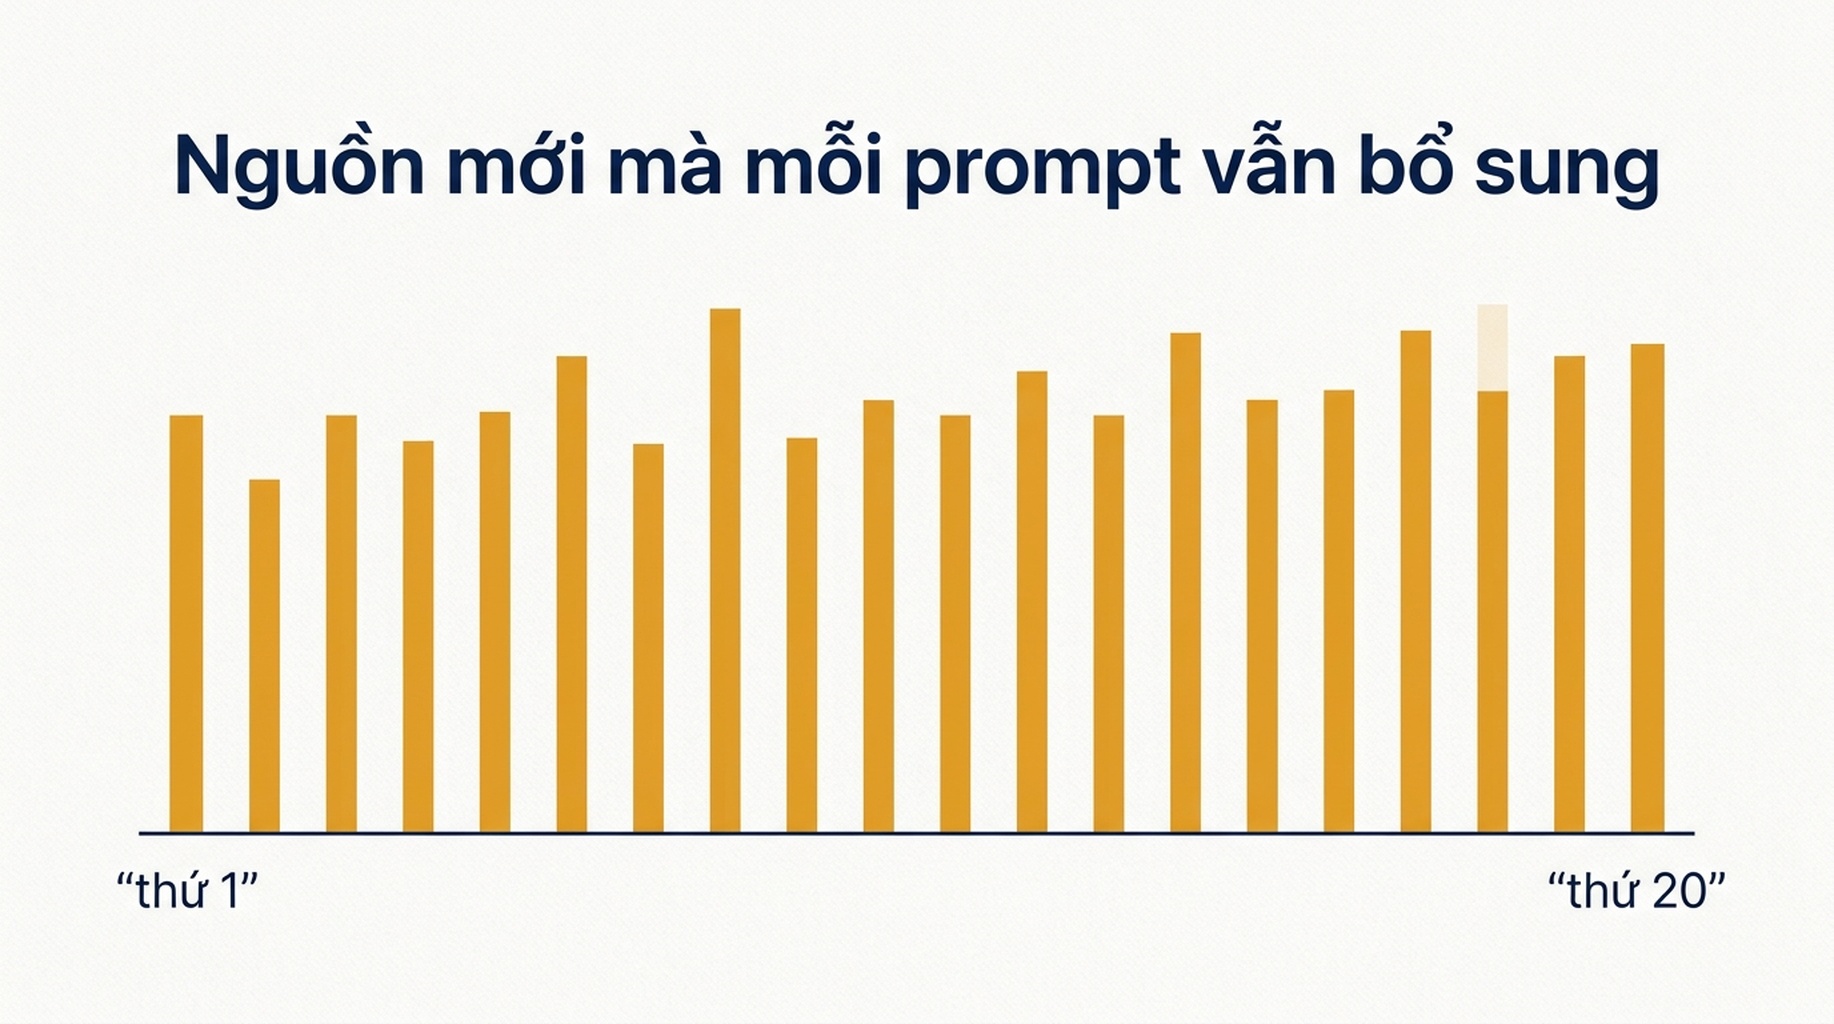
Tháng 9 năm 2026, chúng tôi chạy hai mươi prompt trên ba bề mặt AI và theo dõi đúng một thứ: nguồn đến từ đâu. Không phải lượt nhắc đến thương hiệu của chúng tôi, mà là toàn bộ tập tên miền mà các câu trả lời kéo về. Nếu danh sách prompt đã đầy đủ, thêm prompt phải ngừng tìm ra nguồn mới. Điều đó đã không xảy ra.
Chúng tôi đo những gì
Mục | Thiết lập |
|---|---|
Prompt | 20 câu hỏi của người mua về công cụ hiển thị trên AI |
Bề mặt | ChatGPT (gpt-5), Gemini 2.5 Flash, Perplexity (sonar), bật tìm kiếm web |
Câu trả lời thu được | 60 |
Nguồn riêng biệt tìm được | 432 tên miền |
Chi phí một lượt đầy đủ | 1.444 đô la |
Độ phủ lặp lại | 5 prompt chạy hai lần trong cùng ngày |
Chúng tôi coi mỗi câu trong 60 câu trả lời là một quan sát về vũ trụ nguồn và đếm tên miền riêng biệt, không đếm vị trí trích dẫn. Gemini trả về 989 chú thích nguồn trên 20 câu trả lời, nhưng nhiều chú thích trỏ cùng một trang, nên số tên miền mới là đơn vị trung thực ở đây. Dữ liệu ở cấp chú thích nằm trong phân tích công cụ kiểm tra hiển thị trên AI.
Kết quả 1: danh sách không bao giờ khép lại
Đây chính là phần quyết định cách xây một chương trình giám sát. Sau mỗi prompt, chúng tôi cộng các tên miền mới của nó vào mọi thứ đã tìm được trước đó.
Số prompt đã chạy | Nguồn riêng biệt tìm được | Tỷ lệ trên tổng 20 prompt |
|---|---|---|
1 | 34 | 8 phần trăm |
3 | 91 | 21 phần trăm |
5 | 134 | 31 phần trăm |
10 | 235 | 54 phần trăm |
15 | 336 | 78 phần trăm |
20 | 432 | 100 phần trăm |
Prompt cuối cùng thêm 14 tên miền mà không prompt nào trước đó làm lộ ra. Mức tăng biên nhỏ nhất trong suốt 20 prompt là 14, lớn nhất là 34. Trong khoảng đó không có điểm nào mà thêm một prompt nữa ngừng hoàn vốn, nghĩa là danh sách prompt không phải một mẫu để hoàn tất, mà là một mẫu để tiếp tục rút ra.
Cách hiểu thực dụng: một danh sách năm prompt viết từ trí nhớ phủ khoảng một phần ba những gì hai mươi prompt phủ. Đó là khoảng cách giữa một chương trình giám sát nhận ra thay đổi của cả hạng mục và một chương trình tháng nào cũng báo cáo đúng năm câu trả lời cũ.
Kết quả 2: mỗi bề mặt nhìn thấy một phần ba khác nhau của cùng một không gian
432 tên miền không phân bố đều. Mỗi bề mặt với tới một lát cắt khác của cùng tập câu hỏi.
Bề mặt | Nguồn riêng biệt | Tỷ lệ trên 432 | Trung vị nguồn mỗi câu trả lời |
|---|---|---|---|
ChatGPT | 47 | 11 phần trăm | 0 |
Gemini 2.5 Flash | 184 | 43 phần trăm | 12 |
Perplexity | 285 | 66 phần trăm | 19 |
Gemini và Perplexity cùng nhau tìm được 400 trong 432 tên miền, nghĩa là ChatGPT thêm 32 tên miền mà không bề mặt nào khác làm lộ ra. Ở 12 prompt mà ChatGPT không tìm kiếm, bề mặt đó không đóng góp gì, và đó là lý do trung vị của nó bằng không.
Hệ quả cho việc giám sát thì không dễ chịu. Nếu công cụ theo dõi của bạn chỉ quan sát một bề mặt, bạn không chạy một phiên bản thu nhỏ của chương trình ba bề mặt. Bạn đang báo cáo một tập nguồn khác, và câu trả lời cho "tháng này chúng ta có được trích dẫn nhiều hơn không" có thể chỉ đơn giản là "chúng ta không đổi gì cả, bề mặt mới là thứ đổi". Chúng tôi đo cùng hiệu ứng đó ở cấp câu trả lời trong độ dao động giữa các lần chạy của công cụ theo dõi hiển thị trên AI.
Kết quả 3: hai bề mặt hiếm khi đồng ý ở cùng một prompt
Chúng tôi so sánh danh sách nguồn mà Gemini và Perplexity tạo ra cho cùng một prompt, cùng ngày, cùng ngôn ngữ.
- Hai danh sách chia sẻ trung bình 2,5 tên miền trên khoảng hai mươi tên miền mỗi bên.
- Độ trùng lặp Jaccard trung bình là 0,089.
- Và chỉ ở 3 trong 8 prompt mà ChatGPT cũng trả về nguồn, cả ba bề mặt mới chia sẻ dù chỉ một tên miền, với mức trùng ba chiều lớn nhất là 2 tên miền.
- Sự đồng thuận hoàn toàn của cả ba bề mặt ở một prompt duy nhất chưa bao giờ xảy ra.
Hai câu trả lời cho cùng một câu hỏi, dựng từ những tập trang gần như tách rời. Đó là lập luận mạnh nhất chúng tôi tìm được chống lại việc báo cáo từ một bề mặt, và cũng là tin tốt: một trang mới có nhiều cơ hội được chọn hơn hẳn so với điều mà một danh sách nguồn duy nhất gợi ra.
Kết quả 4: phần lớn nguồn chỉ xuất hiện một lần
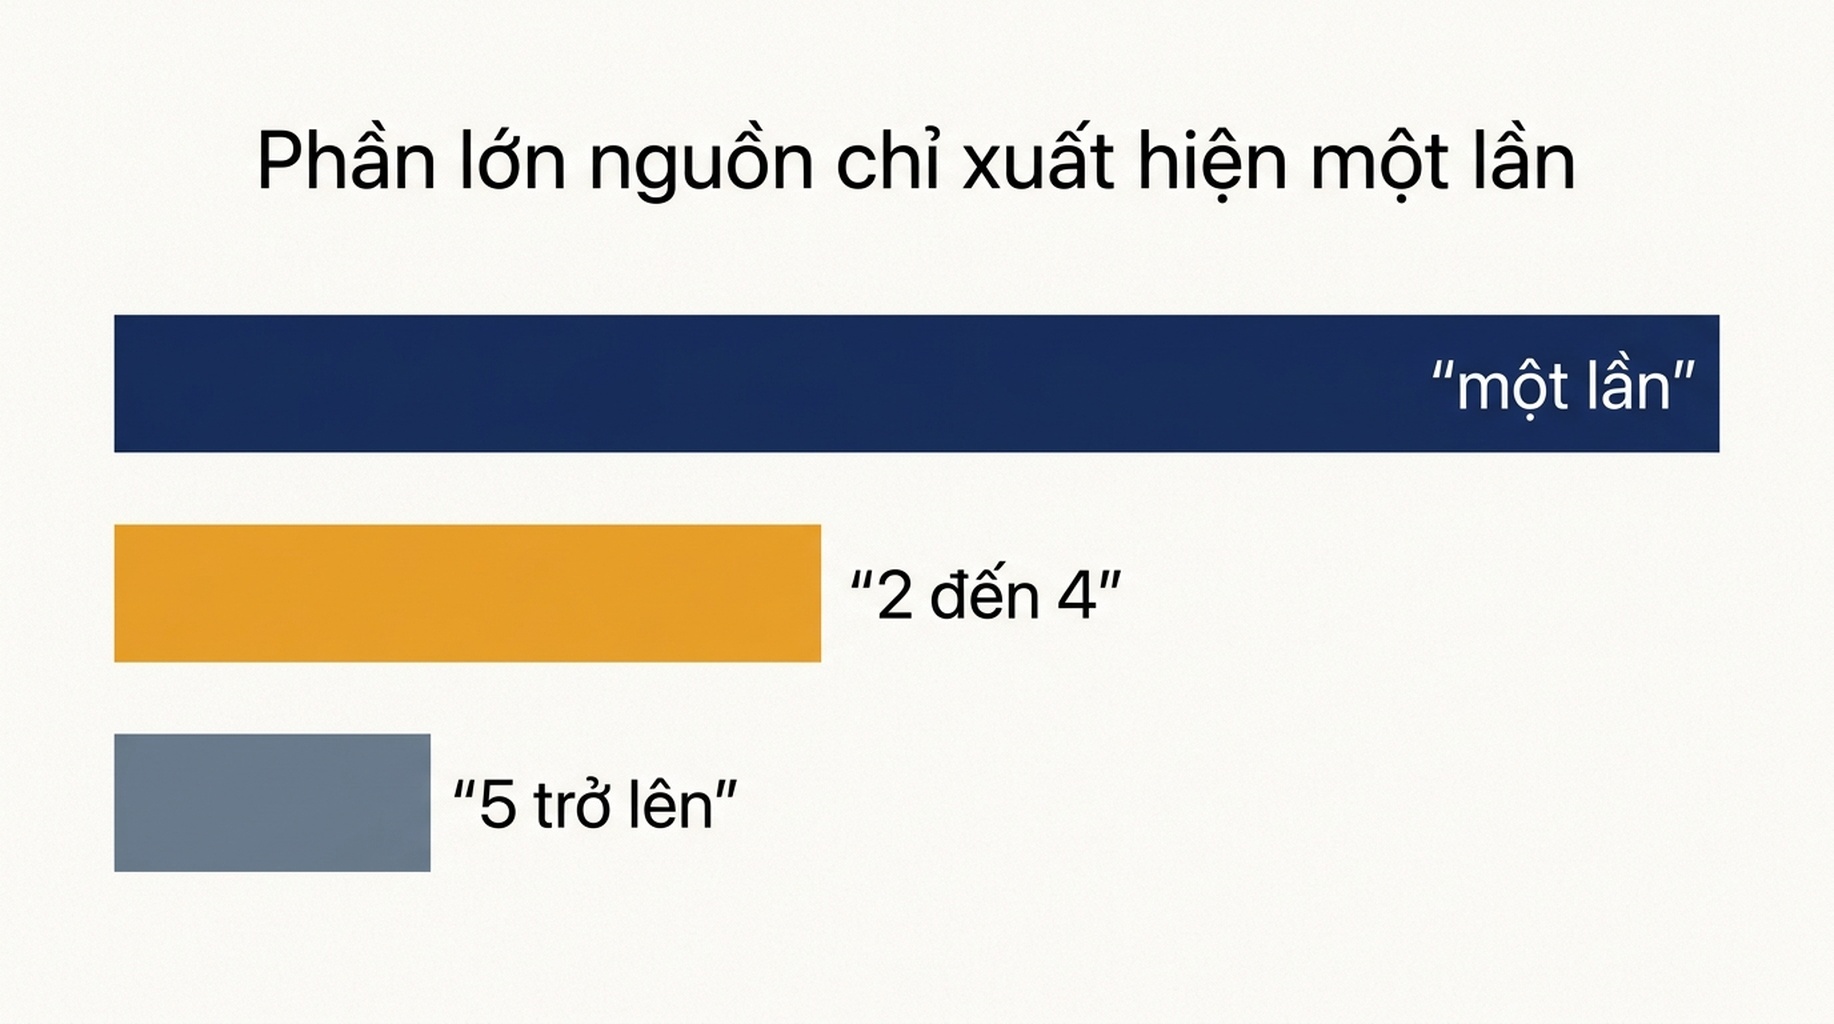
432 tên miền phân bố cực kỳ không đều.
- 324 trong 432 tên miền, tức 75 phần trăm, xuất hiện đúng ở một trong 60 câu trả lời.
- Chỉ 17 tên miền xuất hiện ở 5 câu trả lời trở lên.
- Phần lõi lặp lại thì nhỏ và dễ đoán: ahrefs.com ở 16 câu trả lời, semrush.com ở 15, reddit.com ở 14, rồi frase.io ở 9, và một cụm ở mức 6 gồm otterly.ai, tryprofound.com, llmpulse.ai, cognizo.ai và searchenginejournal.com.
Điều này chia công việc giám sát thành hai, và hai nửa muốn hai nhịp khác nhau. Lõi lặp lại là lớp được kiểm tra lại thường xuyên, vì thay đổi ở đó là dịch chuyển thật trong một nguồn dùng chung. Phần đuôi xuất hiện một lần là lớp được lấy mẫu, vì 75 phần trăm vũ trụ là nhiễu cho tới khi nó lặp lại.
Giám sát gì thay cho một danh sách đầy đủ
Lớp | Gồm những gì | Nhịp | Chi phí dữ liệu hằng tháng |
|---|---|---|---|
Lớp 1: lõi lặp lại | 17 tên miền lặp lại, cộng tên miền của bạn và ba đối thủ gần nhất | Hằng tuần trên một bề mặt | 0,48 đô la trên Perplexity, 3,23 đô la trên Gemini |
Lớp 2: bảng prompt | 15 đến 20 prompt bao quát hạng mục, so sánh, giá và cách phát biểu vấn đề | Hằng tháng trên cả ba bề mặt | 1,44 đô la mỗi lượt |
Lớp 3: khám phá prompt | 5 prompt mới mỗi tháng, viết từ các cuộc gọi bán hàng và phiếu hỗ trợ | Rà soát hằng quý, rồi nâng lên hoặc loại bỏ | Nằm trong lượt hằng tháng |
Ba quy tắc rút ra từ lần chạy này.
- Ghi lại hạng của prompt, không chỉ ghi prompt. Câu trả lời rộng nhất của chúng tôi đến từ một prompt về cách được trích dẫn nói chung, không phải từ so sánh công cụ, còn câu hẹp nhất lại đến từ đúng một so sánh. Mỗi hạng hành xử một kiểu, và thứ được báo cáo là hạng.
- Giữ tên bề mặt trong mọi bản ghi. Một con số trích dẫn không có tên bề mặt thì không so sánh được, vì độ dài danh sách chênh nhau tới ba lần.
- Luân phiên các prompt khám phá. Hai mươi prompt tìm được 432 tên miền, và đường cong nói rằng hai mươi prompt khác sẽ tìm được vài trăm tên miền khác. Nâng lên và loại bỏ là cơ chế duy nhất giữ cho bảng trung thực.
Chi phí không phải là ràng buộc ở đây. Một lượt đầy đủ hai mươi prompt trên ba bề mặt tốn 1.444 đô la, nên một chương trình hằng tháng rơi vào khoảng 17 đô la một năm tiền dữ liệu, chưa tính thời gian rà soát. Ràng buộc nằm ở chỗ thời gian rà soát mới là nửa đắt đỏ, và đó là lý do cấu trúc theo lớp quan trọng hơn độ dài danh sách. Bề mặt AI của chính Google hoàn toàn không có trong bảng này và cần một thước đo khác, như công cụ theo dõi AI Overview của chúng tôi trình bày.
Giới hạn
- Một ngày, một địa điểm, tiếng Anh, ba bề mặt, mỗi bề mặt một phiên bản mô hình.
- Việc đếm tên miền loại bỏ trùng lặp trong một câu trả lời, nên một trang được trích năm lần chỉ tính một lần.
- Các hạng prompt do chúng tôi tự gán, không theo hệ phân loại bên ngoài nào.
- Các con số chi phí chỉ gồm phần tạo câu trả lời.
- Đóng góp của ChatGPT bị kéo xuống bởi 12 prompt mà nó không tìm kiếm, và đó là thuộc tính của bề mặt đó, không phải của tập prompt.
Câu hỏi thường gặp
Tôi cần bao nhiêu prompt cho việc giám sát thương hiệu trên AI?
Dữ liệu của chúng tôi không có điểm kết thúc. Hai mươi prompt tìm được 432 nguồn và prompt thứ hai mươi vẫn thêm 14 nguồn mới. Hãy chọn cỡ bảng mà bạn rà soát được hằng tháng, rồi dồn công sức vào chất lượng prompt và việc luân phiên, chứ không phải vào độ dài danh sách.
Tôi nên giám sát một bề mặt AI hay nhiều bề mặt?
Nhiều, và báo cáo riêng từng bề mặt. Hai bề mặt nặng nhất chỉ chia sẻ trung bình 2,5 nguồn mỗi prompt, và sự đồng thuận ba chiều hoàn toàn chưa bao giờ xảy ra. Một chương trình một bề mặt đo chính bề mặt đó, không đo hạng mục của bạn.
Một tên miền chỉ xuất hiện một lần có đáng theo dõi không?
Chỉ như một quan sát. 324 trong 432 tên miền xuất hiện một lần, nên một lần xuất hiện gần với nhiễu hơn là tín hiệu. Hãy nâng một tên miền lên lớp lặp lại sau khi nó xuất hiện ở câu trả lời thứ hai, tốt nhất là trên bề mặt thứ hai.
Bảng nên chạy bao lâu một lần?
Hằng tháng cho bảng đầy đủ, hằng tuần cho lõi lặp lại. Danh sách lặp lại đủ ngắn để một lượt hằng tuần trên một bề mặt rẻ chỉ tốn dưới năm mươi xu một tháng, và lượt hằng tháng mới là nơi nguồn mới đi vào.
Góc nhìn của Auspia: hãy ngừng định cỡ danh sách prompt theo cảm giác kỹ lưỡng và bắt đầu đo xem khi nào nó thôi tìm ra thứ gì. Trong dữ liệu của chúng tôi, điểm đó chưa bao giờ đến, nghĩa là đơn vị lập kế hoạch đúng là hạng prompt và việc luân phiên, chứ không phải một danh sách dài hơn. Hãy phân lớp các nguồn lặp lại, lấy mẫu phần đuôi, và dán tên bề mặt vào mọi con số bạn báo cáo.
Tác giả: Elena Shaw