हर AI ब्रांड मॉनिटरिंग योजना एक प्रॉम्प्ट सूची से शुरू होती है, और लगभग हर सूची उसी से बनती है जिस पर टीम पहले से विश्वास करती है। बीस प्रॉम्प्ट गहन लगते हैं। पचास निपुण लगते हैं। कोई यह नहीं जाँचता कि सूची अब भी कुछ खोज रही है या नहीं।
सितंबर 2026 में हमने तीन AI प्लेटफ़ॉर्म पर बीस प्रॉम्प्ट चलाए और एक ही चीज़ पर नज़र रखी: स्रोत कहाँ से आ रहे थे। हमारे ब्रांड के ज़िक्र नहीं, बल्कि उन सभी डोमेन का पूरा समूह जिन्हें जवाबों ने खींचा। अगर प्रॉम्प्ट सूची पूरी होती, तो और प्रॉम्प्ट जोड़ने पर नए स्रोत मिलना बंद हो जाना चाहिए था। ऐसा नहीं हुआ।
हमने क्या मापा
मद | सेटिंग |
|---|---|
प्रॉम्प्ट | AI दृश्यता टूल के बारे में 20 खरीदार प्रश्न |
प्लेटफ़ॉर्म | ChatGPT (gpt-5), Gemini 2.5 Flash, Perplexity (sonar), वेब खोज चालू |
एकत्र जवाब | 60 |
मिले अलग स्रोत | 432 डोमेन |
एक पूरे दौर की लागत | 1,444 डॉलर |
दोहराया गया कवरेज | उसी दिन दो बार चलाए गए 5 प्रॉम्प्ट |
हमने 60 जवाबों में से हर एक को स्रोत ब्रह्मांड का एक प्रेक्षण माना और अलग डोमेन गिने, उद्धरण स्लॉट नहीं। Gemini ने अपने 20 जवाबों पर 989 स्रोत एनोटेशन लौटाए, लेकिन उनमें से बहुत से एक ही पेज की ओर इशारा करते थे, इसलिए यहाँ डोमेन गिनती ही ईमानदार इकाई है। एनोटेशन स्तर का डेटा AI दृश्यता जाँचकर्ता के विश्लेषण में है।
नतीजा 1: सूची कभी बंद नहीं होती
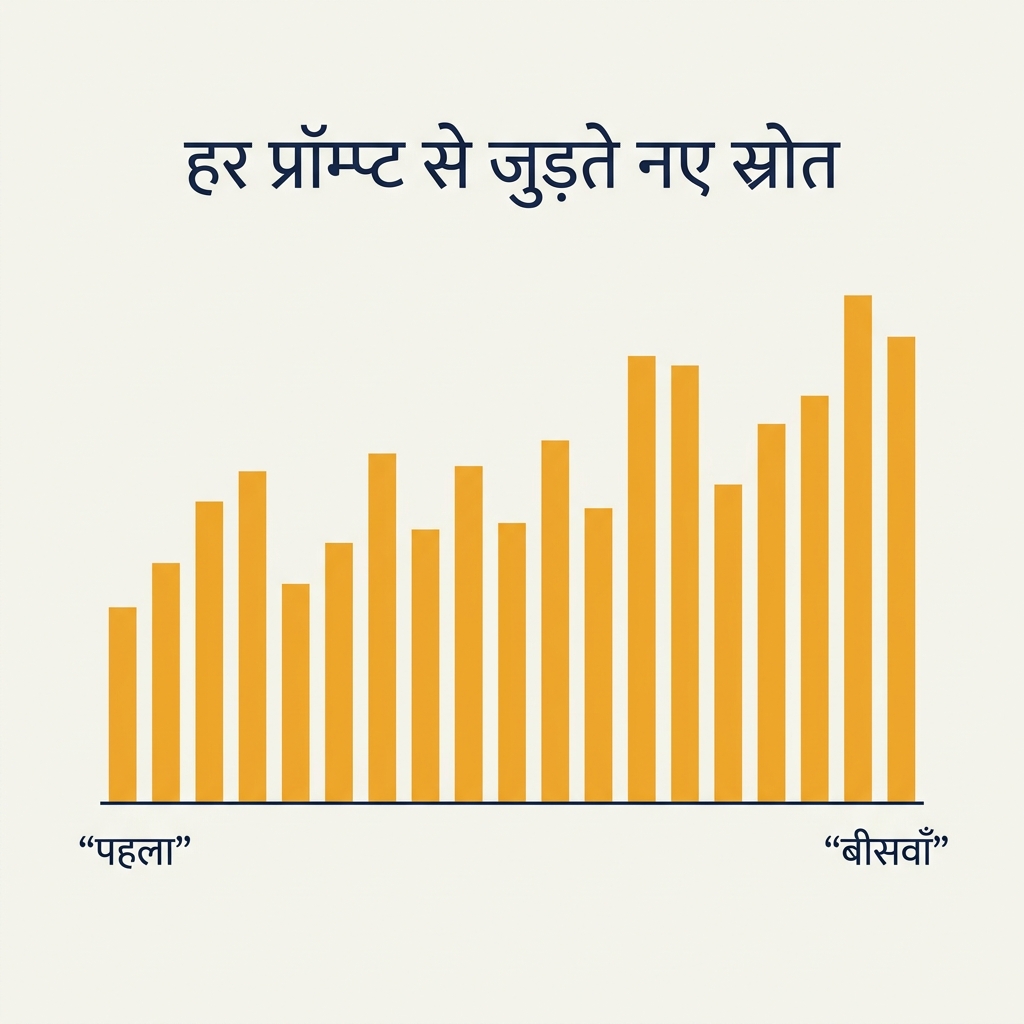
यही वह हिस्सा है जो तय करता है कि मॉनिटरिंग कार्यक्रम कैसे बनाया जाना चाहिए। हर प्रॉम्प्ट के बाद हम उसके नए डोमेन उन सबमें जोड़ते गए जो तब तक मिल चुके थे।
चलाए गए प्रॉम्प्ट | मिले अलग स्रोत | 20 प्रॉम्प्ट के कुल में हिस्सा |
|---|---|---|
1 | 34 | 8 प्रतिशत |
3 | 91 | 21 प्रतिशत |
5 | 134 | 31 प्रतिशत |
10 | 235 | 54 प्रतिशत |
15 | 336 | 78 प्रतिशत |
20 | 432 | 100 प्रतिशत |
आखिरी प्रॉम्प्ट ने 14 ऐसे डोमेन जोड़े जो किसी पिछले प्रॉम्प्ट ने सामने नहीं लाए थे। पूरे 20 प्रॉम्प्ट में सबसे छोटा सीमांत लाभ 14 था और सबसे बड़ा 34। उस दायरे में कोई ऐसा बिंदु नहीं है जहाँ एक और प्रॉम्प्ट अपनी लागत न निकाल पाए, यानी प्रॉम्प्ट सूची कोई ऐसा नमूना नहीं है जिसे पूरा किया जाए, बल्कि ऐसा नमूना है जिसे खींचते रहना पड़ता है।
व्यवहारिक रूप यह है: याद से लिखी पाँच प्रॉम्प्ट की सूची उसका लगभग एक तिहाई कवर करती है जो बीस प्रॉम्प्ट कवर करते हैं। श्रेणी बदलने को भाँपने वाले मॉनिटरिंग कार्यक्रम और हर महीने वही पाँच जवाब रिपोर्ट करने वाले कार्यक्रम के बीच का फ़ासला यहीं है।
नतीजा 2: हर प्लेटफ़ॉर्म उसी जगह का अलग एक तिहाई देखता है
432 डोमेन समान रूप से नहीं बँटे। हर प्लेटफ़ॉर्म उन्हीं सवालों के समूह के अलग हिस्से तक पहुँचा।
प्लेटफ़ॉर्म | अलग स्रोत | 432 में हिस्सा | प्रति जवाब स्रोतों की माध्यिका |
|---|---|---|---|
ChatGPT | 47 | 11 प्रतिशत | 0 |
Gemini 2.5 Flash | 184 | 43 प्रतिशत | 12 |
Perplexity | 285 | 66 प्रतिशत | 19 |
Gemini और Perplexity ने मिलकर 432 में से 400 डोमेन खोजे, यानी ChatGPT ने 32 ऐसे डोमेन जोड़े जो किसी और प्लेटफ़ॉर्म ने सामने नहीं लाए। जिन 12 प्रॉम्प्ट पर ChatGPT ने खोज ही नहीं की, वहाँ उस प्लेटफ़ॉर्म का योगदान शून्य रहा, और इसीलिए उसकी माध्यिका शून्य है।
मॉनिटरिंग के लिए इसका नतीजा असहज है। अगर आपका ट्रैकर सिर्फ़ एक प्लेटफ़ॉर्म देखता है, तो आप तीन प्लेटफ़ॉर्म वाले कार्यक्रम का छोटा संस्करण नहीं चला रहे। आप स्रोतों की एक अलग आबादी रिपोर्ट कर रहे हैं, और "इस महीने हमें ज़्यादा उद्धृत किया जा रहा है क्या" का जवाब यह भी हो सकता है कि "हमने कुछ नहीं बदला, प्लेटफ़ॉर्म बदल गया"। यही असर हमने जवाब के स्तर पर AI दृश्यता ट्रैकर के रन-दर-रन अंतर में मापा।
नतीजा 3: एक ही प्रॉम्प्ट पर दो प्लेटफ़ॉर्म शायद ही सहमत होते हैं
हमने उसी प्रॉम्प्ट, उसी दिन और उसी भाषा के लिए Gemini और Perplexity द्वारा बनाई गई स्रोत सूचियों की तुलना की।
- दोनों सूचियों में औसतन 2.5 डोमेन साझा थे, जबकि हर सूची में करीब बीस थे।
- औसत जैकार्ड ओवरलैप 0.089 था।
- और जिन 8 प्रॉम्प्ट पर ChatGPT ने भी स्रोत लौटाए, उनमें से सिर्फ़ 3 पर तीनों प्लेटफ़ॉर्म ने कम से कम एक डोमेन साझा किया, जिसमें सबसे बड़ा त्रि-पक्षीय ओवरलैप 2 डोमेन था।
- किसी एक प्रॉम्प्ट पर तीनों प्लेटफ़ॉर्म का पूरा मेल कभी नहीं हुआ।
एक ही सवाल के दो जवाब, लगभग अलग-अलग पेज समूहों से बने। यह अकेले प्लेटफ़ॉर्म से रिपोर्टिंग के खिलाफ़ हमारा सबसे मज़बूत तर्क है, और यह अच्छी खबर भी है: एक नए पेज के उठाए जाने की संभावना उससे कहीं ज़्यादा है जितनी एक अकेली स्रोत सूची बताती है।
नतीजा 4: ज़्यादातर स्रोत एक ही बार आते हैं
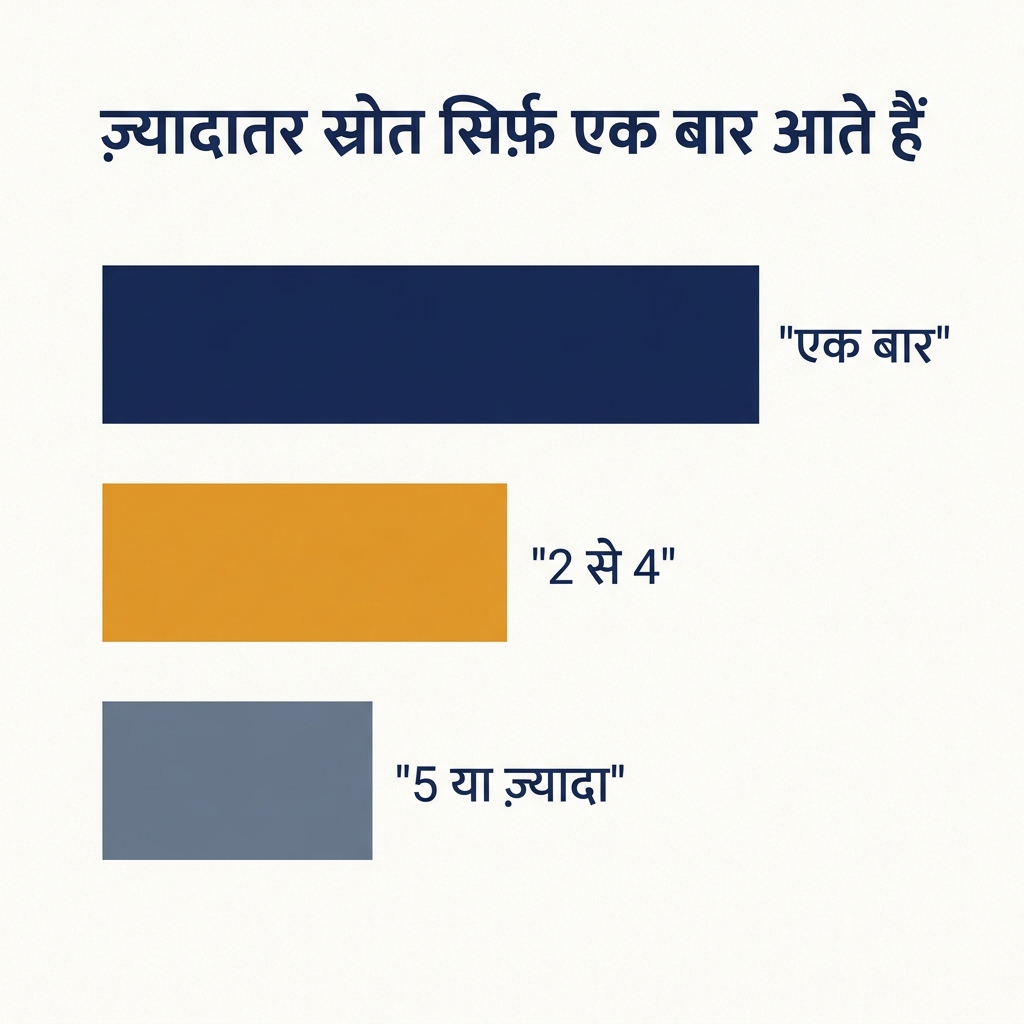
432 डोमेन बेहद असमान रूप से बँटे हैं।
- 432 में से 324 डोमेन, यानी 75 प्रतिशत, 60 जवाबों में से ठीक एक में आए।
- सिर्फ़ 17 डोमेन 5 या ज़्यादा जवाबों में आए।
- आवर्ती कोर छोटा और अनुमानित है: ahrefs.com 16 जवाबों में, semrush.com 15 में, reddit.com 14 में, फिर 9 पर frase.io, और 6 पर एक समूह जिसमें otterly.ai, tryprofound.com, llmpulse.ai, cognizo.ai और searchenginejournal.com शामिल हैं।
यह मॉनिटरिंग के काम को दो हिस्सों में बाँटता है, और दोनों हिस्सों को अलग लय चाहिए। आवर्ती कोर वह परत है जिसे बार-बार जाँचा जाता है, क्योंकि वहाँ का बदलाव साझा स्रोत में असली खिसकाव है। एक बार दिखने वाली पूँछ वह परत है जिसका नमूना लिया जाता है, क्योंकि ब्रह्मांड का 75 प्रतिशत दोहराव तक शोर ही है।
पूरी सूची की जगह क्या मॉनिटर करें
परत | इसमें क्या है | लय | मासिक डेटा लागत |
|---|---|---|---|
परत 1: आवर्ती कोर | आवर्ती 17 डोमेन, साथ में आपका डोमेन और तीन निकटतम प्रतिस्पर्धी | एक प्लेटफ़ॉर्म पर साप्ताहिक | Perplexity पर 0.48 डॉलर, Gemini पर 3.23 डॉलर |
परत 2: प्रॉम्प्ट पैनल | श्रेणी, तुलना, कीमत और समस्या-सूत्रीकरण को कवर करते 15 से 20 प्रॉम्प्ट | तीनों प्लेटफ़ॉर्म पर मासिक | प्रति दौर 1.44 डॉलर |
परत 3: प्रॉम्प्ट खोज | हर महीने 5 नए प्रॉम्प्ट, बिक्री कॉल और सपोर्ट टिकट से लिखे गए | त्रैमासिक समीक्षा, फिर पदोन्नति या बहिष्कार | मासिक दौर में शामिल |
इस दौर से तीन नियम निकले।
- सिर्फ़ प्रॉम्प्ट नहीं, प्रॉम्प्ट की श्रेणी दर्ज करें। हमारा सबसे चौड़ा जवाब उद्धृत होने के तरीके वाले प्रॉम्प्ट से आया, टूल तुलना से नहीं, और सबसे संकरा जवाब ठीक एक तुलना से आया। श्रेणियाँ अलग व्यवहार करती हैं, और रिपोर्ट श्रेणी की होती है।
- हर रिकॉर्ड में प्लेटफ़ॉर्म का नाम रखें। प्लेटफ़ॉर्म के नाम के बिना उद्धरण संख्या तुलनीय नहीं है, क्योंकि सूची की लंबाई तीन गुना तक बदलती है।
- खोज वाले प्रॉम्प्ट घुमाते रहें। बीस प्रॉम्प्ट ने 432 डोमेन खोजे, और वक्र कहता है कि अगले बीस कुछ सौ और खोजेंगे। पदोन्नति और सेवानिवृत्ति ही वह एकमात्र तंत्र है जो पैनल को ईमानदार रखता है।
लागत यहाँ बाधा नहीं है। तीन प्लेटफ़ॉर्म पर बीस प्रॉम्प्ट के एक पूरे दौर की लागत 1,444 डॉलर आई, यानी समीक्षा समय से पहले एक मासिक कार्यक्रम डेटा पर सालाना करीब 17 डॉलर पड़ता है। बाधा यह है कि समीक्षा समय महँगा आधा हिस्सा है, और इसीलिए परतों वाली संरचना सूची की लंबाई से ज़्यादा मायने रखती है। Google का अपना AI प्लेटफ़ॉर्म इस पैनल में बिल्कुल नहीं है और उसे दूसरा मापन साधन चाहिए, जैसा हमारा AI Overview ट्रैकर बताता है।
सीमाएँ
- एक दिन, एक जगह, अंग्रेज़ी, तीन प्लेटफ़ॉर्म, हर एक के लिए एक मॉडल संस्करण।
- डोमेन गिनती एक जवाब के भीतर दोहराव हटा देती है, इसलिए पाँच बार उद्धृत पेज एक बार गिना जाता है।
- प्रॉम्प्ट श्रेणियाँ हमने तय कीं, किसी बाहरी वर्गीकरण ने नहीं।
- लागत के आँकड़े सिर्फ़ जवाब बनाने को कवर करते हैं।
- ChatGPT का योगदान उन 12 प्रॉम्प्ट से दबा है जहाँ उसने खोज नहीं की, और यह उस प्लेटफ़ॉर्म का गुण है, प्रॉम्प्ट समूह का नहीं।
अक्सर पूछे जाने वाले प्रश्न
AI में ब्रांड मॉनिटरिंग के लिए मुझे कितने प्रॉम्प्ट चाहिए?
हमारे डेटा में कोई समापन बिंदु नहीं है। बीस प्रॉम्प्ट ने 432 स्रोत खोजे और बीसवें ने फिर भी 14 नए जोड़े। ऐसा पैनल आकार चुनें जिसे आप हर महीने समीक्षा कर सकें, फिर मेहनत सूची की लंबाई पर नहीं, प्रॉम्प्ट की गुणवत्ता और उसके घुमाव पर लगाएँ।
मुझे एक AI प्लेटफ़ॉर्म मॉनिटर करना चाहिए या कई?
कई, और उन्हें अलग-अलग रिपोर्ट करें। दो सबसे भारी प्लेटफ़ॉर्म प्रति प्रॉम्प्ट औसतन सिर्फ़ 2.5 स्रोत साझा करते थे, और पूरा त्रि-पक्षीय मेल कभी नहीं हुआ। एक-प्लेटफ़ॉर्म कार्यक्रम उस प्लेटफ़ॉर्म को मापता है, आपकी श्रेणी को नहीं।
क्या एक बार दिखने वाला डोमेन ट्रैक करने लायक है?
सिर्फ़ प्रेक्षण के रूप में। 432 में से 324 डोमेन एक बार आए, इसलिए एकबारगी मौजूदगी शोर के ज़्यादा करीब है, संकेत के नहीं। किसी डोमेन को आवर्ती परत में तभी पदोन्नत करें जब वह दूसरे जवाब में आ चुका हो, और बेहतर हो कि दूसरे प्लेटफ़ॉर्म पर।
पैनल कितनी बार चलना चाहिए?
पूरे पैनल के लिए मासिक, आवर्ती कोर के लिए साप्ताहिक। आवर्ती सूची इतनी छोटी है कि सस्ते प्लेटफ़ॉर्म पर साप्ताहिक दौर महीने के पचास सेंट से कम पड़ता है, और नए स्रोत मासिक दौर में ही भीतर आते हैं।
Auspia की राय: प्रॉम्प्ट सूचियों का आकार इस बात से तय करना बंद करें कि वे कितनी गहन लगती हैं, और यह मापना शुरू करें कि वे कब कुछ खोजना बंद करती हैं। हमारे डेटा में वह बिंदु कभी नहीं आया, यानी योजना की सही इकाई प्रॉम्प्ट श्रेणियाँ और घुमाव हैं, कोई लंबी सूची नहीं। आवर्ती स्रोतों को परतों में बाँटें, पूँछ का नमूना लें, और जो भी आँकड़ा रिपोर्ट करें उसके साथ प्लेटफ़ॉर्म का नाम जोड़े रखें।
लेखन: एलेना शॉ