Setiap rencana pemantauan merek di AI dimulai dari daftar prompt, dan hampir semua daftar itu disusun dari apa yang sudah diyakini tim. Dua puluh prompt terasa menyeluruh. Lima puluh terasa tuntas. Tidak ada yang memeriksa apakah daftar itu masih menemukan sesuatu.
Pada September 2026 kami menjalankan dua puluh prompt di tiga permukaan AI dan melacak satu hal: dari mana sumbernya berasal. Bukan penyebutan merek kami, melainkan seluruh himpunan domain yang ditarik jawaban. Kalau daftar prompt sudah lengkap, menambah prompt seharusnya berhenti menemukan sumber baru. Ternyata tidak.
Yang kami ukur
Butir | Pengaturan |
|---|---|
Prompt | 20 pertanyaan pembeli tentang alat visibilitas AI |
Permukaan | ChatGPT (gpt-5), Gemini 2.5 Flash, Perplexity (sonar), penelusuran web aktif |
Jawaban terkumpul | 60 |
Sumber berbeda yang ditemukan | 432 domain |
Biaya satu putaran penuh | 1.444 dolar |
Cakupan ulangan | 5 prompt dijalankan dua kali di hari yang sama |
Kami memperlakukan masing-masing dari 60 jawaban sebagai satu pengamatan atas alam semesta sumber dan menghitung domain berbeda, bukan slot kutipan. Gemini mengembalikan 989 anotasi sumber pada 20 jawabannya, tetapi banyak di antaranya menunjuk halaman yang sama, sehingga jumlah domain adalah satuan yang jujur di sini. Data pada tingkat anotasi ada di analisis pemeriksa visibilitas AI.
Hasil 1: daftarnya tidak pernah menutup
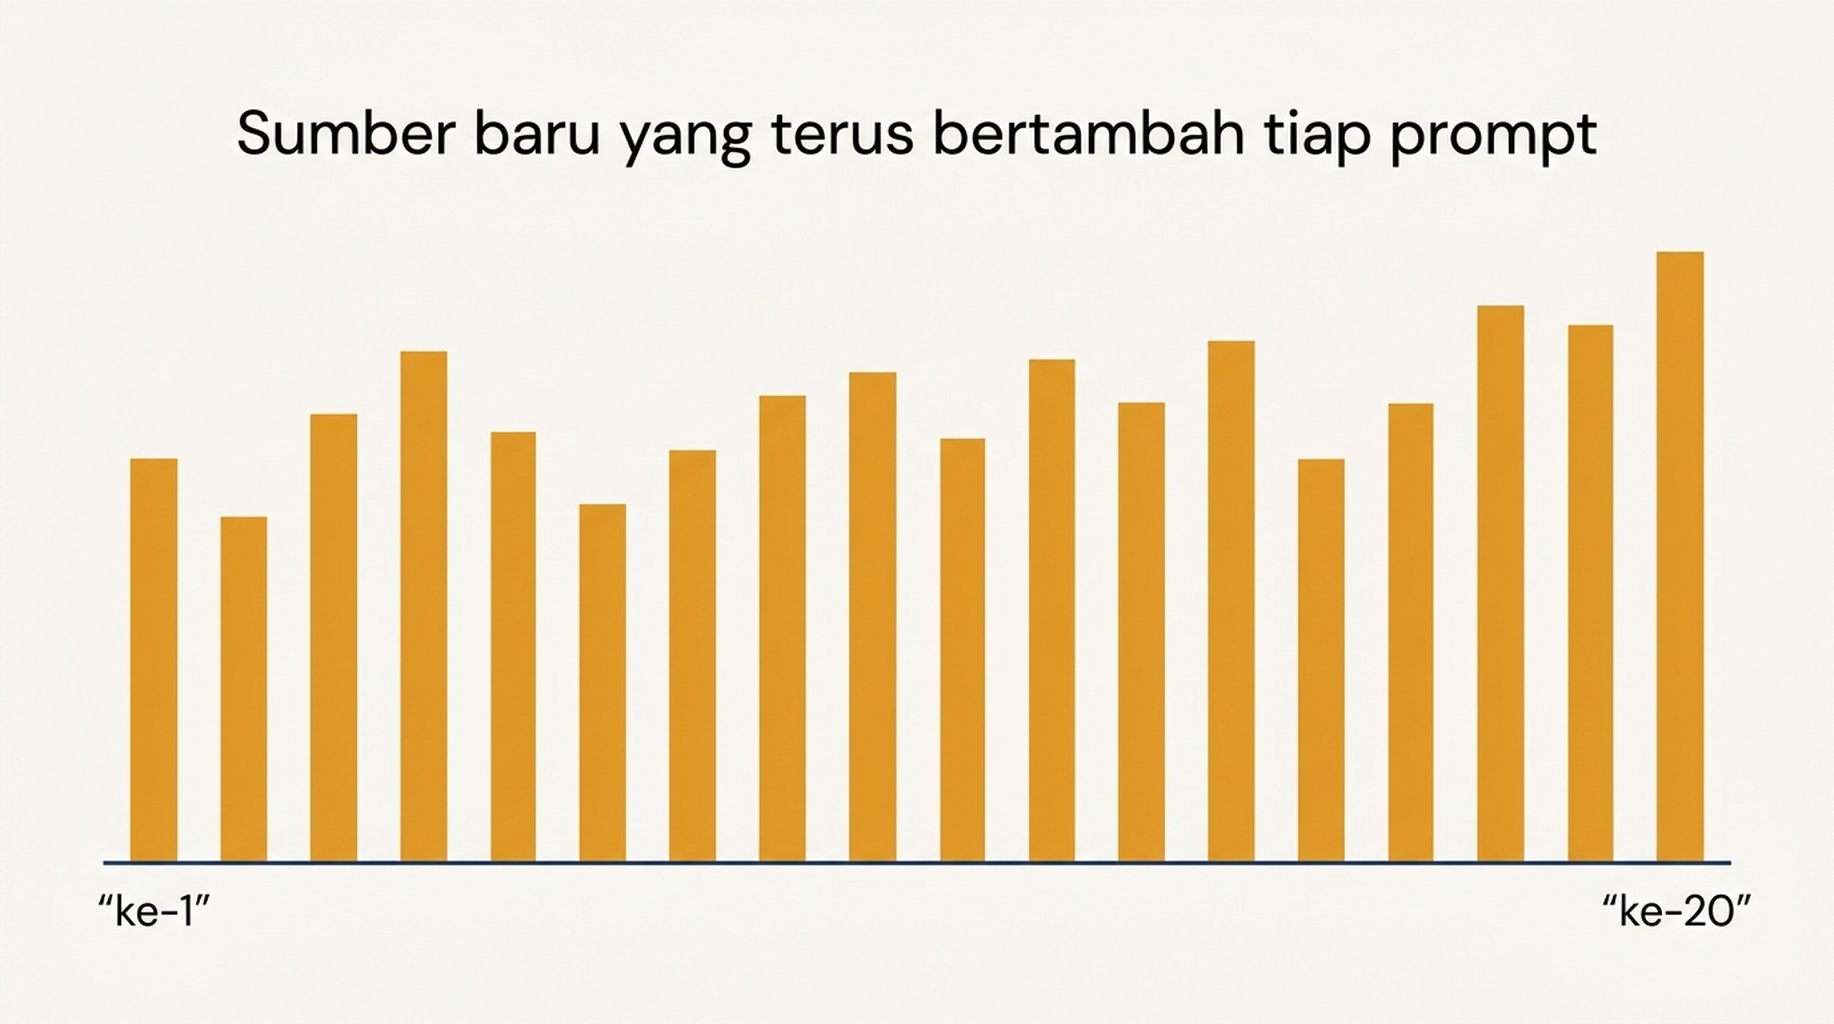
Bagian inilah yang menentukan bagaimana program pemantauan harus dibangun. Setelah setiap prompt, kami menambahkan domain barunya ke semua yang sudah ditemukan.
Prompt dijalankan | Sumber berbeda yang ditemukan | Porsi dari total 20 prompt |
|---|---|---|
1 | 34 | 8 persen |
3 | 91 | 21 persen |
5 | 134 | 31 persen |
10 | 235 | 54 persen |
15 | 336 | 78 persen |
20 | 432 | 100 persen |
Prompt terakhir menambahkan 14 domain yang tidak pernah dimunculkan prompt sebelumnya. Keuntungan marginal terkecil di sepanjang 20 prompt adalah 14, dan terbesar 34. Tidak ada titik dalam rentang itu di mana satu prompt tambahan berhenti mengembalikan modalnya, yang berarti daftar prompt bukan sampel yang Anda lengkapi, melainkan sampel yang terus Anda tarik.
Versi praktisnya: daftar lima prompt yang ditulis dari ingatan mencakup sekitar sepertiga dari apa yang dicakup dua puluh prompt. Di situlah jarak antara program pemantauan yang menyadari perubahan kategori dan program yang melaporkan lima jawaban yang sama setiap bulan.
Hasil 2: setiap permukaan melihat sepertiga berbeda dari ruang yang sama
432 domain tidak tersebar merata. Setiap permukaan menjangkau irisan berbeda dari himpunan pertanyaan yang sama.
Permukaan | Sumber berbeda | Porsi dari 432 | Median sumber per jawaban |
|---|---|---|---|
ChatGPT | 47 | 11 persen | 0 |
Gemini 2.5 Flash | 184 | 43 persen | 12 |
Perplexity | 285 | 66 persen | 19 |
Gemini dan Perplexity bersama-sama menemukan 400 dari 432 domain, jadi ChatGPT menambahkan 32 domain yang tidak dimunculkan permukaan lain. Pada 12 prompt tempat ChatGPT tidak mencari, permukaan itu tidak menyumbang apa pun, dan itulah sebabnya mediannya nol.
Konsekuensinya bagi pemantauan tidak nyaman. Kalau alat pelacak Anda mengamati satu permukaan saja, Anda tidak menjalankan versi kecil dari program tiga permukaan. Anda melaporkan populasi sumber yang berbeda, dan jawaban atas "apakah kami lebih banyak dikutip bulan ini" bisa sekadar "kami tidak mengubah apa pun, permukaannya yang berubah". Kami mengukur efek yang sama pada tingkat jawaban di keragaman jalannya pelacak visibilitas AI.
Hasil 3: dua permukaan jarang sepakat pada prompt yang sama
Kami membandingkan daftar sumber yang dihasilkan Gemini dan Perplexity untuk prompt yang sama, di hari yang sama, dalam bahasa yang sama.
- Kedua daftar berbagi rata-rata 2,5 domain dari sekitar dua puluh di masing-masing daftar.
- Rerata tumpang tindih Jaccard adalah 0,089.
- Dan hanya pada 3 dari 8 prompt tempat ChatGPT juga mengembalikan sumber, ketiga permukaan berbagi setidaknya satu domain, dengan tumpang tindih tiga arah terbesar dua domain.
- Kesepakatan penuh ketiga permukaan pada satu prompt tidak pernah terjadi.
Dua jawaban atas pertanyaan yang sama, disusun dari himpunan halaman yang nyaris terpisah. Itulah argumen terkuat yang kami temukan menentang pelaporan dari satu permukaan, dan sekaligus kabar baik: sebuah halaman baru punya jauh lebih banyak peluang untuk diambil dibandingkan yang disiratkan satu daftar sumber.
Hasil 4: sebagian besar sumber muncul sekali
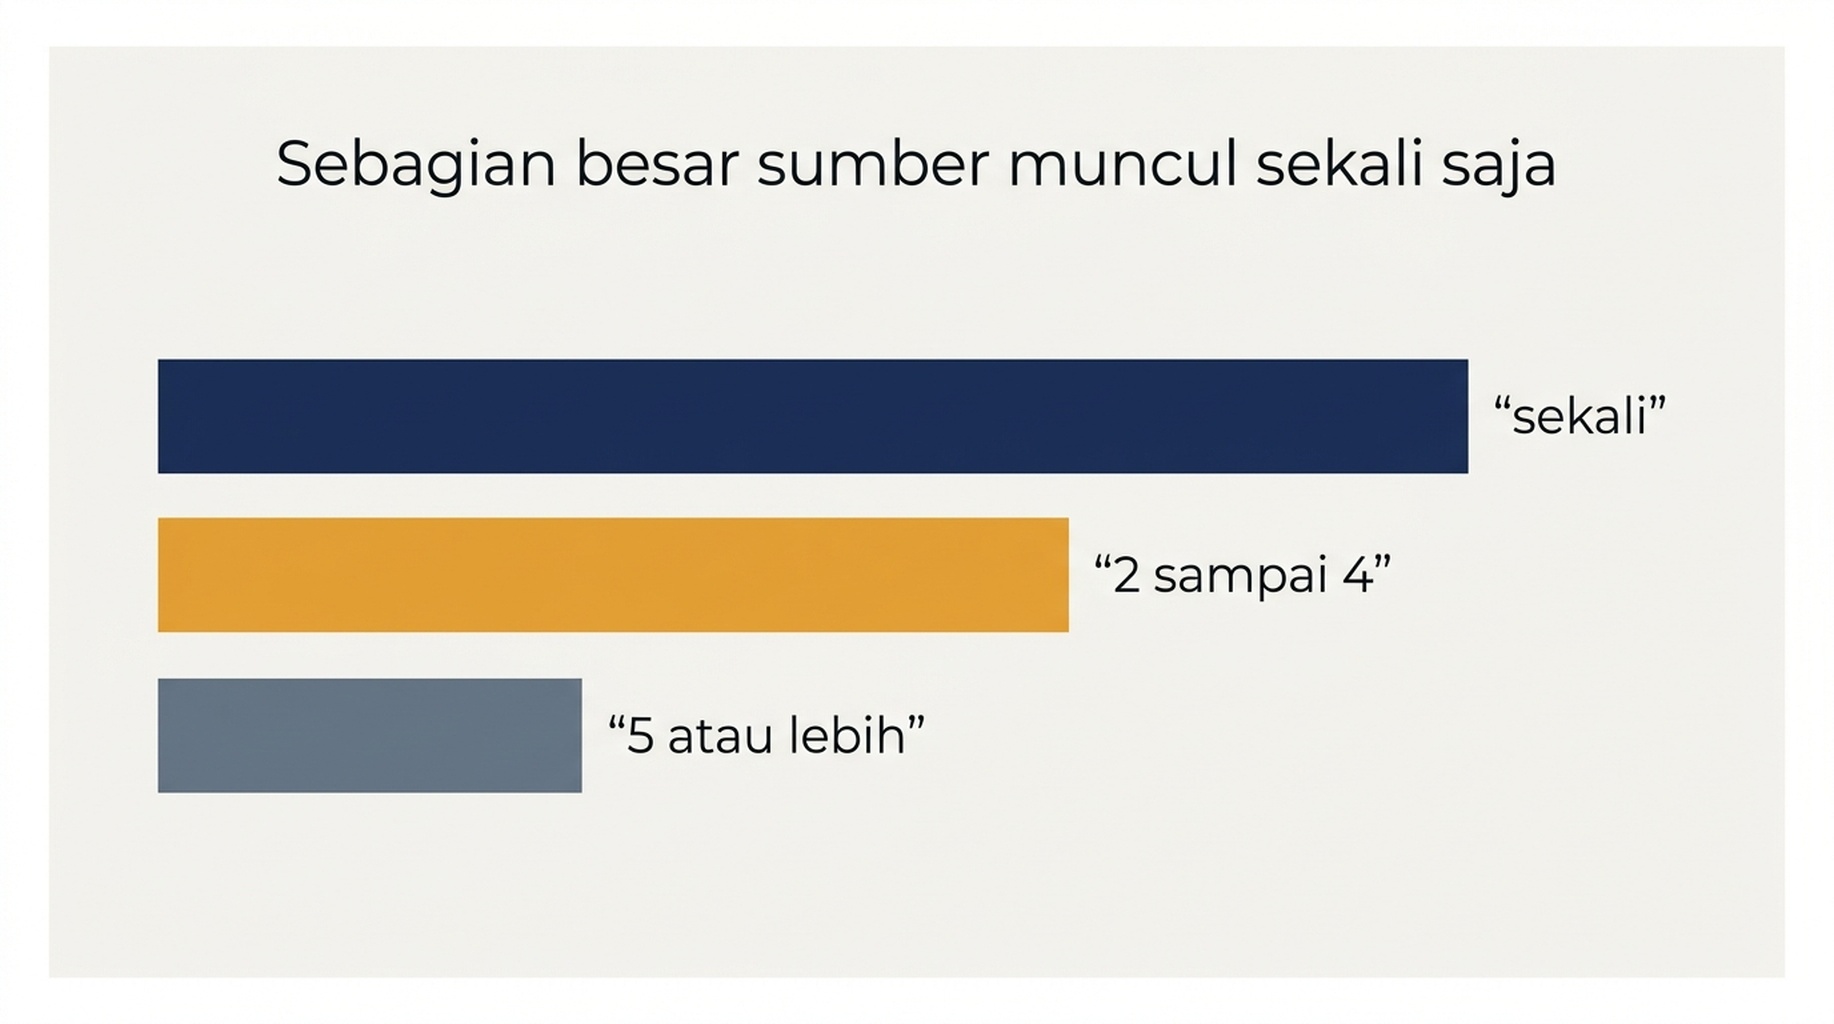
432 domain terdistribusi sangat tidak merata.
- 324 dari 432 domain, atau 75 persen, muncul tepat di satu dari 60 jawaban.
- Hanya 17 domain muncul di 5 jawaban atau lebih.
- Inti yang berulang kecil dan bisa diprediksi: ahrefs.com di 16 jawaban, semrush.com di 15, reddit.com di 14, lalu frase.io di 9, dan gugus di angka 6 yang mencakup otterly.ai, tryprofound.com, llmpulse.ai, cognizo.ai, dan searchenginejournal.com.
Ini membelah pekerjaan pemantauan menjadi dua, dan kedua belahannya menginginkan irama berbeda. Inti yang berulang adalah lapisan yang sering diperiksa ulang, karena perubahan di sana adalah pergeseran nyata pada sumber bersama. Ekor kemunculan sekali adalah lapisan yang disampel, karena 75 persen alam semesta adalah derau sampai ia berulang.
Apa yang dipantau sebagai ganti daftar lengkap
Lapisan | Isinya | Irama | Biaya data bulanan |
|---|---|---|---|
Lapisan 1: inti berulang | 17 domain yang berulang, ditambah domain Anda dan tiga pesaing terdekat | Mingguan di satu permukaan | 0,48 dolar di Perplexity, 3,23 dolar di Gemini |
Lapisan 2: panel prompt | 15 sampai 20 prompt yang mencakup kategori, perbandingan, harga, dan perumusan masalah | Bulanan di ketiga permukaan | 1,44 dolar per putaran |
Lapisan 3: penemuan prompt | 5 prompt baru per bulan, ditulis dari panggilan penjualan dan tiket dukungan | Tinjauan triwulanan, lalu promosi atau buang | Termasuk dalam putaran bulanan |
Tiga aturan muncul dari menjalankan ini.
- Catat kelas prompt, bukan hanya promptnya. Jawaban terluas kami datang dari prompt tentang bagaimana bisa dikutip sama sekali, bukan dari perbandingan alat, dan yang tersempit justru datang dari perbandingan. Tiap kelas berperilaku berbeda, dan kelas itulah yang dilaporkan.
- Simpan nama permukaan di setiap catatan. Jumlah kutipan tanpa nama permukaan tidak bisa dibandingkan, karena panjang daftarnya berbeda dengan faktor tiga.
- Putar prompt penemuan. Dua puluh prompt menemukan 432 domain, dan kurvanya mengatakan dua puluh yang lain akan menemukan beberapa ratus yang berbeda. Promosi dan pensiun adalah satu-satunya mekanisme yang menjaga panel tetap jujur.
Biaya bukan kendalanya di sini. Satu putaran penuh dua puluh prompt di tiga permukaan berbiaya 1.444 dolar, jadi program bulanan berkisar 17 dolar setahun untuk data, sebelum waktu tinjauan. Kendalanya adalah waktu tinjauan justru belahan yang mahal, dan itulah sebabnya struktur lapisan lebih penting daripada panjang daftar. Permukaan AI milik Google sama sekali tidak ada di panel ini dan butuh alat ukur lain, seperti yang dijelaskan pelacak AI Overview kami.
Batasan
- Satu hari, satu lokasi, bahasa Inggris, tiga permukaan, satu versi model untuk masing-masing.
- Penghitungan domain membuang duplikat di dalam satu jawaban, jadi halaman yang dikutip lima kali dihitung sekali.
- Kelas prompt kami tetapkan sendiri, bukan oleh taksonomi luar mana pun.
- Angka biaya hanya mencakup pembuatan jawaban.
- Kontribusi ChatGPT tertekan oleh 12 prompt tempat ia tidak mencari, dan itu sifat permukaan tersebut, bukan sifat himpunan prompt.
Pertanyaan umum
Berapa banyak prompt yang saya butuhkan untuk pemantauan merek di AI?
Tidak ada titik tuntas dalam data kami. Dua puluh prompt menemukan 432 sumber dan yang kedua puluh masih menambahkan 14 sumber baru. Pilih ukuran panel yang bisa Anda tinjau tiap bulan, lalu belanjakan tenaga pada kualitas prompt dan rotasinya, bukan pada panjang daftar.
Haruskah saya memantau satu permukaan AI atau beberapa?
Beberapa, dan laporkan secara terpisah. Dua permukaan terberat hanya berbagi rata-rata 2,5 sumber per prompt, dan kesepakatan tiga arah penuh tidak pernah terjadi. Program satu permukaan mengukur permukaan itu, bukan kategori Anda.
Apakah domain yang muncul sekali layak dilacak?
Hanya sebagai pengamatan. 324 dari 432 domain muncul sekali, jadi kemunculan tunggal lebih dekat ke derau daripada ke sinyal. Promosikan domain ke lapisan berulang setelah ia muncul di jawaban kedua, idealnya di permukaan kedua.
Seberapa sering panel harus dijalankan?
Bulanan untuk panel penuh, mingguan untuk inti berulang. Daftar berulang cukup pendek sehingga putaran mingguan di satu permukaan murah berbiaya di bawah lima puluh sen sebulan, dan putaran bulanan adalah tempat sumber baru masuk.
Pandangan Auspia: berhentilah menentukan ukuran daftar prompt dari seberapa menyeluruh rasanya, dan mulailah mengukur kapan daftar itu berhenti menemukan apa pun. Dalam data kami titik itu tidak pernah datang, yang berarti satuan perencanaan yang benar adalah kelas prompt dan rotasi, bukan satu daftar yang lebih panjang. Lapiskan sumber yang berulang, sampel ekornya, dan tempelkan nama permukaan pada setiap angka yang Anda laporkan.
Penulis: Elena Shaw