Todo plan de monitoreo de marca en IA empieza con una lista de prompts, y casi todas las listas se arman con lo que el equipo ya cree. Veinte prompts parecen rigurosos. Cincuenta parecen exhaustivos. Nadie comprueba si la lista sigue descubriendo algo.
En septiembre de 2026 lanzamos veinte prompts en tres superficies de IA y seguimos una sola cosa: de dónde venían las fuentes. No las menciones a nuestra marca, sino el conjunto completo de dominios que arrastraron las respuestas. Si la lista de prompts estuviera completa, añadir prompts debería dejar de encontrar fuentes nuevas. No lo hizo.
Qué medimos
Elemento | Configuración |
|---|---|
Prompts | 20 preguntas de comprador sobre herramientas de visibilidad en IA |
Superficies | ChatGPT (gpt-5), Gemini 2.5 Flash, Perplexity (sonar), con búsqueda web activada |
Respuestas recogidas | 60 |
Fuentes distintas encontradas | 432 dominios |
Coste de una pasada completa | 1.444 dólares |
Cobertura repetida | 5 prompts ejecutados dos veces el mismo día |
Tratamos cada una de las 60 respuestas como una observación del universo de fuentes y contamos dominios distintos, no huecos de cita. Gemini devolvió 989 anotaciones de fuente en sus 20 respuestas, pero muchas apuntaban a la misma página, así que el recuento de dominios es la unidad honesta aquí. Los datos a nivel de anotación están en el análisis del verificador de visibilidad en IA.
Resultado 1: la lista nunca se cierra
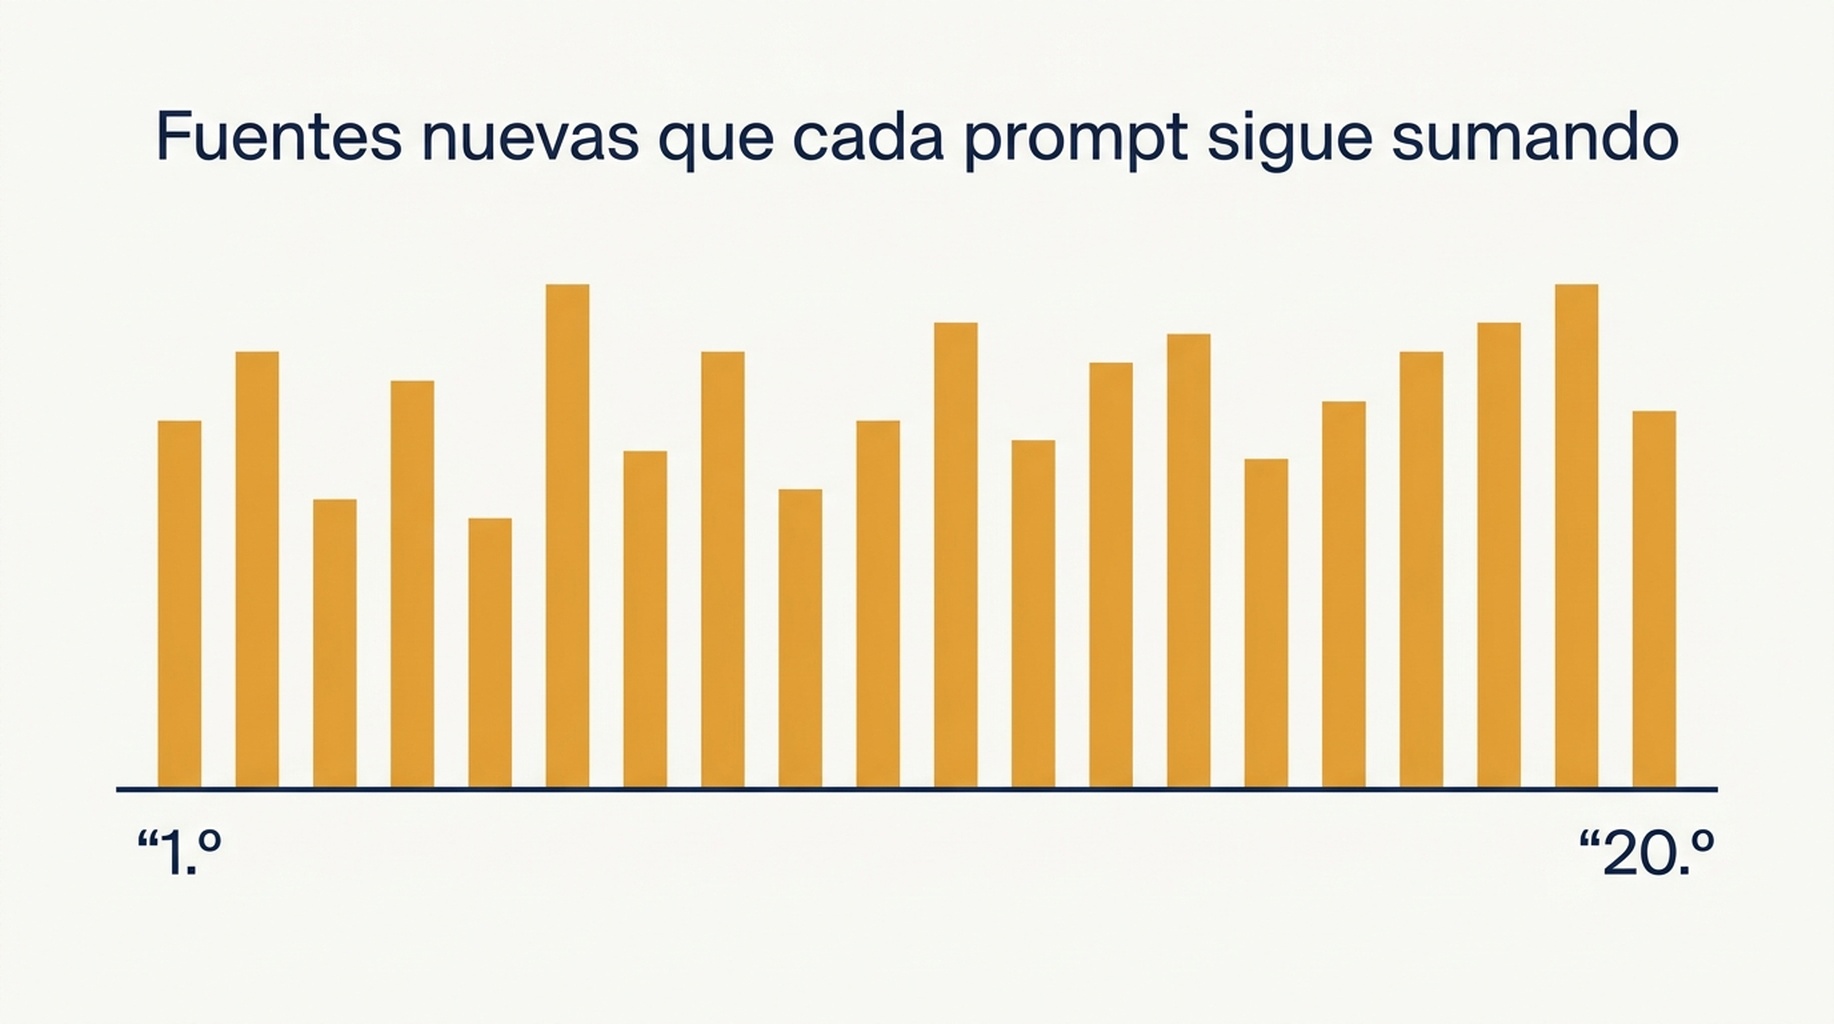
Esta es la parte que decide cómo debe construirse un programa de monitoreo. Después de cada prompt, sumábamos sus dominios nuevos a todo lo encontrado hasta entonces.
Prompts ejecutados | Fuentes distintas encontradas | Porción del total de los 20 prompts |
|---|---|---|
1 | 34 | 8 por ciento |
3 | 91 | 21 por ciento |
5 | 134 | 31 por ciento |
10 | 235 | 54 por ciento |
15 | 336 | 78 por ciento |
20 | 432 | 100 por ciento |
El último prompt añadió 14 dominios que ningún prompt anterior había sacado. La ganancia marginal más pequeña de los 20 prompts fue 14, y la mayor fue 34. No hay en ese rango ningún punto en el que un prompt más deje de pagarse solo, lo que significa que una lista de prompts no es una muestra que se completa, sino una muestra que se sigue extrayendo.
La versión práctica: una lista de cinco prompts escrita de memoria cubre aproximadamente un tercio de lo que cubren veinte. Esa es la diferencia entre un programa de monitoreo que nota el cambio de categoría y uno que informa de las mismas cinco respuestas cada mes.
Resultado 2: cada superficie ve un tercio distinto del mismo espacio
Los 432 dominios no se repartieron de forma uniforme. Cada superficie alcanzó una porción distinta del mismo conjunto de preguntas.
Superficie | Fuentes distintas | Porción de los 432 | Mediana de fuentes por respuesta |
|---|---|---|---|
ChatGPT | 47 | 11 por ciento | 0 |
Gemini 2.5 Flash | 184 | 43 por ciento | 12 |
Perplexity | 285 | 66 por ciento | 19 |
Gemini y Perplexity juntos encontraron 400 de los 432 dominios, así que ChatGPT añadió 32 dominios que ninguna otra superficie sacó. En los 12 prompts en los que ChatGPT no buscó, esa superficie no aportó nada, y por eso su mediana es cero.
La consecuencia para el monitoreo es incómoda. Si tu rastreador vigila una sola superficie, no estás ejecutando una versión reducida de un programa de tres superficies. Estás informando sobre otra población de fuentes, y la respuesta a "¿nos citan más este mes" puede ser simplemente "no cambiamos nada y la superficie cambió". Medimos el mismo efecto a nivel de respuesta en la varianza de ejecución del rastreador de visibilidad en IA.
Resultado 3: dos superficies rara vez coinciden en el mismo prompt
Comparamos las listas de fuentes que Gemini y Perplexity produjeron para el mismo prompt, el mismo día y en el mismo idioma.
- Las dos listas compartieron una media de 2,5 dominios de unos veinte cada una.
- La superposición media de Jaccard fue de 0,089.
- Y solo en 3 de los 8 prompts en los que ChatGPT también devolvió fuentes compartieron las tres superficies al menos un dominio, con la mayor superposición triple en 2 dominios.
- La coincidencia total de las tres superficies en un solo prompt nunca ocurrió.
Dos respuestas a la misma pregunta, construidas con conjuntos de páginas casi disjuntos. Es el argumento más fuerte que encontramos contra informar desde una sola superficie, y también es una buena noticia: una página nueva tiene muchas más posibilidades de ser recogida de lo que sugiere una única lista de fuentes.
Resultado 4: la mayoría de las fuentes aparece una vez
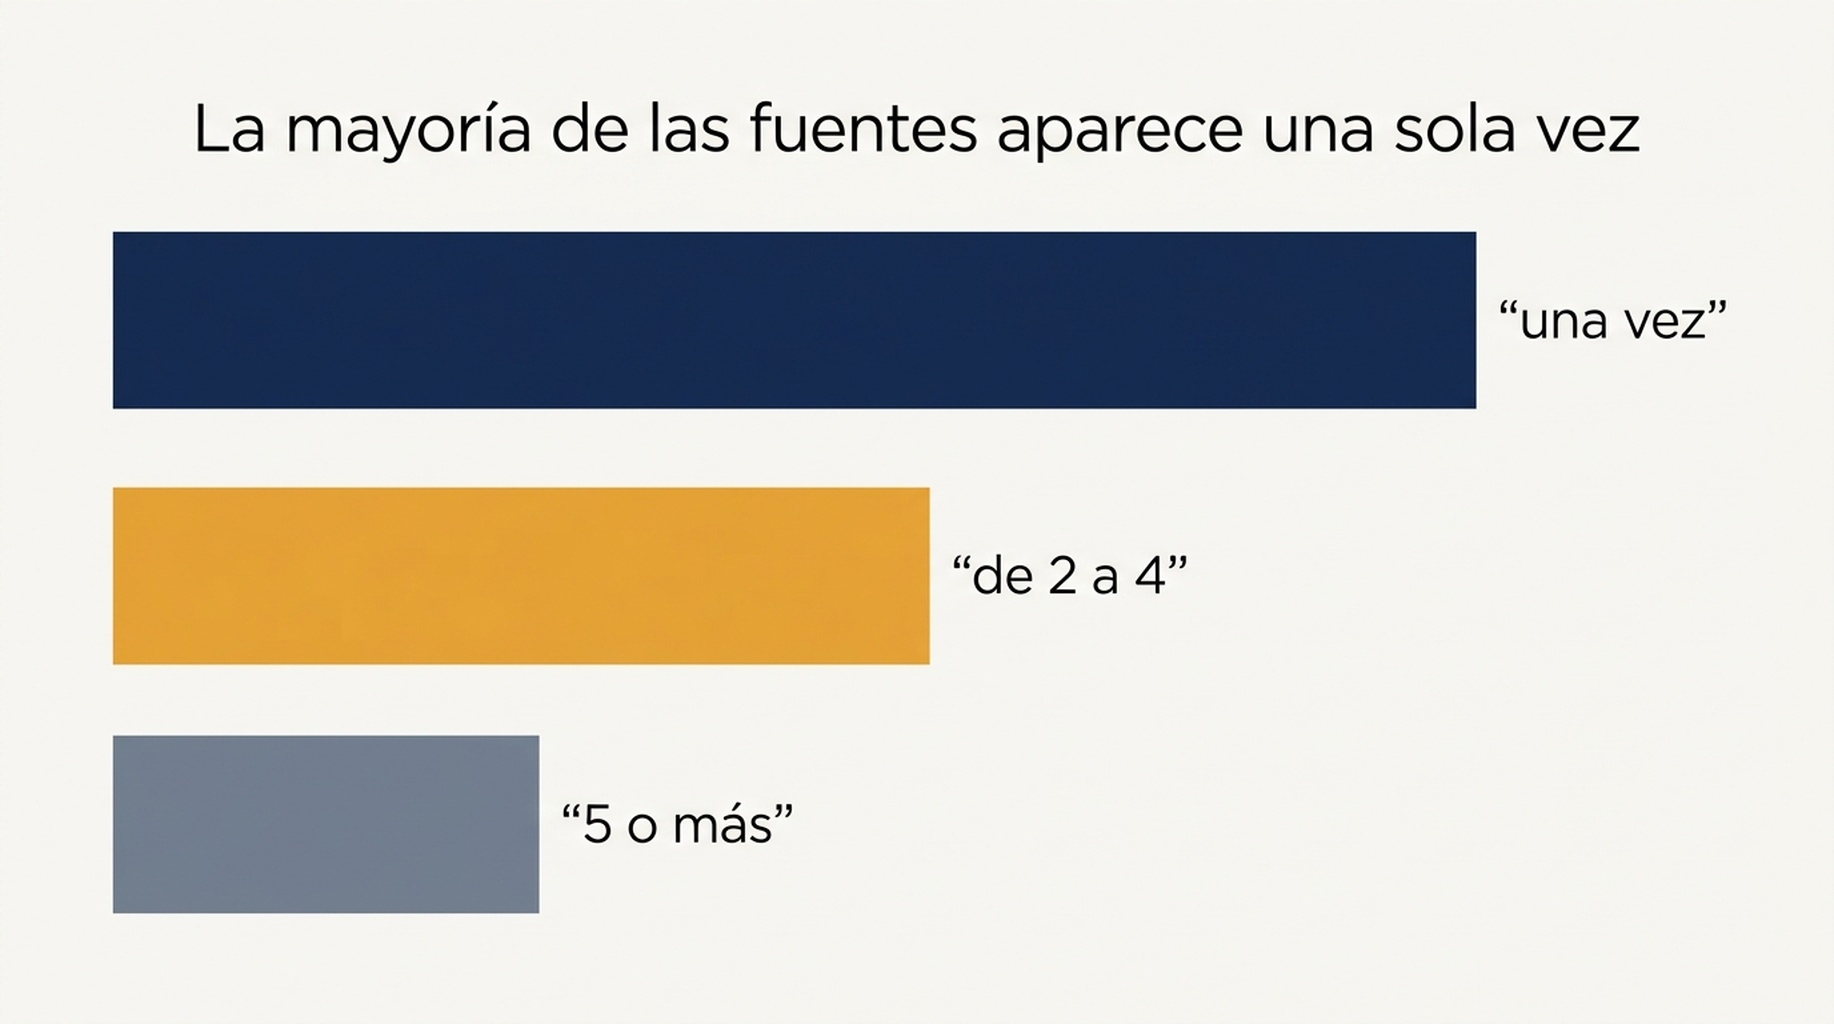
Los 432 dominios se distribuyen de forma extremadamente desigual.
- 324 de los 432 dominios, es decir el 75 por ciento, aparecieron en exactamente una de las 60 respuestas.
- Solo 17 dominios aparecieron en 5 respuestas o más.
- El núcleo recurrente es pequeño y predecible: ahrefs.com en 16 respuestas, semrush.com en 15, reddit.com en 14, luego frase.io con 9, y un grupo en 6 que incluye otterly.ai, tryprofound.com, llmpulse.ai, cognizo.ai y searchenginejournal.com.
Esto parte el trabajo de monitoreo en dos, y las dos mitades quieren cadencias distintas. El núcleo recurrente es la capa que se revisa a menudo, porque un cambio ahí es un cambio real en una fuente compartida. La cola de apariciones únicas es la capa que se muestrea, porque el 75 por ciento del universo es ruido hasta que se repite.
Qué monitorear en lugar de una lista completa
Capa | Qué entra en ella | Cadencia | Coste mensual de datos |
|---|---|---|---|
Capa 1: núcleo recurrente | Los 17 dominios que se repiten, más tu dominio y tus tres competidores más cercanos | Semanal en una superficie | 0,48 dólares en Perplexity, 3,23 dólares en Gemini |
Capa 2: panel de prompts | De 15 a 20 prompts que cubren categoría, comparación, precio y formulación del problema | Mensual en las tres superficies | 1,44 dólares por pasada |
Capa 3: descubrimiento de prompts | 5 prompts nuevos al mes, escritos a partir de llamadas de ventas y tickets de soporte | Revisión trimestral y luego ascenso o descarte | Incluido en la pasada mensual |
De esta ejecución salieron tres reglas.
- Registra la clase de prompt, no solo el prompt. Nuestra respuesta más amplia vino de un prompt sobre cómo conseguir que te citen, no de una comparación de herramientas, y la más estrecha vino precisamente de una comparación. Las clases se comportan distinto, y lo que se informa es la clase.
- Conserva la superficie en cada registro. Un recuento de citas sin el nombre de la superficie no es comparable, porque las longitudes de las listas varían en un factor de tres.
- Rota los prompts de descubrimiento. Veinte prompts encontraron 432 dominios, y la curva dice que otros veinte encontrarían otros cientos. El ascenso y la retirada son el único mecanismo que mantiene honesto al panel.
El coste no es la restricción aquí. Una pasada completa de veinte prompts en tres superficies costó 1.444 dólares, así que un programa mensual sale por unos 17 dólares al año en datos, antes del tiempo de revisión. La restricción es que el tiempo de revisión es la mitad cara, y por eso la estructura de capas importa más que la longitud de la lista. La propia superficie de IA de Google no está en este panel y necesita otro instrumento, como explica nuestro rastreador de AI Overview.
Límites
- Un día, una ubicación, inglés, tres superficies, una versión de modelo para cada una.
- El recuento de dominios elimina duplicados dentro de una respuesta, así que una página citada cinco veces cuenta una vez.
- Las clases de prompt las asignamos nosotros, no ninguna taxonomía externa.
- Las cifras de coste cubren solo la generación de respuestas.
- La contribución de ChatGPT está deprimida por los 12 prompts en los que no buscó, y eso es una propiedad de esa superficie, no del conjunto de prompts.
Preguntas frecuentes
¿Cuántos prompts necesito para el monitoreo de marca en IA?
No hay punto de finalización en nuestros datos. Veinte prompts encontraron 432 fuentes y el vigésimo todavía añadió 14 nuevas. Elige un tamaño de panel que puedas revisar cada mes y gasta el esfuerzo en la calidad y la rotación de los prompts, no en la longitud de la lista.
¿Debo monitorear una superficie de IA o varias?
Varias, e informar de ellas por separado. Las dos superficies más pesadas compartieron una media de 2,5 fuentes por prompt, y la coincidencia triple completa nunca ocurrió. Un programa de una sola superficie mide esa superficie, no tu categoría.
¿Merece la pena seguir un dominio que aparece una vez?
Solo como observación. 324 de 432 dominios aparecieron una vez, así que una aparición única está más cerca del ruido que de la señal. Asciende un dominio a la capa recurrente después de que aparezca en una segunda respuesta, mejor en una segunda superficie.
¿Con qué frecuencia debe ejecutarse el panel?
Mensual para el panel completo, semanal para el núcleo recurrente. La lista recurrente es lo bastante corta como para que una pasada semanal en una superficie barata cueste menos de cincuenta centavos al mes, y es en la pasada mensual donde entran las fuentes nuevas.
Visión de Auspia: dejad de dimensionar las listas de prompts por lo rigurosas que parezcan y empezad a medir cuándo dejan de encontrar algo. En nuestros datos ese punto nunca llegó, lo que significa que la unidad correcta de planificación son las clases de prompt y la rotación, no una lista más larga. Estratificad las fuentes recurrentes, muestread la cola y mantened el nombre de la superficie pegado a cada número que informéis.
Autoría: Elena Shaw