Un agent SEO est un système d'IA qui exécute seul un travail de recherche en plusieurs étapes : il récupère les données de position, vérifie les pages, compare ce qui a changé depuis la semaine dernière et vous livre un résultat fini. Ce n'est pas un outil qui améliore les positions de lui-même. La version utile d'un agent SEO fait la boucle ennuyeuse autour de Google Search Console, puis s'arrête et vous attend avant que quoi que ce soit ne soit publié.
Cette distinction compte davantage en 2026 qu'il y a un an, parce que les signaux de classement eux-mêmes ont bougé. L'enquête d'experts Zyppy publiée le 9 septembre 2026 a demandé à 131 praticiens de pondérer plus de 100 facteurs et a collecté 13 665 points de données. La pertinence du contenu (57,1 %), les backlinks (54,8 %) et la qualité du contenu (47,6 %) sont restés en tête. En dessous, les signaux de clic et de comportement (29,4 %) et les signaux de marque (27,0 %) se situent désormais au-dessus de la santé technique SEO (17,5 %) et des liens internes (11,1 %).
Relisez cette bande intermédiaire. Deux des trois signaux qui sont montés sont difficiles à voir dans un rapport de positions. C'est exactement là qu'un agent gagne sa place : non pas en courant après les positions, mais en rassemblant les preuves dont vous avez besoin pour prendre une bonne décision par semaine.
Ce qu'est un agent SEO, en termes simples
Un agent est un logiciel qui décide de l'étape suivante au lieu d'attendre votre prochaine instruction. Un prompt répond une fois. Un agent lit un fichier, appelle une API, remarque que les chiffres semblent faux, réessaie autrement et note ce qu'il a trouvé.
Pour le travail de position, cette boucle comporte généralement cinq parties :
- Récupérer — extraire les positions et les impressions d'un ensemble de mots-clés depuis Search Console, un outil de suivi de positions ou une API de données SEO.
- Comparer — mettre cette semaine face à la semaine dernière, ou face à la même semaine du trimestre précédent.
- Expliquer le mouvement — distinguer un vrai décalage de la saisonnalité, d'un changement de fonctionnalité dans la SERP ou d'un trou de mesure.
- Préparer un livrable — un rapport, une liste de corrections, un brief ou un brouillon.
- S'arrêter — rendre la décision à une personne.
C'est la cinquième étape qui sépare un agent SEO d'un script qui tourne sans surveillance pendant six mois et corrompt vos données en silence.
Le point de vue d'Auspia : la valeur d'un agent n'est pas de fonctionner sans vous. Elle est de raccourcir la distance entre « quelque chose cloche » et « voici les preuves et la correction proposée ». Tout le reste est du bruit.
Où les agents aident le travail de position, et où ils vous font perdre du temps
Toutes les tâches de position ne méritent pas l'automatisation. Voici la répartition que nous voyons le plus souvent après quelques mois d'usage d'agents.
Tâche de position | Adéquation de l'agent | Pourquoi |
|---|---|---|
Instantanés hebdomadaires de position et d'impressions | Forte | Les mêmes champs, la même comparaison, chaque semaine. Personne ne devrait faire ça à la main. |
Identifier quelles requêtes ont bougé et de combien | Forte | Trier et appliquer des seuils est un travail mécanique qu'un agent fait sans se fatiguer. |
Vérifier les positions au-delà de la 100e | Forte | La plupart des vérificateurs gratuits s'arrêtent à 100. Un agent peut parcourir des résultats plus profonds et les stocker. |
Comparaison par appareil (mobile contre ordinateur) | Bonne | Les données existent dans Search Console ; le travail consiste à les découper et à les étiqueter. |
Revue des backlinks depuis le rapport Liens de Search Console | Bonne | Lire 1 000 lignes et signaler celles qui ont changé est une tâche de lecture. |
Rédiger le rapport mensuel pour les parties prenantes | Bonne, avec relecture | L'explication a toujours besoin d'une personne qui sait ce que l'entreprise a fait ce mois-là. |
Décider quels sujets vous devriez occuper | Faible | C'est une décision d'entreprise, pas une tâche de données. |
Juger si une page est réellement bonne | Faible | Un agent peut noter la structure. Il n'a pas de goût. |
Déployer des changements sur tout le site sans surveillance | À éviter | Une mauvaise règle appliquée à un gabarit, c'est une panne, pas une expérience. |
Le schéma est simple. Les agents sont forts là où la tâche a toujours la même forme et où l'entrée est une donnée. Ils sont faibles là où la tâche exige un contexte absent du fichier.
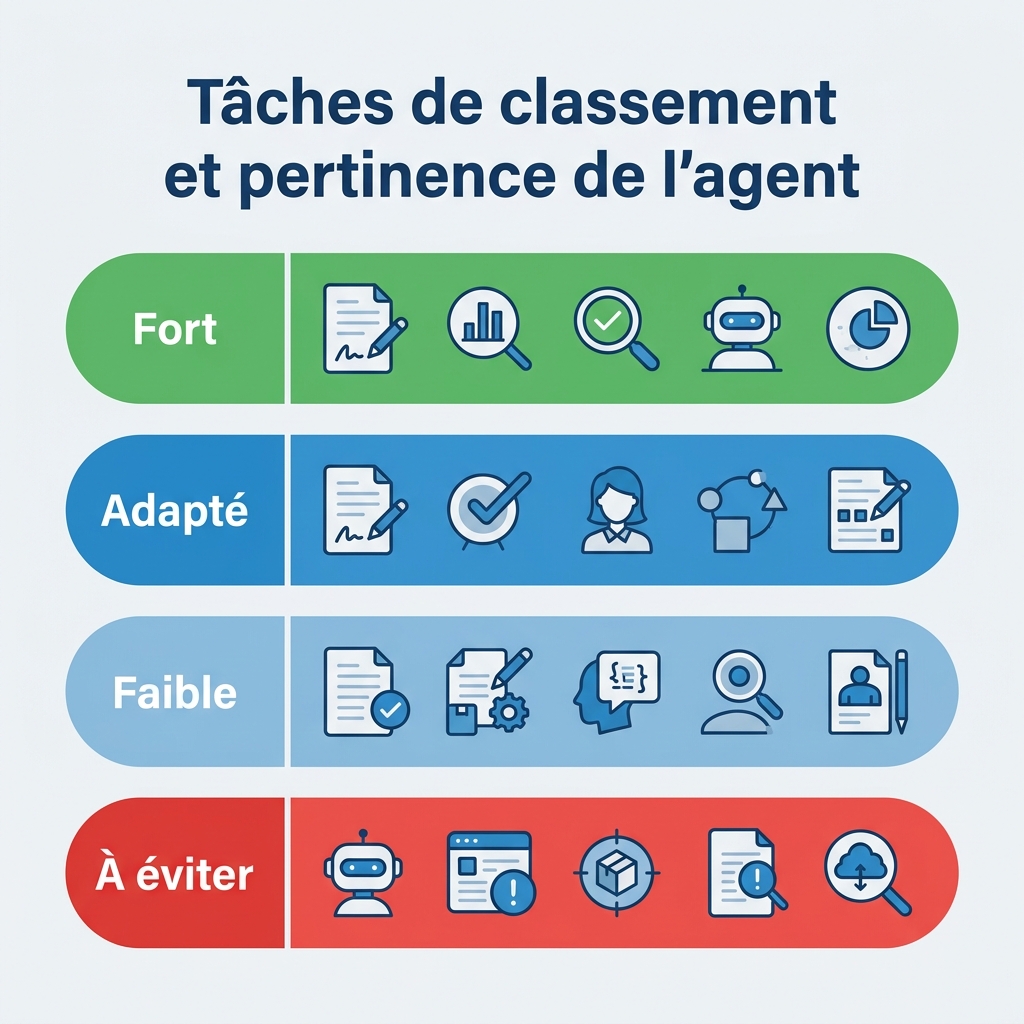
Neuf tâches de position courantes notées selon la façon dont un agent les gère. Les deux dernières lignes sont là où commencent la plupart des mauvais projets d'agents.
Six agents dont on nous parle, et ce en quoi chacun excelle
La plupart des équipes n'ont pas besoin de tester les six. Elles doivent en choisir un qui corresponde à la façon dont le travail se fait déjà. Voici la version honnête.
Agent | Le plus fort pour | Modèle d'accès | Première tâche de position raisonnable |
|---|---|---|---|
Codex | Le travail en dépôt et les exécutions planifiées sur une vraie base de code | Fichiers locaux, terminal, diffs git, automatisations planifiées | Stocker les instantanés hebdomadaires de position dans un dépôt et ouvrir une pull request avec le rapport |
Claude Code | La relecture à long contexte selon une politique écrite explicite | Terminal, fichier de mémoire de projet, connecteurs MCP vers les sources de données | Lire des exports Search Console plus le code source d'une page et produire un verdict documenté |
Hermes Agent | Les compétences réutilisables avec une mémoire entre les sessions | Agent open source avec système de compétences et mémoire persistante | Installer une compétence de position et lancer le même flux chaque lundi |
OpenClaw | La collecte de preuves dans le navigateur sous permissions strictes | Accès navigateur d'abord, fichiers locaux ensuite | Capturer ce qu'une requête renvoie réellement sur mobile, puis s'arrêter |
Google Antigravity | Les artefacts structurés que vous relisez avant l'implémentation | IDE agentique avec surfaces de planification et d'édition séparées | Produire une enquête sur une chute de position sous forme d'artefact relisible |
ChatGPT | L'analyse ponctuelle de fichiers exportés | Téléversements, projets, connecteurs | Coller un export Search Console et demander ce qui a changé et pourquoi |
Deux réserves valent d'être posées d'emblée. Les six peuvent faire les six tâches si vous poussez assez fort, donc le tableau décrit où chacun est le moins maladroit — et c'est précisément ce qui décide si vous continuerez à l'utiliser après la troisième semaine. Et cette catégorie change chaque mois, alors vérifiez les capacités et les tarifs actuels sur le site de l'éditeur lui-même avant d'engager une équipe dessus.
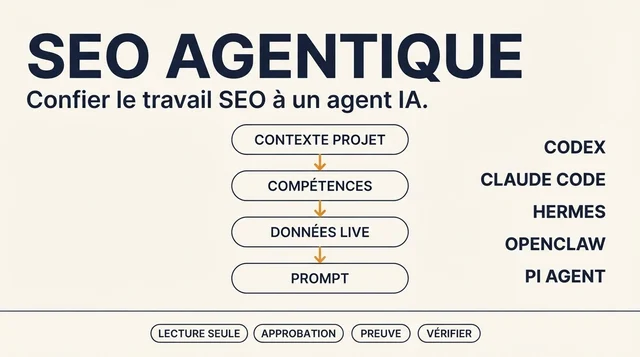
Si vous voulez la version accessible aux débutants de chaque configuration, nous tenons des guides complets pour Codex, Claude Code, Hermes Agent et OpenClaw. Les quatre suivent le même schéma : lecture seule d'abord, un changement approuvé, vérification avant mise en ligne.
Si votre site vit dans un dépôt git, commencez par un agent de code. Si votre travail est surtout fait d'exports et de conversations, commencez par un agent de conversation. Si vous voulez qu'un navigateur vérifie ce que voit une vraie personne, il vous en faut un avec accès au navigateur et une frontière de permissions.
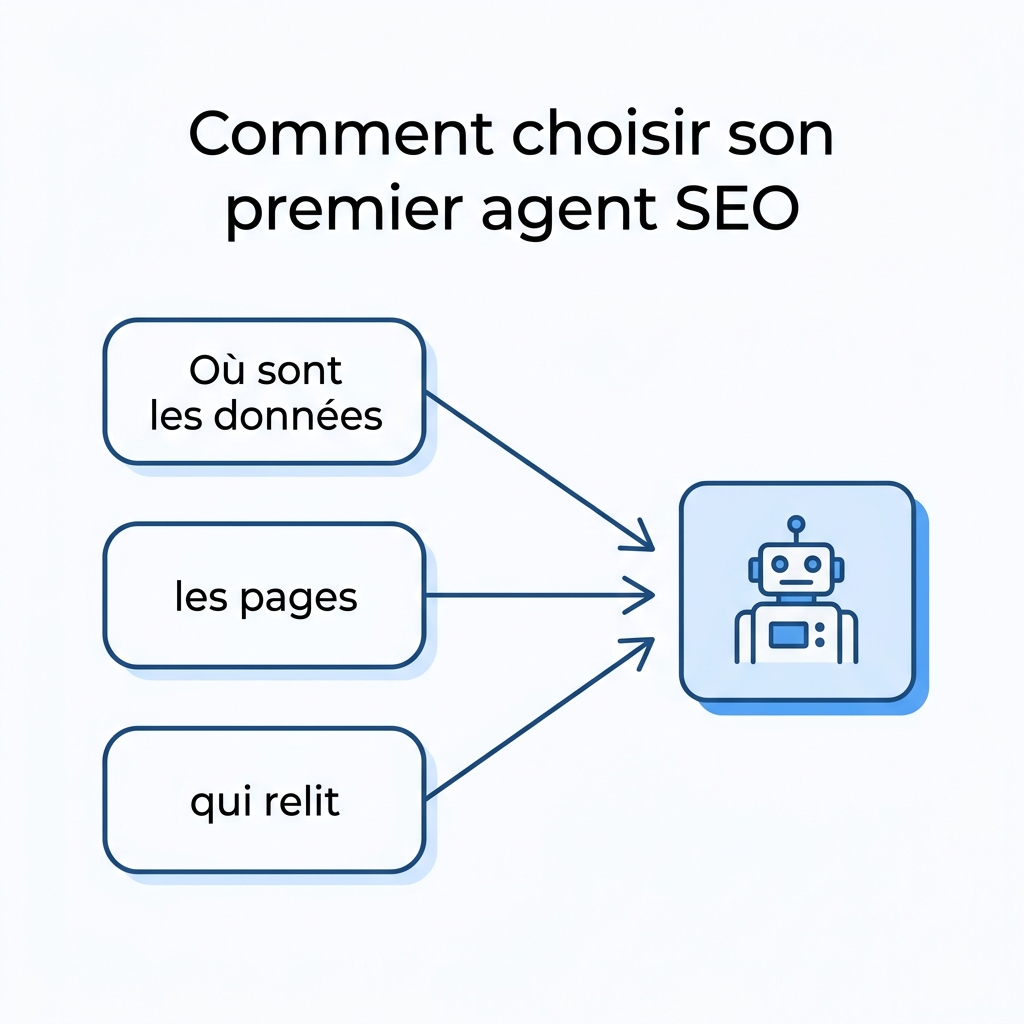
Trois questions réduisent six agents à un seul. Répondez-y avant d'évaluer les fonctionnalités.
Le travail de position qu'il faut automatiser en premier
Vous n'avez pas besoin d'une plateforme. Vous avez besoin d'un flux qui tourne selon un calendrier et produit quelque chose qu'une personne lit. Voici les cinq qui s'amortissent le plus vite, et chacun a un guide sur ce site.
- Un rapport de position hebdomadaire avec les colonnes qui comptent. Une liste de positions n'est pas un rapport. Un rapport répond à « qu'est-ce qui a changé, pourquoi cela a probablement changé, et que allons-nous faire ». Si vous assemblez encore le vôtre à la main, commencez par comment vérifier les positions Google.
- Un moniteur de positions avec des seuils. La surveillance échoue quand tout déclenche une alerte. Fixez les bandes une fois et laissez l'agent ne remonter que les mouvements qui les franchissent. Le rythme de relecture de comment les plateformes d'AI SEO suivent la performance des positions se transpose presque tel quel dans une configuration d'agent.
- Une vérification approfondie au-delà de la position 100. C'est là que vit la découverte de longue traîne, et c'est la tâche que la plupart des gens sautent parce que les outils s'arrêtent à 100.
- Une comparaison mobile contre ordinateur. L'indexation mobile-first n'est plus une nouveauté ; l'écart de position entre appareils surprend encore chaque mois. Nos notes sur l'indexation mobile-first en 2026 couvrent ce qui diffère toujours selon l'appareil.
- Une revue des backlinks à partir des données gratuites de Google. Le rapport Liens de Search Console est gratuit et sans éclat, et la plupart des équipes ne l'ont jamais lu correctement. Outils de suivi des backlinks 2026 couvre quand ce rapport gratuit suffit et quand il ne suffit pas.
Choisissez-en un. Faites-le tourner un mois. Puis ajoutez le deuxième. Les équipes qui démarrent avec cinq flux d'un coup finissent avec cinq tableaux de bord cassés et aucune décision.
Comment en choisir un sans trop y penser
Quatre questions tranchent plus vite qu'une matrice de fonctionnalités.
Où vivent vos données ? Si les positions viennent d'exports Search Console, un agent de conversation avec téléversement de fichiers suffit. Si elles viennent d'une API, vous voulez un agent capable d'exécuter du code selon un calendrier.
Où vivent vos pages ? Dans un dépôt, un agent de code peut préparer un changement relu. Dans un constructeur de pages, l'agent peut préparer un brief et s'arrêter là.
Qui relit le livrable ? Une personne qui relit un rapport hebdomadaire, ce n'est pas le même design qu'une équipe qui relit une pull request. Construisez l'étape de relecture avant de construire l'automatisation.
Que ferez-vous quand ce sera faux ? Tout agent finira par étiqueter un trou de données comme une chute de position. Si vous n'avez aucun moyen de l'attraper, vous avez ajouté une source d'erreur au lieu de retirer du travail.
Écrivez les réponses. L'agent que vous devez choisir devrait devenir évident ensuite, et si ce n'est pas le cas, vous optimisez pour une fonctionnalité que vous n'utiliserez pas.
Votre premier flux : le rapport de position hebdomadaire
C'est la plus petite version qui produit encore quelque chose d'utile. Prévoyez une demi-heure pour la mise en place.
Ce qu'il vous faut : une propriété Search Console, une liste enregistrée de 20 à 50 requêtes qui vous importent vraiment, et un endroit pour stocker des fichiers.
- Exportez les 90 derniers jours de données de requêtes depuis Search Console, découpées par appareil si vous avez le temps. Les données au niveau de la requête sont ce qui rend le rapport explicable.
- Définissez trois bandes pour ce qui compte comme un changement méritant d'être rapporté. Par exemple : toute requête qui bouge de plus de cinq positions, toute requête dont les impressions grimpent de plus de 30 % avec des clics stables, et toute requête tombée entièrement de la première page.
- Donnez à l'agent les définitions des bandes, pas seulement le fichier. Un seuil transforme un tableau en décision. Sans lui, vous obtenez un résumé qui dit « certaines choses ont monté, d'autres ont baissé ».
- Demandez une forme de sortie fixe. Trois sections fonctionnent bien : ce qui a bougé et franchi le seuil, ce qui l'explique probablement, et ce qu'il faut vérifier la semaine prochaine.
- Ajoutez une ligne que l'agent ne peut pas remplir. Une courte note de votre part sur « ce que nous avons livré la semaine dernière ». C'est le moyen le plus rapide d'attraper un agent qui impute à une mise à jour d'algorithme un changement fait par votre équipe.
- Lisez-le, corrigez une chose et enregistrez-le. Cette correction est le signal d'entraînement. Sans elle, vous répétez la même explication erronée chaque semaine.
Contrôle qualité avant de faire confiance au livrable : prenez deux requêtes du rapport et vérifiez les chiffres à la main dans l'interface Search Console. S'ils concordent, le pipeline est solide. Sinon, réparez l'étape de données avant de lire un mot de plus d'analyse.
Quand le rapport signale une page plutôt qu'une requête, passez cette URL dans le Vérificateur de score SEO de site web avant de demander une correction à l'agent. Cela coûte une minute et sépare « la page a un problème technique » de « la page va bien et c'est la requête qui a changé ».
Si ça échoue : l'échec le plus courant est un décalage de plage de dates. La plage par défaut de Search Console et celle de votre export sont rarement la même fenêtre, et un décalage de deux jours fera passer un mois stable pour un effondrement. Fixez les dates à chaque exécution.
Quatre garde-fous qui gardent un agent utile
Lecture seule d'abord. Laissez l'agent interroger les données et écrire des fichiers avant de pouvoir modifier des pages. La plupart des équipes devraient rester dans ce mode pendant un mois.
Une porte d'approbation par livrable. L'agent prépare ; une personne approuve. La fatigue d'approbation est réelle, alors gardez le nombre de portes faible, pas à zéro.
Consignez la source de données et la date sur chaque affirmation. « Les positions ont chuté » est inutile. « Les positions ont chuté, d'après un export Search Console de 28 jours récupéré le 11 septembre » est vérifiable.
Étiquetez l'incertitude au lieu de la combler. Un agent qui devine pourquoi une position a chuté est pire qu'un agent qui dit « les données n'expliquent pas cela ». Demandez ce comportement explicitement, par écrit, dans le fichier d'instructions.
Personnellement, je préfère un agent qui produit un rapport ennuyeux auquel je fais confiance plutôt qu'un agent astucieux que je dois auditer ligne par ligne. Le second type est abandonné en trois semaines.
Questions fréquentes (FAQ)
Qu'est-ce qu'un agent SEO ? Un agent SEO est un logiciel d'IA qui exécute des tâches de recherche en plusieurs étapes sans instructions pas à pas. En pratique, il récupère des données de position et de trafic, compare des périodes, explique ce qui a changé, prépare un rapport ou un brouillon, et attend l'approbation humaine avant de publier quoi que ce soit.
Un agent SEO peut-il améliorer seul les positions Google ? Non. Il peut supprimer des heures de vérification manuelle et rendre les problèmes visibles plus tôt, mais les positions dépendent du contenu, des liens, des signaux de marque et du comportement des utilisateurs. Un agent qui prétend faire monter les positions tout seul décrit un script, pas un résultat.
Par quel agent commencer pour le travail de position ? Si votre site est dans un dépôt git, commencez par un agent de code comme Codex ou Claude Code, car il peut préparer un changement relu. Si votre travail est surtout fait d'exports et d'analyse, commencez par un agent de conversation. Si vous devez voir ce que renvoie un navigateur, prenez-en un avec accès au navigateur et une frontière de permissions stricte.
Faut-il savoir coder ? Non, si vous restez en mode lecture seule et travaillez à partir d'exports. Mais vous voudrez un minimum d'aisance avec les fichiers et les dossiers, car tout flux d'agent utile dépend d'un endroit stable pour lire et écrire.
Comment empêcher un agent d'empirer les choses ? Trois choses : gardez-le en lecture seule jusqu'à ce que vous fassiez confiance au livrable, exigez une porte d'approbation avant tout changement, et vérifiez deux points de données à la main chaque fois que vous modifiez le pipeline. Les agents échouent bruyamment à l'étape des données et silencieusement à l'étape de l'explication, alors vérifiez les deux.
Les agents remplacent-ils le besoin d'outils de données de position ? Non. Les agents ont besoin d'une source. Search Console couvre votre propre site gratuitement, et les outils de suivi payants ou les API de données étendent l'ensemble aux concurrents et aux positions que vous ne voyez pas dans votre propre propriété. L'agent est l'ouvrier, pas la donnée.
Auteur : Aaron Wolfe, Designer de systèmes de croissance organique avec 15 ans en SEO/GEO chez Auspia. Aaron écrit sur la façon dont les équipes structurent les agents d'IA, les données et les étapes de relecture en flux de recherche qui survivent à un cycle de planification trimestriel.