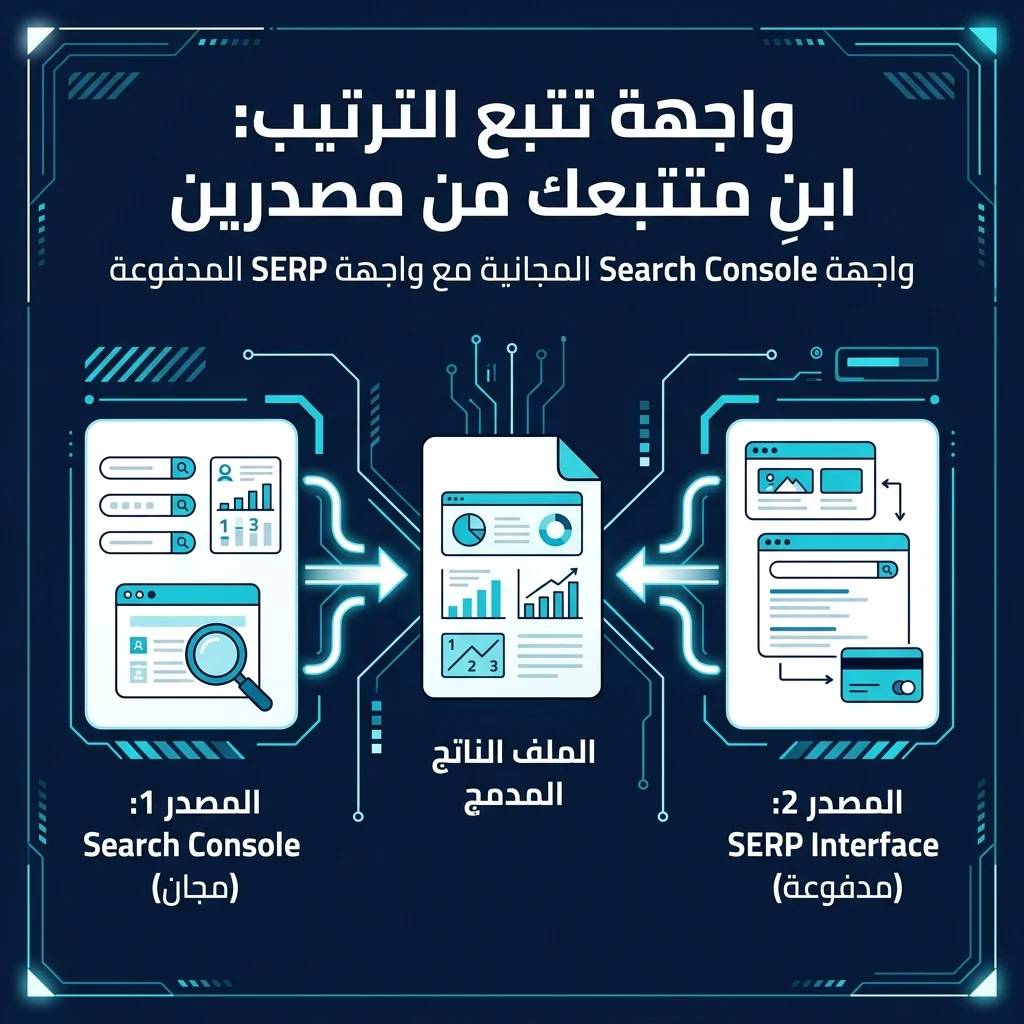
«واجهة تتبّع الترتيب» ليست شيئًا واحدًا. المطوّر الذي يبحث عن "rank tracking API" يريد عادةً نقطة نهاية واحدة تُعيد المواضع، والسوق يجيبه بقوائم مقالات يكتبها المورّدون. الجواب الصادق أنك تحتاج مصدرين، وأنهما يجيبان عن سؤالين مختلفين.
واجهة Search Console API مجانية ورسمية، ومحصورة بشكل دائم بالخصائص التي تستطيع التحقق منها. وواجهة SERP API مدفوعة وغير رسمية، وتستطيع فحص أي كلمة مفتاحية في أي مكان، بما في ذلك كلمات لم تظهر لها يومًا. لا واحدة منهما وحدها متتبّع ترتيب. ومعًا، هما نحو 120 سطرًا من بايثون وسطر cron واحد.
هذا هو البناء. يفترض أنك تستطيع تشغيل سكربت وتخزين ملف، ولا يفترض أنك تريد بناء منتج.
ما الذي ستحصل عليه في النهاية
لمن هذا: لمطوّر أو مسوّق تقني يملك أصلًا وصولًا إلى Search Console ويريد المواضع وفق جدول دون الدفع لكل مقعد.
ما سيكون بين يديك عند الانتهاء: دالتا سحب تعملان، وملف ناتج مدموج واحد في كل تشغيل، وقاعدة مقارنة تمنع الأرقام من الكذب عليك.
الوقت: نحو 90 دقيقة للبناء الأول، ثم نحو 10 دقائق مراجعة في كل تشغيل.
شكل الإنجاز: ملف JSON مؤرّخ يحتوي مواضعك حسب الاستعلام والجهاز، ولقطات SERP حيّة لقائمة كلمات مفتاحية مجمّدة، وفارق قصير مقابل التشغيل السابق.
قبل أن تبدأ: ما يستطيع كل مصدر فعله وما لا يستطيع
اضبط هذا التقسيم بشكل صحيح فيصبح باقي البناء ميكانيكيًا. اضبطه خطأً وستنفق شهرًا في بناء شيء إما عديم الفائدة وإما مكلف.
Search Console API | SERP API | |
|---|---|---|
مواضع مَن | خصائصك الموثّقة فقط | أي أحد، بما في ذلك المنافسون |
الكلمات المفتاحية | استعلامات تظهر لها بالفعل | أي كلمة مفتاحية تكتبها |
التكلفة | مجانية | تُحاسب لكل طلب |
تقسيم الأجهزة | نعم، كبُعد | نعم، لكل طلب |
الموقع | البلدان التي تظهر فيها | أي موقع يدعمه المورّد |
نوع البيانات | مجموع النقرات والظهور والموضع | صفحة نتائج في لحظة زمنية |
العمق التاريخي | النطاق الذي تطلبه | فقط من اليوم الذي تبدأ فيه التخزين |
الصفة الرسمية | بيانات Google نفسها | قراءة طرف ثالث لصفحة عامة |
سيتعارض المصدران، وهذا التعارض معلومة لا خلل. فـ Search Console يأخذ متوسط كل ظهور عبر النطاق الزمني وكل جهاز. وسحب SERP هو صفحة نتائج واحدة في لحظة واحدة. وإن قارنتهما مباشرة ستطارد هبوطًا وهميًا، ولهذا تعرّف الخطوة الخامسة قاعدة المقارنة.
ثلاثة أرقام يجدر معرفتها قبل كتابة الشيفرة. تقبل واجهة Search Console API حدًّا للصفوف بين 1 و25,000 لكل طلب، والقيمة الافتراضية 1,000، لذا يستطيع موقع متوسط الحجم سحب ثلاثة أشهر من بيانات الاستعلام والجهاز في استدعاء واحد. وتسمح بـ1,200 استعلام في الدقيقة لكل موقع ولكل مستخدم. وتفرض حصص تحميل تُقاس في مقاطع من 10 دقائق، حيث يكلّف النطاق الزمني الطويل أكثر من القصير، ولهذا تحديدًا تقول إرشادات Google نفسها إن عليك تجنّب إعادة الاستعلام عن البيانات ذاتها.
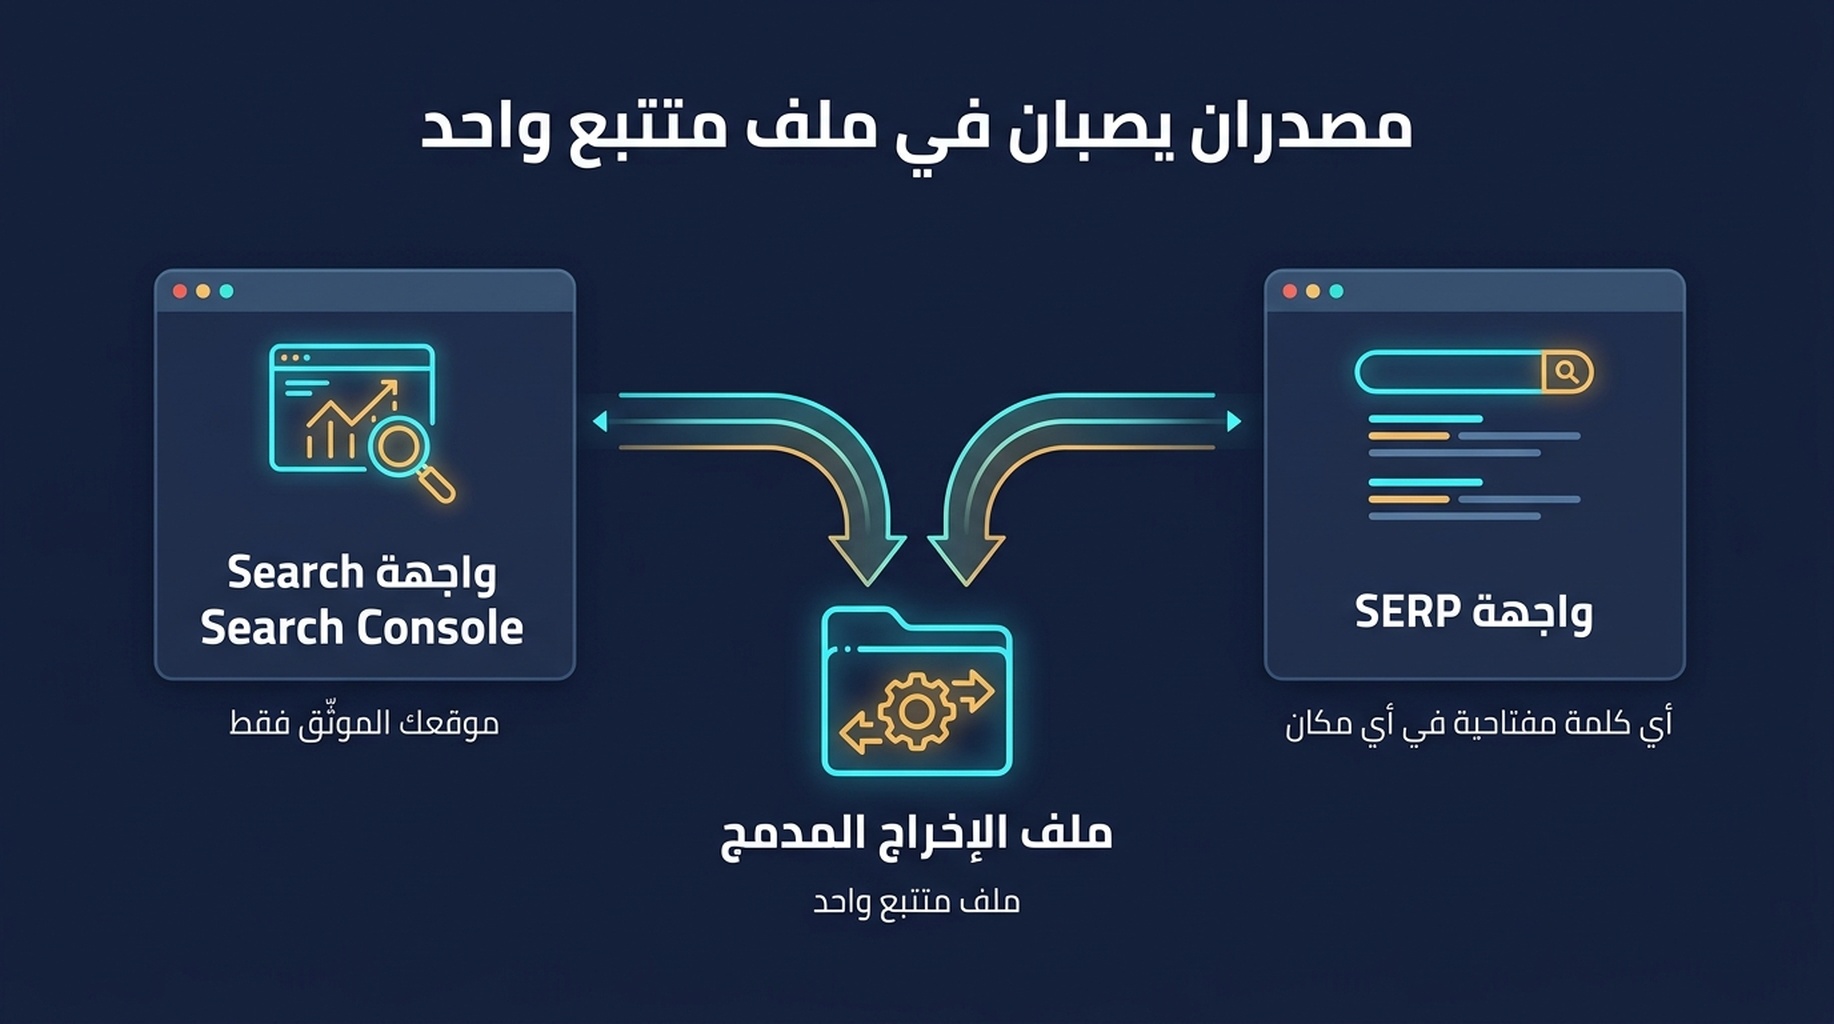
مصدران، ناتج واحد. Search Console يجيب عن «أين أظهر»، وSERP API يجيب عن «كيف تبدو الصفحة».
الخطوة 1: جمّد مجموعة الكلمات المفتاحية قبل كتابة أي شيفرة
المتتبّع الذي يسحب قائمة كلمات مختلفة في كل تشغيل لا يستطيع الإجابة عمّا إذا تغيّر شيء. اختر القائمة أولًا واحتفظ بها ربع سنة.
ثلاث مجموعات، ومصادرها مختلفة.
- من Search Console: كل استعلام حقّق 20 ظهورًا على الأقل في آخر 90 يومًا. هذه لا تختارها أنت، بل يختارها ظهورك. وهذه هي المجموعة التي يعني فيها التحرّك شيئًا، لأن ثمة طلبًا حقيقيًا مرتبطًا بها بالفعل.
- من العمل: العشرة إلى العشرين استعلامًا التي تقابل إيرادًا، سواء كنت تظهر لها أم لا.
- من المنافسين: الاستعلامات التي يظهر لها منافس ولا تظهر لها أنت. هذه تحتاج واجهة SERP API لأن Search Console لن يعرضها أبدًا.
اكتب القائمة في ملف، وأدر إصداراتها، وعامل الإضافات كتغيير متعمّد لا كانزياح تدريجي.
الخطوة 2: اسحب مواضعك مجانًا
هذا النصف رسمي ومجاني، ويمنحك تقسيم الأجهزة وبيانات النقر التي لا تملكها أي واجهة SERP API.
from google.oauth2 import service_account
from googleapiclient.discovery import build

service = build(
    "searchconsole", "v1",
    credentials=service_account.Credentials.from_service_account_file(
        "gsc-key.json",
        scopes=["https://www.googleapis.com/auth/webmasters.readonly"],
    ),
)

body = {
    "startDate": "2026-06-14",
    "endDate": "2026-09-11",
    "dimensions": ["query", "device"],
    "type": "web",
    "dataState": "final",
    "rowLimit": 25000,
}

rows = service.searchanalytics().query(
    siteUrl="sc-domain:example.com", body=body
).execute().get("rows", [])
تفصيلان في هذا الطلب يقومان بمعظم العمل.
dataState: "final" يستبعد البيانات الطازجة التي قد تعدّلها Google لاحقًا. ومن دونه تتحرّك أحدث يومين أو ثلاثة بين تشغيل وآخر، فيُظهر الفارق لديك تحرّكات لم تحدث قط.
dimensions: ["query", "device"] هو ما يجعل الناتج مفيدًا لاحقًا. إضافة الجهاز الآن لا تكلّف شيئًا. أما إعادة سحب ثلاثة أشهر من التاريخ لاحقًا فتكلف تشغيلًا كاملًا ولا تعطيك شيئًا عن الأيام التي تجاوزتها بالفعل.
الناتج المتوقّع: صف واحد لكل استعلام وجهاز، مع النقرات والظهور ونسبة النقر إلى الظهور ومتوسط الموضع.
فحص الجودة: يجب أن يكون عدد الصفوف أقل من 25,000. وإن جاء 25,000 بالضبط فأنت مبتور وتحتاج استدعاءً ثانيًا بـstartRow: 25000.
إذا فشل: الخطأ 403 يعني عادةً أن بريد حساب الخدمة لم يُضف قط كمستخدم على الخاصية. أضفه في Search Console، وانتظر بضع دقائق، ثم أعد المحاولة.
الخطوة 3: اسحب نتائج SERP التي لا تراها في بياناتك
النصف الثاني يغطّي كل ما لا تستطيع Search Console بنيويًا فعله. هذا استدعاء عامل بسيط.
import base64, json, urllib.request

LOGIN, PASSWORD = "your-login", "your-password"

def serp(keyword, depth=100):
    token = base64.b64encode(f"{LOGIN}:{PASSWORD}".encode()).decode()
    payload = json.dumps([{
        "keyword": keyword,
        "location_name": "United States",
        "language_name": "English",
        "depth": depth,
    }]).encode()
    request = urllib.request.Request(
        "https://api.dataforseo.com/v3/serp/google/organic/live/advanced",
        data=payload,
        headers={"Authorization": f"Basic {token}",
                 "Content-Type": "application/json"},
        method="POST",
    )
    return json.loads(urllib.request.urlopen(request, timeout=120).read())
اضبط `depth` على 100، لا 200. اختبرنا هذا في سبتمبر 2026 بطلب 200 نتيجة عبر ستة استعلامات. أعادت Google من 83 إلى 128 نتيجة عضوية ثم توقّفت، وكان أعمق موضع في الاختبار كله 142. الاختبار الكامل هنا. طلب 200 لا يجلب لك 200 نتيجة، وربما يظل المورّد يحاسبك على العمق الذي طلبته. اطلب 100 وستتلقّى دائمًا تقريبًا كل ما هو موجود.
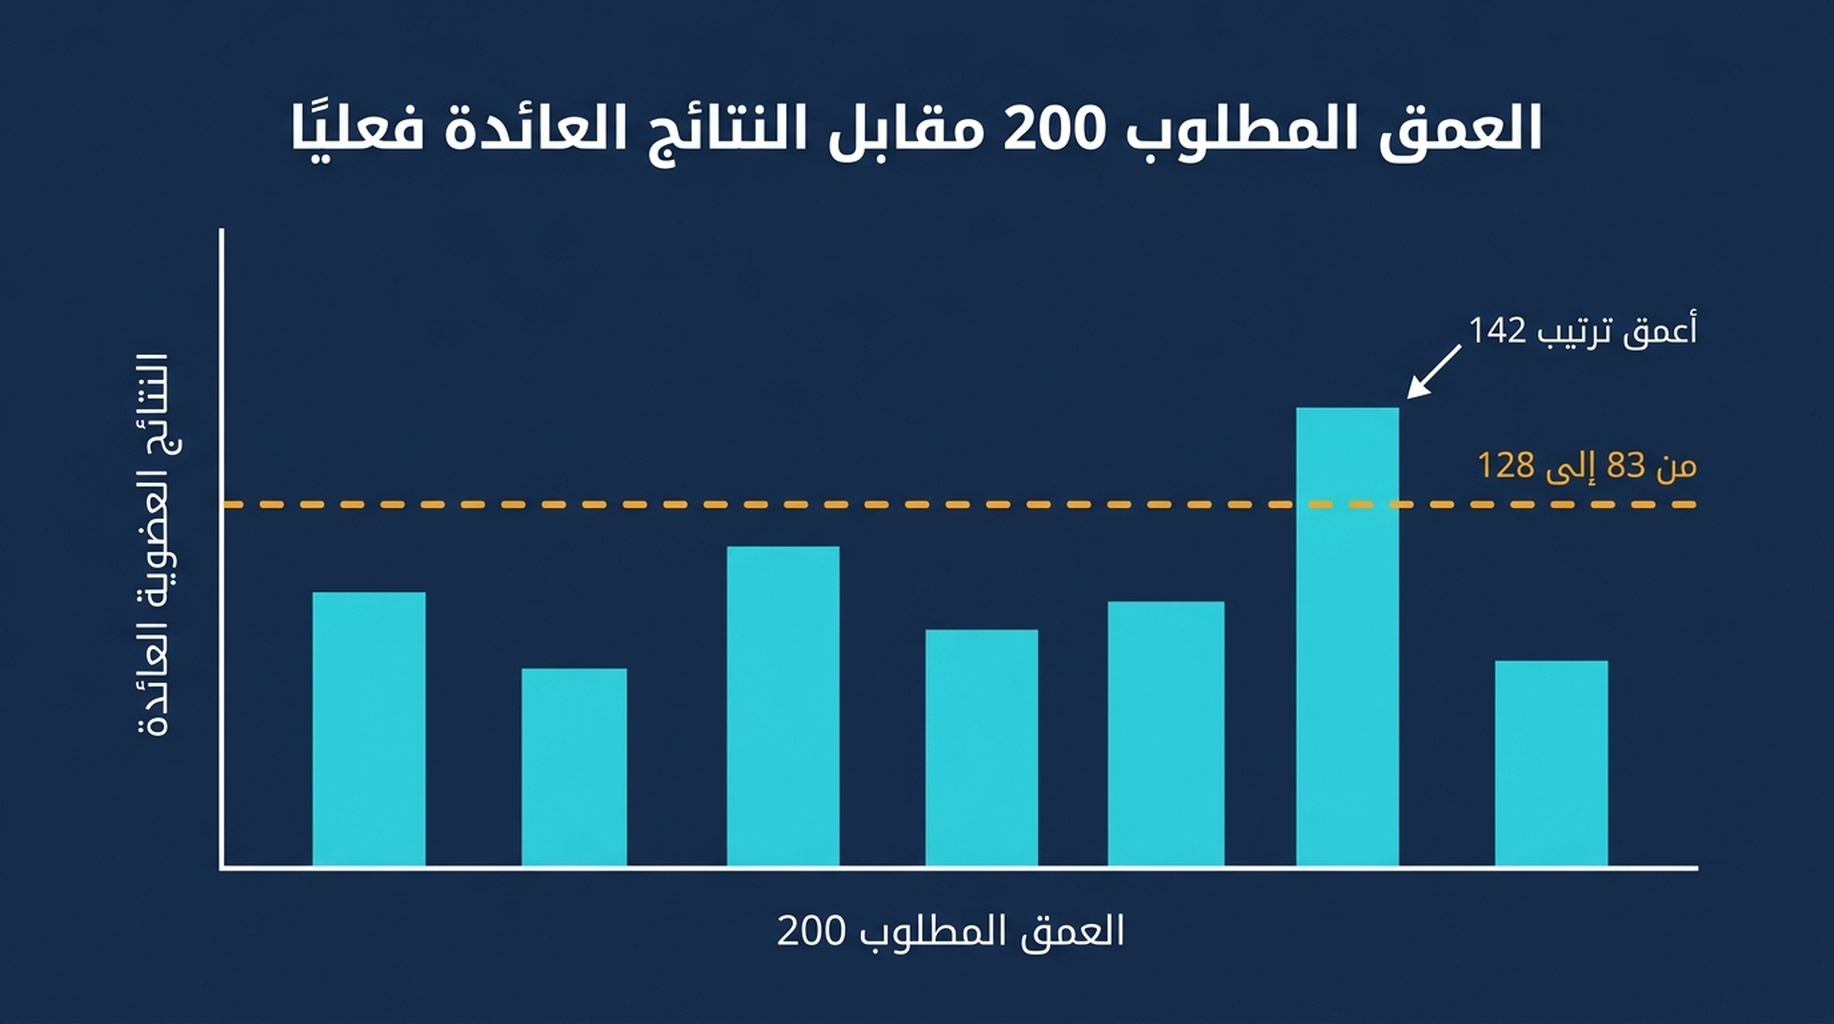
طلب 200 نتيجة وتلقّي 83 إلى 128. العمق فوق نحو 140 لا يشتري شيئًا في معظم الاستعلامات التجارية.
الناتج المتوقّع: حِمل JSON يحتوي عناصر عضوية بالموضع والرابط والعنوان والنطاق.
فحص الجودة: تأكّد من أن الحِمل يحتوي نوع عنصر ai_overview عند وجوده. وإن استخرجت العناصر organic فقط فستفوّت سبب خسارة صفحة لنقراتها مع احتفاظها بموضعها.
إذا فشل: الخطأ 401 خطأ في base64 أو في بيانات الاعتماد. ورمز من نمط 40200 يعني أن رصيد حسابك فارغ، وهو أكثر إخفاق شيوعًا في الشهر الأول.
الخطوة 4: خزّن الحِمل الخام، لا الملخّص
هذا هو القرار الذي يندم الناس على تجاوزه.
تخزين جدول مواضع ينجح إلى أن تحتاج طرح سؤال لم تتوقّعه: هل طالت صفحة النتائج، هل استولى الفيديو، هل دخل منافس، هل ظهر AI Overview فوق الطيّة. الملخّص لا يستطيع الإجابة عن ذلك. الحِمل الخام يستطيع، وبكلفة إضافية صفر.
الصيغة العملية: اكتب ملفًا واحدًا لكل تشغيل، مسمّى بالتاريخ والوقت، يحتوي الناتج المدموج. واحتفظ بآخر 90 يومًا. هذا صغير بما يكفي ليسكن مستودعًا، وكامل بما يكفي لإعادة الإجابة عن أسئلة قديمة.
الخطوة 5: اكتب قاعدة المقارنة قبل أن تجدول أي شيء
المتتبّع الذي يقارن التشغيل السابق بالحالي يُنتج إنذارًا كاذبًا في معظم الأيام. أرقامنا نحن تُظهر السبب: عبر 124 استعلامًا بظهور لا يقل عن 30، تحرّك الاستعلام المتوسط 4.57 موضعًا من يوم إلى اليوم التالي. هبوط أربعة مواضع هو أمر يوم ثلاثاء.
لذا تحتاج القاعدة إلى عتبة واتجاه.
أبلغ عن استعلام فقط عندما:
  - تكون القيمة المطلقة لتغيّر الموضع مقابل التشغيل السابق 5 أو أكثر، و
  - يكون للاستعلام 20 ظهورًا على الأقل في نافذة المقارنة، و
  - لا يُفسَّر التغيّر بتحوّل في مزيج الأجهزة

جمّع الناتج حسب فئة الاستعلام: money، comparison، brand، informational.
لا تقترح إصلاحات.
شرط الأجهزة ليس زينة. فالاستعلام نفسه قد يبعد 11 موضعًا بين الجوال وسطح المكتب، وإن تحرّك مزيج الأجهزة بين تشغيلين تحرّك الرقم المدمج أيضًا. نحن قِسنا ذلك على حدة وهو كبير بما يكفي لتزييف اتجاه.
ما الذي يكلّفه
أسعار المورّدين تتغيّر، فابنِ النموذج بدل مطاردة عرض سعر.
- كلمة مفتاحية واحدة تُفحص مرة يوميًا لمدة 30 يومًا = 30 طلبًا في الشهر.
- مجموعة من 200 كلمة تُفحص يوميًا = 6,000 طلب في الشهر.
- المجموعة نفسها تُفحص أسبوعيًا = نحو 860 طلبًا في الشهر.
- نصف Search Console مجاني، وهو طلب واحد لكل عرض، مهما كان عدد الكلمات المفتاحية داخله.
هذا الضرب هو القرار كله. فسؤال «هل أشتري أداة» يكاد دائمًا ينهار إلى هذا: احسب الطلبات في الشهر، واضربها بسعر الطلب عندك، وقارن بترخيص المقعد. التتبّع اليومي لمجموعة كلمات كبيرة أرخص عادةً كاشتراك. والتتبّع الأسبوعي لمجموعة صغيرة أرخص عادةً كواجهة API. وتتبّع قائمة مجمّدة يُبقي جانب الـAPI صغيرًا.
متى تشتري بدل أن تبني
ابنِ هذا إن كنت تريد المواضع داخل خط أنابيبك، أو تملك بالفعل بيانات اعتماد SERP API، أو تحتاج صفحة النتائج الخام لأسباب تتجاوز الموضع.
اشترِ بدل ذلك إن كنت تحتاج مواضع تاريخية من ما قبل اليوم، أو تحتاج عشرة مواقع وخمسة أجهزة للكلمات ذاتها، أو لم يكن في الفريق من يصون مهمة cron. ومقالات قوائم المورّدين تستحق القراءة لهذا السبب تحديدًا، ولأن امتلاك بنية تحتية تتوقّف عن العمل حين ينتقل بانيها إلى فريق آخر له كلفة حقيقية.
وإن كان الناتج الذي تحتاجه فعلًا تقريرًا أسبوعيًا مكتوبًا لا ملف JSON، فإن سير عمل التقارير في Codex يبدأ من المصدرين ذاتهما وينتهي إلى مستند. وللتنبيه فوق الملف، يغطّي دليل تصميم المراقبة العتبات.
رأي Auspia: سؤال واجهة تتبّع الترتيب هو في الحقيقة سؤال ملكية بيانات. يمنحك Search Console بيانات رسمية عن خاصيتك مجانًا وسيظل يفعل ذلك دائمًا. وكل ما عدا ذلك لقطة تدفع ثمنها. ابنِ النصف المجاني أولًا، وأضف النصف المدفوع فقط حيث يجيب عن سؤال لديك فعلًا.
الأسئلة الشائعة
هل تقدّم Google واجهة لتتبّع الترتيب؟ لا، لا توجد واجهة عامة. تعيد واجهة Search Console API متوسط موضعك للاستعلامات التي تظهر لها بالفعل، وهو قريب لكنه ليس الشيء ذاته. لا تستطيع فحص كلمة لا تظهر لها، ولا فحص منافس.
إلى أي عمق تستطيع واجهة SERP API أن تصل؟ يقبل المورّدون قيم عمق تتجاوز 200 بكثير، لكن Google تتوقّف عن تقديم النتائج عند نحو 100 إلى 140 في معظم الاستعلامات التجارية. وطلب المزيد لا ينتج نتائج أكثر.
هل أستخدم الفحص اليومي أم الأسبوعي؟ الأسبوعي لمجموعة كلمات عادية. واليومي فقط لقائمة قصيرة من استعلامات الإيراد. الفحص اليومي لمجموعة كبيرة يضاعف الكلفة سبع مرات ويقيس الضجيج في معظمه، إذ كان متوسط التحرّك اليومي في بياناتنا 4.57 موضعًا.
لماذا يختلف رقم الـAPI عندي عن أداة تتبّع الترتيب؟ أجهزة مختلفة، ومواقع مختلفة، ولحظات مختلفة، وغالبًا مصادر بيانات مختلفة. الرقم عيّنة. ثبّت الموقع والجهاز في طلبك وأعد السحب قبل أن تستنتج أن شيئًا تغيّر.
هل يستطيع وكيل تشغيل هذا بدلًا عني؟ نعم، وهو مناسب جدًا لأن المهمة بالشكل نفسه في كل تشغيل. وللصورة الأوسع لما يمكن أن يملكه الوكيل في عمل الترتيب، راجع الدليل الميداني لوكيل SEO. أبقِ قاعدة المقارنة في ملف تعليمات مكتوب ودع الوكيل ينتج الفارق، وأبقِ قرار البناء أو الشراء بيد إنسان.
الكاتب: Rowan Blake، محلل أتمتة محتوى في Auspia مسؤول عن أكثر من 100 خط نشر. يكتب عن خطوط البيانات المؤتمتة والتقارير المجدولة وكلفة صيانة أنظمة تعمل من دونك.