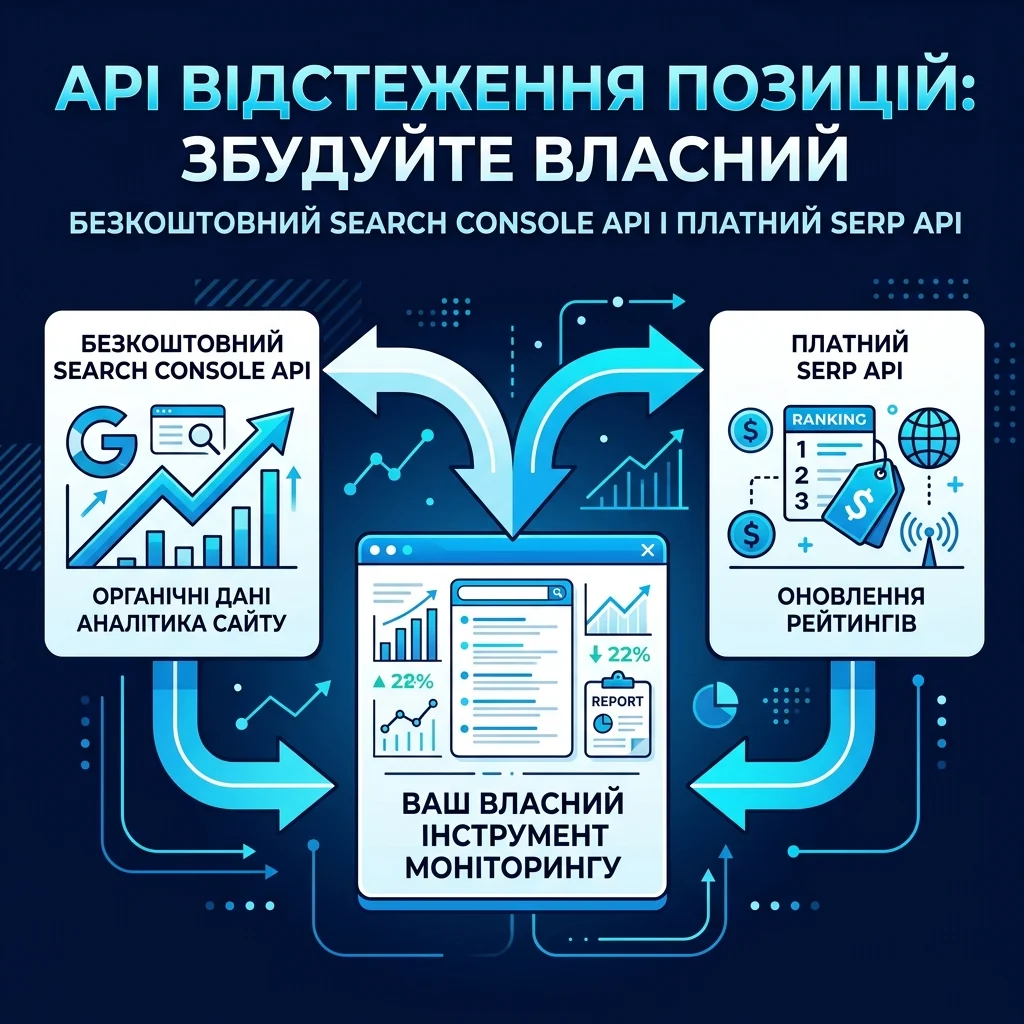
«API відстеження позицій» — це не одна річ. Розробник, який шукає "rank tracking API", зазвичай хоче один ендпоінт, що повертає позиції, а ринок відповідає добірками від постачальників. Чесна відповідь: потрібні два джерела, і вони відповідають на різні питання.
Search Console API безкоштовний, офіційний і назавжди обмежений ресурсами, які ви можете підтвердити. SERP API платний, неофіційний і може перевірити будь-який запит будь-де, включно із запитами, за якими ви ніколи не ранжувалися. Жодне з них окремо не є трекером позицій. Разом це приблизно 120 рядків Python і один рядок у cron.
Ось це збирання. Воно припускає, що ви вмієте запустити скрипт і зберегти файл. Воно не припускає, що ви хочете робити продукт.
Що у вас буде наприкінці
Для кого це: для розробника або технічного маркетолога, який уже має доступ до Search Console і хоче позиції за розкладом, не платячи за місце.
Що буде у вас на руках після завершення: дві робочі функції вибірки, один об'єднаний файл виводу на кожен запуск і правило порівняння, яке не дає числам вам брехати.
Час: близько 90 хвилин на перше збирання, далі приблизно 10 хвилин на розбір кожного запуску.
Як виглядає готове: датований JSON-файл із вашими позиціями за запитами й пристроями, плюс живі знімки SERP для замороженого списку запитів, плюс короткий диференціал до попереднього запуску.
Перед початком: що кожне джерело може і чого не може
Розділіть правильно — і все інше збирання буде механічним. Розділіть неправильно — і ви витратите місяць на щось або марне, або дороге.
Search Console API | SERP API | |
|---|---|---|
Чиї позиції | Лише ваші підтверджені ресурси | Будь-кого, включно з конкурентами |
Запити | Запити, за якими ви вже показуєтеся | Будь-який запит, який ви введете |
Вартість | Безкоштовно | Оплата за запит |
Розбивка за пристроями | Є, як вимір | Є, на кожен запит |
Локація | Країни, де ви ранжуєтеся | Будь-яка локація, яку підтримує постачальник |
Тип даних | Зведені кліки, покази, позиція | Сторінка результатів на певний момент |
Історична глибина | Запрошений діапазон | Лише від дня, коли ви почали зберігати |
Офіційний статус | Дані самого Google | Прочитання публічної сторінки третьою стороною |
Два джерела розходитимуться, і ця розбіжність — інформація, а не помилка. Search Console усереднює кожен показ за діапазоном дат і за всіма пристроями. Вибірка SERP — це одна сторінка результатів в один момент. Якщо порівнювати їх напряму, ви ганятиметеся за примарними падіннями. Саме тому крок п'ятий визначає правило порівняння.
Три числа, які варто знати до написання коду. Search Console API приймає ліміт рядків від 1 до 25 000 на запит і за замовчуванням ставить 1 000, тож сайт середнього розміру може витягнути три місяці даних про запити й пристрої одним викликом. Він дозволяє 1 200 запитів за хвилину на сайт і на користувача. І він застосовує квоти навантаження, вимірювані десятихвилинними відрізками, де довгий діапазон дат коштує дорожче за короткий — саме тому настанови самого Google радять уникати повторних запитів тих самих даних.
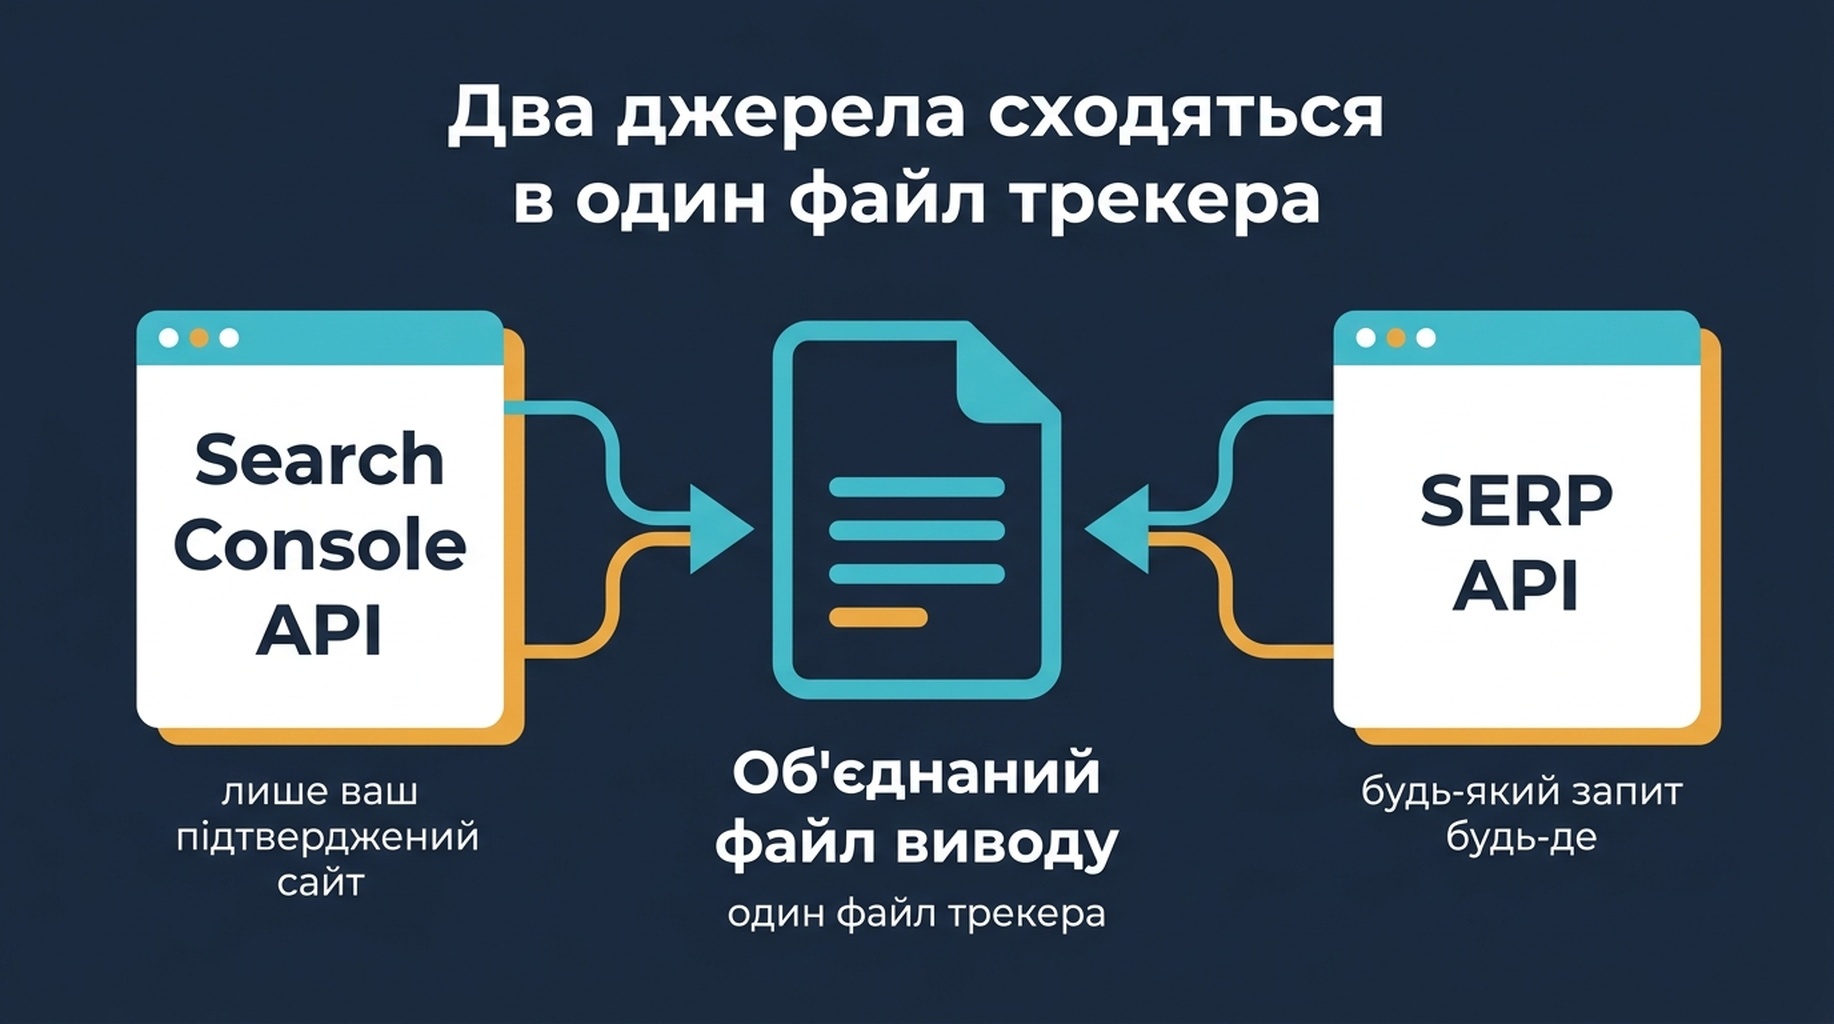
Два джерела, один вивід. Search Console відповідає «де я показуюся», SERP API відповідає «як виглядає сторінка».
Крок 1: заморозьте набір запитів до написання коду
Трекер, який тягне різний список запитів у кожному запуску, не може відповісти, чи щось змінилося. Спершу виберіть список і тримайте його квартал.
Три групи, і беруться вони з різних місць.
- З Search Console: кожен запит щонайменше з 20 показами за останні 90 днів. Їх вибираєте не ви; їх вибирають ваші покази. Це група, де рух щось означає, бо за нею вже стоїть попит.
- З бізнесу: десять-двадцять запитів, що відповідають доходу, незалежно від того, чи ви за ними ранжуєтеся.
- З конкурентів: запити, за якими ранжується конкурент, а ви ні. Для них потрібен SERP API, бо Search Console їх ніколи не покаже.
Запишіть список у файл, ведіть його версії й ставтеся до додавань як до свідомої зміни, а не як до дрейфу.
Крок 2: заберіть свої позиції безкоштовно
Ця половина офіційна, безкоштовна й дає розбивку за пристроями та дані про кліки, яких немає в жодного SERP API.
from google.oauth2 import service_account
from googleapiclient.discovery import build

service = build(
    "searchconsole", "v1",
    credentials=service_account.Credentials.from_service_account_file(
        "gsc-key.json",
        scopes=["https://www.googleapis.com/auth/webmasters.readonly"],
    ),
)

body = {
    "startDate": "2026-06-14",
    "endDate": "2026-09-11",
    "dimensions": ["query", "device"],
    "type": "web",
    "dataState": "final",
    "rowLimit": 25000,
}

rows = service.searchanalytics().query(
    siteUrl="sc-domain:example.com", body=body
).execute().get("rows", [])
Дві деталі в цьому запиті роблять майже всю роботу.
dataState: "final" виключає свіжі дані, які Google ще може переглянути. Без нього останні два-три дні гуляють між запусками, і у вашому диференціалі з'являються рухи, яких не було.
dimensions: ["query", "device"] — це те, що робить вивід корисним згодом. Додати пристрій зараз не коштує нічого. Повторно тягнути три місяці історії потім коштує повного запуску й не дає нічого за дні, які ви вже пропустили.
Очікуваний вивід: по одному рядку на запит і пристрій, з кліками, показами, CTR і середньою позицією.
Перевірка якості: кількість рядків має бути меншою за 25 000. Якщо рівно 25 000, вас обрізали й потрібен другий виклик із startRow: 25000.
Якщо не вдалося: 403 зазвичай означає, що пошту сервісного акаунта так і не додали користувачем на ресурс. Додайте її в Search Console, зачекайте кілька хвилин, повторіть.
Крок 3: заберіть SERP, яких не видно у ваших даних
Друга половина покриває все, чого Search Console структурно не може. Це мінімальний робочий виклик.
import base64, json, urllib.request

LOGIN, PASSWORD = "your-login", "your-password"

def serp(keyword, depth=100):
    token = base64.b64encode(f"{LOGIN}:{PASSWORD}".encode()).decode()
    payload = json.dumps([{
        "keyword": keyword,
        "location_name": "United States",
        "language_name": "English",
        "depth": depth,
    }]).encode()
    request = urllib.request.Request(
        "https://api.dataforseo.com/v3/serp/google/organic/live/advanced",
        data=payload,
        headers={"Authorization": f"Basic {token}",
                 "Content-Type": "application/json"},
        method="POST",
    )
    return json.loads(urllib.request.urlopen(request, timeout=120).read())
Ставте `depth` на 100, а не на 200. Ми перевірили це у вересні 2026 року, запросивши по 200 результатів для шести запитів. Google повернув від 83 до 128 органічних результатів і спинився, а найглибша позиція за весь тест була 142. Повний тест тут. Запит на 200 не дає 200 результатів, і залежно від постачальника вам усе одно можуть виставити рахунок за замовлену глибину. Запросіть 100 — і ви майже завжди отримаєте все, що існує.
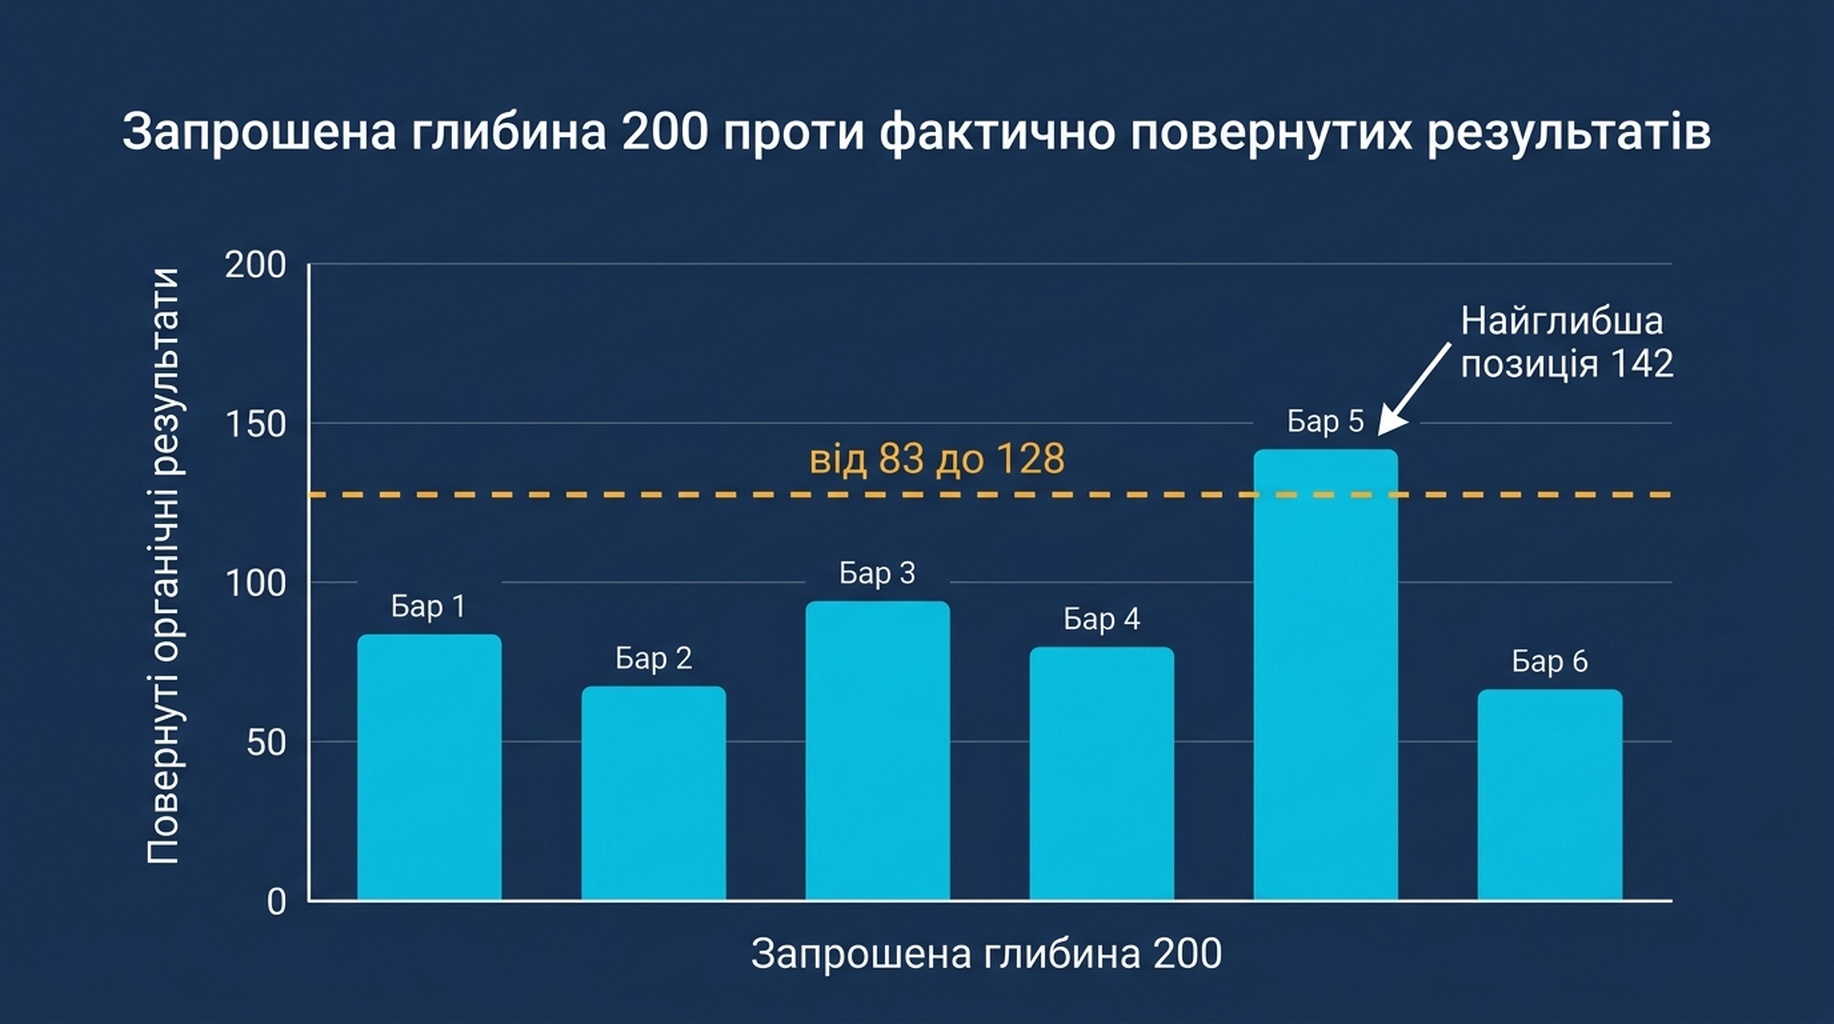
Замовляємо 200 результатів і отримуємо від 83 до 128. Глибина понад приблизно 140 на більшості комерційних запитів не купує нічого.
Очікуваний вивід: JSON-навантаження з органічними елементами, що містять позицію, URL, заголовок і домен.
Перевірка якості: переконайтеся, що навантаження містить тип елемента ai_overview, коли він є. Якщо витягувати лише елементи organic, ви пропустите причину, чому сторінка втратила кліки, утримавши позицію.
Якщо не вдалося: 401 — це помилка base64 або облікових даних. Код на кшталт 40200 означає, що баланс акаунта порожній, і це найчастіша невдача першого місяця.
Крок 4: зберігайте сире навантаження, а не підсумок
Це те рішення, про пропуск якого люди шкодують.
Зберігання таблиці позицій працює, доки вам не знадобиться поставити питання, якого ви не передбачили: чи видача стала довшою, чи відео все забрало, чи зайшов конкурент, чи з'явився AI Overview над згином. Підсумок цього не відповість. Сире навантаження відповість, за нульових додаткових витрат.
Практичний варіант: пишіть по одному файлу на запуск, з іменем за датою й часом, що містить об'єднаний вивід. Тримайте останні 90 днів. Цього достатньо мало, щоб жити в репозиторії, і достатньо повно, щоб заново відповідати на старі питання.
Крок 5: напишіть правило порівняння до того, як щось планувати
Трекер, який порівнює минулий запуск із поточним, більшість днів видає хибну тривогу. Наші власні числа показують чому: за 124 запитами щонайменше з 30 показами середній запит зміщувався на 4.57 позиції за добу. Падіння на чотири позиції — це вівторок.
Отже, правилу потрібні поріг і напрямок.
Повідомляти про запит лише коли:
  - абсолютна зміна позиції до попереднього запуску становить 5 або більше, І
  - запит мав щонайменше 20 показів у вікні порівняння, І
  - зміна не пояснюється зсувом у складі пристроїв

Групувати вивід за класом запиту: money, comparison, brand, informational.
Не пропонувати виправлень.
Застереження про пристрої — не оздоба. Той самий запит може стояти на 11 позицій по-різному на мобільному й настільному, і якщо склад пристроїв зсунеться між запусками, змішане число теж зсунеться. Ми виміряли це окремо, і величина достатня, щоб підробити тренд.
Скільки це коштує
Ціни постачальників змінюються, тож будуйте модель, а не ганяйтеся за комерційною пропозицією.
- Один запит, що перевіряється раз на день 30 днів, — це 30 запитів на місяць.
- Набір із 200 запитів, що перевіряється щодня, — це 6 000 запитів на місяць.
- Той самий набір, що перевіряється щотижня, — близько 860 запитів на місяць.
- Половина Search Console безкоштовна й становить один запит на подання, скільки б запитів усередині не було.
Це множення і є все рішення. Майже будь-яке питання «чи варто купувати інструмент» зводиться до нього: порахуйте запити на місяць, помножте на свою ціну за запит і порівняйте з ліцензією за місце. Щоденне відстеження великого набору зазвичай дешевше за підпискою. Щотижневе відстеження малого набору зазвичай дешевше через API. Відстежуйте заморожений список — і бік API залишиться малим.
Коли купувати, а не збирати
Збирайте, якщо хочете позиції у власному конвеєрі, якщо у вас уже є облікові дані SERP API або якщо сира сторінка результатів потрібна вам з причин, окрім позиції.
Купуйте натомість, якщо потрібні історичні позиції до сьогодні, якщо потрібні десять локацій і п'ять пристроїв для тих самих запитів, або якщо ніхто в команді не підтримуватиме cron. Добірки постачальників варто читати саме з цієї причини, і у володінні інфраструктурою, яка зупиняється, коли її автор переходить в іншу команду, є реальна ціна.
Якщо потрібний вам вивід — це письмовий тижневий звіт, а не JSON-файл, звітний процес у Codex починається з тих самих двох джерел і закінчується документом. Для оповіщень поверх файлу настанова з проєктування моніторингу розбирає пороги.
Погляд Auspia: питання про API відстеження позицій насправді є питанням володіння даними. Search Console дає офіційні дані про ваш ресурс безкоштовно й завжди даватиме. Усе інше — знімок, за який ви платите. Спершу збудуйте безкоштовну половину, а платну додавайте лише там, де вона відповідає на питання, яке у вас справді є.
Часті питання
Чи пропонує Google API для відстеження позицій? Публічного — ні. Search Console API повертає вашу середню позицію за запитами, за якими ви вже показуєтеся; це близько, але не те саме. Він не може перевірити запит, за яким ви не ранжуєтеся, і не може перевірити конкурента.
Як глибоко може сягнути SERP API? Постачальники приймуть значення глибини значно вище 200, але Google перестає віддавати результати десь між 100 і 140 на більшості комерційних запитів. Запит більшого не дає більшої кількості результатів.
Використовувати щоденні чи щотижневі перевірки? Щотижневі для звичайного набору запитів. Щоденні — лише для короткого списку грошових запитів. Щоденні перевірки великого набору множать вартість на сім і здебільшого вимірюють шум, адже середній добовий зсув у наших даних становив 4.57 позиції.
Чому моє число з API відрізняється від мого трекера позицій? Інші пристрої, інші локації, інші моменти й часто інші джерела даних. Число — це вибірка. Зафіксуйте локацію й пристрій у запиті та витягніть дані знову, перш ніж робити висновок, що щось змінилося.
Чи може агент запускати це замість мене? Так, і це добре пасує, бо завдання має ту саму форму в кожному запуску. Ширша картина того, що агент може взяти на себе в роботі з позиціями, — у практичній настанові з SEO-агента. Тримайте правило порівняння в письмовому файлі інструкцій і дозвольте агенту створювати диференціал; рішення «збирати чи купувати» залиште людині.
Автор: Rowan Blake, аналітик з автоматизації контенту в Auspia, відповідає за понад 100 видавничих конвеєрів. Пише про автоматизовані конвеєри даних, звітність за розкладом і вартість підтримки систем, які працюють без вас.