批次排名檢查器只承諾一件事:把許多關鍵詞彙總成一份報告。而報告裡有什麼,幾乎完全由一個大多數人從不改動的設定決定——檢查往下探多深。
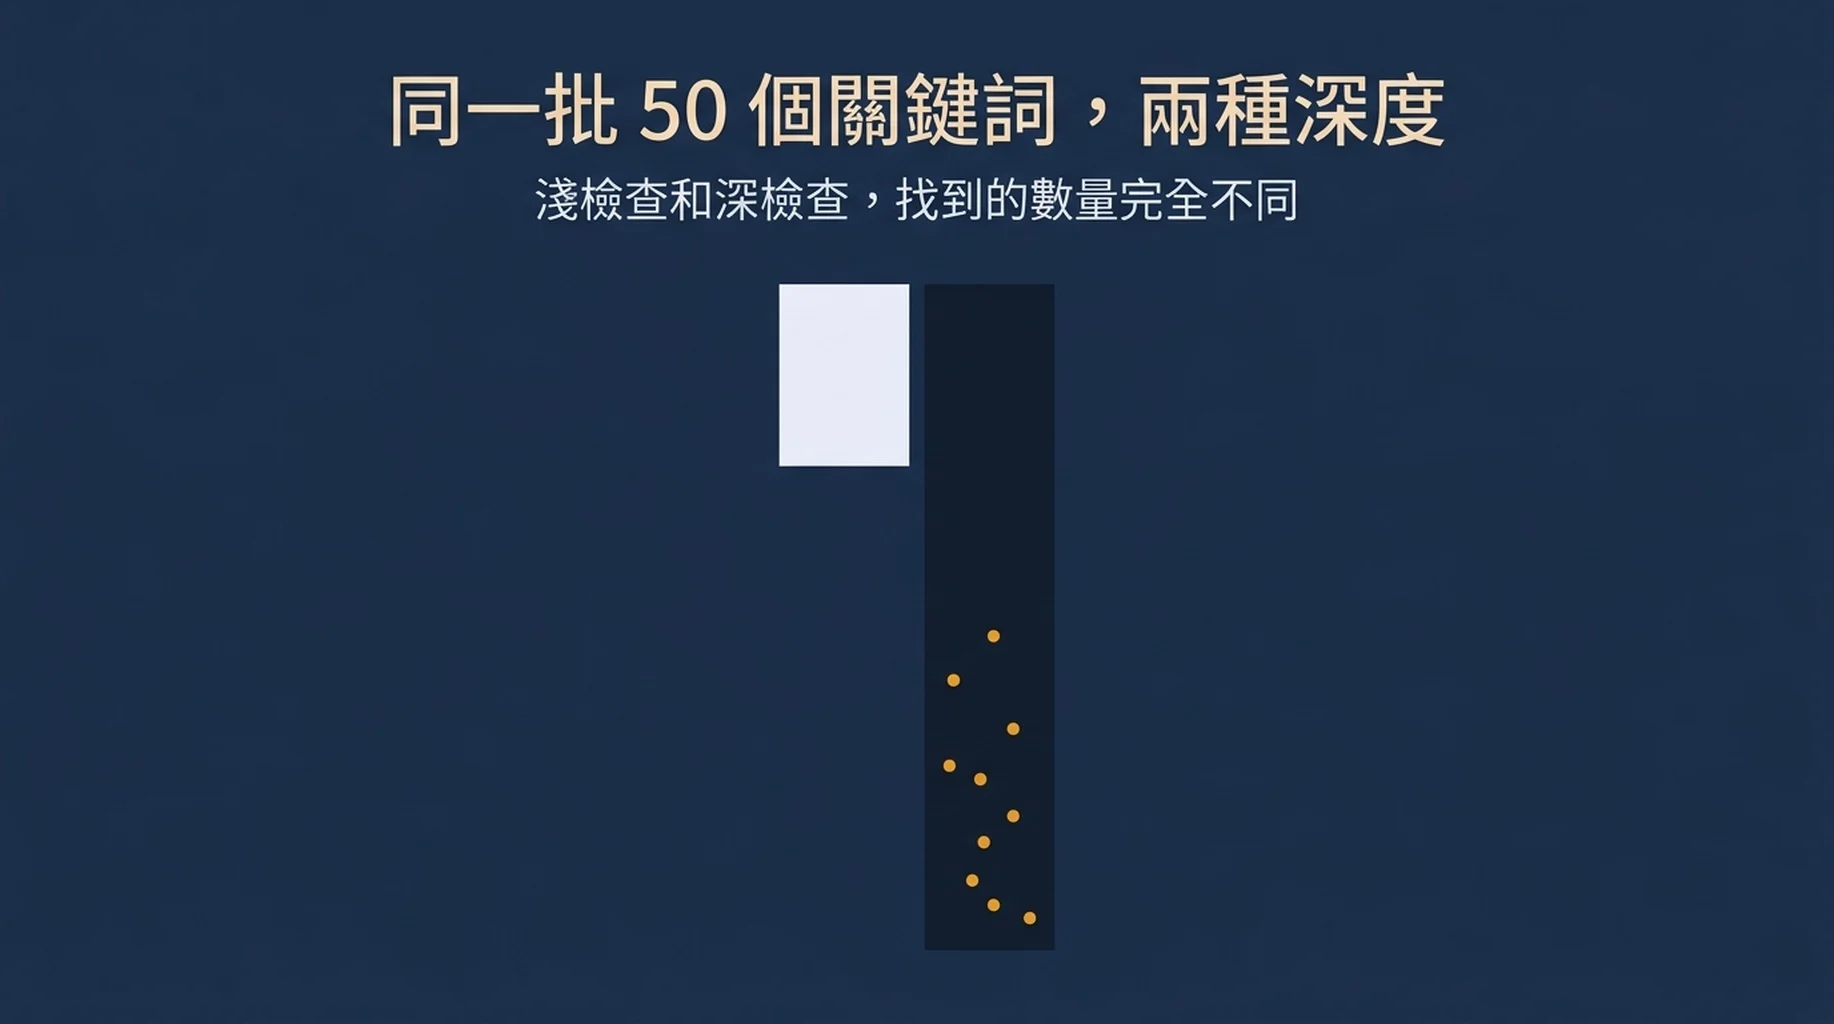
我們在 2026 年 9 月 12 日,把同一批 50 個關鍵詞,針對同一個搜尋引擎、同一個地區、同一台裝置,背靠背跑了兩遍。唯一不同的是深度。
在深度 10 下,檢查在 50 個關鍵詞中的 1 個裡找到了我們的網域。在深度 100 下,它在其中 22 個裡找到了我們的網域。
同樣的關鍵詞。同一個小時。同一個 API。這個差別不是準確度,因為兩次執行都是準確的。這是視野範圍,而它把標題數字改變了 22 倍。
我們跑了什麼
50 個關鍵詞取自我們自己的 Search Console 查詢清單,並篩選為拉丁字母查詢,以便與美國、英語的結果集相符。兩次執行都使用桌面解析度下的即時 Google 自然結果請求、8 個並行工作行程,以及每次請求 300 秒的逾時。
設定 | 執行 A | 執行 B |
|---|---|---|
關鍵詞 | 50 | 50 |
請求的深度 | 10 | 100 |
地區與語言 | 美國、英語 | 美國、英語 |
裝置 | 桌面 | 桌面 |
並行數 | 8 | 8 |
我們記錄了每次請求的延遲、計費成本、自然結果數量,以及我們的網域是否出現。
結果 1:同樣的關鍵詞,兩個不同的答案
指標 | 深度 10 | 深度 100 |
|---|---|---|
檢查的關鍵詞 | 50 | 50 |
傳回可用結果的請求 | 50 | 43 |
失敗的請求 | 0 | 7 |
我們的網域出現的關鍵詞 | 1 | 22 |
進入前 3 名 | 1 | 1 |
進入前 20 名 | 1 | 1 |
進入前 100 名 | 1 | 20 |
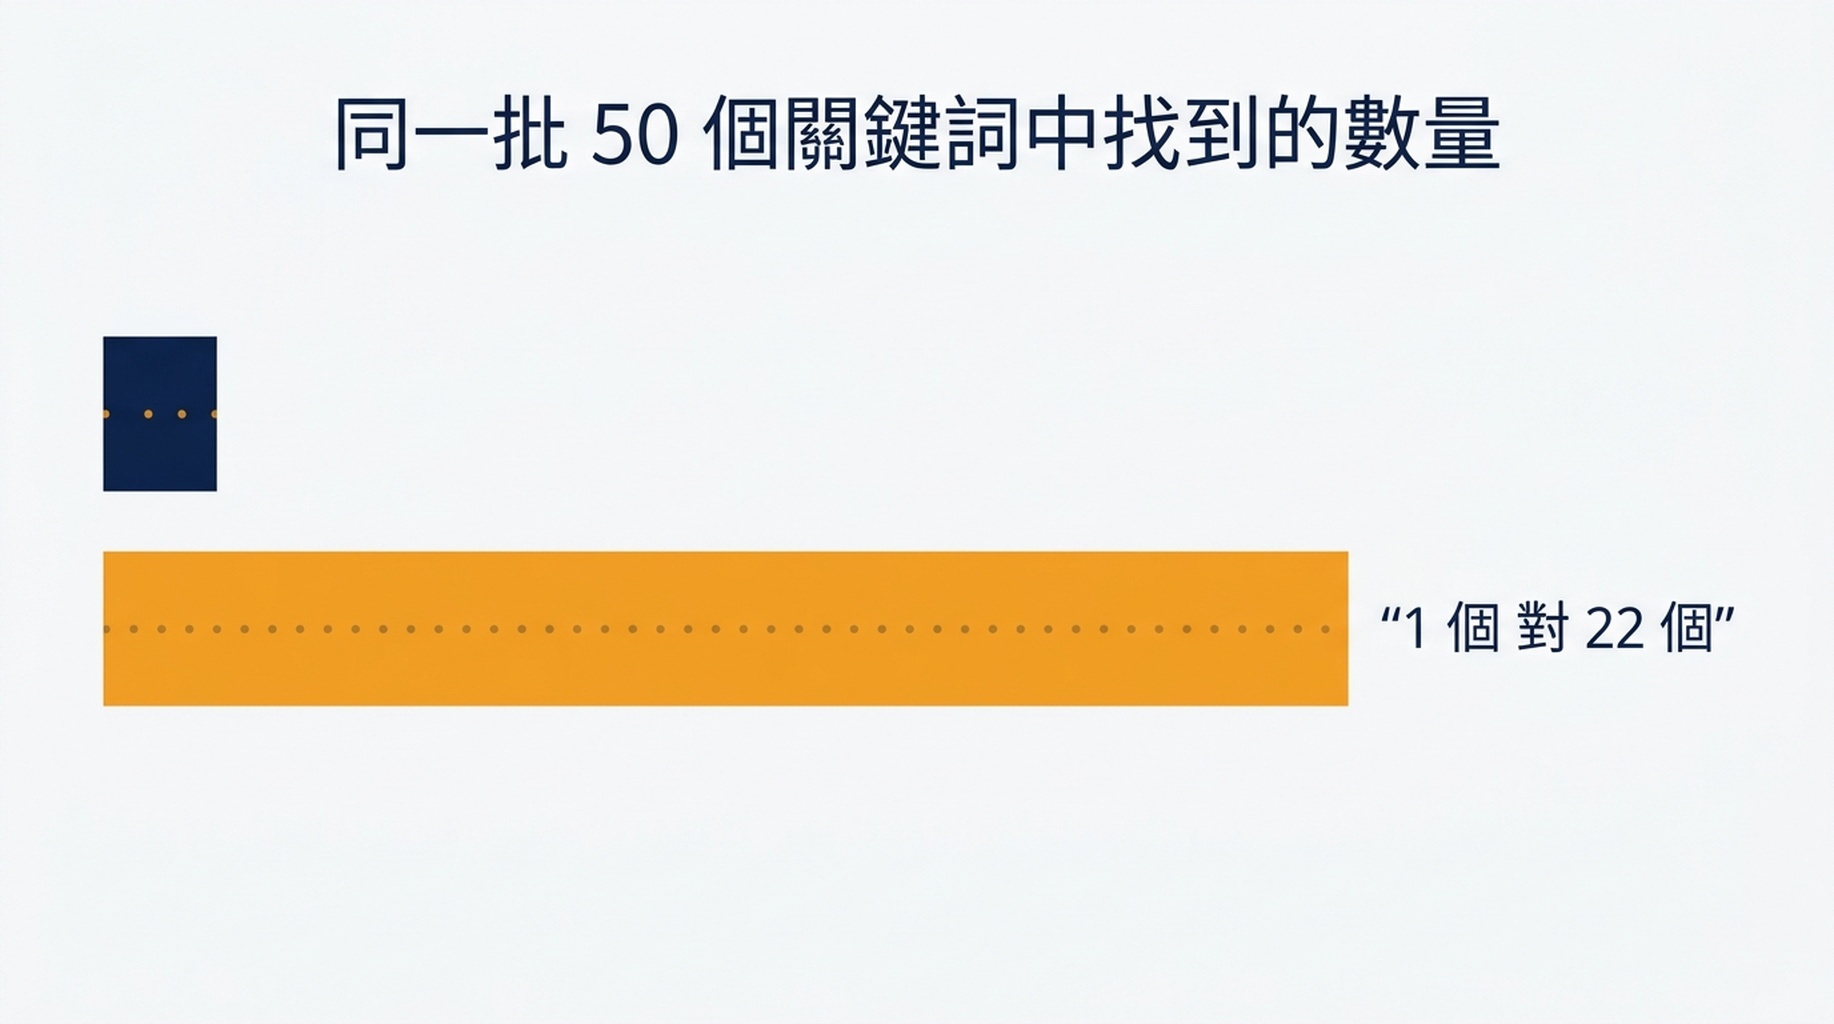
兩次執行之間關鍵詞集合沒有變化,變的只是深度設定。
這一點要仔細讀,因為它的形狀本身就是全部的教訓。在深度 10 下,我們在這批關鍵詞上的可見度看起來是 2%。在深度 100 下看起來是 44%。兩個數字都沒錯,而只有一個是可用的。
頁面頂部的圖景幾乎沒有變化。有 1 個關鍵詞在兩次執行中都落在前 10 名之內。更深的檢查所增加的一切都位於第 20 名到第 100 名之間,而這正是預設設定的批次檢查器所隱藏的區間。如果你的計畫建立在把排名檢查器設為首頁之上,那你的基準就不是對可見度的測量,而是對首頁之內可見度的測量,而在這批關鍵詞上兩者相差 21 個關鍵詞。
一個小的補充細節:深跑找到的 22 個關鍵詞中有 2 個位於絕對第 100 名之外。API 會略微超出所請求的深度傳回,所以一份「前 100 名」報告可能包含 100 名之後的排名。如果這個標籤對你重要,就把它們過濾掉。
結果 2:成本隨深度增長,約為 7 比 1
指標 | 深度 10 | 深度 100 |
|---|---|---|
計費成本合計 | $0.1000 | $0.6230 |
每個關鍵詞的成本 | $0.0020 | $0.0125 |
每個關鍵詞傳回的自然結果 | 約 12 | 約 97 |
深度 100 的執行對同樣的 50 個關鍵詞花掉了深度 10 的 6.2 倍成本,而這個差額買到了我們網域出現的另外 21 個關鍵詞。
這個比率是對批次檢查器最常見問題的誠實回答,即為更多結果付費是否值得。如果你排名在首頁之後,那就值得。如果你的關鍵詞停留在前 10 名,深跑傳回的大多是你永遠不會讀的列。
有一個中間設定,而且通常它才是對的。深度 20 在我們早先的定價中是每個關鍵詞 $0.0035,比深度 10 貴 75%,但相對於深度 100 仍是 75% 的折扣。對於一個處在第 20 到第 50 名區間的網站,深度 20 能以很小的一部分成本捕捉到大部分有用的變化。
計費成本也比按關鍵詞單價預測的更低,因為那 7 個失敗的請求沒有計費。這就是失敗率出現在帳單上的方式,我們馬上就會講到它。
結果 3:報告還隱藏了當時有沒有 AI Overview
只給排名的報告漏掉的不只是深度。
我們在兩次執行的每次請求上都記錄了 SERP 元素類型。在深度 10 的執行中,50 個查詢裡有 48 個傳回了 AI Overview。在深度 100 的執行中,43 個成功請求裡有 42 個傳回了。
執行 | 帶有 AI Overview 的查詢 | 檢查的查詢 |
|---|---|---|
深度 10 | 48 | 50 |
深度 100 | 42 | 43 個成功請求 |
對讀過我們早先那份快照的人來說,這個數字看起來是錯的——那份快照在 40 個 SEO 主題查詢中的 4 個裡發現了 AI Overview。兩者都對,區別在查詢集而不在方法。
那 40 個查詢的集合是一份 SEO 主題清單:排名工具、稽核、演算法更新,以及 15 個點名某個工具或 API 的查詢。這 50 個查詢的集合來自我們自己的 Search Console 查詢清單,其中以長尾的工具型與對比型措辭為主。一個網站真正獲得曝光的查詢,與 SEO 團隊記錄下來的查詢形狀不同,而 AI Overview 的出現跟著這個形狀走。
對批次檢查來說,實務上的要點更窄也更惱人。批次排名檢查器傳回的是排名。它不傳回如今坐在第 1 名之上的那個元素,而在我們真正擁有的這個查詢集上,那個元素出現在 96% 的查詢裡。
結果 4:時間等於延遲除以並行數
批次檢查不是瞬間完成的,原因是請求延遲,而不是你能控制的任何處理。
指標 | 深度 10 | 深度 100 |
|---|---|---|
8 個工作行程下的實際耗時 | 62.0 秒 | 135.9 秒 |
最快的請求 | 2.6 秒 | 8.1 秒 |
中位請求 | 8.3 秒 | 19.2 秒 |
最慢的請求 | 22.0 秒 | 40.3 秒 |
所有請求時間之和 | 451 秒 | 998 秒 |
由此得出兩點。
延遲中位數隨深度翻了一倍多,從 8.3 秒升到 19.2 秒。更深的搜尋組裝起來確實更慢,這正是客戶端逾時很短的批次檢查器會在深跑上失敗、而在淺跑上不會的原因。
實際耗時由並行數決定,而不是由 API 的速度決定。把 50 個關鍵詞串行跑一遍,深度 10 的檢查要花約 7.5 分鐘;8 個工作行程下只要 1 分鐘。如果你的批次檢查器沒有並行控制,那就是唯一值得去問的設定,因為在成本沒有差別的情況下它值 8 倍的時間。
結果 5:深跑有 14% 的失敗率
深度 100 的 50 次請求中有 7 次失敗。深度 10 的請求一次都沒有失敗。
執行 | 失敗數 | 失敗率 |
|---|---|---|
深度 10 | 50 次中 0 次 | 0% |
深度 100 | 50 次中 7 次 | 14% |
由於失敗的請求沒有計費,深度 100 的執行也比按關鍵詞單價預測的 $0.70 更便宜,這就是為什麼有效單關鍵詞成本落在 $0.0125 而不是 $0.014。
這是批次檢查中報告很少展示的部分。一個默默重試的工具會把它蓋過去。一個不重試的工具會悄悄少報你的排名,而失敗集中在最慢的請求上——那正是你額外付費買來的深請求。
7 次請求的錯誤訊息完全相同:工作帶著部分結果完成,有些頁面在多次重試後仍無法抓取,未傳回的頁面沒有計費。這是服務方應有的行為,也正是批次檢查會少報而不是崩潰的原因。一個失敗的頁面並不是你沒有排名的關鍵詞,它是一個未知;而把未知渲染成空白儲存格的報告,已經悄悄把未知變成了否定。
如果你自己寫迴圈,就把失敗記錄為一等結果而不是丟棄,並在出報告前把失敗重試一次。
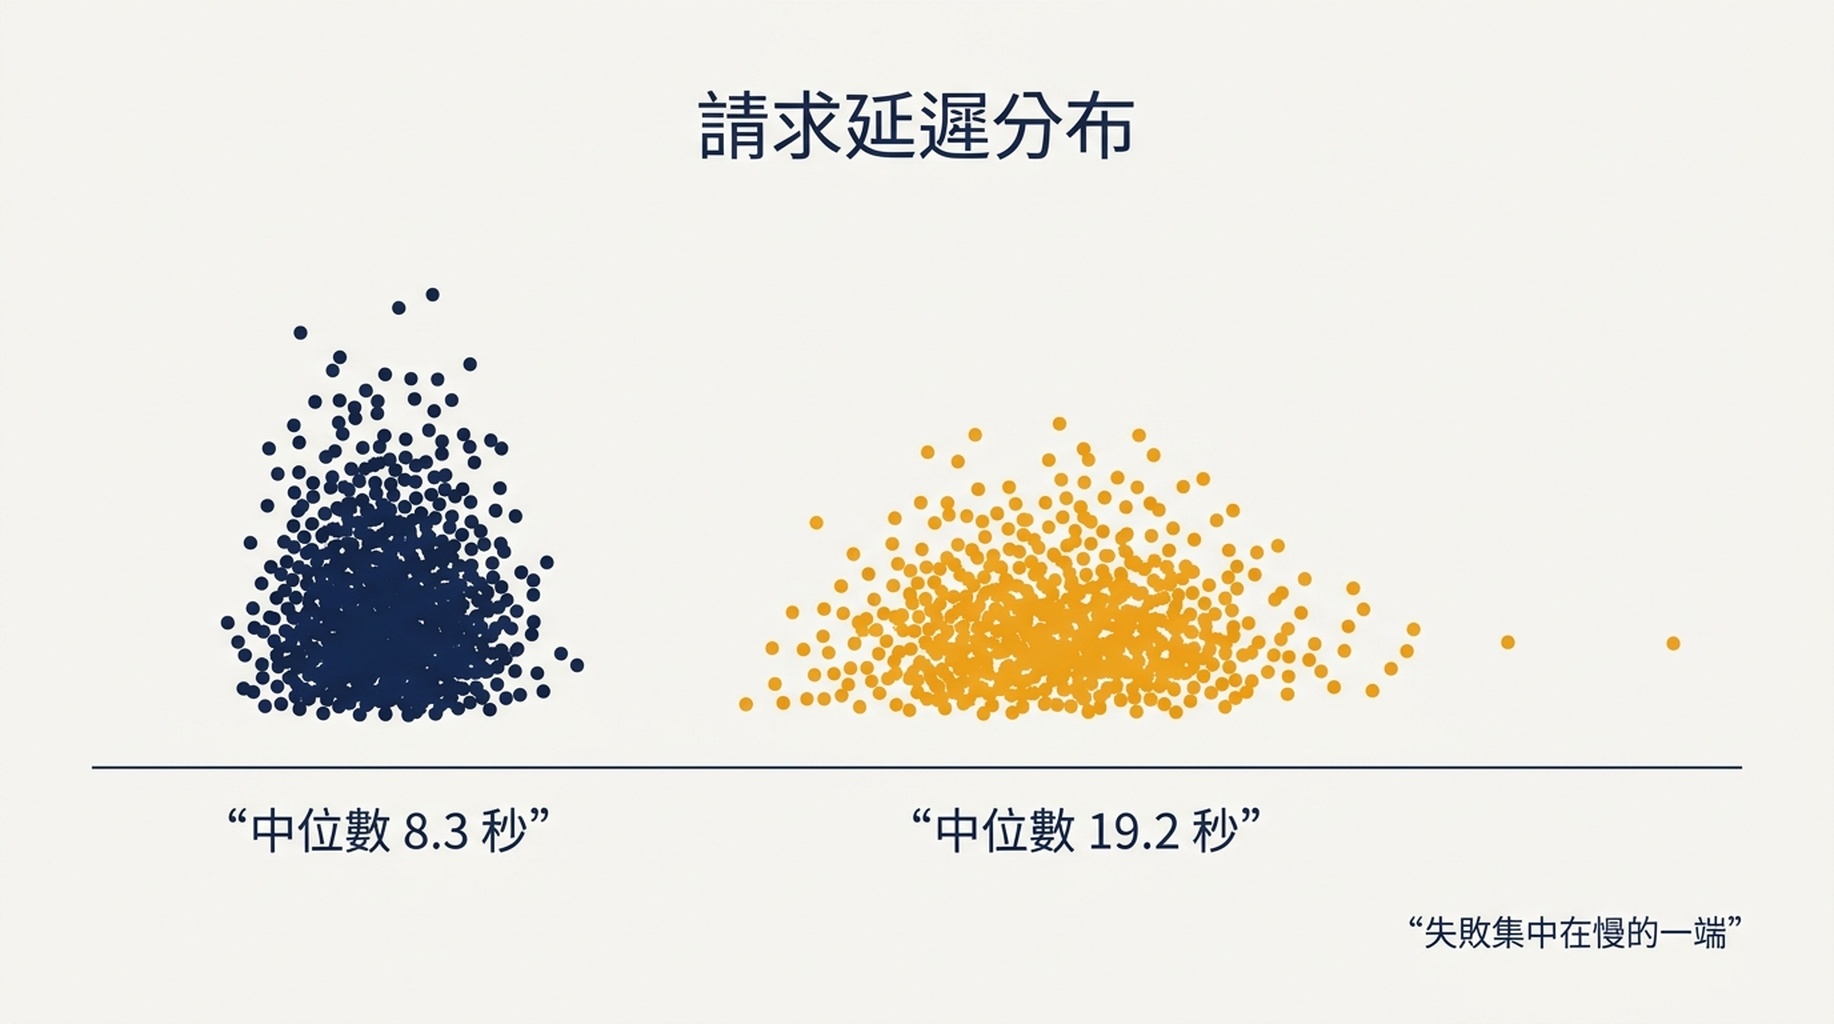
更深的請求耗時更長,而失敗集中在分布的慢端。
這對你儀表板上那個數字意味著什麼
同樣的 50 個關鍵詞產生了兩個都站得住腳的可見度數字,2% 和 44%,把它們分開的只是一個深度設定。這個擺動幅度比你花一個季度去解釋的大多數排名變化都要大。
由此推出三條規則。
深度要按你的排名位置來定,而不是按工具的預設值來定。 先把你自己的排名分布拉出來。如果你大多數關鍵詞位於第 20 名到第 60 名之間,深度 10 幾乎什麼都報不出來,而你會得出一個你其實並不存在的可見度問題。
把深度和數字一起報出來。 沒有深度設定的排名報告不可重現。地區、語言和裝置也一樣。
把「未找到」當作資料,而不是錯誤。 50 個關鍵詞裡有 28 個在深度 100 下也沒有傳回我們網域的結果,而這就是誠實的答案。一個把這些列藏起來的檢查器,是在朝最沒用的方向縮短你的關鍵詞清單。
確認報告到底有沒有包含 SERP 功能。 在這批關鍵詞上,AI Overview 出現在 96% 的查詢裡。只給排名的匯出無法顯示這一點,任何深度設定也不會把它補上。
如果目標是隨時間推移站得住腳的數字,那麼深度問題就在報告問題之下。我們關於 Google 實際會把結果提供到多深的筆記講了上限在哪裡,同時執行第一方來源與即時來源講了讓你對此保持誠實的配置,而 Search Console 能告訴你哪些即時檢查做不到的事講的則是這次執行完全沒有觸及的那一半。
限制
有兩點限制值得說明。
來自一個網站的 50 個關鍵詞是小樣本,而 2% 對 44% 這個分裂,是關鍵詞位置很深的網站所特有的。一個在清單大部分詞上都排在前 10 名的網站,兩次執行之間幾乎看不到差別,而且是在為深度過度付費。
延遲取決於服務方、地區和當下時刻。這裡的絕對秒數不會遷移,但兩個深度之間的比率應當大致保持,因為差別是真正的工作量而不是網路波動。
常見問題
批次排名檢查器應該用多深? 按你自己的排名分布來定。如果你排在前 10 名,深度 10 就夠了。深度 20 以每個關鍵詞 $0.0035 覆蓋了大部分實用區間。深度 100 要花 $0.014,只有在你確實追蹤第 50 名之後的排名時才值得。
檢查 50 個關鍵詞要多久? 8 個並行工作行程下,淺檢查約 1 分鐘,深檢查約 2.3 分鐘。串行執行時同樣的檢查要 7.5 分鐘和 16.6 分鐘,所以並行在實際耗時上值 8 倍。
為什麼深檢查失敗得更頻繁? 更深的請求組裝起來更久,中位數 19.2 秒對淺跑的 8.3 秒,所以更容易撞上客戶端或服務方的逾時。要把失敗記錄下來並重試,而不是丟棄。
如果批次排名檢查器說我的關鍵詞未找到,它準確嗎? 通常準確。在我們的執行中,50 個關鍵詞裡有 28 個在 100 名之內確實沒有我們網域的結果。在把缺失的列當成資料問題之前,先檢查深度設定。
檢查更多關鍵詞比檢查得更深更貴嗎? 深度改變的是每個關鍵詞的帳單,而關鍵詞會成倍放大總額。在深度 10 下從 50 個增加到 500 個關鍵詞,成本是 10 倍、耗時也是 10 倍,而深度 100 每個關鍵詞貴 7 倍。先為你需要的深度定價,再買你審得過來的關鍵詞數量。
Auspia 觀點:在改動任何一個頁面之前,先看你的批次檢查器的深度設定。它是對一個令人意外的可見度數字最便宜的解釋,在我們的測試中,它造成了相隔幾分鐘的兩次執行之間 22 倍的差距。深度要按排名分布來定,記錄失敗,並把設定留在報告裡,這樣下個季度的數字才可比。
作者:Bennett Hayes,Auspia 應用 GEO 分析師,負責 400 多次實施評審。撰寫關於實務性搜尋執行、測量,以及那些會改變一份報告的細節的文章。