Масовий чекер позицій обіцяє одне: багато ключових фраз — один звіт. А що саме в цьому звіті, майже повністю визначає одне налаштування, яке майже ніхто не змінює, — наскільки глибоко сягає перевірка.
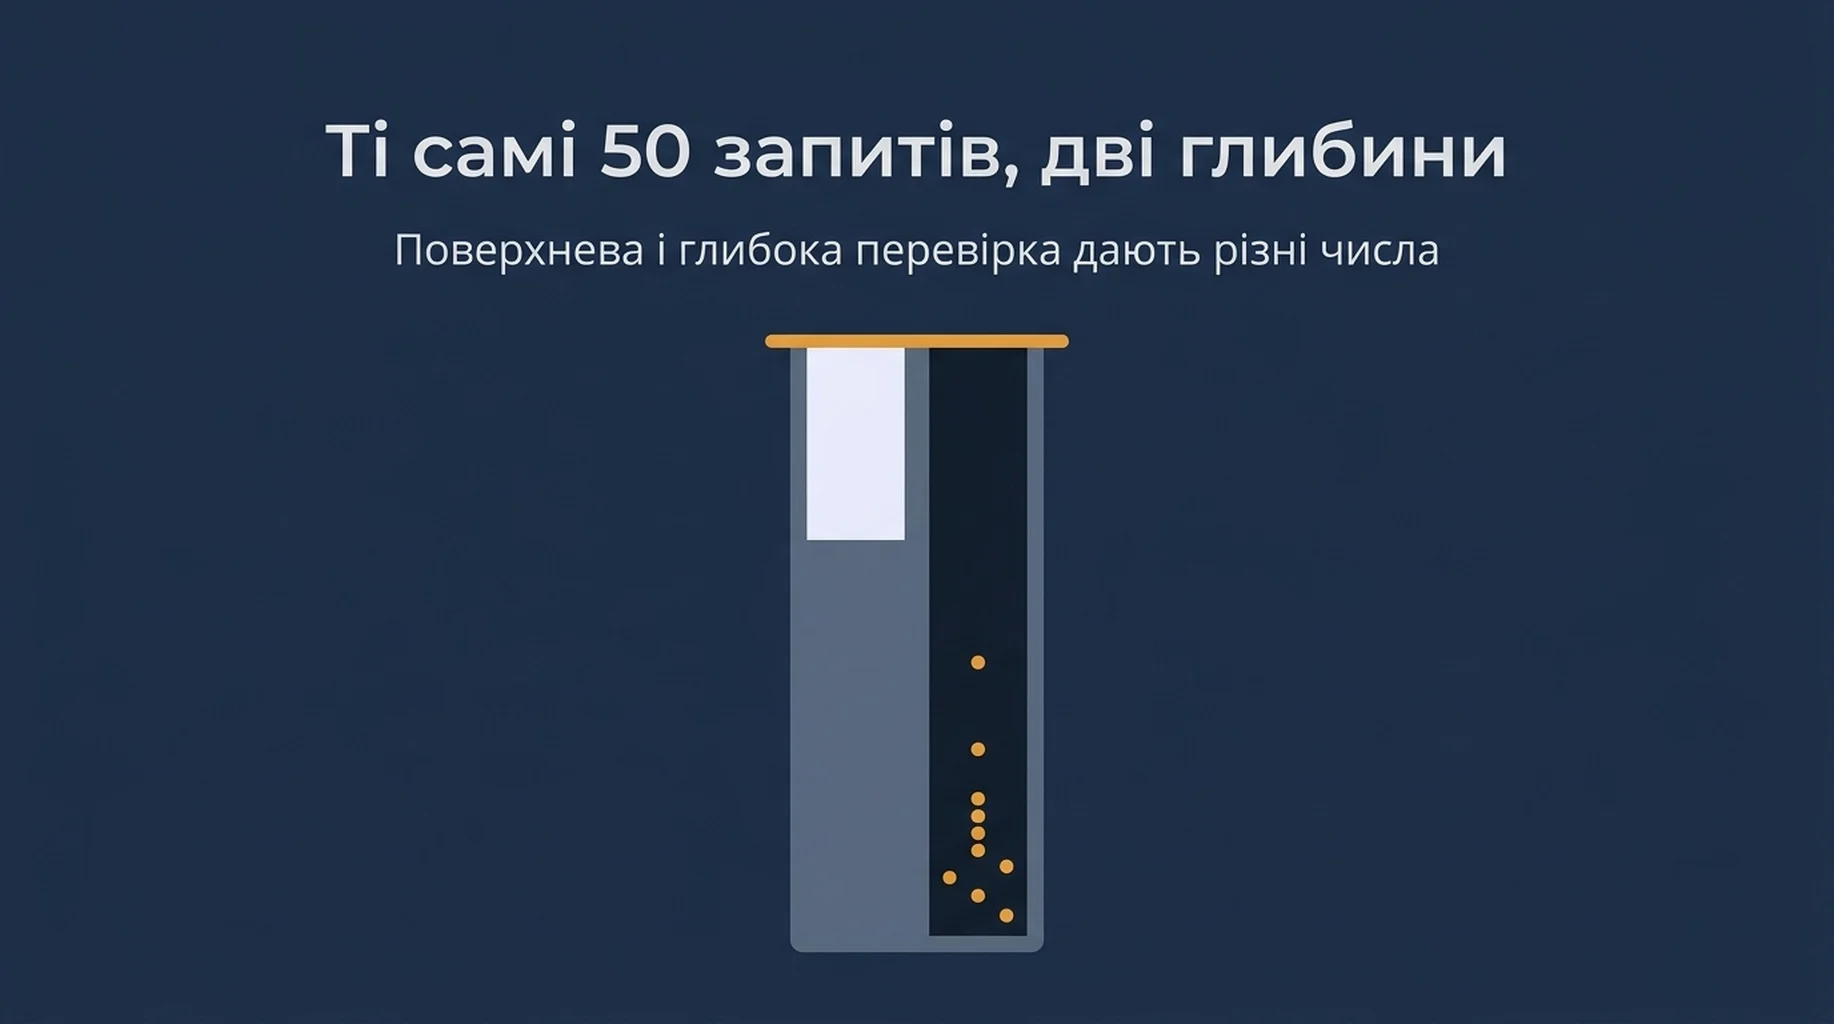
Ми прогнали ті самі 50 ключових фраз двічі підряд 12 вересня 2026 року по тій самій пошуковій системі, локації та пристрою. Різнилася лише глибина.
На глибині 10 перевірка знайшла наш домен за 1 фразою з 50. На глибині 100 вона знайшла його за 22 з них.
Ті самі фрази. Та сама година. Той самий API. Різниця не в точності, бо обидва прогони були точними. Це поле зору, і воно змінює заголовкове число у 22 рази.
Що ми прогнали
П'ятдесят ключових фраз узято з нашого власного списку запитів у Search Console і відфільтровано до запитів латиницею, щоб збігтися з набором результатів для США англійською. Обидва прогони використали живі органічні запити Google у роздільності десктопа, вісім паралельних воркерів і таймаут 300 секунд на запит.
Налаштування | Прогін A | Прогін B |
|---|---|---|
Ключові фрази | 50 | 50 |
Запрошена глибина | 10 | 100 |
Локація та мова | США, англійська | США, англійська |
Пристрій | Десктоп | Десктоп |
Паралельність | 8 | 8 |
Ми фіксували затримку кожного запиту, списану вартість, кількість органічних результатів і те, чи з'явився наш домен.
Результат 1: ті самі фрази, дві різні відповіді
Показник | Глибина 10 | Глибина 100 |
|---|---|---|
Перевірено фраз | 50 | 50 |
Запитів із придатним результатом | 50 | 43 |
Запитів із помилкою | 0 | 7 |
Фраз, де з'явився наш домен | 1 | 22 |
Усередині топ-3 | 1 | 1 |
Усередині топ-20 | 1 | 1 |
Усередині топ-100 | 1 | 20 |
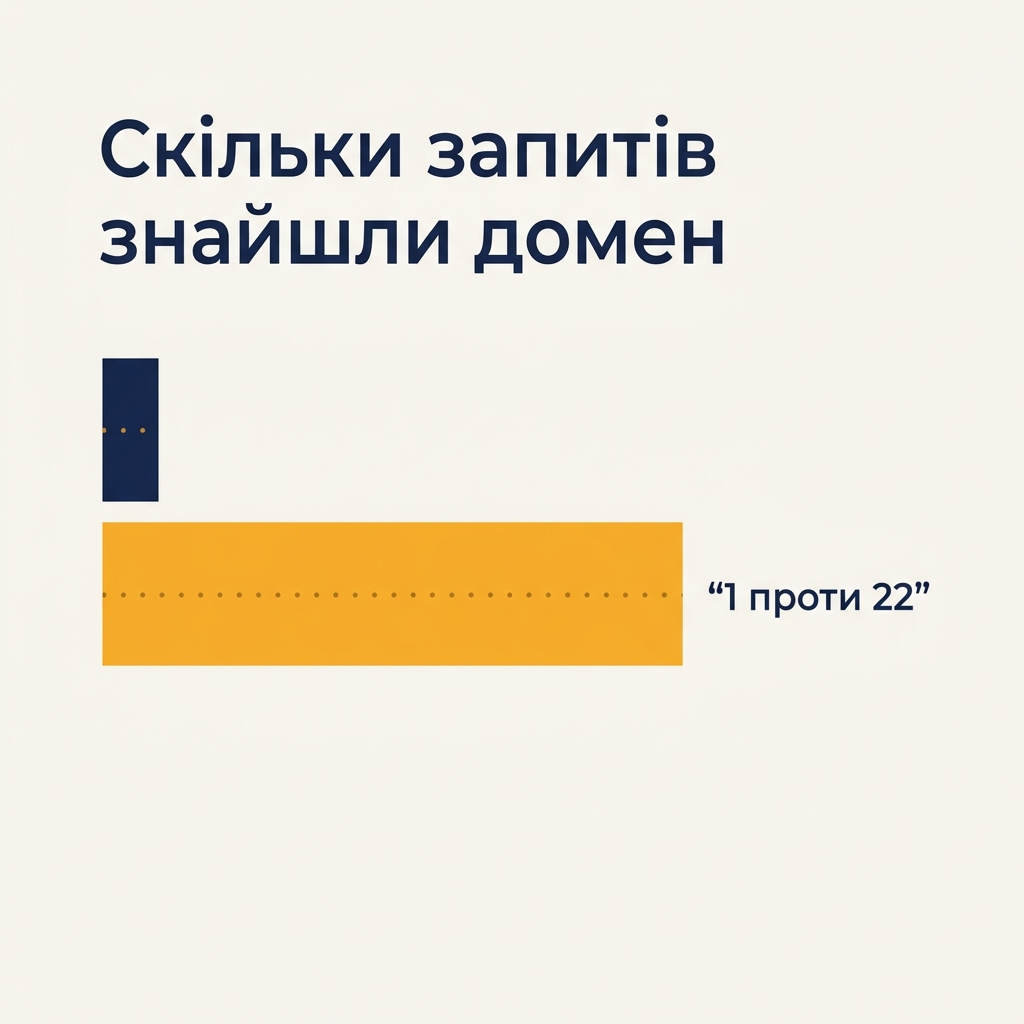
Набір ключових фраз між прогонами не змінювався. Змінилося лише налаштування глибини.
Читайте це уважно, бо форма цього і є весь урок. На глибині 10 наша видимість за цим набором виглядала як 2 відсотки. На глибині 100 вона виглядала як 44 відсотки. Жодне з чисел не хибне, і корисне лише одне.
Картина верху сторінки майже не зрушила. Одна фраза перебувала всередині топ-10 в обох прогонах. Усе, що додала глибока перевірка, лежало між позицією 20 і позицією 100, а це рівно той діапазон, який приховує масовий чекер із налаштуваннями за замовчуванням. Якщо ваш план побудований на чекері, виставленому на першу сторінку, ваш базовий рівень — це не вимірювання вашої видимості. Це вимірювання вашої видимості всередині першої сторінки, і на цьому наборі фраз вони розходяться на 21 фразу.
Невелика додаткова деталь: дві з 22 фраз, знайдених у глибокому прогоні, перебували за абсолютною позицією 100. API віддає трохи далі за запрошену глибину, тож звіт «топ-100» може містити позиції понад 100. Відфільтруйте їх, якщо ця мітка для вас важлива.
Результат 2: вартість зростає з глибиною, приблизно сім до одного
Показник | Глибина 10 | Глибина 100 |
|---|---|---|
Разом списана вартість | $0,1000 | $0,6230 |
Вартість за фразу | $0,0020 | $0,0125 |
Органічних результатів на фразу | близько 12 | близько 97 |
Глибокий прогін коштував у 6,2 раза дорожче за мілкий за ті самі 50 фраз, і ця різниця купила 21 додаткову фразу, за якою з'явився наш домен.
Це співвідношення — чесна відповідь на найчастіше питання про масові чекери: чи варто платити за більше результатів. Варто, якщо ви ранжуєтеся нижче першої сторінки. Якщо ваші фрази тримаються в топ-10, глибокий прогін здебільшого повертає рядки, які ви ніколи не прочитаєте.
Є проміжне налаштування, і зазвичай саме воно правильне. Глибина 20 коштує $0,0035 за фразу в нашому попередньому прайсі — це на 75 відсотків дорожче за глибину 10 і все ще знижка 75 відсотків проти глибини 100. Для сайту в смузі з 20-ї по 50-ту позицію глибина 20 ловить більшу частину корисного руху за частку вартості.
Списана вартість виявилася ще й нижчою за передбачену ціною за фразу, бо сім невдалих запитів не було списано. Це частка збоїв, що проступає в рахунку, і ми ось-ось до неї підійдемо.
Результат 3: звіт також приховує, чи був там AI Overview
Глибина — не єдине, що пропускає звіт лише за позиціями.
Ми фіксували типи елементів SERP за кожним запитом в обох прогонах. У прогоні на глибині 10 48 запитів із 50 повернули AI Overview. У прогоні на глибині 100 це зробили 42 з 43 успішних запитів.
Прогін | Запитів з AI Overview | Перевірено запитів |
|---|---|---|
Глибина 10 | 48 | 50 |
Глибина 100 | 42 | 43 успішних |
Це число здасться хибним кожному, хто читав наш попередній знімок, де AI Overview знайшлися в 4 запитах із 40 на тему SEO. Обидва правильні, і різниця в наборі запитів, а не в методі.
Набір із 40 запитів був списком на тему SEO: інструменти ранжування, аудити, оновлення алгоритму і 15 запитів, що називають інструмент або API. Цей набір із 50 прийшов із нашого списку запитів у Search Console, де переважають довгохвості формулювання про користь і порівняння. Запити, за якими сайт реально отримує покази, за формою відрізняються від запитів, які записує SEO-команда, і присутність AI Overview слідує за формою.
Практичний висновок для масової перевірки вужчий і неприємніший. Масовий чекер позицій повертає позиції. Він не повертає елемент, який тепер сидить над позицією 1, а на наборі запитів, який реально є в нас, цей елемент був присутній у 96 відсотках із них.
Результат 4: час — це затримка, поділена на паралельність
Масова перевірка не миттєва, і причина в затримці запиту, а не в якійсь обробці, яку ви контролюєте.
Показник | Глибина 10 | Глибина 100 |
|---|---|---|
Реальний час за 8 воркерів | 62,0 секунди | 135,9 секунди |
Найшвидший запит | 2,6 секунди | 8,1 секунди |
Медіанний запит | 8,3 секунди | 19,2 секунди |
Найповільніший запит | 22,0 секунди | 40,3 секунди |
Сума часів усіх запитів | 451 секунда | 998 секунд |
Звідси випливають дві речі.
Медіанна затримка зросла з глибиною більш ніж удвічі, з 8,3 до 19,2 секунди. Глибший пошук справді довше збирається, тому масовий чекер із коротким таймаутом клієнта падає на глибоких прогонах, а не на мілких.
Реальний час визначає паралельність, а не швидкість API. Проженіть 50 фраз по одній — перевірка на глибині 10 займе близько 7,5 хвилини; за восьми воркерів вона займе хвилину. Якщо у вашому масовому чекері немає керування паралельністю, це єдине налаштування, про яке варто спитати, бо воно дає восьмикратний виграш у часі без жодної різниці у вартості.
Результат 5: глибокий прогін падав у 14 відсотках випадків
Сім із 50 запитів на глибині 100 завершилися помилкою. Жоден запит на глибині 10 не впав.
Прогін | Збої | Частка збоїв |
|---|---|---|
Глибина 10 | 0 із 50 | 0 відсотків |
Глибина 100 | 7 із 50 | 14 відсотків |
Оскільки невдалі запити не було списано, прогін на глибині 100 обійшовся ще й дешевше за $0,70, які передбачала ціна за фразу, тому ефективна вартість за фразу вийшла $0,0125, а не $0,014.
Це та частина масової перевірки, яку звіти показують рідко. Інструмент, який мовчки повторює спроби, це замаскує. Інструмент, який цього не робить, тихо занижуватиме ваші позиції, а збої купчаться на найповільніших запитах — тих самих глибоких, за які ви платили більше.
Повідомлення про помилку було однакове в усіх семи: завдання завершилося з частковими результатами, частину сторінок не вдалося отримати після кількох повторних спроб, а за сторінки, які не було віддано, списання не було. Це правильна поведінка постачальника, і вона ж — причина, чому масова перевірка занижує результат, а не падає. Сторінка, що впала, — це не фраза, за якою ви не ранжуєтеся. Це невідоме, а звіт, який малює її порожньою коміркою, тихо перетворив невідоме на заперечення.
Якщо ви пишете свій цикл, фіксуйте збої як повноцінний результат, а не викидайте їх, і повторіть збої один раз перед звітом.
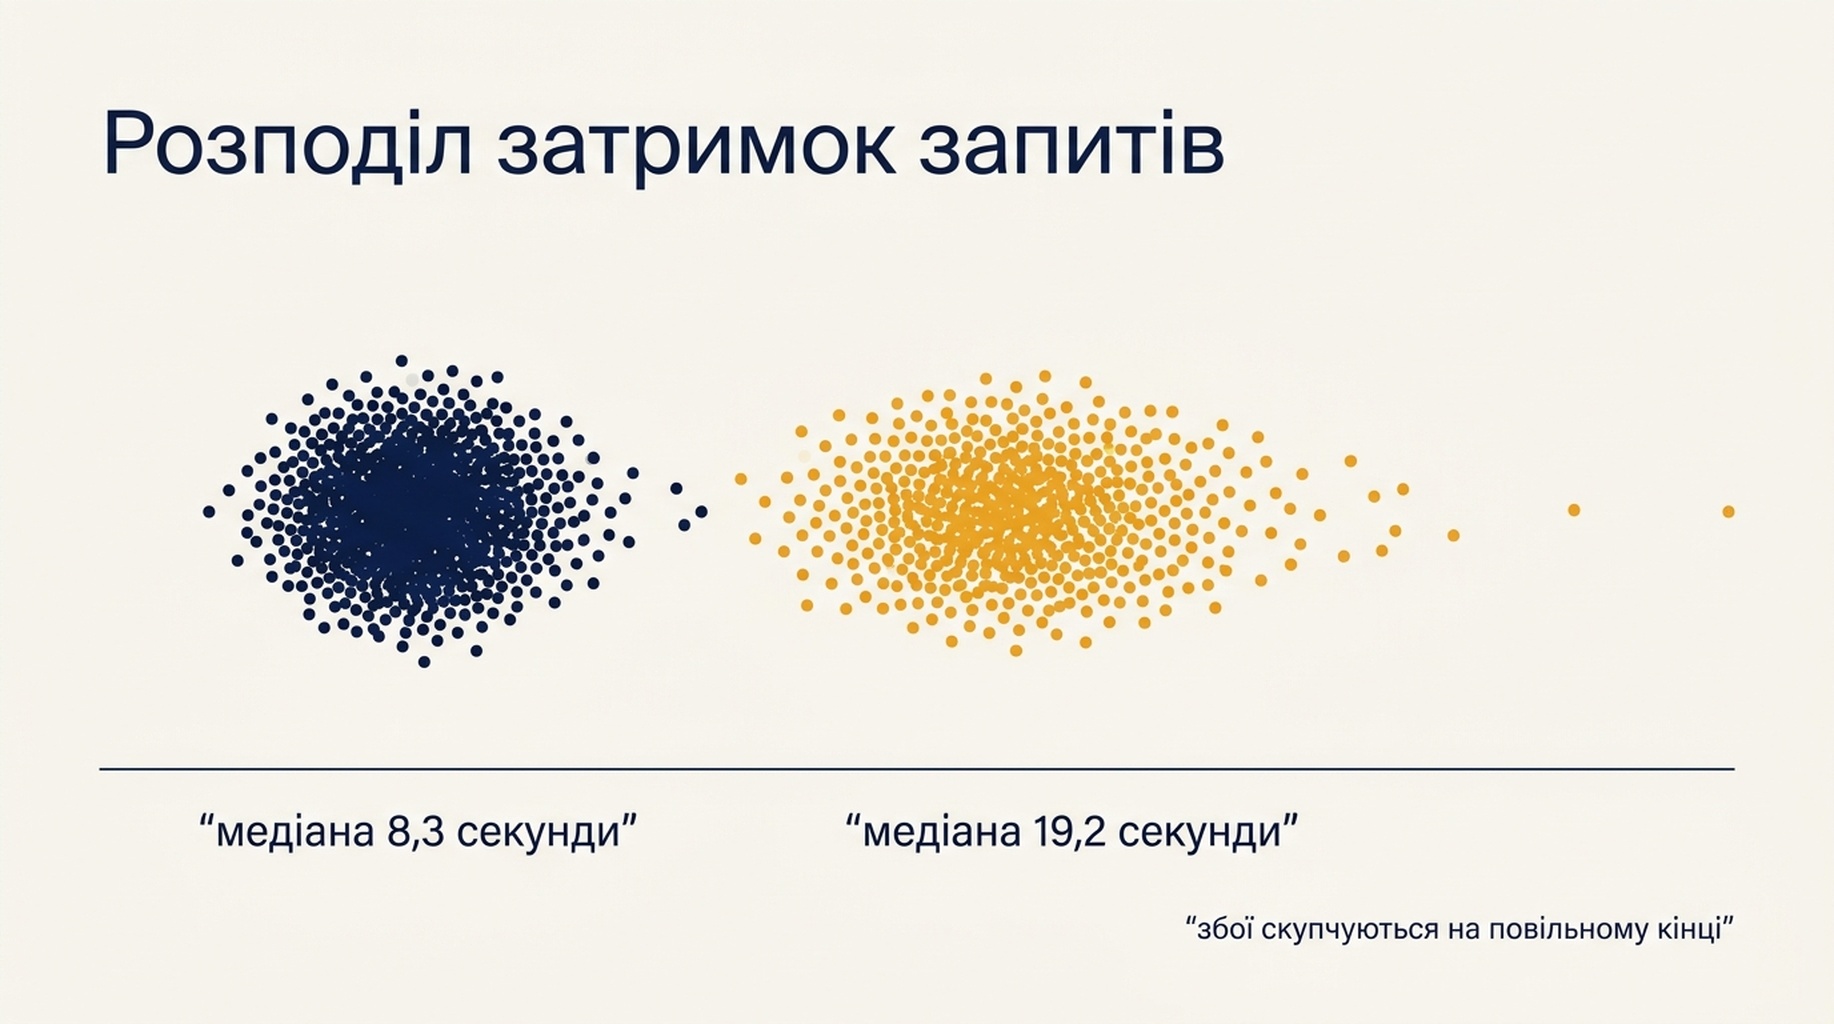
Глибші запити тривають довше, а збої купчаться на повільному кінці розподілу.
Що це означає для числа на вашому дашборді
Ті самі 50 фраз дали два обороноздатні числа видимості, 2 відсотки й 44 відсотки, і розділяло їх лише налаштування глибини. Це розмах більший за більшість змін ранжування, які ви витратите квартал на пояснення.
Звідси три правила.
Ставте глибину від того, де ви ранжуєтеся, а не від того, що типово в інструменті. Спершу вивантажте власний розподіл позицій. Якщо більшість ваших фраз між 20-ю і 60-ю позицією, глибина 10 майже нічого не покаже, і ви дійдете висновку, що маєте проблему з видимістю, якої немає.
Зазначайте глибину поруч із числом. Звіт про ранжування без налаштування глибини не відтворюваний. Те саме стосується локації, мови та пристрою.
Ставтеся до «не знайдено» як до даних, а не як до помилки. Двадцять вісім із 50 фраз не дали результату за нашим доменом на глибині 100, і це чесна відповідь. Чекер, який ховає ці рядки, скорочує ваш список фраз у найменш корисному напрямку.
Перевірте, чи звіт узагалі містить елементи SERP. На цьому наборі фраз AI Overview був присутній у 96 відсотках запитів. Вивантаження лише за позиціями цього показати не може, і жодне налаштування глибини цього не додасть.
Якщо мета — число, яке можна захищати з часом, питання глибини лежить під питанням звітності. Наші нотатки про те, наскільки глибоко Google насправді віддає результати, описують, де межа, запуск власного джерела й живого джерела разом описує конфігурацію, яка тримає вас чесними щодо цього, а що Search Console може сказати такого, чого не може жива перевірка описує ту половину, якої цей прогін узагалі не торкався.
Обмеження
Два обмеження варто назвати.
П'ятдесят фраз з одного ресурсу — це мала вибірка, і розкол 2 відсотки проти 44 відсотків специфічний для сайту, чиї фрази сидять глибоко. Ресурс, що ранжується в топ-10 за більшістю свого списку, майже не побачив би різниці між прогонами і переплачував би за глибину.
Затримка залежить від постачальника, локації та моменту. Абсолютні секунди звідси не перенесуться, але співвідношення між двома глибинами має приблизно зберегтися, бо різниця — це реальна робота, а не мережева варіативність.
Часті питання
Яку глибину використовувати масовому чекеру позицій? Ставте її від власного розподілу позицій. Глибини 10 достатньо, якщо ви в топ-10. Глибина 20 покриває більшу частину практичного діапазону за $0,0035 за фразу. Глибина 100 коштує $0,014 і виправдана лише тоді, коли ви справді відстежуєте позиції нижче 50-ї.
Скільки часу займає перевірка 50 фраз? Близько хвилини за восьми паралельних воркерів для мілкої перевірки і близько 2,3 хвилини для глибокої. За послідовного прогону ті самі перевірки займуть 7,5 і 16,6 хвилини, тож паралельність дає восьмикратний виграш у часі.
Чому глибока перевірка падала частіше? Глибокі запити довше збираються: медіана 19,2 секунди проти 8,3 у мілкому прогоні, тому вони частіше впираються в таймаут клієнта чи постачальника. Фіксуйте збої й повторюйте їх, а не викидайте.
Чи точний масовий чекер, якщо він каже, що моєї фрази не знайдено? Зазвичай так. У нашому прогоні в 28 фраз із 50 справді не було результату за нашим доменом усередині 100 позицій. Перевірте налаштування глибини, перш ніж вважати пропущений рядок проблемою даних.
Перевіряти більше фраз дорожче, ніж перевіряти глибше? Глибина рухає рахунок за фразу, але фрази множать підсумок. Перехід із 50 на 500 фраз на глибині 10 коштує в десять разів дорожче й займає в десять разів більше часу, тоді як глибина 100 коштує в сім разів дорожче за фразу. Оцініть потрібну глибину, а потім купіть стільки фраз, скільки зможете переглянути.
Погляд Auspia: перш ніж змінювати хоч одну сторінку, перевірте налаштування глибини у вашому масовому чекері. Це найдешевше пояснення несподіваного числа видимості, і в нашому тесті воно дало різницю у 22 рази між двома прогонами з різницею в хвилини. Ставте глибину від розподілу позицій, фіксуйте збої й залишайте налаштування у звіті, щоб число наступного кварталу було зіставним.
Автор: Беннетт Хейз, прикладний GEO-аналітик, понад 400 оглядів впроваджень в Auspia. Матеріали про практичне виконання пошуку, вимірювання та деталі, які змінюють звіт.