대량 순위 검사기는 한 가지를 약속한다. 많은 키워드를 하나의 보고서로 묶는 것이다. 그 보고서에 무엇이 담기는지는 대부분의 사람이 바꾸지 않는 한 가지 설정이 거의 결정한다. 검사가 얼마나 깊이 들어가는지다.
우리는 2026년 9월 12일, 같은 50개 키워드를 같은 검색엔진, 같은 지역, 같은 기기로 연달아 두 번 실행했다. 달라진 것은 깊이뿐이었다.
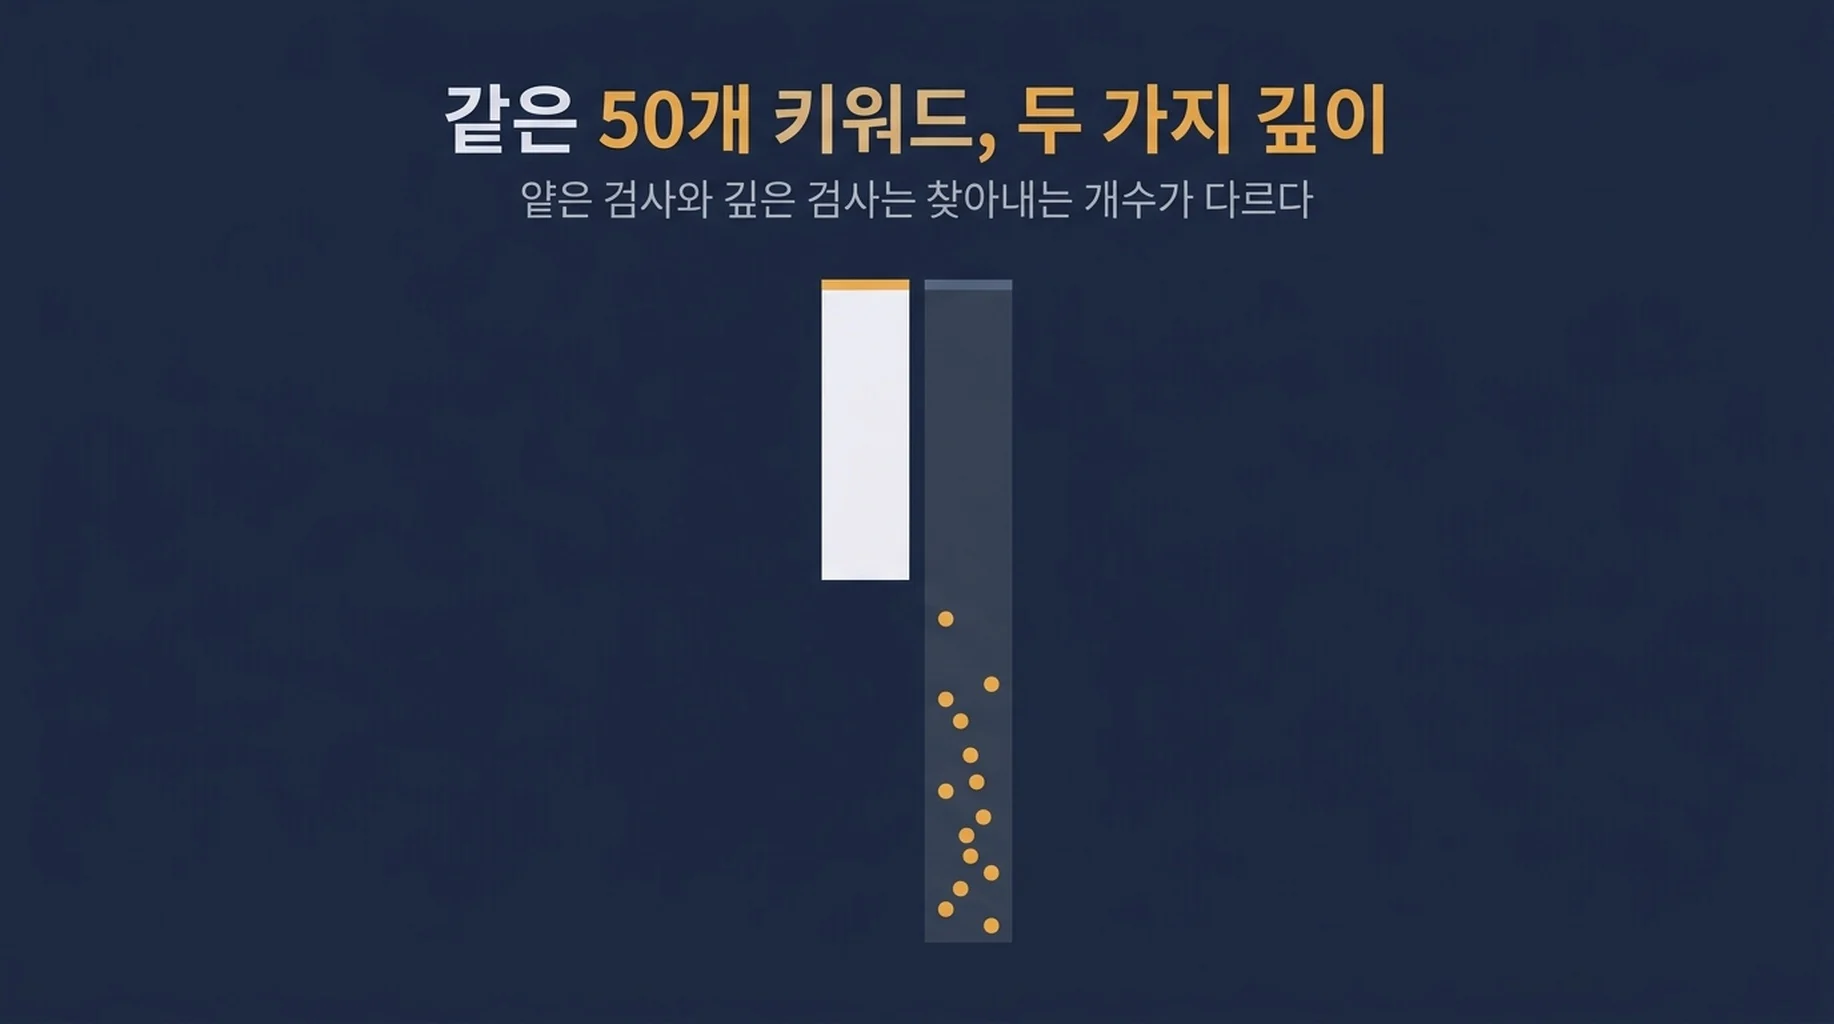
깊이 10에서는 검사가 50개 중 1개 키워드에서 우리 도메인을 찾아냈다. 깊이 100에서는 50개 중 22개에서 찾아냈다.
같은 키워드. 같은 시간대. 같은 API. 이 차이는 정확도가 아니다. 두 실행 모두 정확했다. 이것은 시야의 문제이고, 헤드라인 숫자를 22배 바꾼다.
무엇을 실행했는가
50개 키워드는 우리 자신의 Search Console 쿼리 목록에서 뽑았고, 미국·영어 결과 세트와 맞도록 라틴 문자 쿼리로 걸렀다. 두 실행 모두 데스크톱 해상도의 라이브 Google 유기 결과 요청, 동시 작업자 8개, 요청당 300초 타임아웃을 사용했다.
설정 | 실행 A | 실행 B |
|---|---|---|
키워드 | 50 | 50 |
요청한 깊이 | 10 | 100 |
지역과 언어 | 미국, 영어 | 미국, 영어 |
기기 | 데스크톱 | 데스크톱 |
동시성 | 8 | 8 |
요청별 지연 시간, 청구 비용, 유기 결과 수, 그리고 우리 도메인이 나타났는지를 기록했다.
결과 1: 같은 키워드, 두 개의 다른 답
측정 항목 | 깊이 10 | 깊이 100 |
|---|---|---|
검사한 키워드 | 50 | 50 |
사용 가능한 결과를 반환한 요청 | 50 | 43 |
실패한 요청 | 0 | 7 |
우리 도메인이 나타난 키워드 | 1 | 22 |
상위 3위 이내 | 1 | 1 |
상위 20위 이내 | 1 | 1 |
상위 100위 이내 | 1 | 20 |
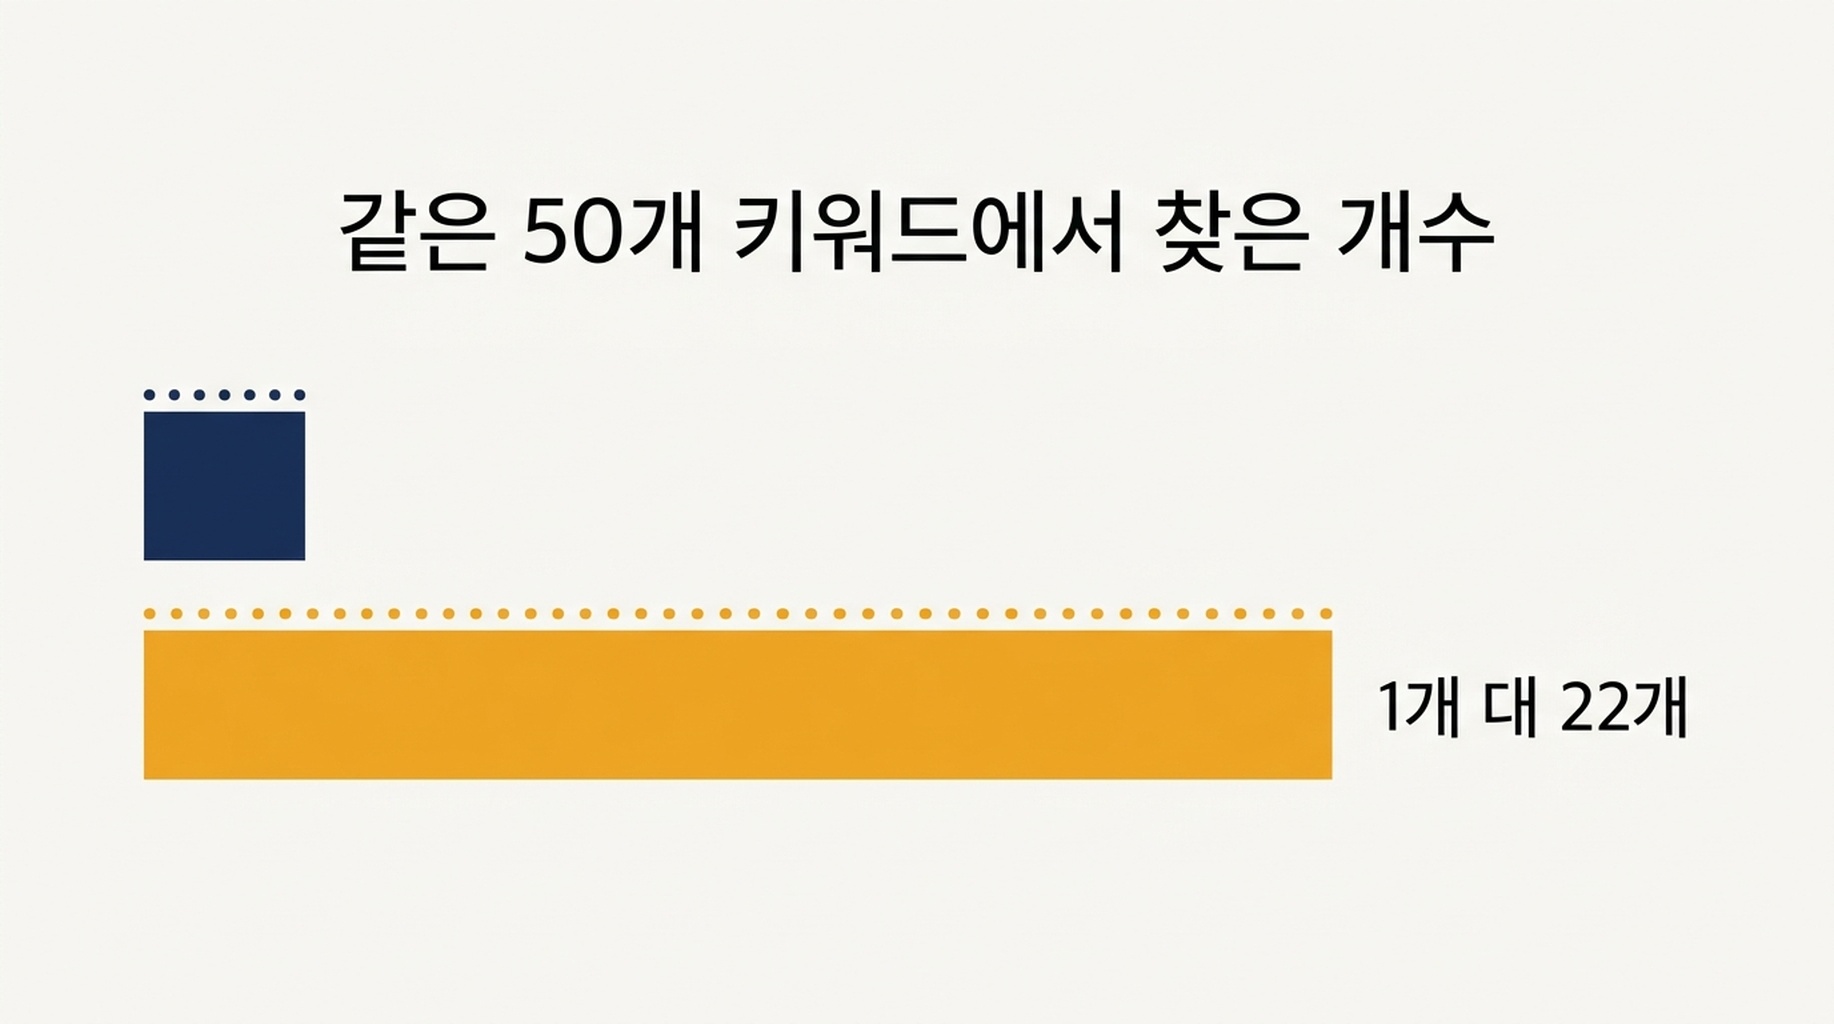
키워드 세트는 두 실행 사이에 변하지 않았다. 바뀐 것은 깊이 설정뿐이다.
이것을 주의 깊게 읽어야 한다. 그 모양 자체가 교훈의 전부이기 때문이다. 깊이 10에서 이 키워드 세트에 대한 우리의 가시성은 2퍼센트로 보였다. 깊이 100에서는 44퍼센트로 보였다. 어느 숫자도 틀리지 않았고, 쓸모 있는 것은 한쪽뿐이다.
페이지 상단의 그림은 거의 움직이지 않았다. 한 개 키워드가 두 실행 모두에서 상위 10위 안에 있었다. 더 깊은 검사가 추가한 것은 모두 20위와 100위 사이에 있었고, 그것이 바로 기본 설정된 대량 검사기가 숨기는 범위다. 첫 페이지로 설정된 순위 검사기 위에 계획을 세웠다면, 그 기준선은 가시성의 측정이 아니다. 첫 페이지 안에서의 가시성 측정이며, 이 키워드 세트에서는 그 차이가 21개 키워드다.
작은 부가 설명 하나. 깊은 실행에서 발견된 22개 중 2개는 절대 순위 100위를 넘어 있었다. API는 요청한 깊이를 조금 넘겨서 반환하므로 "상위 100위" 보고서에 100위 아래의 순위가 들어갈 수 있다. 라벨이 중요하다면 걸러내자.
결과 2: 비용은 깊이에 비례하며 대략 7대 1
측정 항목 | 깊이 10 | 깊이 100 |
|---|---|---|
총 청구 비용 | $0.1000 | $0.6230 |
키워드당 비용 | $0.0020 | $0.0125 |
키워드당 반환된 유기 결과 | 약 12 | 약 97 |
깊이 100 실행은 같은 50개 키워드에 대해 깊이 10 실행의 6.2배 비용이 들었고, 그 차이가 우리 도메인이 나타난 21개 키워드를 사들였다.
이 비율이 대량 검사기에 대해 가장 흔히 나오는 질문에 대한 정직한 답이다. 즉, 더 많은 결과에 돈을 낼 가치가 있는가. 첫 페이지 아래에 순위가 있다면 가치가 있다. 키워드가 상위 10위에 머문다면, 깊은 실행은 끝내 읽지 않을 행을 대부분 반환한다.
중간 설정이 있고, 대개 그것이 정답이다. 깊이 20은 우리의 이전 가격에서 키워드당 $0.0035로, 깊이 10보다 75퍼센트 비싸지만 깊이 100에 대해서는 75퍼센트 할인이다. 20위에서 50위 구간에 있는 사이트라면 깊이 20이 유용한 움직임의 대부분을 훨씬 적은 비용으로 잡는다.
청구 비용은 키워드당 가격이 예측한 것보다 낮기도 했다. 실패한 7개 요청에는 요금이 부과되지 않았기 때문이다. 이것은 실패율이 청구서에 나타난 것이고, 곧 그 이야기로 간다.
결과 3: 보고서는 AI Overview가 있었는지도 숨긴다
순위만 담은 보고서가 빠뜨리는 것은 깊이만이 아니다.
우리는 두 실행의 모든 요청에서 SERP 요소 유형을 기록했다. 깊이 10 실행에서는 50개 쿼리 중 48개가 AI Overview를 반환했다. 깊이 100 실행에서는 성공한 43개 중 42개가 그랬다.
실행 | AI Overview가 있던 쿼리 | 검사한 쿼리 |
|---|---|---|
깊이 10 | 48 | 50 |
깊이 100 | 42 | 성공 43개 |
이 숫자는 우리의 이전 스냅숏을 읽은 사람에게는 틀려 보일 것이다. 그쪽은 40개 SEO 주제 쿼리 중 4개에서 AI Overview를 발견했다. 둘 다 맞고, 차이는 방법이 아니라 쿼리 세트에 있다.
40개 세트는 SEO 주제 목록이었다. 순위 도구, 감사, 알고리즘 업데이트, 그리고 도구나 API를 지목하는 15개 쿼리다. 이 50개 세트는 우리 자신의 Search Console 쿼리 목록에서 왔고, 롱테일 유틸리티 표현과 비교 표현이 대부분이다. 사이트가 실제로 노출을 얻는 쿼리는 SEO 팀이 적어 두는 쿼리와 모양이 다르고, AI Overview의 존재는 그 모양을 따른다.
대량 검사에 대한 실무적 요점은 더 좁고 더 성가시다. 대량 순위 검사기는 순위를 반환한다. 지금 1위 위에 앉아 있는 요소는 반환하지 않는다. 그리고 우리가 실제로 가진 쿼리 세트에서는 그 요소가 96퍼센트의 쿼리에 존재했다.
결과 4: 시간은 지연 시간을 동시성으로 나눈 값
대량 검사는 즉시 끝나지 않으며, 그 이유는 당신이 통제하는 어떤 처리도 아니라 요청 지연 시간에 있다.
측정 항목 | 깊이 10 | 깊이 100 |
|---|---|---|
작업자 8개에서의 실시간 | 62.0초 | 135.9초 |
가장 빠른 요청 | 2.6초 | 8.1초 |
중앙값 요청 | 8.3초 | 19.2초 |
가장 느린 요청 | 22.0초 | 40.3초 |
모든 요청 시간의 합 | 451초 | 998초 |
여기서 두 가지가 나온다.
지연 시간 중앙값은 깊이와 함께 두 배 이상 늘어 8.3초에서 19.2초가 되었다. 더 깊은 검색은 실제로 조립에 시간이 더 걸리고, 그래서 짧은 클라이언트 타임아웃을 가진 대량 검사기는 깊은 실행에서 실패하고 얕은 실행에서는 실패하지 않는다.
실시간을 정하는 것은 API의 속도가 아니라 동시성이다. 50개 키워드를 하나씩 실행하면 깊이 10 검사는 약 7.5분 걸리고, 작업자 8개에서는 1분 걸린다. 당신의 대량 검사기에 동시성 제어가 없다면, 그것이 물어볼 가치가 있는 유일한 설정이다. 비용 차이 없이 경과 시간이 8배 달라지기 때문이다.
결과 5: 깊은 실행은 14퍼센트 실패했다
깊이 100 요청 50개 중 7개가 실패했다. 깊이 10 요청은 하나도 실패하지 않았다.
실행 | 실패 | 실패율 |
|---|---|---|
깊이 10 | 50개 중 0개 | 0퍼센트 |
깊이 100 | 50개 중 7개 | 14퍼센트 |
실패한 요청에는 요금이 부과되지 않았으므로 깊이 100 실행은 키워드당 가격이 예측한 $0.70보다도 저렴했고, 그래서 실효 키워드당 비용이 $0.014가 아니라 $0.0125로 나왔다.
이것이 대량 검사에서 보고서가 좀처럼 보여주지 않는 부분이다. 조용히 재시도하는 도구는 이것을 덮는다. 그렇지 않은 도구는 순위를 조용히 과소 보고한다. 그리고 실패는 가장 느린 요청에 몰린다. 그것이 당신이 추가로 돈을 낸 깊은 쪽이다.
오류 메시지는 7개 모두 동일했다. 작업이 부분 결과로 완료되었고, 일부 페이지는 여러 번 재시도한 뒤에도 가져올 수 없었으며, 반환되지 않은 페이지에는 요금이 부과되지 않았다는 것이다. 이것은 제공자로서 올바른 동작이며, 대량 검사가 충돌하지 않고 과소 보고하는 이유이기도 하다. 실패한 페이지는 당신이 순위에 없는 키워드가 아니다. 그것은 미지이고, 그것을 빈 셀로 그려내는 보고서는 미지를 조용히 부정으로 바꾼 것이다.
직접 루프를 만든다면 실패를 일급 결과로 기록하고 버리지 말며, 보고 전에 한 번 재시도하라.
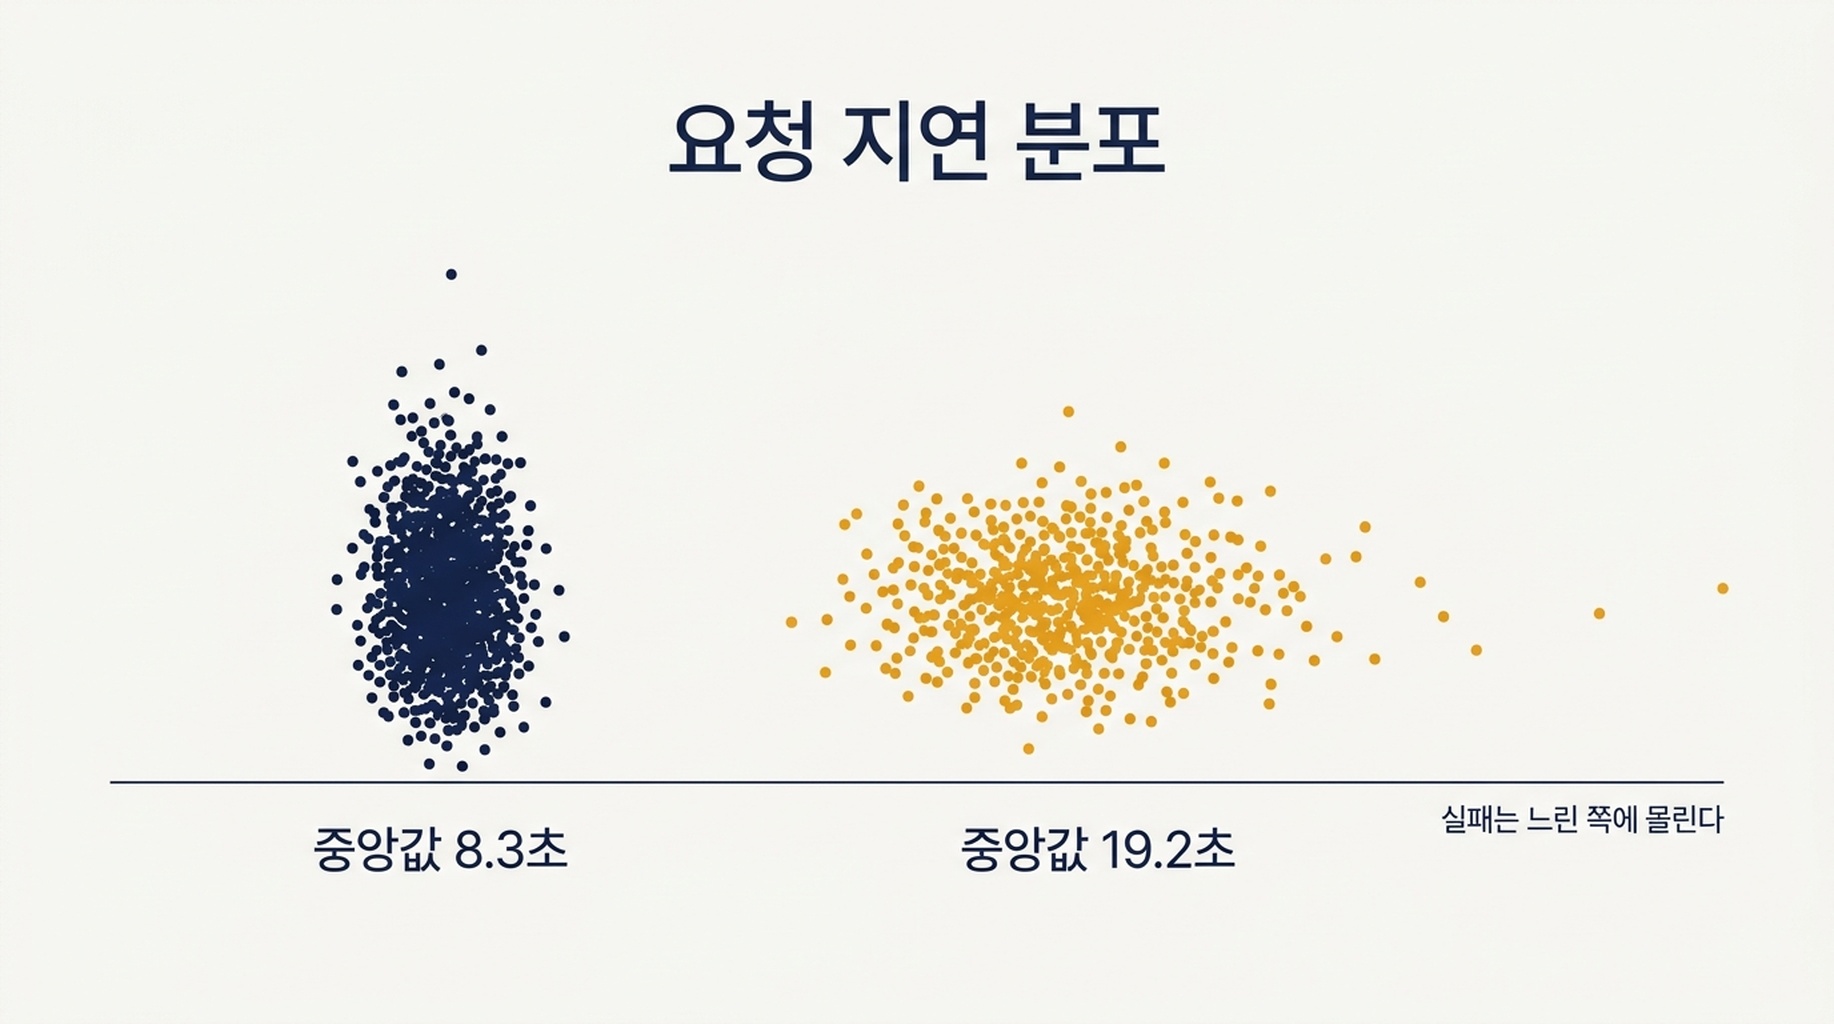
깊은 요청은 더 오래 걸리고, 실패는 분포의 느린 끝에 몰린다.
대시보드의 숫자에 이것이 의미하는 것
같은 50개 키워드가 두 개의 방어 가능한 가시성 수치, 2퍼센트와 44퍼센트를 만들어냈고, 이를 갈라놓은 것은 깊이 설정뿐이었다. 이것은 한 분기를 들여 설명하려 할 대부분의 순위 변동보다 큰 폭이다.
여기서 세 가지 규칙이 나온다.
깊이는 도구의 기본값이 아니라 당신이 순위에 있는 위치에서 정하라. 먼저 자신의 순위 분포를 뽑아라. 키워드 대부분이 20위와 60위 사이에 있다면 깊이 10은 거의 아무것도 보고하지 않을 것이고, 당신은 갖지도 않은 가시성 문제가 있다고 결론 내리게 된다.
숫자와 함께 깊이를 보고하라. 깊이 설정이 없는 순위 보고서는 재현할 수 없다. 지역, 언어, 기기도 마찬가지다.
"찾을 수 없음"을 오류가 아니라 데이터로 다뤄라. 50개 키워드 중 28개는 깊이 100에서도 우리 도메인의 결과를 반환하지 않았고, 그것이 정직한 답이다. 그 행을 숨기는 검사기는 당신의 키워드 목록을 가장 쓸모없는 방향으로 줄이고 있다.
보고서가 SERP 기능을 아예 포함하는지 확인하라. 이 키워드 세트에서는 AI Overview가 쿼리의 96퍼센트에 있었다. 순위만 있는 내보내기는 그것을 보여줄 수 없고, 어떤 깊이 설정도 그것을 더하지 않는다.
시간이 지나도 방어할 수 있는 숫자를 원한다면, 깊이 문제는 보고 문제 아래에 있다. Google이 실제로 얼마나 아래까지 결과를 제공하는지에 대한 우리 메모는 상한이 어디인지를 다루고, 퍼스트파티와 라이브 소스를 함께 돌리는 것은 그것에 대해 정직을 유지하는 구성을 다루며, Search Console이 라이브 검사가 못 하는 무엇을 알려주는지는 이번 실행이 건드리지 않은 절반을 다룬다.
한계
두 가지 한계를 밝혀 둔다.
한 속성에서 나온 50개 키워드는 작은 표본이고, 2퍼센트 대 44퍼센트라는 갈림은 키워드가 깊은 위치에 있는 사이트에 특정된 것이다. 목록 대부분에서 상위 10위에 있는 속성이라면 두 실행 사이에 거의 차이를 보지 못할 것이고, 깊이에 과하게 지불하고 있는 셈이다.
지연 시간은 제공자, 지역, 그 순간에 달려 있다. 여기의 절대 초는 옮겨지지 않지만, 두 깊이 사이의 비율은 대략 유지될 것이다. 차이가 네트워크 변동이 아니라 실제 작업이기 때문이다.
자주 묻는 질문
대량 순위 검사기는 어느 깊이를 써야 하는가? 자신의 순위 분포에서 정하라. 상위 10위에 순위가 있다면 깊이 10으로 충분하다. 깊이 20은 키워드당 $0.0035로 실용적인 범위의 대부분을 덮는다. 깊이 100은 $0.014가 들고 50위 아래를 정말로 추적할 때만 가치가 있다.
50개 키워드를 검사하는 데 얼마나 걸리는가? 동시 작업자 8개에서 얕은 검사는 약 1분, 깊은 검사는 약 2.3분이다. 직렬로 실행하면 같은 검사에 7.5분과 16.6분이 걸리므로, 동시성은 경과 시간에서 8배의 가치가 있다.
왜 더 깊은 검사가 더 자주 실패했는가? 깊은 요청은 조립에 더 오래 걸려 중앙값이 얕은 실행의 8.3초에 대해 19.2초이므로, 클라이언트나 제공자 타임아웃에 부딪히기 쉽다. 실패는 버리지 말고 기록하고 재시도하라.
키워드가 발견되지 않는다고 말하는 대량 순위 검사기는 정확한가? 대개 그렇다. 우리 실행에서는 50개 중 28개가 100위 안에 우리 도메인의 결과가 정말로 없었다. 빠진 행을 데이터 문제로 다루기 전에 깊이 설정을 확인하라.
키워드를 더 많이 검사하는 것이 더 깊게 검사하는 것보다 비싼가? 깊이는 키워드당 청구서를 움직이지만, 키워드는 총액을 배로 만든다. 50개에서 500개로 깊이 10에서 늘리면 10배의 비용과 10배의 시간이 들고, 깊이 100은 키워드당 7배의 비용이 든다. 필요한 깊이에 값을 매기고, 그다음 검토할 수 있는 키워드 수를 사라.
Auspia 관점: 페이지를 하나라도 바꾸기 전에 대량 검사기의 깊이 설정을 확인하라. 놀라운 가시성 숫자에 대한 가장 싼 설명이고, 우리 테스트에서는 몇 분 간격의 두 실행 사이에 22배 차이를 만들어냈다. 깊이는 순위 분포에서 정하고, 실패를 기록하고, 설정을 보고서에 남겨 다음 분기의 숫자가 비교 가능하도록 하라.
글: Bennett Hayes, Auspia에서 400건 이상의 구현 리뷰를 담당하는 응용 GEO 분석가. 실무적인 검색 실행, 측정, 그리고 보고서를 바꾸는 세부 사항에 대해 씁니다.