เครื่องมือตรวจอันดับแบบเป็นชุดสัญญาสิ่งเดียว: คำค้นจำนวนมากในรายงานเดียว และสิ่งที่อยู่ในรายงานนั้นแทบจะถูกกำหนดทั้งหมดโดยการตั้งค่าหนึ่งที่แทบไม่มีใครเปลี่ยน นั่นคือความลึกที่การตรวจไล่ลงไป
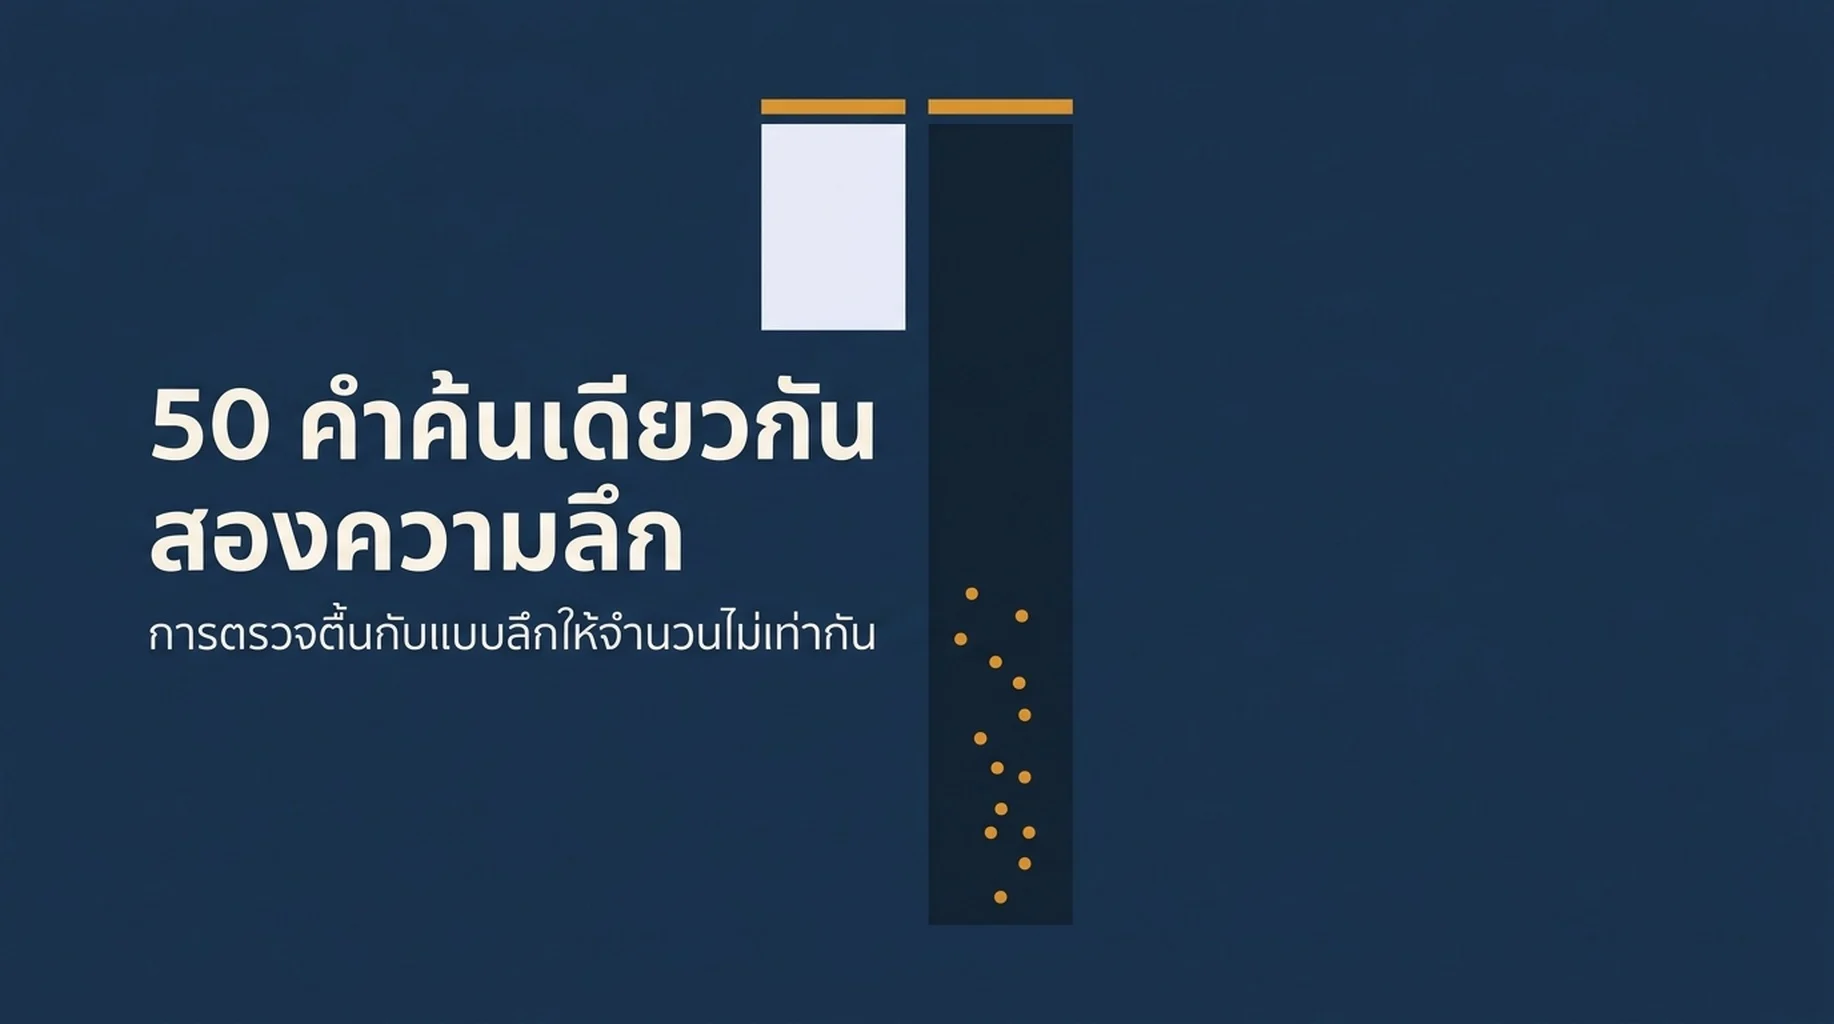
เรารันคำค้น 50 คำเดียวกันสองครั้งติดกันเมื่อวันที่ 12 กันยายน 2026 กับเสิร์ชเอนจินเดียวกัน ตำแหน่งทางภูมิศาสตร์เดียวกัน และอุปกรณ์เดียวกัน สิ่งเดียวที่ต่างคือความลึก
ที่ความลึก 10 การตรวจพบโดเมนของเราใน 1 คำค้นจาก 50 คำ ที่ความลึก 100 พบใน 22 คำ
คำค้นเดียวกัน ชั่วโมงเดียวกัน API เดียวกัน ความต่างนี้ไม่ใช่ความแม่นยำ เพราะทั้งสองรอบแม่นยำทั้งคู่ มันคือขอบเขตการมองเห็น และมันเปลี่ยนตัวเลขพาดหัวไป 22 เท่า
เรารันอะไร
คำค้น 50 คำดึงมาจากรายการคำค้นของเราเองใน Search Console และกรองให้เหลือคำค้นที่เป็นตัวอักษรละตินเพื่อให้ตรงกับชุดผลลัพธ์ของสหรัฐอเมริกาภาษาอังกฤษ ทั้งสองรอบใช้คำขอผลลัพธ์ออร์แกนิกสดของ Google ที่ความละเอียดเดสก์ท็อป เวิร์กเกอร์พร้อมกันแปดตัว และหมดเวลา 300 วินาทีต่อคำขอ
การตั้งค่า | รอบ A | รอบ B |
|---|---|---|
คำค้น | 50 | 50 |
ความลึกที่ร้องขอ | 10 | 100 |
ตำแหน่งและภาษา | สหรัฐอเมริกา อังกฤษ | สหรัฐอเมริกา อังกฤษ |
อุปกรณ์ | เดสก์ท็อป | เดสก์ท็อป |
การทำงานพร้อมกัน | 8 | 8 |
เราบันทึกความหน่วงต่อคำขอ ต้นทุนที่เรียกเก็บ จำนวนผลลัพธ์ออร์แกนิก และว่าโดเมนของเราปรากฏหรือไม่
ผลที่ 1: คำค้นเดียวกัน สองคำตอบที่ต่างกัน
ตัววัด | ความลึก 10 | ความลึก 100 |
|---|---|---|
คำค้นที่ตรวจ | 50 | 50 |
คำขอที่คืนผลลัพธ์ใช้ได้ | 50 | 43 |
คำขอที่ล้มเหลว | 0 | 7 |
คำค้นที่โดเมนของเราปรากฏ | 1 | 22 |
อยู่ใน 3 อันดับแรก | 1 | 1 |
อยู่ใน 20 อันดับแรก | 1 | 1 |
อยู่ใน 100 อันดับแรก | 1 | 20 |
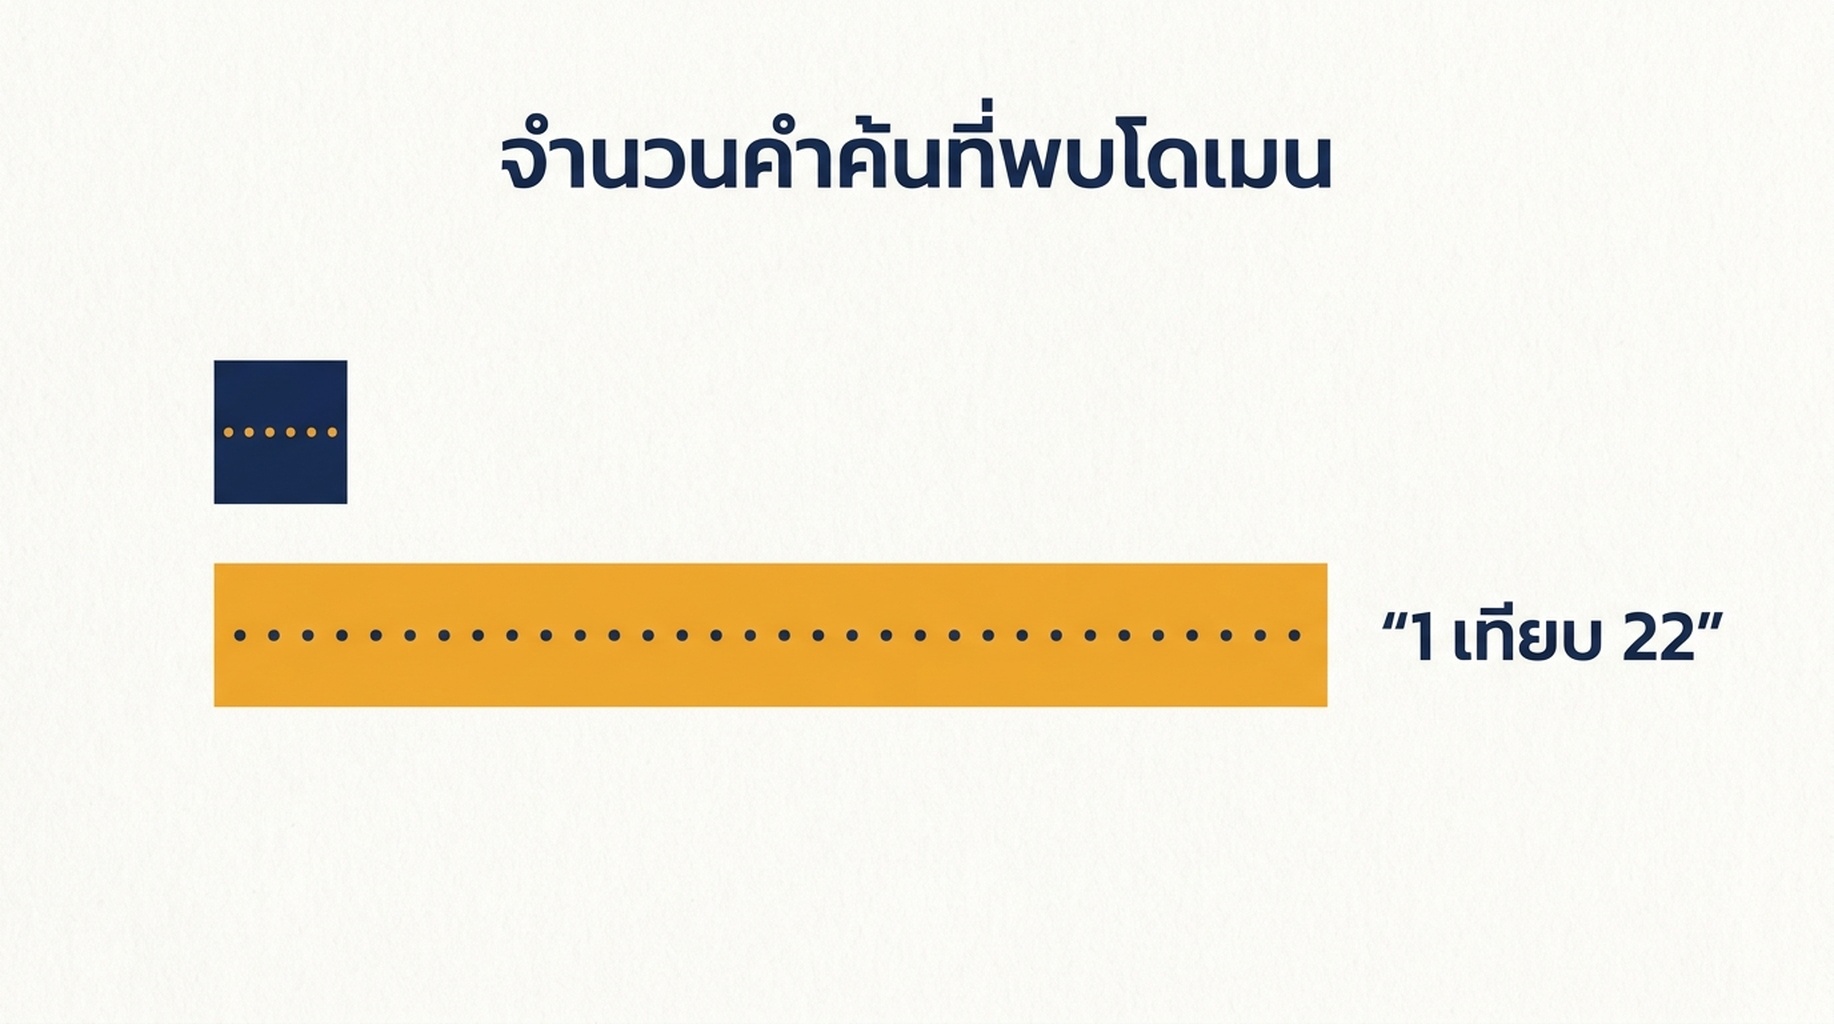
ชุดคำค้นไม่เปลี่ยนไประหว่างสองรอบ สิ่งเดียวที่เปลี่ยนคือการตั้งค่าความลึก
อ่านตรงนี้ให้ดี เพราะรูปทรงของมันคือบทเรียนทั้งหมด ที่ความลึก 10 การปรากฏของเราในชุดคำค้นนี้ดูเหมือน 2 เปอร์เซ็นต์ ที่ความลึก 100 ดูเหมือน 44 เปอร์เซ็นต์ ไม่มีตัวเลขไหนผิด และมีเพียงตัวเดียวที่ใช้ประโยชน์ได้
ภาพที่ด้านบนของหน้าแทบไม่ขยับ มีหนึ่งคำค้นที่อยู่ใน 10 อันดับแรกทั้งสองรอบ ทุกอย่างที่การตรวจแบบลึกเพิ่มเข้ามาอยู่ระหว่างอันดับ 20 กับอันดับ 100 ซึ่งเป็นช่วงที่เครื่องมือตรวจอันดับแบบเป็นชุดที่ตั้งค่าเริ่มต้นซ่อนไว้พอดี ถ้าแผนของคุณตั้งอยู่บนเครื่องมือตรวจอันดับที่ตั้งไว้ที่หน้าแรก ฐานอ้างอิงของคุณไม่ใช่การวัดการปรากฏของคุณ มันคือการวัดการปรากฏของคุณภายในหน้าแรก และในชุดคำค้นนี้สองสิ่งนั้นต่างกัน 21 คำค้น
รายละเอียดเล็ก ๆ เพิ่มเติม: สองใน 22 คำค้นที่พบในรอบลึกอยู่เลยอันดับสมบูรณ์ 100 ไป API คืนผลลึกเกินความลึกที่ร้องขอไปเล็กน้อย รายงาน "100 อันดับแรก" จึงมีอันดับที่เกิน 100 ได้ กรองออกถ้าป้ายกำกับนี้สำคัญกับคุณ
ผลที่ 2: ต้นทุนเพิ่มตามความลึก ประมาณเจ็ดต่อหนึ่ง
ตัววัด | ความลึก 10 | ความลึก 100 |
|---|---|---|
ต้นทุนที่เรียกเก็บรวม | $0.1000 | $0.6230 |
ต้นทุนต่อคำค้น | $0.0020 | $0.0125 |
ผลลัพธ์ออร์แกนิกที่คืนต่อคำค้น | ประมาณ 12 | ประมาณ 97 |
รอบความลึก 100 มีต้นทุน 6.2 เท่าของรอบความลึก 10 สำหรับคำค้น 50 คำเดียวกัน และส่วนต่างนั้นซื้อ 21 คำค้นเพิ่มเติมที่โดเมนของเราปรากฏ
อัตราส่วนนี้คือคำตอบที่ซื่อตรงต่อคำถามที่ถูกถามบ่อยที่สุดเกี่ยวกับเครื่องมือตรวจแบบเป็นชุด นั่นคือคุ้มไหมที่จะจ่ายเพื่อผลลัพธ์ที่มากขึ้น คุ้มถ้าคุณมีอันดับต่ำกว่าหน้าแรก ถ้าคำค้นของคุณอยู่ใน 10 อันดับแรก รอบที่ลึกกว่าจะคืนแถวที่คุณจะไม่มีวันอ่านเป็นส่วนใหญ่
มีการตั้งค่ากลาง และโดยปกติมันคือค่าที่ถูก ตามราคาก่อนหน้าของเรา ความลึก 20 อยู่ที่ $0.0035 ต่อคำค้น แพงกว่าความลึก 10 อยู่ 75 เปอร์เซ็นต์ แต่ยังเป็นส่วนลด 75 เปอร์เซ็นต์เทียบกับความลึก 100 สำหรับไซต์ที่อยู่ในช่วงอันดับ 20 ถึง 50 ความลึก 20 จับความเคลื่อนไหวที่มีประโยชน์ส่วนใหญ่ได้ในเศษเสี้ยวของต้นทุน
ต้นทุนที่เรียกเก็บยังต่ำกว่าที่ราคาต่อคำค้นทำนายไว้ด้วย เพราะคำขอที่ล้มเหลวเจ็ดรายการไม่ถูกเรียกเก็บ นั่นคืออัตราความล้มเหลวที่โผล่มาในใบแจ้งหนี้ และเรากำลังจะไปถึงเรื่องนั้น
ผลที่ 3: รายงานยังซ่อนว่ามี AI Overview อยู่หรือไม่
ความลึกไม่ใช่สิ่งเดียวที่รายงานแบบมีแต่ตำแหน่งละไว้
เราบันทึกประเภทองค์ประกอบ SERP ในทุกคำขอของการรันทั้งสองรอบ ในรอบความลึก 10 มี 48 คำค้นจาก 50 คำที่คืน AI Overview ในรอบความลึก 100 มี 42 จาก 43 คำขอที่สำเร็จ
รอบ | คำค้นที่มี AI Overview | คำค้นที่ตรวจ |
|---|---|---|
ความลึก 10 | 48 | 50 |
ความลึก 100 | 42 | 43 คำขอที่สำเร็จ |
ตัวเลขนี้จะดูผิดสำหรับใครก็ตามที่อ่านสแนปช็อตก่อนหน้าของเรา ซึ่งพบ AI Overview ใน 4 จาก 40 คำค้นหัวข้อ SEO ทั้งสองถูกต้อง และความต่างอยู่ที่ชุดคำค้นไม่ใช่วิธีการ
ชุด 40 คำค้นนั้นเป็นรายการหัวข้อ SEO ทั้งเครื่องมือจัดอันดับ การตรวจสอบ การอัปเดตอัลกอริทึม และคำค้น 15 คำที่ระบุชื่อเครื่องมือหรือ API ส่วนชุด 50 คำค้นนี้มาจากรายการคำค้นของเราเองใน Search Console ซึ่งเต็มไปด้วยถ้อยคำแนวประโยชน์ใช้สอยและการเปรียบเทียบแบบหางยาว คำค้นที่ไซต์ได้รับการแสดงผลจริงนั้นมีรูปทรงต่างจากคำค้นที่ทีม SEO จดลงไป และการมีอยู่ของ AI Overview ก็ตามรูปทรงนั้น
ประเด็นปฏิบัติสำหรับการตรวจแบบเป็นชุดนั้นแคบกว่าและน่ารำคาญกว่า เครื่องมือตรวจอันดับแบบเป็นชุดคืนตำแหน่ง มันไม่คืนองค์ประกอบที่ตอนนี้นั่งอยู่เหนืออันดับ 1 และในชุดคำค้นที่เรามีจริง องค์ประกอบนั้นมีอยู่ใน 96 เปอร์เซ็นต์ของคำค้น
ผลที่ 4: เวลาคือความหน่วงหารด้วยการทำงานพร้อมกัน
การตรวจแบบเป็นชุดไม่ใช่เรื่องทันที และเหตุผลคือความหน่วงของคำขอ ไม่ใช่การประมวลผลใด ๆ ที่คุณควบคุมได้
ตัววัด | ความลึก 10 | ความลึก 100 |
|---|---|---|
เวลาจริงที่เวิร์กเกอร์ 8 ตัว | 62.0 วินาที | 135.9 วินาที |
คำขอที่เร็วที่สุด | 2.6 วินาที | 8.1 วินาที |
คำขอค่ามัธยฐาน | 8.3 วินาที | 19.2 วินาที |
คำขอที่ช้าที่สุด | 22.0 วินาที | 40.3 วินาที |
ผลรวมเวลาคำขอทั้งหมด | 451 วินาที | 998 วินาที |
มีสองสิ่งหลุดออกมาจากตรงนี้
ความหน่วงค่ามัธยฐานเพิ่มขึ้นกว่าสองเท่าตามความลึก จาก 8.3 เป็น 19.2 วินาที การค้นที่ลึกกว่าประกอบผลช้าลงจริง และนั่นคือเหตุผลที่เครื่องมือตรวจแบบเป็นชุดที่ตั้งไทม์เอาต์ฝั่งไคลเอนต์สั้น ๆ ล้มเหลวในรอบลึกแต่ไม่ล้มเหลวในรอบตื้น
เวลาจริงถูกกำหนดโดยการทำงานพร้อมกัน ไม่ใช่โดยความเร็วของ API รันคำค้น 50 คำทีละคำ การตรวจความลึก 10 จะใช้เวลาประมาณ 7.5 นาที ที่เวิร์กเกอร์แปดตัวใช้เวลาหนึ่งนาที ถ้าเครื่องมือตรวจแบบเป็นชุดของคุณไม่มีการควบคุมการทำงานพร้อมกัน นั่นคือการตั้งค่าเดียวที่ควรถามถึง เพราะมันมีค่าเท่ากับแปดเท่าในเวลาโดยไม่ต่างเรื่องต้นทุน
ผลที่ 5: รอบที่ลึกกว่าล้มเหลว 14 เปอร์เซ็นต์
เจ็ดใน 50 คำขอที่ความลึก 100 ล้มเหลว ไม่มีคำขอความลึก 10 รายการใดล้มเหลวเลย
รอบ | ความล้มเหลว | อัตราความล้มเหลว |
|---|---|---|
ความลึก 10 | 0 จาก 50 | 0 เปอร์เซ็นต์ |
ความลึก 100 | 7 จาก 50 | 14 เปอร์เซ็นต์ |
เนื่องจากคำขอที่ล้มเหลวไม่ถูกเรียกเก็บ รอบความลึก 100 จึงมีต้นทุนต่ำกว่า $0.70 ที่ราคาต่อคำค้นทำนายไว้ด้วย ซึ่งเป็นเหตุผลที่ต้นทุนต่อคำค้นที่แท้จริงออกมาที่ $0.0125 ไม่ใช่ $0.014
นี่คือส่วนของการตรวจแบบเป็นชุดที่รายงานแทบไม่แสดง เครื่องมือที่ลองใหม่เงียบ ๆ จะกลบมันไว้ เครื่องมือที่ไม่ทำเช่นนั้นจะรายงานอันดับของคุณต่ำกว่าจริงอย่างเงียบ ๆ และความล้มเหลวกระจุกตัวอยู่ที่คำขอที่ช้าที่สุด ซึ่งคือคำขอแบบลึกที่คุณจ่ายเพิ่มไป
ข้อความข้อผิดพลาดเหมือนกันทั้งเจ็ดรายการ: งานเสร็จสิ้นพร้อมผลลัพธ์บางส่วน บางหน้าไม่สามารถดึงได้หลังจากพยายามซ้ำหลายครั้ง และหน้าที่ไม่ถูกคืนนั้นไม่ถูกเรียกเก็บ นั่นคือพฤติกรรมที่ถูกต้องจากผู้ให้บริการ และเป็นเหตุผลที่การตรวจแบบเป็นชุดรายงานต่ำกว่าจริงแทนที่จะล่ม หน้าที่ล้มเหลวไม่ใช่คำค้นที่คุณไม่มีอันดับ มันคือค่าที่ไม่รู้ และรายงานที่วาดมันเป็นช่องว่างได้แปลงค่าที่ไม่รู้ให้เป็นค่าปฏิเสธไปอย่างเงียบ ๆ
ถ้าคุณสร้างลูปเอง ให้บันทึกความล้มเหลวเป็นผลลัพธ์ระดับแรกแทนที่จะทิ้งไป และลองใหม่กับความล้มเหลวสักครั้งก่อนออกรายงาน
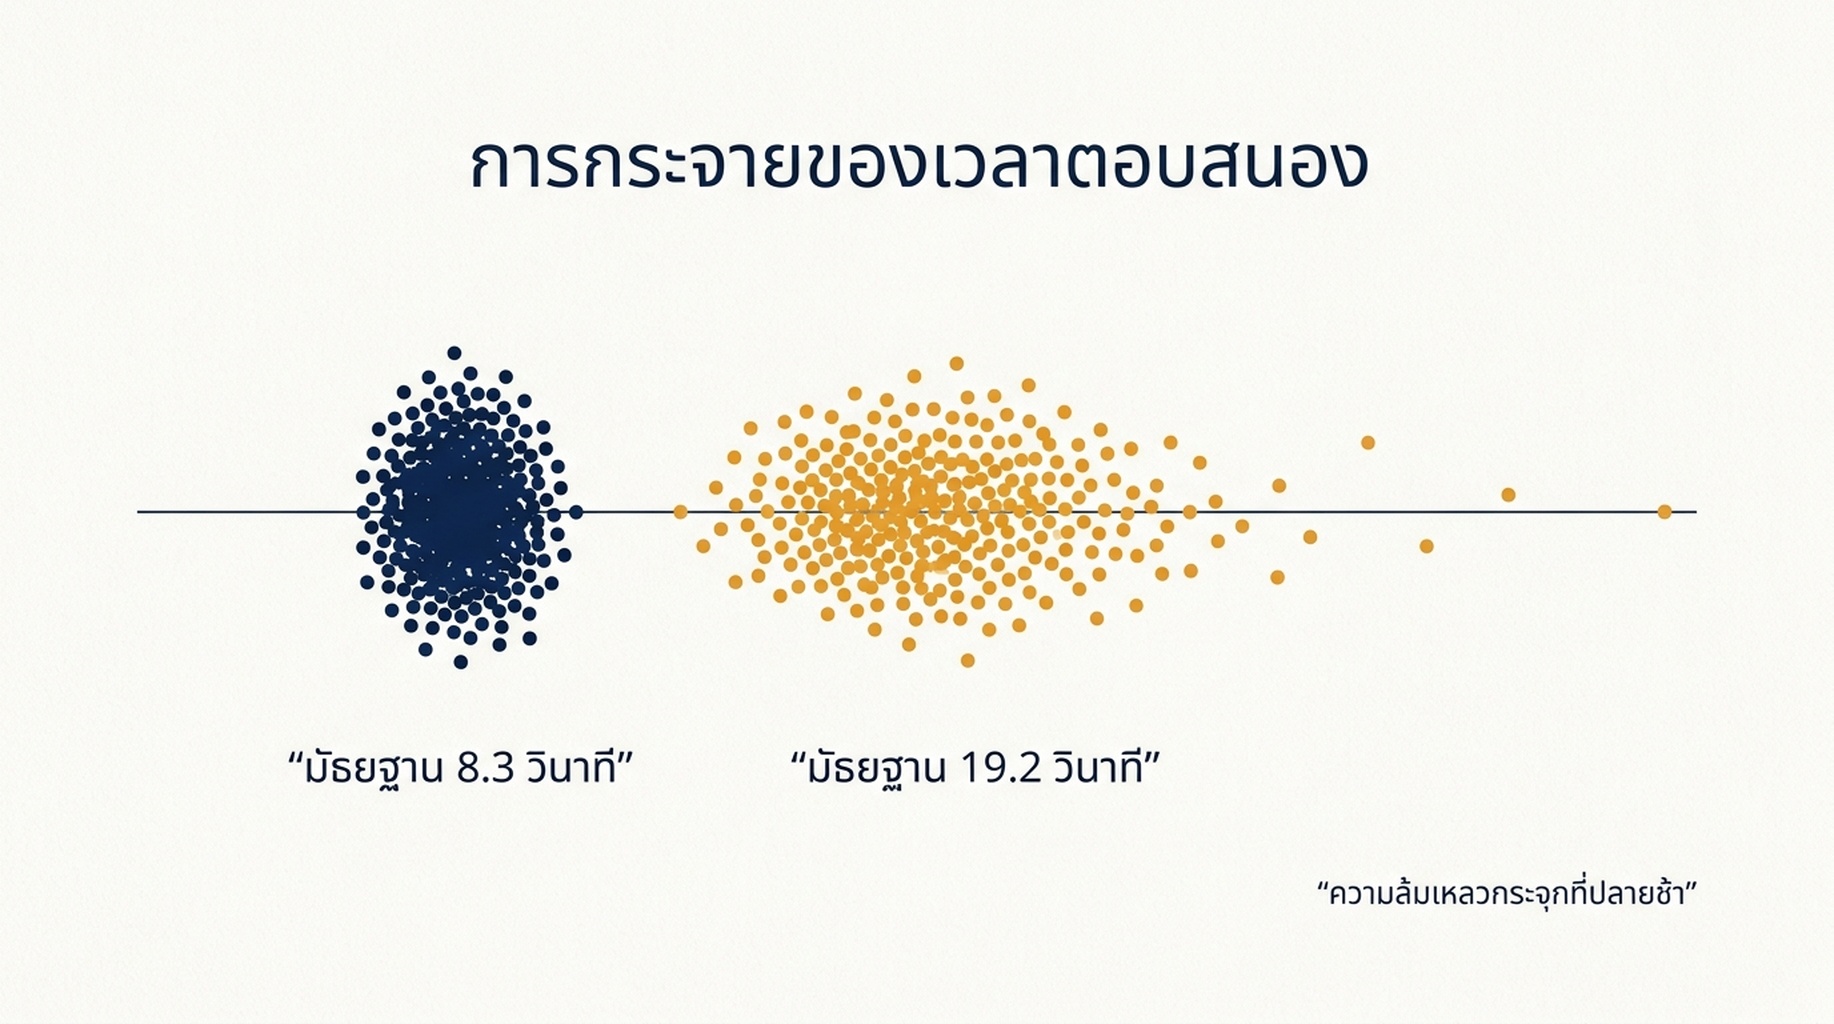
คำขอที่ลึกกว่าใช้เวลานานกว่า และความล้มเหลวกระจุกตัวที่ปลายช้าของการกระจาย
สิ่งนี้หมายความต่อตัวเลขบนแดชบอร์ดของคุณ
คำค้น 50 คำเดียวกันให้ตัวเลขการปรากฏสองตัวที่ป้องกันได้ คือ 2 เปอร์เซ็นต์กับ 44 เปอร์เซ็นต์ โดยมีเพียงการตั้งค่าความลึกที่แยกมันออกจากกัน นั่นคือการแกว่งที่ใหญ่กว่าการเปลี่ยนแปลงอันดับส่วนใหญ่ที่คุณจะใช้เวลาทั้งไตรมาสเพื่ออธิบาย
มีกฎสามข้อตามมา
ตั้งความลึกจากที่ที่คุณมีอันดับ ไม่ใช่จากค่าเริ่มต้นของเครื่องมือ ดึงการกระจายอันดับของคุณเองออกมาก่อน ถ้าคำค้นส่วนใหญ่ของคุณอยู่ระหว่างอันดับ 20 กับ 60 ความลึก 10 จะแทบไม่รายงานอะไรเลย และคุณจะสรุปว่าคุณมีปัญหาการปรากฏที่คุณไม่ได้มี
รายงานความลึกควบคู่กับตัวเลข รายงานอันดับที่ไม่มีการตั้งค่าความลึกไม่สามารถทำซ้ำได้ เช่นเดียวกับตำแหน่ง ภาษา และอุปกรณ์
ถือว่า "ไม่พบ" เป็นข้อมูล ไม่ใช่ข้อผิดพลาด ยี่สิบแปดจาก 50 คำค้นไม่คืนผลลัพธ์สำหรับโดเมนของเราที่ความลึก 100 และนั่นคือคำตอบที่ซื่อตรง เครื่องมือตรวจที่ซ่อนแถวเหล่านั้นกำลังย่อรายการคำค้นของคุณไปในทิศทางที่ไร้ประโยชน์ที่สุด
ตรวจว่าตัวรายงานมีคุณสมบัติ SERP รวมอยู่หรือไม่ ในชุดคำค้นนี้ AI Overview มีอยู่ใน 96 เปอร์เซ็นต์ของคำค้น การส่งออกแบบมีแต่ตำแหน่งไม่สามารถแสดงสิ่งนั้นได้ และไม่มีการตั้งค่าความลึกใดที่จะเพิ่มมันเข้าไป
ถ้าเป้าหมายคือตัวเลขที่ป้องกันได้เมื่อเวลาผ่านไป คำถามเรื่องความลึกอยู่ใต้คำถามเรื่องการรายงาน บันทึกของเราเกี่ยวกับ Google ให้ผลลัพธ์ลึกแค่ไหนจริง ๆ ครอบคลุมว่าเพดานอยู่ตรงไหน การรันทั้งแหล่งข้อมูลของเราเองและแหล่งข้อมูลสดพร้อมกัน ครอบคลุมการตั้งค่าที่ทำให้คุณซื่อตรงกับเรื่องนี้ และ สิ่งที่ Search Console บอกได้ที่การตรวจสดบอกไม่ได้ ครอบคลุมอีกครึ่งที่การรันนี้ไม่ได้แตะเลย
ข้อจำกัด
มีสองข้อจำกัดที่ควรระบุ
คำค้น 50 คำจากพร็อพเพอร์ตีเดียวเป็นตัวอย่างเล็ก ๆ และการแยก 2 เปอร์เซ็นต์กับ 44 เปอร์เซ็นต์นั้นจำเพาะกับไซต์ที่คำค้นอยู่ลึก พร็อพเพอร์ตีที่ติด 10 อันดับแรกในรายการส่วนใหญ่จะแทบไม่เห็นความต่างระหว่างสองรอบ และกำลังจ่ายเกินสำหรับความลึก
ความหน่วงขึ้นอยู่กับผู้ให้บริการ ตำแหน่ง และช่วงเวลา ตัวเลขวินาทีสัมบูรณ์ตรงนี้จะไม่ย้ายไปด้วย แต่อัตราส่วนระหว่างสองความลึกควรคงอยู่โดยประมาณ เพราะความต่างคืองานจริงไม่ใช่ความแปรปรวนของเครือข่าย
คำถามที่พบบ่อย
เครื่องมือตรวจอันดับแบบเป็นชุดควรใช้ความลึกเท่าไร ตั้งจาการกระจายอันดับของคุณเอง ความลึก 10 ก็พอถ้าคุณติด 10 อันดับแรก ความลึก 20 ครอบคลุมช่วงที่ใช้ได้จริงส่วนใหญ่ที่ $0.0035 ต่อคำค้น ความลึก 100 ราคา $0.014 และคุ้มเฉพาะเมื่อคุณติดตามอันดับที่ต่ำกว่า 50 จริง ๆ
ตรวจ 50 คำค้นใช้เวลานานเท่าไร ประมาณหนึ่งนาทีที่เวิร์กเกอร์พร้อมกันแปดตัวสำหรับการตรวจตื้น และประมาณ 2.3 นาทีสำหรับการตรวจลึก ถ้ารันแบบเรียงลำดับ การตรวจเดียวกันจะใช้ 7.5 และ 16.6 นาที ดังนั้นการทำงานพร้อมกันจึงมีค่าเท่ากับแปดเท่าในเรื่องเวลา
ทำไมการตรวจที่ลึกกว่าจึงล้มเหลวบ่อยกว่า คำขอที่ลึกกว่าประกอบผลนานกว่า โดยค่ามัธยฐาน 19.2 วินาที เทียบกับ 8.3 ในรอบตื้น จึงมีโอกาสชนไทม์เอาต์ของไคลเอนต์หรือผู้ให้บริการมากกว่า ให้บันทึกความล้มเหลวและลองใหม่แทนที่จะทิ้งไป
เครื่องมือตรวจอันดับแบบเป็นชุดแม่นยำไหมถ้ามันบอกว่าคำค้นของฉันไม่พบ โดยปกติแม่นยำ ในการรันของเรา 28 จาก 50 คำค้นไม่มีผลลัพธ์สำหรับโดเมนของเราภายใน 100 อันดับจริง ๆ ตรวจการตั้งค่าความลึกก่อนที่คุณจะถือว่าแถวที่หายไปเป็นปัญหาข้อมูล
การตรวจคำค้นมากขึ้นแพงกว่าการตรวจให้ลึกขึ้นไหม ความลึกขยับใบแจ้งหนี้ต่อคำค้น แต่คำค้นคูณยอดรวม การเพิ่มจาก 50 เป็น 500 คำค้นที่ความลึก 10 มีต้นทุนสิบเท่าและใช้เวลาสิบเท่า ขณะที่ความลึก 100 แพงกว่าเจ็ดเท่าต่อคำค้น ตั้งราคาความลึกที่คุณต้องการก่อน แล้วค่อยซื้อจำนวนคำค้นที่คุณตรวจทานไหว
มุมมองของ Auspia: ก่อนจะเปลี่ยนหน้าใด ๆ สักหน้า ให้ตรวจการตั้งค่าความลึกของเครื่องมือตรวจอันดับแบบเป็นชุดของคุณ มันคือคำอธิบายที่ถูกที่สุดสำหรับตัวเลขการปรากฏที่น่าประหลาดใจ และในการทดสอบของเรามันสร้างส่วนต่าง 22 เท่าระหว่างสองรอบที่ห่างกันไม่กี่นาที ตั้งความลึกจากการกระจายอันดับ บันทึกความล้มเหลว และเก็บการตั้งค่าไว้ในรายงานเพื่อให้ตัวเลขของไตรมาสหน้าเทียบกันได้
ผู้เขียน: Bennett Hayes นักวิเคราะห์ GEO เชิงประยุกต์ที่ Auspia ผ่านการรีวิวการนำไปใช้มากกว่า 400 ครั้ง เขียนเกี่ยวกับการปฏิบัติงานค้นหาจริง การวัด และรายละเอียดที่เปลี่ยนรายงาน