Un verificador de posiciones masivo promete una sola cosa: muchas palabras clave, un informe. Y lo que contiene ese informe lo determina casi por completo un ajuste que casi nadie cambia: hasta dónde baja la comprobación.
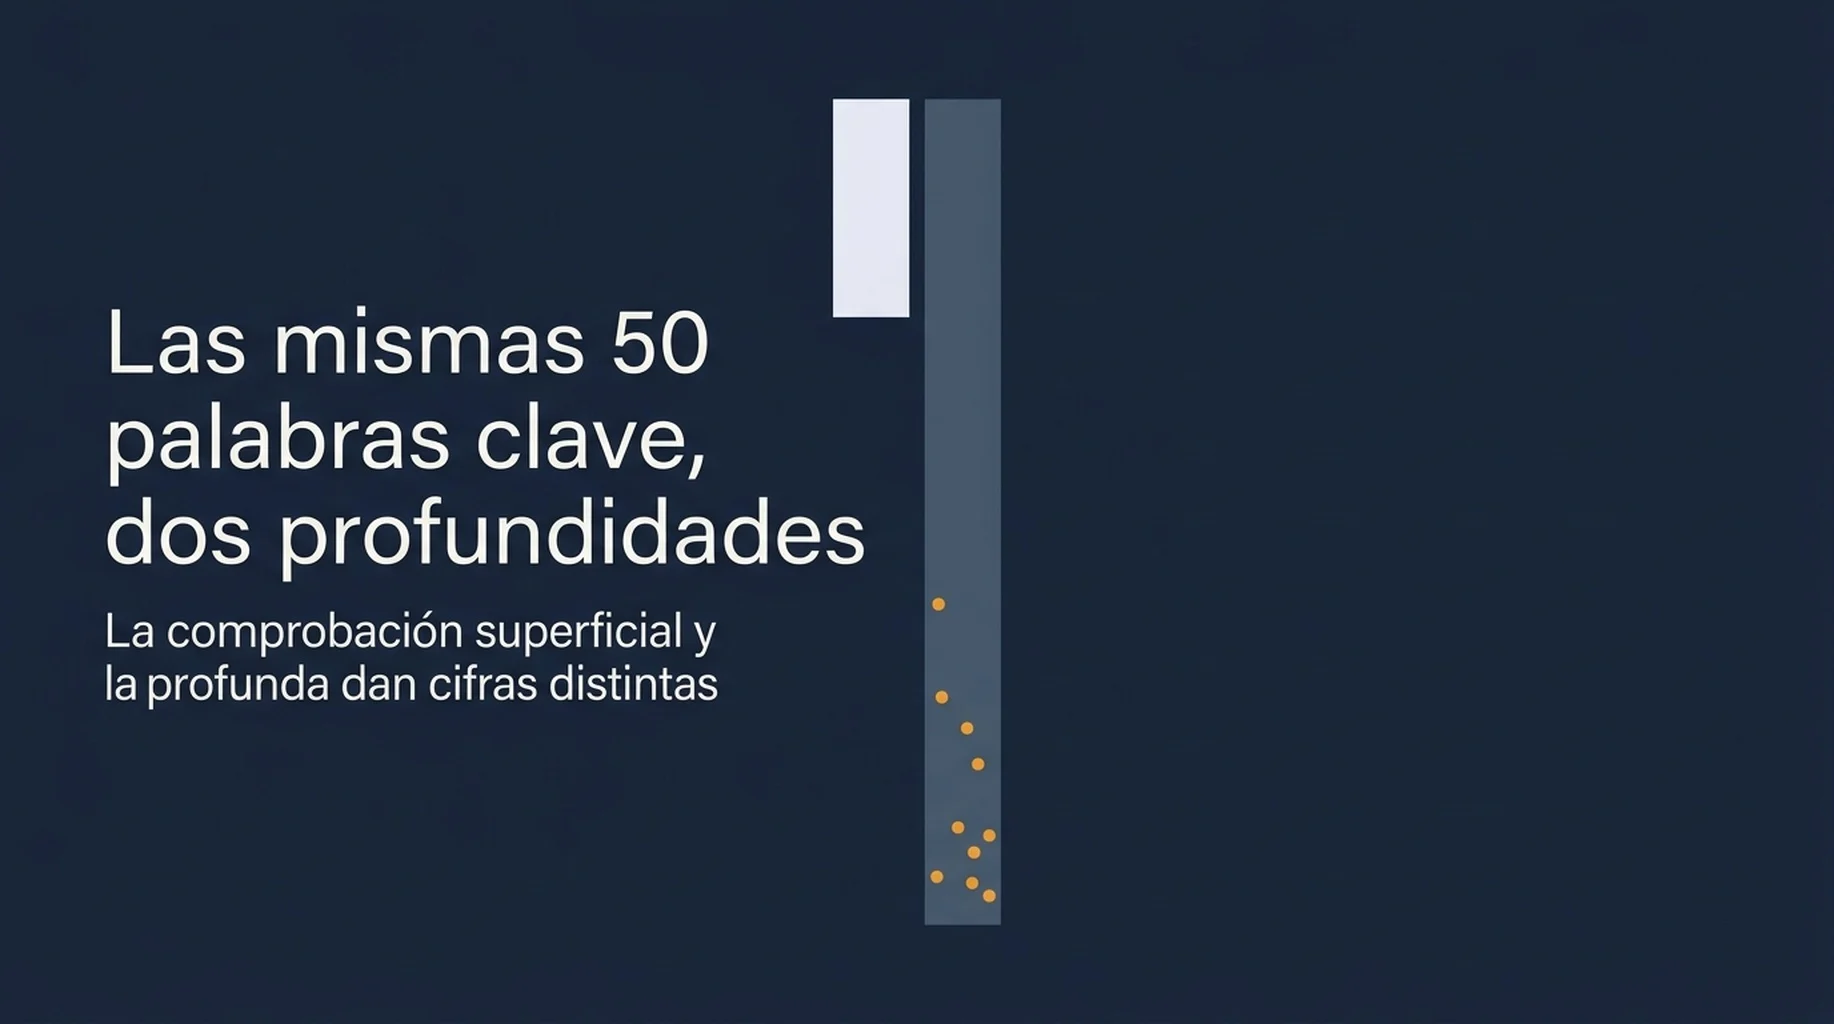
Ejecutamos las mismas 50 palabras clave dos veces seguidas, el 12 de septiembre de 2026, contra el mismo motor de búsqueda, la misma ubicación y el mismo dispositivo. La única diferencia era la profundidad.
Con profundidad 10, la comprobación encontró nuestro dominio en 1 de las 50 palabras clave. Con profundidad 100, lo encontró en 22 de ellas.
Las mismas palabras clave. La misma hora. La misma API. La diferencia no es precisión, porque ambas ejecuciones eran precisas. Es campo de visión, y cambia la cifra del titular por un factor de 22.
Qué ejecutamos
Cincuenta palabras clave tomadas de nuestra propia lista de consultas de Search Console y filtradas a consultas en alfabeto latino para que coincidiera el conjunto de resultados de Estados Unidos en inglés. Ambas ejecuciones usaron solicitudes orgánicas en vivo de Google a resolución de escritorio, ocho trabajadores simultáneos y un tiempo de espera de 300 segundos por solicitud.
Ajuste | Ejecución A | Ejecución B |
|---|---|---|
Palabras clave | 50 | 50 |
Profundidad solicitada | 10 | 100 |
Ubicación e idioma | Estados Unidos, inglés | Estados Unidos, inglés |
Dispositivo | Escritorio | Escritorio |
Simultaneidad | 8 | 8 |
Registramos la latencia por solicitud, el coste facturado, el recuento de resultados orgánicos y si aparecía nuestro dominio.
Resultado 1: las mismas palabras clave, dos respuestas distintas
Métrica | Profundidad 10 | Profundidad 100 |
|---|---|---|
Palabras clave comprobadas | 50 | 50 |
Solicitudes que devolvieron un resultado utilizable | 50 | 43 |
Solicitudes fallidas | 0 | 7 |
Palabras clave en las que apareció nuestro dominio | 1 | 22 |
Dentro del top 3 | 1 | 1 |
Dentro del top 20 | 1 | 1 |
Dentro del top 100 | 1 | 20 |
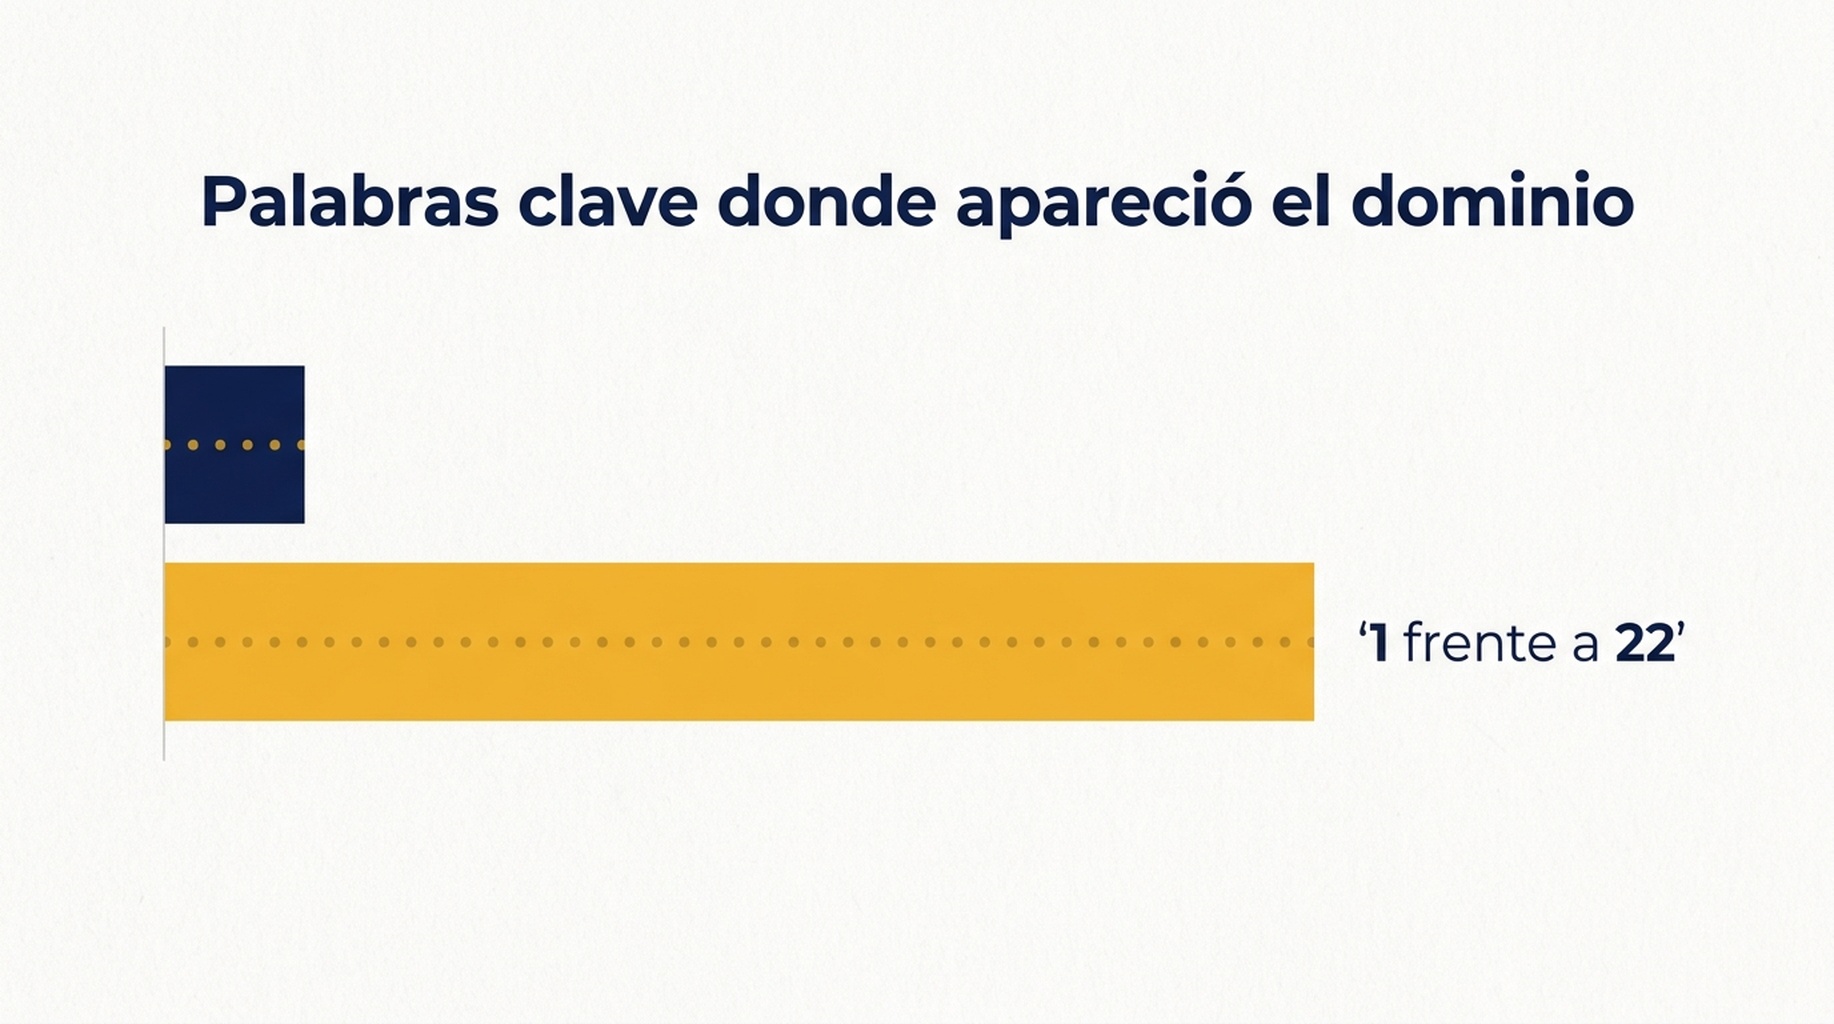
El conjunto de palabras clave no cambió entre ejecuciones. El único ajuste que cambió fue la profundidad.
Lee esto con atención, porque su forma es toda la lección. Con profundidad 10, nuestra visibilidad en ese conjunto parecía del 2 por ciento. Con profundidad 100, parecía del 44 por ciento. Ninguna de las dos cifras es errónea, y solo una es útil.
El cuadro de la parte alta de la página apenas se movió. Una palabra clave se mantuvo dentro del top 10 en ambas ejecuciones. Todo lo que añadió la comprobación profunda estaba entre la posición 20 y la posición 100, que es justo la franja que esconde un verificador masivo con la configuración predeterminada. Si tu plan se apoya en un verificador de posiciones ajustado a la primera página, tu línea base no es una medición de tu visibilidad. Es una medición de tu visibilidad dentro de la primera página, y en este conjunto las dos difieren en 21 palabras clave.
Un detalle adicional: dos de las 22 palabras clave encontradas en la ejecución profunda estaban más allá de la posición absoluta 100. La API devuelve algo más allá de la profundidad solicitada, así que un informe de "top 100" puede contener posiciones por encima de 100. Fíltrálas si la etiqueta te importa.
Resultado 2: el coste crece con la profundidad, alrededor de siete a uno
Métrica | Profundidad 10 | Profundidad 100 |
|---|---|---|
Coste total facturado | $0,1000 | $0,6230 |
Coste por palabra clave | $0,0020 | $0,0125 |
Resultados orgánicos devueltos por palabra clave | unos 12 | unos 97 |
La ejecución con profundidad 100 costó 6,2 veces la de profundidad 10 por las mismas 50 palabras clave, y esa diferencia compró las 21 palabras clave adicionales en las que aparecía nuestro dominio.
Esa proporción es la respuesta honesta a la pregunta más común sobre los verificadores masivos: si merece la pena pagar por más resultados. Merece la pena si posicionas por debajo de la primera página. Si tus palabras clave se quedan en el top 10, la ejecución profunda devuelve sobre todo filas que nunca vas a leer.
Hay un ajuste intermedio, y normalmente es el correcto. La profundidad 20 cuesta $0,0035 por palabra clave en nuestro baremo anterior, lo que es un 75 por ciento más caro que la profundidad 10 y sigue siendo un 75 por ciento de descuento frente a la profundidad 100. Para un sitio en la franja de la posición 20 a la 50, la profundidad 20 captura la mayor parte del movimiento útil por una fracción del coste.
El coste facturado también quedó por debajo de lo que preveía el precio por palabra clave, porque las siete solicitudes fallidas no se facturaron. Es la tasa de fallo asomando en la factura, y vamos a llegar a ella enseguida.
Resultado 3: el informe también esconde si había un AI Overview
La profundidad no es lo único que omite un informe de solo posiciones.
Registramos los tipos de elemento de SERP en cada solicitud de ambas ejecuciones. En la ejecución de profundidad 10, 48 de las 50 consultas devolvieron un AI Overview. En la de profundidad 100, lo hicieron 42 de las 43 solicitudes correctas.
Ejecución | Consultas con AI Overview | Consultas comprobadas |
|---|---|---|
Profundidad 10 | 48 | 50 |
Profundidad 100 | 42 | 43 correctas |
Esta cifra le parecerá errónea a cualquiera que haya leído nuestra instantánea anterior, que encontró AI Overviews en 4 de 40 consultas sobre SEO. Las dos son correctas, y la diferencia está en el conjunto de consultas, no en el método.
El conjunto de 40 consultas era una lista sobre SEO: herramientas de posicionamiento, auditorías, actualizaciones de algoritmo y 15 consultas que nombran una herramienta o una API. Este conjunto de 50 salió de nuestra propia lista de consultas de Search Console, dominada por formulaciones de utilidad y comparación de cola larga. Las consultas por las que un sitio recibe impresiones de verdad tienen una forma distinta de las que anota un equipo de SEO, y la presencia de AI Overview sigue esa forma.
El punto práctico para la comprobación masiva es más estrecho y más incómodo. Un verificador de posiciones masivo devuelve posiciones. No devuelve el elemento que ahora se sienta por encima de la posición 1, y en el conjunto de consultas que tenemos de verdad ese elemento estaba presente en el 96 por ciento de ellas.
Resultado 4: el tiempo es la latencia dividida entre la simultaneidad
Una comprobación masiva no es instantánea, y la razón es la latencia de las solicitudes, no ningún procesamiento que controles.
Métrica | Profundidad 10 | Profundidad 100 |
|---|---|---|
Tiempo real con 8 trabajadores | 62,0 segundos | 135,9 segundos |
Solicitud más rápida | 2,6 segundos | 8,1 segundos |
Solicitud mediana | 8,3 segundos | 19,2 segundos |
Solicitud más lenta | 22,0 segundos | 40,3 segundos |
Suma de todos los tiempos de solicitud | 451 segundos | 998 segundos |
De aquí salen dos cosas.
La latencia mediana más que se duplicó con la profundidad, de 8,3 a 19,2 segundos. Una búsqueda más profunda tarda de verdad más en montarse, y por eso un verificador masivo con un tiempo de espera de cliente corto falla en las ejecuciones profundas y no en las superficiales.
El tiempo real lo define la simultaneidad, no la velocidad de la API. Ejecuta las 50 palabras clave de una en una y la comprobación de profundidad 10 tarda unos 7,5 minutos; con ocho trabajadores tarda un minuto. Si tu verificador masivo no tiene control de simultaneidad, ese es el único ajuste que merece la pena preguntar, porque vale un factor de ocho en tiempo transcurrido sin ninguna diferencia de coste.
Resultado 5: la ejecución profunda falló el 14 por ciento de las veces
Siete de las 50 solicitudes de profundidad 100 fallaron. Ninguna de las solicitudes de profundidad 10 falló.
Ejecución | Fallos | Tasa de fallo |
|---|---|---|
Profundidad 10 | 0 de 50 | 0 por ciento |
Profundidad 100 | 7 de 50 | 14 por ciento |
Como las solicitudes fallidas no se facturaron, la ejecución de profundidad 100 también costó menos que los $0,70 que preveía el precio por palabra clave, y por eso el coste efectivo por palabra clave salió a $0,0125 y no a $0,014.
Esta es la parte de la comprobación masiva que los informes casi nunca muestran. Una herramienta que reintenta en silencio lo tapa. Una herramienta que no lo hace va a subnotificar tus posiciones sin avisar, y los fallos se concentran en las solicitudes más lentas, que son las profundas por las que pagaste de más.
El mensaje de error era idéntico en las siete: la tarea se completó con resultados parciales, algunas páginas no se pudieron recuperar tras varios reintentos y las páginas no devueltas no se facturaron. Ese es el comportamiento correcto de un proveedor, y es también la razón por la que una comprobación masiva subnotifica en lugar de caerse. Una página fallida no es una palabra clave en la que no posicionas. Es un desconocido, y un informe que la dibuja como una celda vacía convirtió en silencio un desconocido en una negativa.
Si montas tu propio bucle, registra los fallos como un desenlace de primera clase en lugar de descartarlos, y reintenta los fallos una vez antes de informar.
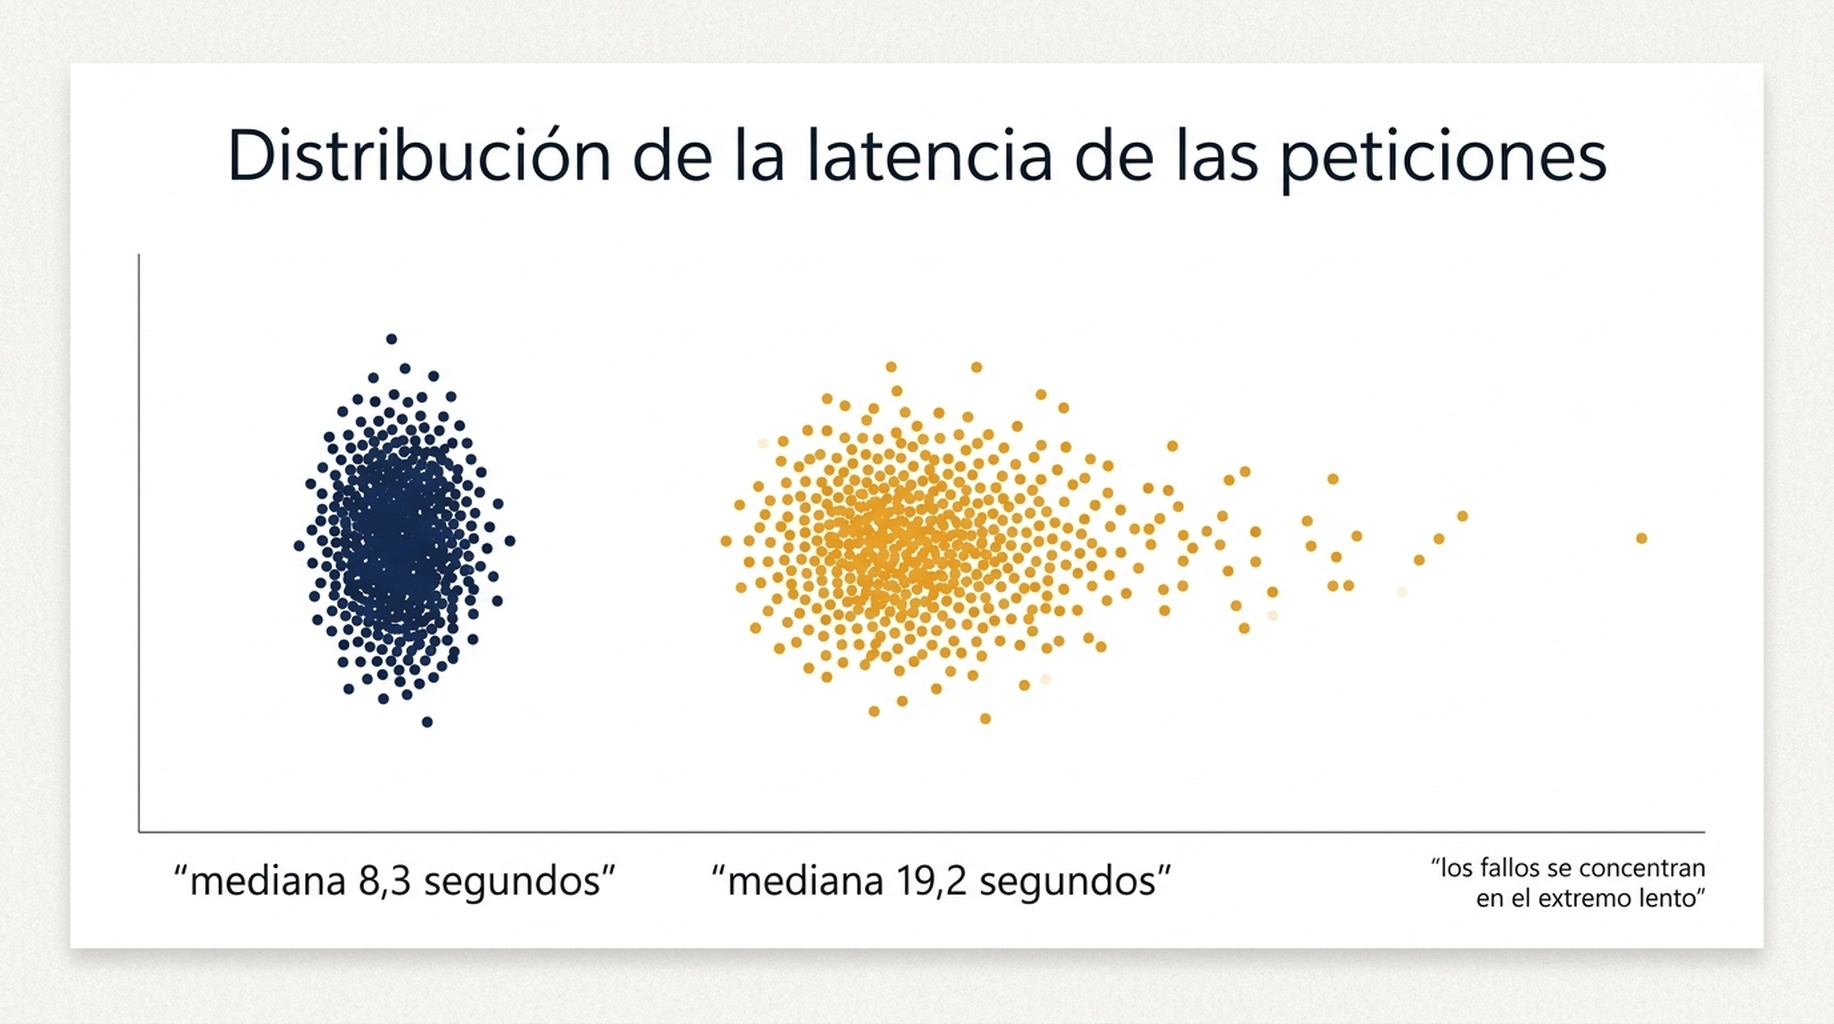
Las solicitudes más profundas tardan más, y los fallos se concentran en el extremo lento de la distribución.
Qué significa esto para la cifra de tu panel
Las mismas 50 palabras clave produjeron dos cifras de visibilidad defendibles, 2 por ciento y 44 por ciento, separadas solo por un ajuste de profundidad. Esa oscilación es mayor que la mayoría de los cambios de posicionamiento que te vas a pasar un trimestre explicando.
De ahí salen tres reglas.
Fija la profundidad desde donde posicionas, no desde el valor predeterminado de la herramienta. Saca primero tu propia distribución de posiciones. Si la mayoría de tus palabras clave están entre la 20 y la 60, la profundidad 10 no informará de casi nada y concluirás que tienes un problema de visibilidad que no tienes.
Informa de la profundidad junto con la cifra. Un informe de posicionamiento sin el ajuste de profundidad no es reproducible. Lo mismo vale para la ubicación, el idioma y el dispositivo.
Trata "no encontrado" como dato, no como error. Veintiocho de las 50 palabras clave no devolvieron resultado para nuestro dominio con profundidad 100, y esa es la respuesta honesta. Un verificador que esconde esas filas está acortando tu lista de palabras clave en la dirección menos útil.
Comprueba si el informe incluye siquiera funciones de SERP. En este conjunto, un AI Overview estaba presente en el 96 por ciento de las consultas. Una exportación de solo posiciones no puede mostrarlo, y ningún ajuste de profundidad lo va a añadir.
Si el objetivo es una cifra que puedas defender con el tiempo, la cuestión de la profundidad está por debajo de la cuestión del informe. Nuestras notas sobre hasta dónde entrega resultados Google de verdad cubren dónde está el techo, ejecutar una fuente propia y una fuente en vivo a la vez cubre la configuración que te mantiene honesto al respecto, y qué puede decirte Search Console que una comprobación en vivo no puede cubre la mitad que esta ejecución no tocó.
Límites
Dos límites que conviene declarar.
Cincuenta palabras clave de una sola propiedad son una muestra pequeña, y la división del 2 por ciento frente al 44 por ciento es específica de un sitio cuyas palabras clave se quedan abajo. Una propiedad que posiciona en el top 10 en la mayor parte de su lista apenas vería diferencia entre las ejecuciones y estaría pagando de más por la profundidad.
La latencia depende del proveedor, la ubicación y el momento. Los segundos absolutos de aquí no se trasladan, pero la proporción entre las dos profundidades debería mantenerse más o menos, porque la diferencia es trabajo real y no variación de red.
Preguntas frecuentes
¿Qué profundidad debería usar un verificador de posiciones masivo? Fíjala desde tu propia distribución de posiciones. La profundidad 10 basta si posicionas en el top 10. La profundidad 20 cubre la mayor parte de la franja práctica a $0,0035 por palabra clave. La profundidad 100 cuesta $0,014 y solo compensa cuando de verdad sigues posiciones por debajo de la 50.
¿Cuánto se tarda en comprobar 50 palabras clave? Alrededor de un minuto con ocho trabajadores simultáneos para una comprobación superficial, y unos 2,3 minutos para una profunda. En serie, esas mismas comprobaciones tardan 7,5 y 16,6 minutos, así que la simultaneidad vale un factor de ocho en tiempo transcurrido.
¿Por qué falló más la comprobación profunda? Las solicitudes profundas tardan más en montarse, con una mediana de 19,2 segundos frente a 8,3 de la ejecución superficial, así que tienen más probabilidad de chocar con un tiempo de espera de cliente o de proveedor. Registra los fallos y reinténtalos en lugar de descartarlos.
¿Es preciso un verificador de posiciones masivo cuando dice que mi palabra clave no aparece? Normalmente sí. En nuestra ejecución, 28 de las 50 palabras clave no tenían de verdad ningún resultado para nuestro dominio dentro de las 100 posiciones. Comprueba el ajuste de profundidad antes de tratar una fila ausente como un problema de datos.
¿Comprobar más palabras clave cuesta más que comprobar más profundo? La profundidad mueve la factura por palabra clave, pero las palabras clave multiplican el total. Pasar de 50 a 500 palabras clave con profundidad 10 cuesta diez veces más y tarda diez veces más, mientras que la profundidad 100 cuesta siete veces más por palabra clave. Pon precio a la profundidad que necesitas y luego compra la cantidad de palabras clave que puedas revisar.
Visión de Auspia: antes de cambiar una sola página, comprueba el ajuste de profundidad de tu verificador masivo. Es la explicación más barata de una cifra de visibilidad sorprendente, y en nuestra prueba supuso un factor de 22 entre dos ejecuciones separadas por minutos. Fija la profundidad desde la distribución de posiciones, registra los fallos y deja el ajuste en el informe para que la cifra del próximo trimestre sea comparable.
Autoría: Bennett Hayes, analista de GEO aplicado con más de 400 revisiones de implementación en Auspia. Escribe sobre ejecución práctica de búsqueda, medición y los detalles que cambian un informe.