Un vérificateur de positions en masse promet une chose : beaucoup de mots-clés, un seul rapport. Et ce que contient ce rapport est déterminé presque entièrement par un réglage que presque personne ne change — la profondeur jusqu'à laquelle la vérification descend.
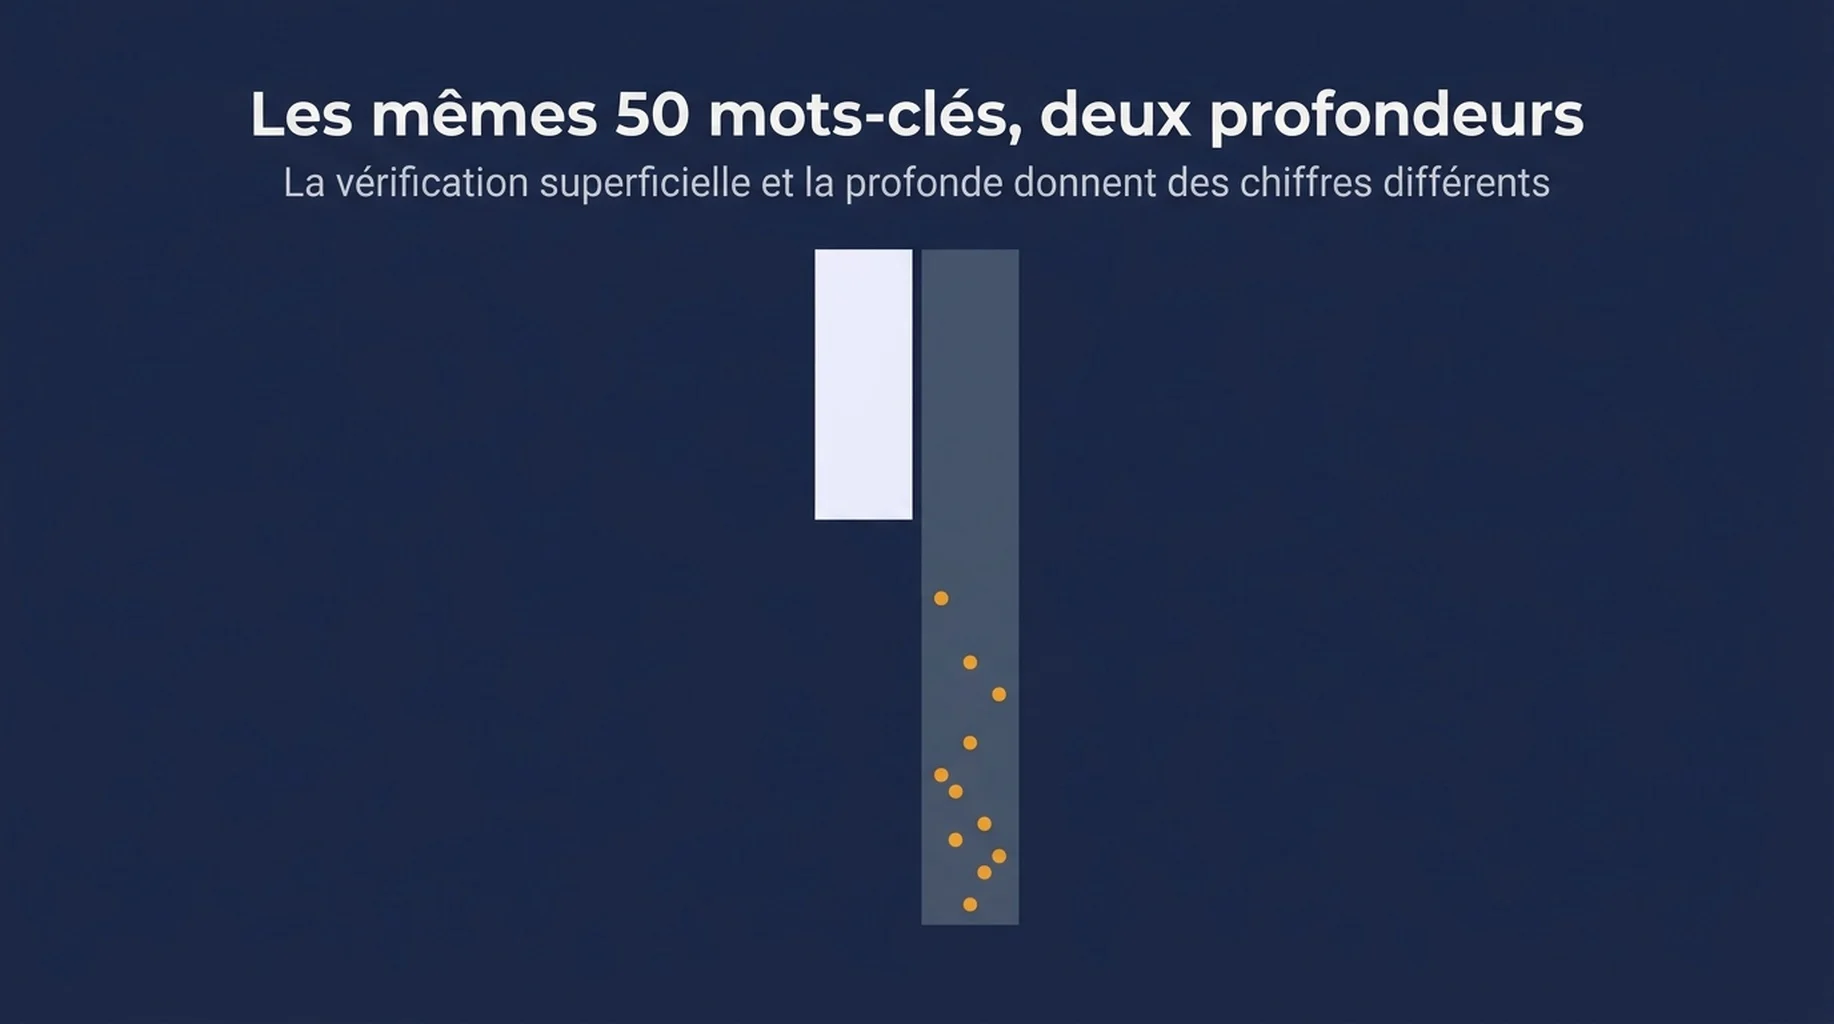
Nous avons exécuté les mêmes 50 mots-clés deux fois de suite, le 12 septembre 2026, contre le même moteur de recherche, la même localisation et le même appareil. La seule différence était la profondeur.
À la profondeur 10, la vérification a trouvé notre domaine sur 1 mot-clé sur 50. À la profondeur 100, elle l'a trouvé sur 22 d'entre eux.
Les mêmes mots-clés. La même heure. La même API. La différence n'est pas une question de précision, car les deux passes étaient précises. C'est le champ de vision, et il fait varier le chiffre de tête d'un facteur 22.
Ce que nous avons exécuté
Cinquante mots-clés tirés de notre propre liste de requêtes Search Console, filtrés sur des requêtes en alphabet latin pour correspondre à l'ensemble de résultats des États-Unis en anglais. Les deux passes ont utilisé des requêtes organiques Google en direct en résolution bureau, huit workers simultanés et un délai d'attente de 300 secondes par requête.
Réglage | Passe A | Passe B |
|---|---|---|
Mots-clés | 50 | 50 |
Profondeur demandée | 10 | 100 |
Localisation et langue | États-Unis, anglais | États-Unis, anglais |
Appareil | Bureau | Bureau |
Simultanéité | 8 | 8 |
Nous avons relevé la latence par requête, le coût facturé, le nombre de résultats organiques et la présence ou non de notre domaine.
Résultat 1 : les mêmes mots-clés, deux réponses différentes
Mesure | Profondeur 10 | Profondeur 100 |
|---|---|---|
Mots-clés vérifiés | 50 | 50 |
Requêtes ayant renvoyé un résultat exploitable | 50 | 43 |
Requêtes en échec | 0 | 7 |
Mots-clés où notre domaine est apparu | 1 | 22 |
Dans le top 3 | 1 | 1 |
Dans le top 20 | 1 | 1 |
Dans le top 100 | 1 | 20 |
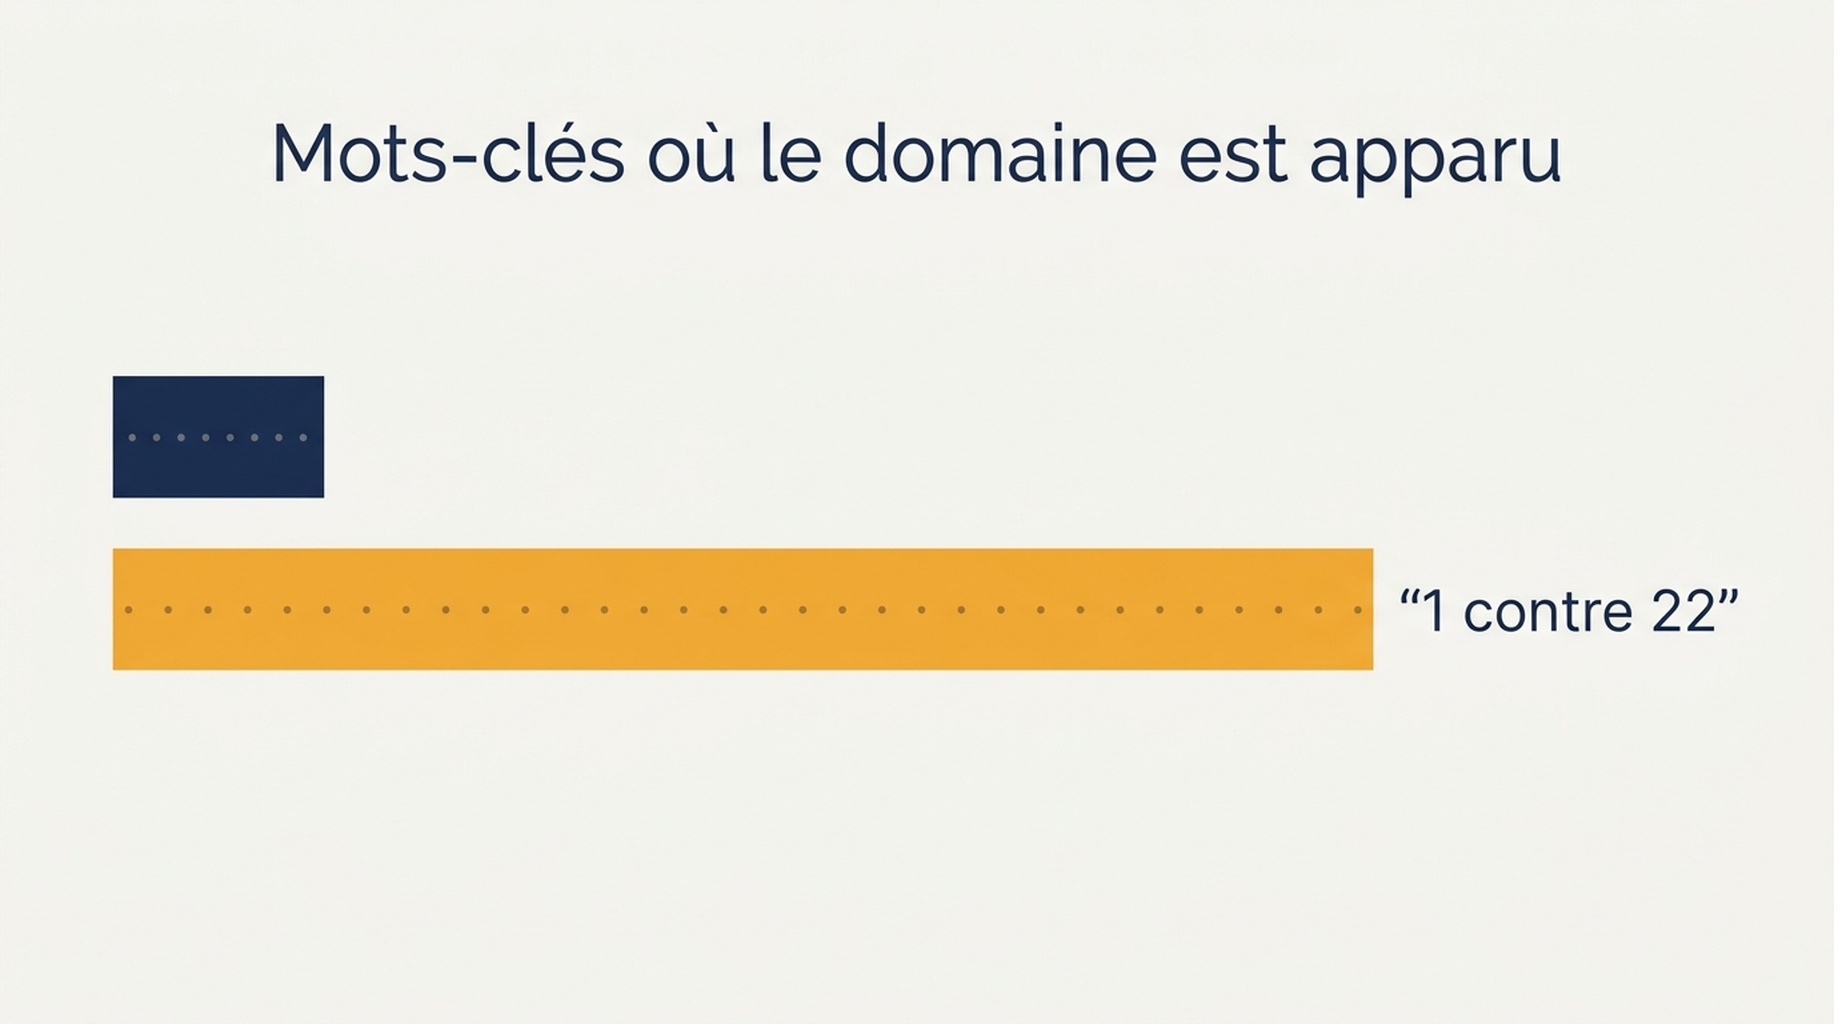
L'ensemble de mots-clés n'a pas changé entre les passes. Le seul réglage qui a changé est la profondeur.
Lisez ceci attentivement, car sa forme est toute la leçon. À la profondeur 10, notre visibilité sur cet ensemble ressemblait à 2 pour cent. À la profondeur 100, elle ressemblait à 44 pour cent. Aucun des deux chiffres n'est faux, et un seul est utile.
Le tableau du haut de page n'a presque pas bougé. Un mot-clé est resté dans le top 10 lors des deux passes. Tout ce que la vérification profonde a ajouté se situait entre la position 20 et la position 100, exactement la plage qu'un vérificateur en masse réglé par défaut dissimule. Si votre plan repose sur un vérificateur de positions réglé sur la première page, votre base de référence n'est pas une mesure de votre visibilité. C'est une mesure de votre visibilité à l'intérieur de la première page, et sur cet ensemble, les deux diffèrent de 21 mots-clés.
Un petit détail en plus : deux des 22 mots-clés trouvés lors de la passe profonde se situaient au-delà de la position absolue 100. L'API renvoie un peu au-delà de la profondeur demandée, donc un rapport « top 100 » peut contenir des positions supérieures à 100. Filtrez-les si ce libellé compte pour vous.
Résultat 2 : le coût croît avec la profondeur, environ sept pour un
Mesure | Profondeur 10 | Profondeur 100 |
|---|---|---|
Coût total facturé | $0,1000 | $0,6230 |
Coût par mot-clé | $0,0020 | $0,0125 |
Résultats organiques renvoyés par mot-clé | environ 12 | environ 97 |
La passe à la profondeur 100 a coûté 6,2 fois la passe à la profondeur 10 pour les mêmes 50 mots-clés, et cet écart a acheté les 21 mots-clés supplémentaires où notre domaine est apparu.
Ce ratio est la réponse honnête à la question la plus fréquente sur les vérificateurs en masse : faut-il payer pour plus de résultats. Oui, si vous vous positionnez au-delà de la première page. Si vos mots-clés tiennent dans le top 10, la passe profonde renvoie surtout des lignes que vous ne lirez jamais.
Il existe un réglage intermédiaire, et c'est généralement le bon. La profondeur 20 coûte $0,0035 par mot-clé dans notre grille précédente, soit 75 pour cent de plus que la profondeur 10 et encore 75 pour cent de remise face à la profondeur 100. Pour un site dans la plage des positions 20 à 50, la profondeur 20 capte l'essentiel du mouvement utile pour une fraction du coût.
Le coût facturé est aussi resté sous ce que prévoyait le prix par mot-clé, parce que les sept requêtes en échec n'ont pas été facturées. C'est le taux d'échec qui affleure sur la facture, et nous y venons tout de suite.
Résultat 3 : le rapport dissimule aussi la présence d'un AI Overview
La profondeur n'est pas la seule chose qu'omet un rapport de positions seules.
Nous avons relevé les types d'éléments SERP sur chaque requête des deux passes. Dans la passe à la profondeur 10, 48 requêtes sur 50 ont renvoyé un AI Overview. Dans celle à la profondeur 100, 42 des 43 requêtes réussies l'ont fait.
Passe | Requêtes avec AI Overview | Requêtes vérifiées |
|---|---|---|
Profondeur 10 | 48 | 50 |
Profondeur 100 | 42 | 43 réussies |
Ce chiffre paraîtra faux à quiconque a lu notre instantané précédent, qui trouvait des AI Overview sur 4 requêtes SEO sur 40. Les deux sont exacts, et la différence tient à l'ensemble de requêtes, pas à la méthode.
L'ensemble de 40 requêtes était une liste sur le SEO : outils de positionnement, audits, mises à jour d'algorithme et 15 requêtes nommant un outil ou une API. Cet ensemble de 50 vient de notre propre liste Search Console, dominée par des formulations de longue traîne autour de l'utilité et de la comparaison. Les requêtes pour lesquelles un site obtient réellement des impressions ont une forme différente de celles qu'une équipe SEO note, et la présence d'AI Overview suit cette forme.
Le point pratique pour la vérification en masse est plus étroit et plus gênant. Un vérificateur de positions en masse renvoie des positions. Il ne renvoie pas l'élément qui siège désormais au-dessus de la position 1, et sur l'ensemble de requêtes que nous avons réellement, cet élément était présent sur 96 pour cent d'entre elles.
Résultat 4 : le temps, c'est la latence divisée par la simultanéité
Une vérification en masse n'est pas instantanée, et la raison tient à la latence des requêtes, pas à un traitement que vous contrôlez.
Mesure | Profondeur 10 | Profondeur 100 |
|---|---|---|
Temps réel avec 8 workers | 62,0 secondes | 135,9 secondes |
Requête la plus rapide | 2,6 secondes | 8,1 secondes |
Requête médiane | 8,3 secondes | 19,2 secondes |
Requête la plus lente | 22,0 secondes | 40,3 secondes |
Somme de tous les temps de requête | 451 secondes | 998 secondes |
Deux choses en ressortent.
La latence médiane a plus que doublé avec la profondeur, passant de 8,3 à 19,2 secondes. Une recherche plus profonde met réellement plus longtemps à se construire, et c'est pourquoi un vérificateur en masse doté d'un délai d'attente client court échoue sur les passes profondes et pas sur les superficielles.
Le temps réel est déterminé par la simultanéité, pas par la vitesse de l'API. Lancez les 50 mots-clés un par un et la vérification à la profondeur 10 prend environ 7,5 minutes ; avec huit workers, elle prend une minute. Si votre vérificateur en masse n'a pas de contrôle de simultanéité, c'est le seul réglage qui vaut la peine d'être demandé, car il vaut un facteur huit sur le temps écoulé sans aucune différence de coût.
Résultat 5 : la passe profonde a échoué 14 pour cent du temps
Sept des 50 requêtes à la profondeur 100 ont échoué. Aucune des requêtes à la profondeur 10 n'a échoué.
Passe | Échecs | Taux d'échec |
|---|---|---|
Profondeur 10 | 0 sur 50 | 0 pour cent |
Profondeur 100 | 7 sur 50 | 14 pour cent |
Comme les requêtes en échec n'ont pas été facturées, la passe à la profondeur 100 a aussi coûté moins que les $0,70 prévus par le prix par mot-clé, et c'est pourquoi le coût effectif par mot-clé ressort à $0,0125 et non $0,014.
C'est la partie de la vérification en masse que les rapports montrent rarement. Un outil qui réessaie en silence va la masquer. Un outil qui ne le fait pas va sous-déclarer discrètement vos positions, et les échecs se concentrent sur les requêtes les plus lentes, celles en profondeur que vous avez payées plus cher.
Le message d'erreur était identique sur les sept : la tâche s'est terminée avec des résultats partiels, certaines pages n'ont pas pu être récupérées après plusieurs tentatives, et les pages non renvoyées n'ont pas été facturées. C'est le comportement correct d'un fournisseur, et c'est aussi pourquoi une vérification en masse sous-déclare au lieu de s'effondrer. Une page en échec n'est pas un mot-clé sur lequel vous n'êtes pas positionné. C'est une inconnue, et un rapport qui la dessine en cellule vide a discrètement converti une inconnue en négation.
Si vous construisez votre propre boucle, journalisez les échecs comme un résultat à part entière au lieu de les écarter, et réessayez les échecs une fois avant de produire le rapport.
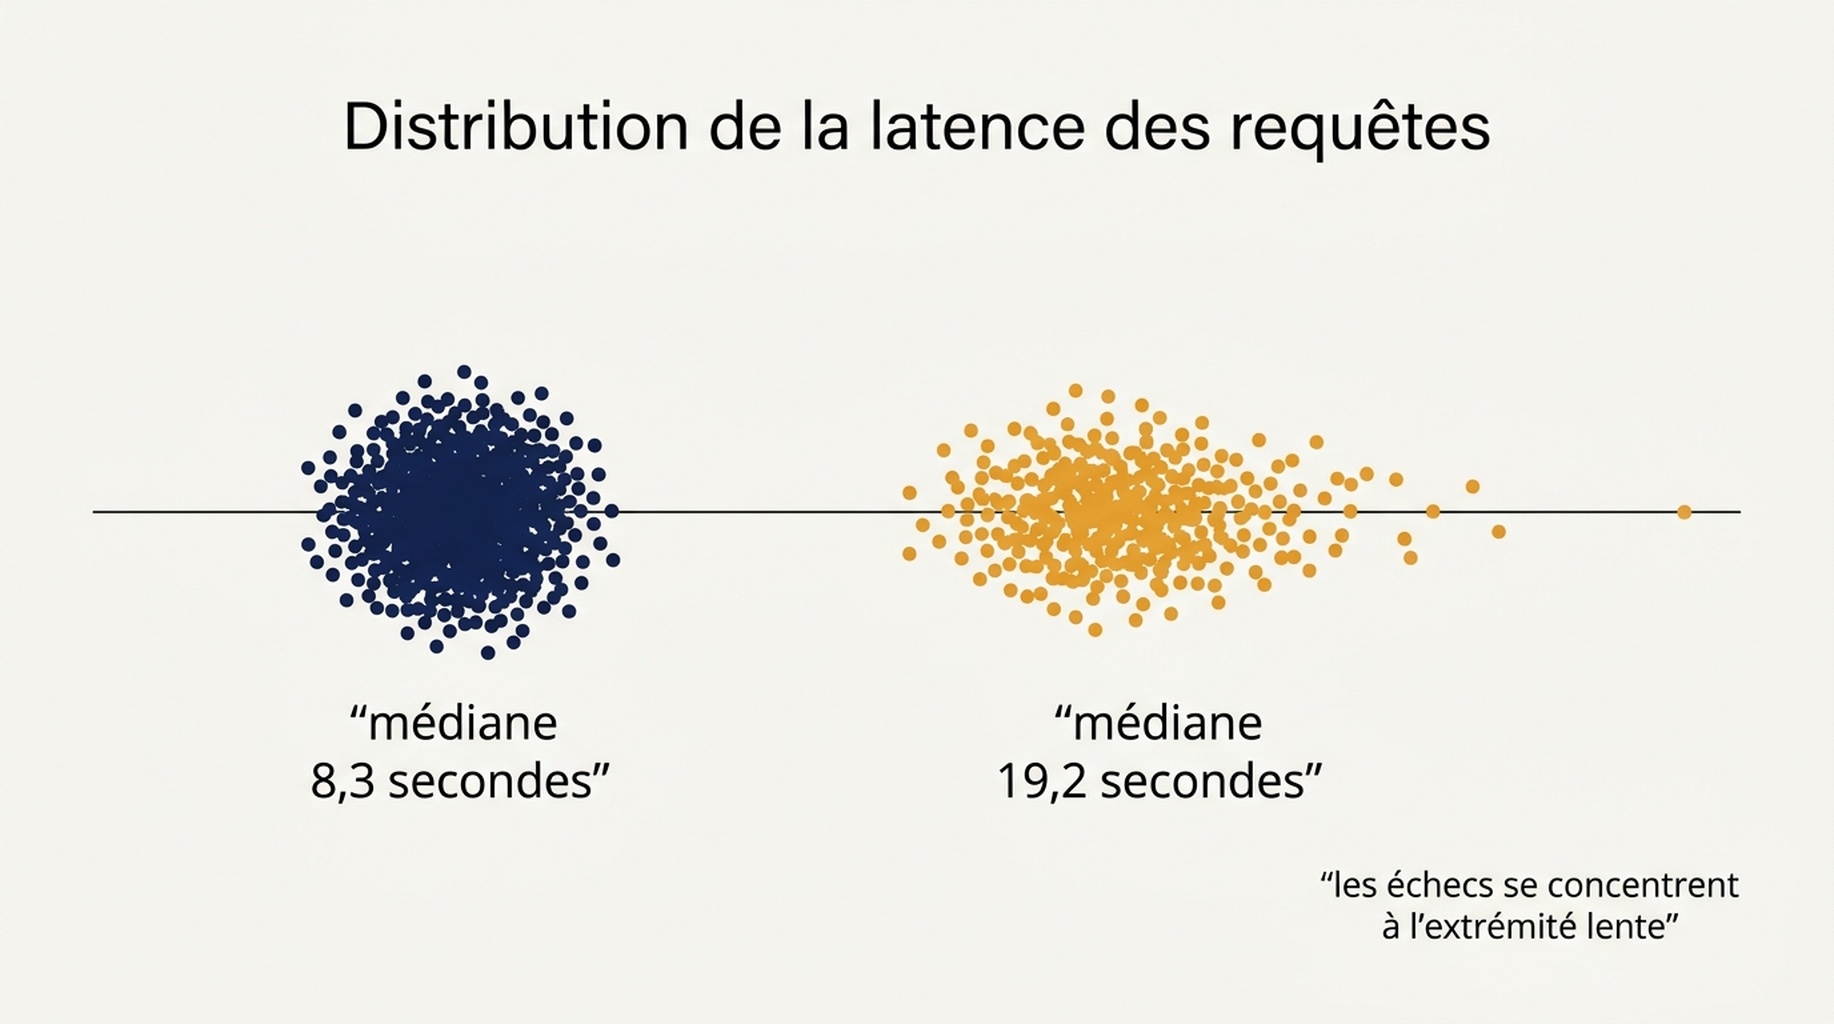
Les requêtes profondes prennent plus de temps, et les échecs se concentrent à l'extrémité lente de la distribution.
Ce que cela signifie pour le chiffre de votre tableau de bord
Les mêmes 50 mots-clés ont produit deux chiffres de visibilité défendables, 2 pour cent et 44 pour cent, séparés par un seul réglage de profondeur. Cette oscillation est plus grande que la plupart des variations de positionnement que vous passerez un trimestre à expliquer.
Trois règles en découlent.
Réglez la profondeur d'après l'endroit où vous vous positionnez, pas d'après la valeur par défaut de l'outil. Sortez d'abord votre propre distribution de positions. Si la plupart de vos mots-clés se situent entre 20 et 60, la profondeur 10 ne signalera presque rien et vous conclurez à un problème de visibilité que vous n'avez pas.
Indiquez la profondeur à côté du chiffre. Un rapport de positionnement sans réglage de profondeur n'est pas reproductible. Idem pour la localisation, la langue et l'appareil.
Traitez « non trouvé » comme une donnée, pas comme une erreur. Vingt-huit des 50 mots-clés n'ont renvoyé aucun résultat pour notre domaine à la profondeur 100, et c'est la réponse honnête. Un vérificateur qui cache ces lignes raccourcit votre liste de mots-clés dans la direction la moins utile.
Vérifiez si le rapport inclut ne serait-ce que les fonctionnalités SERP. Sur cet ensemble, un AI Overview était présent sur 96 pour cent des requêtes. Un export de positions seules ne peut pas le montrer, et aucun réglage de profondeur ne l'ajoutera.
Si l'objectif est un chiffre que vous pouvez défendre dans le temps, la question de la profondeur se situe sous celle du rapport. Nos notes sur jusqu'où Google livre réellement des résultats couvrent où se trouve le plafond, faire tourner une source propriétaire et une source en direct ensemble couvre la configuration qui vous garde honnête là-dessus, et ce que la Search Console peut dire qu'une vérification en direct ne peut pas couvre la moitié que cette passe n'a pas touchée du tout.
Limites
Deux limites qu'il vaut la peine de déclarer.
Cinquante mots-clés issus d'une seule propriété constituent un petit échantillon, et le partage de 2 pour cent contre 44 pour cent est propre à un site dont les mots-clés se situent bas. Une propriété positionnée dans le top 10 sur la majeure partie de sa liste ne verrait presque aucune différence entre les passes et paierait trop cher la profondeur.
La latence dépend du fournisseur, de la localisation et du moment. Les secondes absolues ici ne se transposeront pas, mais le rapport entre les deux profondeurs devrait à peu près tenir, parce que la différence est du travail réel et non de la variabilité réseau.
Questions fréquentes
Quelle profondeur un vérificateur de positions en masse doit-il utiliser ? Réglez-la d'après votre propre distribution de positions. La profondeur 10 suffit si vous êtes dans le top 10. La profondeur 20 couvre l'essentiel de la plage pratique à $0,0035 par mot-clé. La profondeur 100 coûte $0,014 et ne vaut le coup que si vous suivez réellement des positions au-delà de 50.
Combien de temps prend la vérification de 50 mots-clés ? Environ une minute avec huit workers simultanés pour une vérification superficielle, et environ 2,3 minutes pour une profonde. En séquentiel, ces mêmes vérifications prennent 7,5 et 16,6 minutes, la simultanéité vaut donc un facteur huit sur le temps écoulé.
Pourquoi la vérification profonde a-t-elle échoué plus souvent ? Les requêtes profondes mettent plus longtemps à se construire, avec une médiane de 19,2 secondes contre 8,3 pour la passe superficielle, elles ont donc plus de chances de heurter un délai d'attente client ou fournisseur. Journalisez les échecs et réessayez-les au lieu de les écarter.
Un vérificateur de positions en masse est-il précis quand il dit que mon mot-clé est introuvable ? Généralement oui. Dans notre passe, 28 des 50 mots-clés n'avaient réellement aucun résultat pour notre domaine dans les 100 positions. Vérifiez le réglage de profondeur avant de traiter une ligne absente comme un problème de données.
Vérifier plus de mots-clés coûte-t-il plus cher que vérifier plus profond ? La profondeur déplace la facture par mot-clé, mais les mots-clés multiplient le total. Passer de 50 à 500 mots-clés à la profondeur 10 coûte dix fois plus cher et prend dix fois plus de temps, tandis que la profondeur 100 coûte sept fois plus cher par mot-clé. Chiffrez la profondeur dont vous avez besoin, puis achetez la quantité de mots-clés que vous pouvez relire.
Point de vue Auspia : avant de modifier une seule page, vérifiez le réglage de profondeur de votre vérificateur en masse. C'est l'explication la moins coûteuse d'un chiffre de visibilité surprenant, et dans notre test il a représenté un facteur 22 entre deux passes séparées de quelques minutes. Réglez la profondeur d'après la distribution des positions, journalisez les échecs et gardez le réglage dans le rapport pour que le chiffre du prochain trimestre soit comparable.
Auteur : Bennett Hayes, analyste GEO appliqué, plus de 400 revues de mise en œuvre chez Auspia. Écrit sur l'exécution concrète du référencement, la mesure et les détails qui changent un rapport.