Ein Massen-Rank-Checker verspricht eines: viele Keywords, ein Bericht. Und was in diesem Bericht steht, bestimmt fast vollständig eine Einstellung, die kaum jemand ändert – wie tief die Prüfung hinuntergeht.
Wir haben dieselben 50 Keywords am 12. September 2026 zweimal hintereinander gegen dieselbe Suchmaschine, denselben Standort und dasselbe Gerät laufen lassen. Der einzige Unterschied war die Tiefe.
Bei Tiefe 10 fand die Prüfung unsere Domain bei 1 von 50 Keywords. Bei Tiefe 100 fand sie sie bei 22 von ihnen.
Dieselben Keywords. Dieselbe Stunde. Dieselbe API. Der Unterschied ist keine Genauigkeit, denn beide Läufe waren genau. Es ist das Sichtfeld, und es verschiebt die Schlagzeile um den Faktor 22.
Was wir laufen ließen
Fünfzig Keywords aus unserer eigenen Query-Liste in der Search Console, gefiltert auf lateinisch geschriebene Queries, damit das Ergebnis-Set der USA auf Englisch passte. Beide Läufe nutzten live organische Google-Anfragen in Desktop-Auflösung, acht gleichzeitige Worker und ein Timeout von 300 Sekunden pro Anfrage.
Einstellung | Lauf A | Lauf B |
|---|---|---|
Keywords | 50 | 50 |
Angeforderte Tiefe | 10 | 100 |
Standort und Sprache | USA, Englisch | USA, Englisch |
Gerät | Desktop | Desktop |
Parallelität | 8 | 8 |
Wir haben die Latenz pro Anfrage, die berechneten Kosten, die Zahl der organischen Ergebnisse und die Frage festgehalten, ob unsere Domain auftauchte.
Ergebnis 1: dieselben Keywords, zwei verschiedene Antworten
Messgröße | Tiefe 10 | Tiefe 100 |
|---|---|---|
Geprüfte Keywords | 50 | 50 |
Anfragen mit verwertbarem Ergebnis | 50 | 43 |
Fehlgeschlagene Anfragen | 0 | 7 |
Keywords, bei denen unsere Domain auftauchte | 1 | 22 |
Innerhalb der Top 3 | 1 | 1 |
Innerhalb der Top 20 | 1 | 1 |
Innerhalb der Top 100 | 1 | 20 |
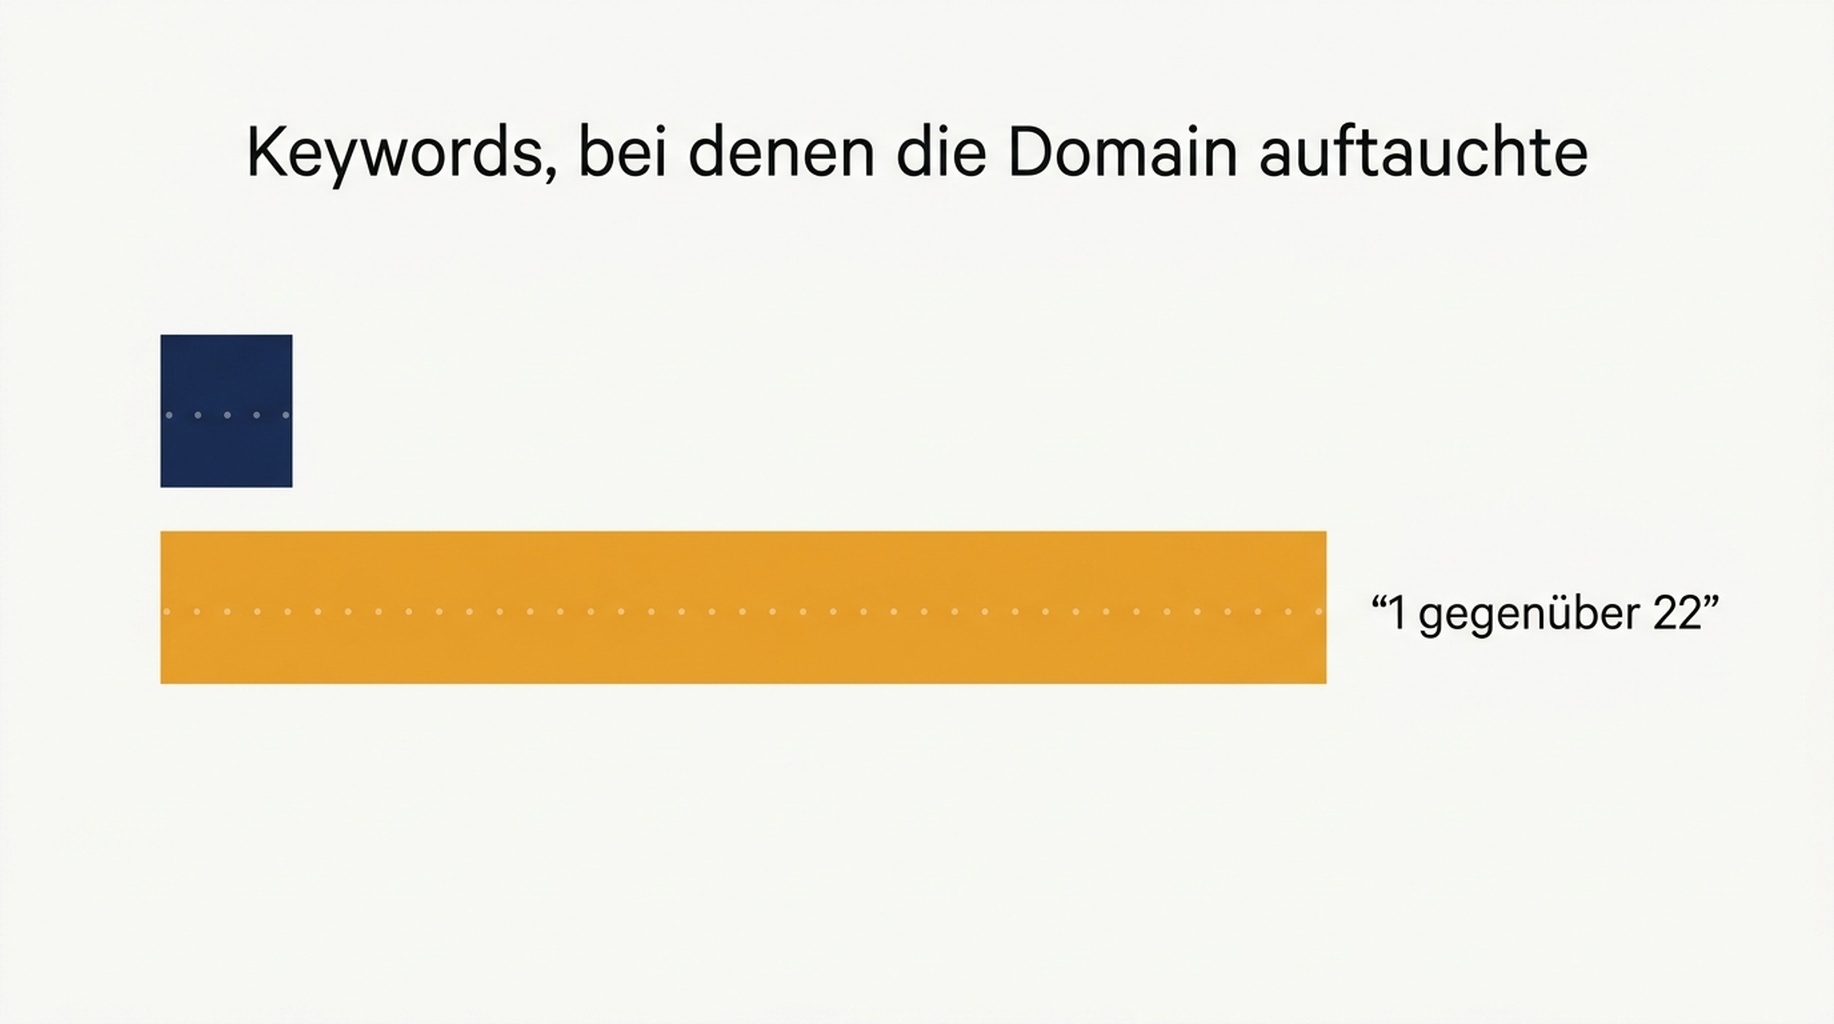
Das Keyword-Set blieb zwischen den Läufen unverändert. Die einzige geänderte Einstellung war die Tiefe.
Lesen Sie das genau, denn seine Form ist die ganze Lehre. Bei Tiefe 10 sah unsere Sichtbarkeit in diesem Set nach 2 Prozent aus. Bei Tiefe 100 sah sie nach 44 Prozent aus. Keine der beiden Zahlen ist falsch, und nur eine ist brauchbar.
Das Bild oben auf der Seite hat sich kaum bewegt. Ein Keyword blieb in beiden Läufen innerhalb der Top 10. Alles, was die tiefe Prüfung hinzufügte, lag zwischen Position 20 und Position 100 – genau das Band, das ein Massen-Checker mit Standardeinstellung verbirgt. Wenn Ihr Plan auf einem Rank-Checker aufbaut, der auf die erste Seite gestellt ist, ist Ihre Ausgangsbasis keine Messung Ihrer Sichtbarkeit. Sie ist eine Messung Ihrer Sichtbarkeit innerhalb der ersten Seite, und in diesem Set unterscheiden sich die beiden um 21 Keywords.
Ein kleines Zusatzdetail: Zwei der 22 Keywords aus dem tiefen Lauf lagen jenseits der absoluten Position 100. Die API liefert etwas über die angeforderte Tiefe hinaus, ein "Top 100"-Bericht kann also Positionen über 100 enthalten. Filtern Sie sie heraus, wenn Ihnen das Label wichtig ist.
Ergebnis 2: die Kosten wachsen mit der Tiefe, etwa sieben zu eins
Messgröße | Tiefe 10 | Tiefe 100 |
|---|---|---|
Berechnete Gesamtkosten | $0,1000 | $0,6230 |
Kosten pro Keyword | $0,0020 | $0,0125 |
Zurückgegebene organische Ergebnisse pro Keyword | etwa 12 | etwa 97 |
Der Lauf mit Tiefe 100 kostete das 6,2-Fache des Laufs mit Tiefe 10 für dieselben 50 Keywords, und dieser Unterschied kaufte die 21 zusätzlichen Keywords, bei denen unsere Domain auftauchte.
Dieses Verhältnis ist die ehrliche Antwort auf die häufigste Frage zu Massen-Checkern: ob es sich lohnt, für mehr Ergebnisse zu zahlen. Es lohnt sich, wenn Sie unterhalb der ersten Seite ranken. Stehen Ihre Keywords in den Top 10, liefert der tiefere Lauf überwiegend Zeilen zurück, die Sie nie lesen werden.
Es gibt eine mittlere Einstellung, und meistens ist sie die richtige. Tiefe 20 kostet in unserer früheren Preisliste $0,0035 pro Keyword, also 75 Prozent mehr als Tiefe 10 und immer noch 75 Prozent Rabatt gegenüber Tiefe 100. Für eine Website im Bereich der Positionen 20 bis 50 fängt Tiefe 20 den größten Teil der nützlichen Bewegung für einen Bruchteil der Kosten ein.
Die berechneten Kosten lagen außerdem unter dem, was der Preis pro Keyword vorhersagte, weil die sieben fehlgeschlagenen Anfragen nicht berechnet wurden. Das ist die Ausfallquote, die in der Rechnung auftaucht, und wir kommen gleich dazu.
Ergebnis 3: der Bericht verbirgt auch, ob es eine AI Overview gab
Die Tiefe ist nicht das Einzige, was ein reiner Positionsbericht auslässt.
Wir haben in beiden Läufen bei jeder Anfrage die SERP-Elementtypen festgehalten. Im Lauf mit Tiefe 10 lieferten 48 der 50 Queries eine AI Overview. Im Lauf mit Tiefe 100 taten das 42 der 43 erfolgreichen Anfragen.
Lauf | Queries mit AI Overview | Geprüfte Queries |
|---|---|---|
Tiefe 10 | 48 | 50 |
Tiefe 100 | 42 | 43 erfolgreiche |
Diese Zahl wird jedem falsch vorkommen, der unsere frühere Momentaufnahme gelesen hat, die bei 4 von 40 SEO-Queries AI Overviews fand. Beide sind richtig, und der Unterschied liegt im Query-Set, nicht in der Methode.
Das Set aus 40 Queries war eine SEO-Liste: Ranking-Tools, Audits, Algorithmus-Updates und 15 Queries, die ein Tool oder eine API nennen. Dieses Set aus 50 Queries kam aus unserer eigenen Search-Console-Liste, in der Long-Tail-Formulierungen zu Nutzen und Vergleich dominieren. Die Queries, für die eine Website tatsächlich Impressionen bekommt, haben eine andere Form als die Queries, die ein SEO-Team notiert, und die Anwesenheit von AI Overview folgt dieser Form.
Der praktische Punkt für die Massenprüfung ist enger und unangenehmer. Ein Massen-Rank-Checker liefert Positionen. Er liefert nicht das Element, das jetzt über Position 1 sitzt, und im Query-Set, das wir tatsächlich haben, war dieses Element bei 96 Prozent der Queries vorhanden.
Ergebnis 4: die Zeit ist die Latenz geteilt durch die Parallelität
Eine Massenprüfung ist nicht augenblicklich, und der Grund ist die Latenz der Anfrage, nicht irgendeine Verarbeitung, die Sie steuern.
Messgröße | Tiefe 10 | Tiefe 100 |
|---|---|---|
Reale Zeit bei 8 Workern | 62,0 Sekunden | 135,9 Sekunden |
Schnellste Anfrage | 2,6 Sekunden | 8,1 Sekunden |
Median-Anfrage | 8,3 Sekunden | 19,2 Sekunden |
Langsamste Anfrage | 22,0 Sekunden | 40,3 Sekunden |
Summe aller Anfragezeiten | 451 Sekunden | 998 Sekunden |
Zwei Dinge fallen dabei heraus.
Die Median-Latenz hat sich mit der Tiefe mehr als verdoppelt, von 8,3 auf 19,2 Sekunden. Eine tiefere Suche braucht tatsächlich länger zum Zusammenbauen, und deshalb scheitert ein Massen-Checker mit kurzem Client-Timeout bei tiefen Läufen und nicht bei flachen.
Die reale Zeit bestimmt die Parallelität, nicht die Geschwindigkeit der API. Lassen Sie die 50 Keywords einzeln laufen, dauert die Prüfung mit Tiefe 10 etwa 7,5 Minuten; mit acht Workern dauert sie eine Minute. Wenn Ihr Massen-Checker keine Parallelitätssteuerung hat, ist das die einzige Einstellung, nach der es sich zu fragen lohnt, denn sie bringt den Faktor acht bei der Laufzeit ohne jeden Kostenunterschied.
Ergebnis 5: der tiefere Lauf scheiterte in 14 Prozent der Fälle
Sieben der 50 Anfragen mit Tiefe 100 scheiterten. Keine der Anfragen mit Tiefe 10 scheiterte.
Lauf | Ausfälle | Ausfallquote |
|---|---|---|
Tiefe 10 | 0 von 50 | 0 Prozent |
Tiefe 100 | 7 von 50 | 14 Prozent |
Da die fehlgeschlagenen Anfragen nicht berechnet wurden, kostete der Lauf mit Tiefe 100 auch weniger als die $0,70, die der Preis pro Keyword vorhersagte; deshalb lagen die effektiven Kosten pro Keyword bei $0,0125 und nicht bei $0,014.
Das ist der Teil der Massenprüfung, den Berichte fast nie zeigen. Ein Tool, das still erneut versucht, deckt es zu. Ein Tool, das das nicht tut, meldet Ihre Positionen unbemerkt zu niedrig, und die Ausfälle sammeln sich bei den langsamsten Anfragen – den tiefen, für die Sie mehr bezahlt haben.
Die Fehlermeldung war bei allen sieben identisch: die Aufgabe wurde mit Teilergebnissen abgeschlossen, einige Seiten konnten nach mehreren Wiederholungen nicht abgerufen werden, und die nicht zurückgegebenen Seiten wurden nicht berechnet. Das ist das korrekte Verhalten eines Anbieters und zugleich der Grund, warum eine Massenprüfung zu niedrig meldet, statt abzustürzen. Eine fehlgeschlagene Seite ist kein Keyword, bei dem Sie nicht ranken. Sie ist ein Unbekanntes, und ein Bericht, der sie als leere Zelle zeichnet, hat ein Unbekanntes still in eine Verneinung verwandelt.
Wenn Sie Ihre eigene Schleife bauen, protokollieren Sie Ausfälle als vollwertiges Ergebnis, statt sie zu verwerfen, und wiederholen Sie Ausfälle einmal, bevor Sie berichten.
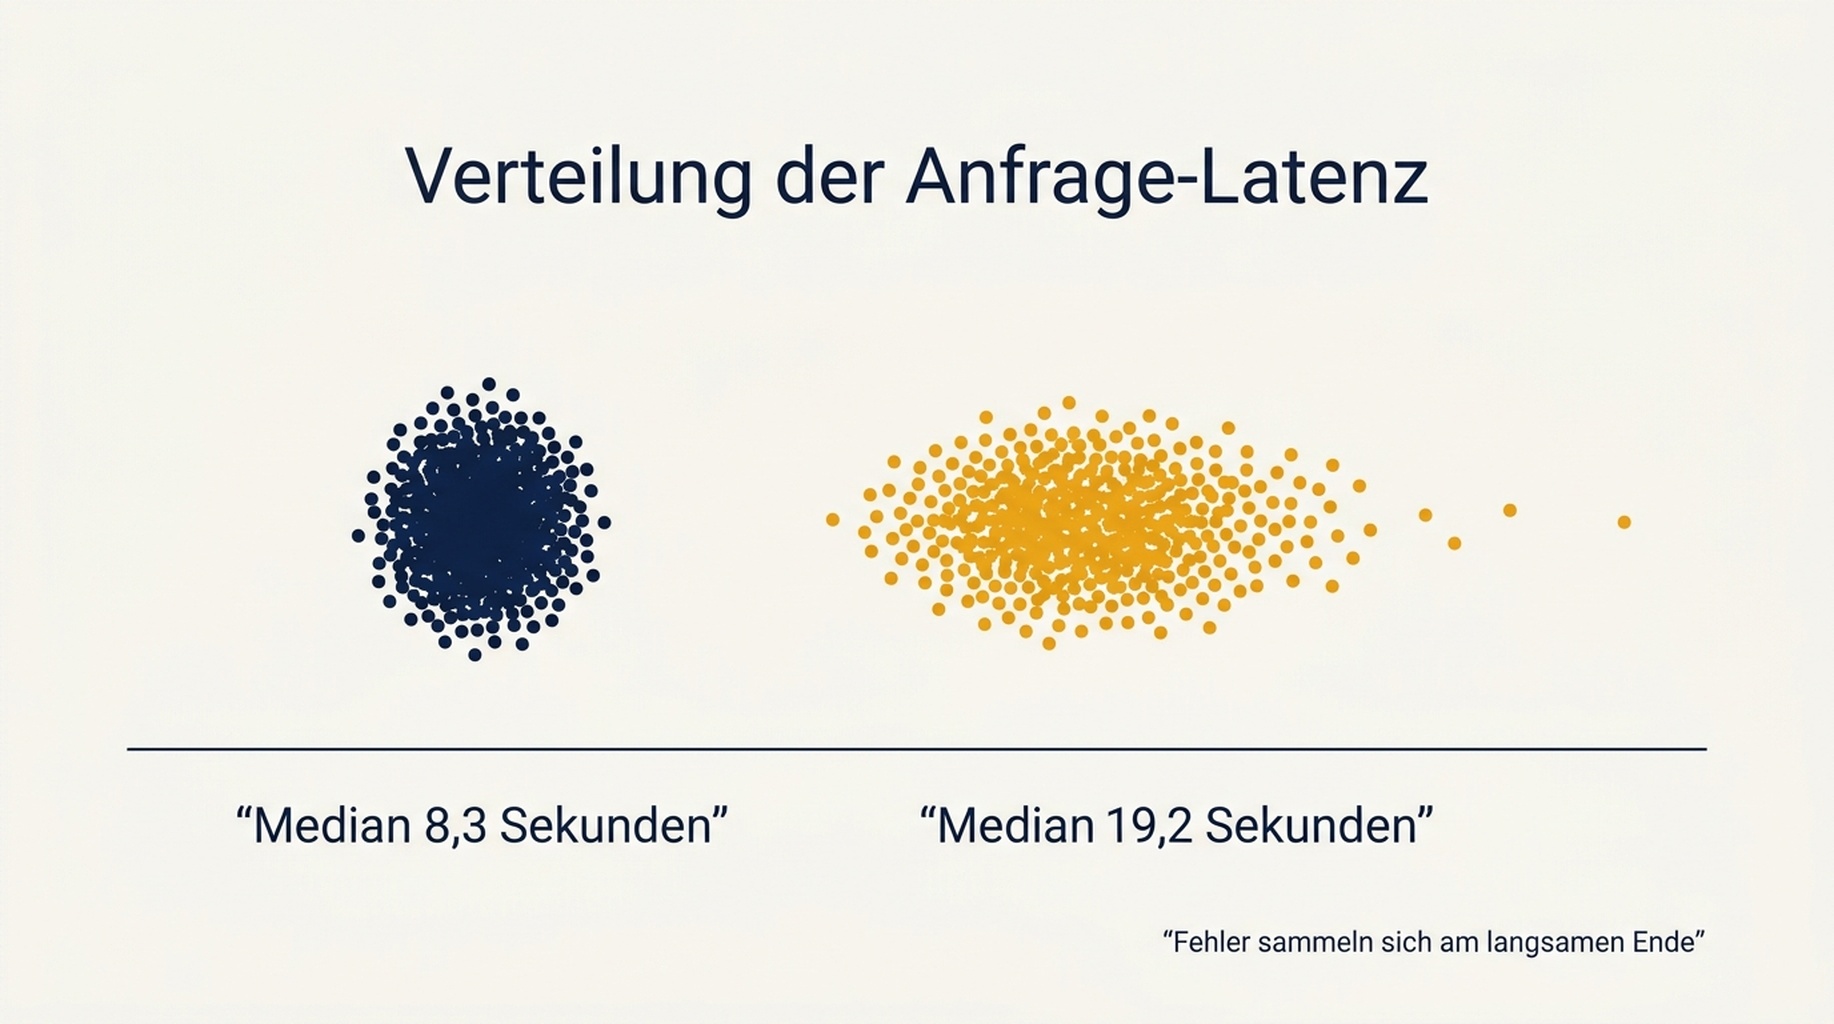
Tiefere Anfragen dauern länger, und die Ausfälle sammeln sich am langsamen Ende der Verteilung.
Was das für die Zahl in Ihrem Dashboard bedeutet
Dieselben 50 Keywords ergaben zwei verteidigungsfähige Sichtbarkeitszahlen, 2 Prozent und 44 Prozent, getrennt nur durch eine Tiefeneinstellung. Diese Schwankung ist größer als die meisten Ranking-Verschiebungen, für deren Erklärung Sie ein Quartal aufwenden werden.
Daraus folgen drei Regeln.
Setzen Sie die Tiefe danach, wo Sie ranken, nicht nach dem Standardwert des Tools. Ziehen Sie zuerst Ihre eigene Positionsverteilung. Liegen die meisten Ihrer Keywords zwischen 20 und 60, meldet Tiefe 10 fast nichts, und Sie schließen auf ein Sichtbarkeitsproblem, das Sie nicht haben.
Nennen Sie die Tiefe zusammen mit der Zahl. Ein Ranking-Bericht ohne Tiefeneinstellung ist nicht reproduzierbar. Dasselbe gilt für Standort, Sprache und Gerät.
Behandeln Sie "nicht gefunden" als Datum, nicht als Fehler. Achtundzwanzig der 50 Keywords lieferten bei Tiefe 100 kein Ergebnis für unsere Domain, und das ist die ehrliche Antwort. Ein Checker, der diese Zeilen verbirgt, verkürzt Ihre Keyword-Liste in die nutzloseste Richtung.
Prüfen Sie, ob der Bericht überhaupt SERP-Features enthält. In diesem Set war eine AI Overview bei 96 Prozent der Queries vorhanden. Ein reiner Positions-Export kann das nicht zeigen, und keine Tiefeneinstellung wird es hinzufügen.
Wenn das Ziel eine Zahl ist, die Sie über die Zeit verteidigen können, liegt die Tiefenfrage unter der Berichtsfrage. Unsere Notizen dazu, wie tief Google Ergebnisse wirklich ausliefert, behandeln, wo die Obergrenze liegt, eine eigene Quelle und eine Live-Quelle parallel zu betreiben behandelt die Konfiguration, die Sie dabei ehrlich hält, und was die Search Console sagen kann, was eine Live-Prüfung nicht kann behandelt die Hälfte, die dieser Lauf gar nicht berührt hat.
Grenzen
Zwei Grenzen, die man nennen sollte.
Fünfzig Keywords aus einer einzigen Property sind eine kleine Stichprobe, und die Teilung von 2 Prozent gegen 44 Prozent ist spezifisch für eine Website, deren Keywords tief stehen. Eine Property, die in den Top 10 der meisten ihrer Liste rankt, würde kaum einen Unterschied zwischen den Läufen sehen und für die Tiefe zu viel zahlen.
Die Latenz hängt von Anbieter, Standort und Zeitpunkt ab. Die absoluten Sekunden hier übertragen sich nicht, aber das Verhältnis zwischen den beiden Tiefen sollte ungefähr bestehen bleiben, weil der Unterschied echte Arbeit ist und keine Netzwerkstreuung.
Häufige Fragen
Welche Tiefe sollte ein Massen-Rank-Checker verwenden? Setzen Sie sie nach Ihrer eigenen Positionsverteilung. Tiefe 10 genügt, wenn Sie in den Top 10 ranken. Tiefe 20 deckt den größten Teil des praktischen Bereichs für $0,0035 pro Keyword ab. Tiefe 100 kostet $0,014 und lohnt nur, wenn Sie wirklich Positionen unterhalb von 50 verfolgen.
Wie lange dauert die Prüfung von 50 Keywords? Etwa eine Minute mit acht gleichzeitigen Workern für eine flache Prüfung und rund 2,3 Minuten für eine tiefe. Sequenziell dauern dieselben Prüfungen 7,5 und 16,6 Minuten, die Parallelität bringt also den Faktor acht bei der Laufzeit.
Warum scheiterte die tiefere Prüfung häufiger? Tiefere Anfragen brauchen länger zum Zusammenbauen, mit einem Median von 19,2 Sekunden gegenüber 8,3 im flachen Lauf, also stoßen sie eher auf ein Client- oder Anbieter-Timeout. Protokollieren Sie Ausfälle und wiederholen Sie sie, statt sie zu verwerfen.
Ist ein Massen-Rank-Checker genau, wenn er sagt, mein Keyword sei nicht gefunden worden? Normalerweise ja. In unserem Lauf hatten 28 der 50 Keywords tatsächlich kein Ergebnis für unsere Domain innerhalb von 100 Positionen. Prüfen Sie die Tiefeneinstellung, bevor Sie eine fehlende Zeile als Datenproblem behandeln.
Kostet es mehr, mehr Keywords zu prüfen, als tiefer zu prüfen? Die Tiefe bewegt die Rechnung pro Keyword, aber die Keywords vervielfachen die Summe. Von 50 auf 500 Keywords bei Tiefe 10 kostet zehnmal so viel und dauert zehnmal so lang, während Tiefe 100 pro Keyword siebenmal so viel kostet. Bepreisen Sie zuerst die Tiefe, die Sie brauchen, und kaufen Sie dann so viele Keywords, wie Sie überblicken können.
Auspia-Sicht: Bevor Sie eine einzige Seite ändern, prüfen Sie die Tiefeneinstellung Ihres Massen-Checkers. Sie ist die billigste Erklärung für eine überraschende Sichtbarkeitszahl, und in unserem Test machte sie den Faktor 22 zwischen zwei Läufen im Abstand von Minuten aus. Setzen Sie die Tiefe nach der Positionsverteilung, protokollieren Sie Ausfälle und lassen Sie die Einstellung im Bericht, damit die Zahl des nächsten Quartals vergleichbar ist.
Autor: Bennett Hayes, angewandter GEO-Analyst mit über 400 Implementierungsprüfungen bei Auspia. Schreibt über praktische Suchumsetzung, Messung und die Details, die einen Bericht verändern.