Masowy checker pozycji obiecuje jedno: wiele słów kluczowych, jeden raport. A to, co jest w tym raporcie, niemal w całości wyznacza jedno ustawienie, którego prawie nikt nie zmienia — jak głęboko sięga sprawdzenie.
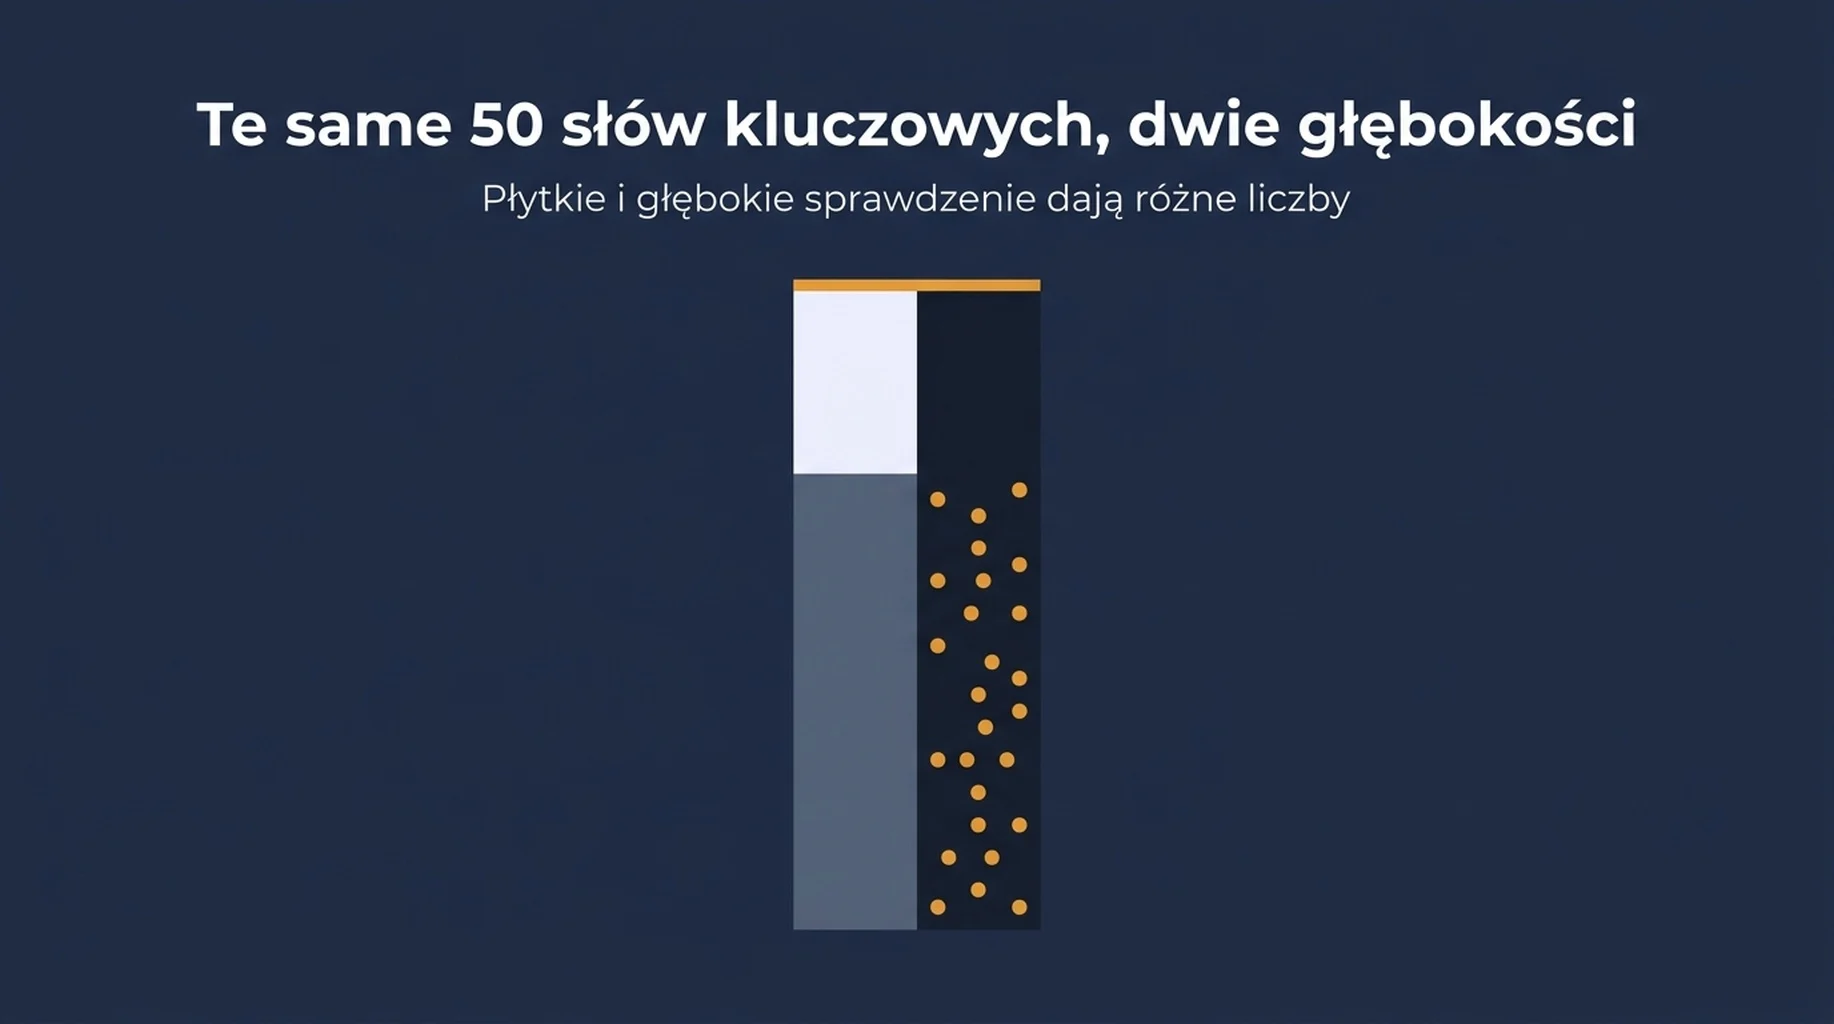
Przepuściliśmy te same 50 słów kluczowych dwa razy pod rząd 12 września 2026 roku, po tej samej wyszukiwarce, tej samej lokalizacji i tym samym urządzeniu. Różniła się tylko głębokość.
Na głębokości 10 sprawdzenie znalazło naszą domenę przy 1 ze 50 słów kluczowych. Na głębokości 100 znalazło ją przy 22 z nich.
Te same słowa kluczowe. Ta sama godzina. To samo API. Różnica nie polega na dokładności, bo oba przebiegi były dokładne. To pole widzenia i zmienia liczbę nagłówkową 22-krotnie.
Co przepuściliśmy
Pięćdziesiąt słów kluczowych z naszej własnej listy zapytań w Search Console, odfiltrowanych do zapytań łacińskich, żeby pokrywały się ze zbiorem wyników dla Stanów Zjednoczonych po angielsku. Oba przebiegi użyły żywych organicznych zapytań Google w rozdzielczości desktopowej, ośmiu równoległych workerów i limitu 300 sekund na zapytanie.
Ustawienie | Przebieg A | Przebieg B |
|---|---|---|
Słowa kluczowe | 50 | 50 |
Żądana głębokość | 10 | 100 |
Lokalizacja i język | USA, angielski | USA, angielski |
Urządzenie | Desktop | Desktop |
Współbieżność | 8 | 8 |
Rejestrowaliśmy opóźnienie każdego zapytania, naliczony koszt, liczbę wyników organicznych i to, czy pojawiła się nasza domena.
Wynik 1: te same słowa kluczowe, dwie różne odpowiedzi
Miara | Głębokość 10 | Głębokość 100 |
|---|---|---|
Sprawdzone słowa kluczowe | 50 | 50 |
Zapytania z użytecznym wynikiem | 50 | 43 |
Zapytania zakończone błędem | 0 | 7 |
Słowa kluczowe, przy których pojawiła się nasza domena | 1 | 22 |
W pierwszej 3 | 1 | 1 |
W pierwszej 20 | 1 | 1 |
W pierwszej 100 | 1 | 20 |
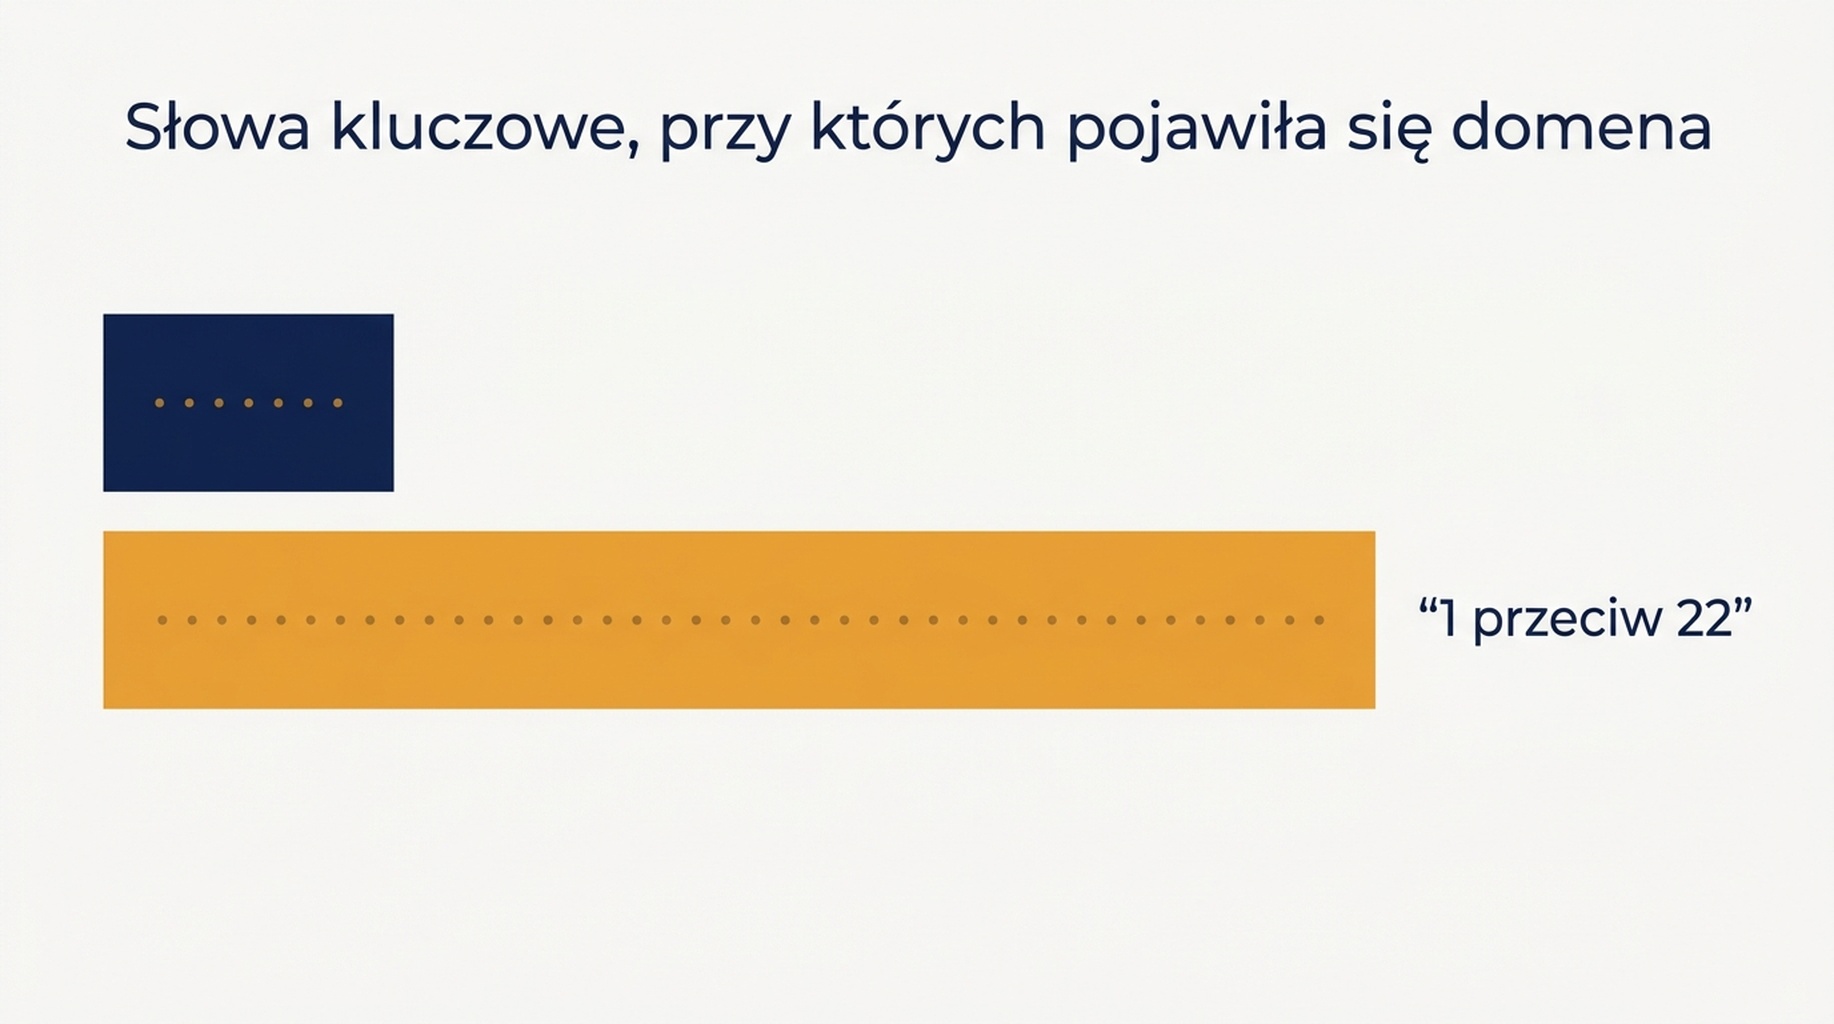
Zbiór słów kluczowych nie zmienił się między przebiegami. Zmieniło się tylko ustawienie głębokości.
Przeczytaj to uważnie, bo jego kształt to cała lekcja. Na głębokości 10 nasza widoczność w tym zbiorze wyglądała na 2 procent. Na głębokości 100 wyglądała na 44 procent. Żadna z tych liczb nie jest błędna i tylko jedna jest użyteczna.
Obraz góry strony prawie się nie ruszył. Jedno słowo kluczowe zostało w pierwszej 10 w obu przebiegach. Wszystko, co dodało głębokie sprawdzenie, leżało między pozycją 20 a pozycją 100, czyli dokładnie w tym paśmie, które masowy checker z domyślnymi ustawieniami ukrywa. Jeśli twój plan opiera się na checkerze pozycji ustawionym na pierwszą stronę, twoja linia bazowa nie jest pomiarem twojej widoczności. To pomiar twojej widoczności w obrębie pierwszej strony, a w tym zbiorze te dwie rzeczy różnią się o 21 słów kluczowych.
Drobny szczegół dodatkowy: dwa z 22 słów kluczowych znalezionych w głębokim przebiegu leżały poza bezwzględną pozycją 100. API zwraca nieco dalej niż żądana głębokość, więc raport „pierwszej 100” może zawierać pozycje powyżej 100. Odfiltruj je, jeśli ta etykieta jest dla ciebie ważna.
Wynik 2: koszt rośnie wraz z głębokością, mniej więcej siedem do jednego
Miara | Głębokość 10 | Głębokość 100 |
|---|---|---|
Łączny naliczony koszt | $0,1000 | $0,6230 |
Koszt za słowo kluczowe | $0,0020 | $0,0125 |
Zwrócone wyniki organiczne na słowo kluczowe | około 12 | około 97 |
Przebieg na głębokości 100 kosztował 6,2 raza więcej niż przebieg na głębokości 10 za te same 50 słów kluczowych, a ta różnica kupiła 21 dodatkowych słów kluczowych, przy których pojawiła się nasza domena.
Ten stosunek to uczciwa odpowiedź na najczęstsze pytanie o masowe checkery: czy warto płacić za więcej wyników. Warto, jeśli pozycjonujesz się poniżej pierwszej strony. Jeśli twoje słowa kluczowe trzymają się w pierwszej 10, głębszy przebieg zwraca w większości wiersze, których nigdy nie przeczytasz.
Jest ustawienie pośrednie i zwykle to ono jest właściwe. Głębokość 20 kosztuje $0,0035 za słowo kluczowe w naszym wcześniejszym cenniku, czyli o 75 procent więcej niż głębokość 10 i wciąż 75 procent zniżki wobec głębokości 100. Dla witryny w przedziale od 20. do 50. pozycji głębokość 20 łapie większość użytecznego ruchu za ułamek kosztu.
Naliczony koszt był też niższy, niż przewidywała cena za słowo kluczowe, bo siedem nieudanych zapytań nie zostało naliczonych. To odsetek błędów przebijający się na fakturze i zaraz do niego dojdziemy.
Wynik 3: raport ukrywa też, czy był AI Overview
Głębokość to nie jedyna rzecz, którą pomija raport zawierający wyłącznie pozycje.
Rejestrowaliśmy typy elementów SERP przy każdym zapytaniu w obu przebiegach. W przebiegu na głębokości 10 48 zapytań z 50 zwróciło AI Overview. W przebiegu na głębokości 100 zrobiły to 42 z 43 udanych zapytań.
Przebieg | Zapytania z AI Overview | Sprawdzone zapytania |
|---|---|---|
Głębokość 10 | 48 | 50 |
Głębokość 100 | 42 | 43 udane |
Ta liczba wyda się błędna każdemu, kto czytał nasz wcześniejszy zrzut, w którym AI Overview znalazły się w 4 z 40 zapytań o tematyce SEO. Obie są poprawne, a różnica tkwi w zbiorze zapytań, nie w metodzie.
Zbiór 40 zapytań był listą o tematyce SEO: narzędzia rankingowe, audyty, aktualizacje algorytmu i 15 zapytań nazywających narzędzie lub API. Ten zbiór 50 zapytań przyszedł z naszej własnej listy w Search Console, zdominowanej przez długie ogonowo sformułowania o użyteczności i porównaniu. Zapytania, za które witryna naprawdę dostaje wyświetlenia, mają inny kształt niż zapytania notowane przez zespół SEO, a obecność AI Overview podąża za tym kształtem.
Praktyczny punkt dla masowego sprawdzania jest węższy i bardziej niewygodny. Masowy checker pozycji zwraca pozycje. Nie zwraca elementu, który siedzi teraz nad pozycją 1, a w zbiorze zapytań, który naprawdę mamy, ten element był obecny w 96 procentach z nich.
Wynik 4: czas to opóźnienie podzielone przez współbieżność
Masowe sprawdzenie nie jest natychmiastowe, a powodem jest opóźnienie zapytania, nie jakiekolwiek przetwarzanie, które kontrolujesz.
Miara | Głębokość 10 | Głębokość 100 |
|---|---|---|
Czas rzeczywisty przy 8 workerach | 62,0 sekundy | 135,9 sekundy |
Najszybsze zapytanie | 2,6 sekundy | 8,1 sekundy |
Zapytanie medianowe | 8,3 sekundy | 19,2 sekundy |
Najwolniejsze zapytanie | 22,0 sekundy | 40,3 sekundy |
Suma czasów wszystkich zapytań | 451 sekund | 998 sekund |
Wynikają z tego dwie rzeczy.
Mediana opóźnienia wzrosła z głębokością ponad dwukrotnie, z 8,3 do 19,2 sekundy. Głębsze wyszukiwanie naprawdę dłużej się składa i dlatego masowy checker z krótkim limitem po stronie klienta pada na przebiegach głębokich, a nie na płytkich.
Czas rzeczywisty wyznacza współbieżność, nie szybkość API. Przepuść 50 słów kluczowych pojedynczo, a sprawdzenie na głębokości 10 zajmie około 7,5 minuty; przy ośmiu workerach zajmuje minutę. Jeśli twój masowy checker nie ma sterowania współbieżnością, to jedyne ustawienie, o które warto zapytać, bo daje ośmiokrotność w czasie bez żadnej różnicy w koszcie.
Wynik 5: głębszy przebieg zawiódł w 14 procentach przypadków
Siedem z 50 zapytań na głębokości 100 zawiodło. Żadne zapytanie na głębokości 10 nie zawiodło.
Przebieg | Błędy | Odsetek błędów |
|---|---|---|
Głębokość 10 | 0 z 50 | 0 procent |
Głębokość 100 | 7 z 50 | 14 procent |
Ponieważ nieudane zapytania nie zostały naliczone, przebieg na głębokości 100 kosztował też mniej niż $0,70 przewidywane przez cenę za słowo kluczowe, dlatego efektywny koszt za słowo kluczowe wyszedł $0,0125, a nie $0,014.
To ta część masowego sprawdzania, którą raporty pokazują najrzadziej. Narzędzie, które po cichu ponawia próby, to zamaskuje. Narzędzie, które tego nie robi, będzie po cichu zaniżać twoje pozycje, a błędy skupiają się na najwolniejszych zapytaniach, czyli tych głębokich, za które zapłaciłeś więcej.
Komunikat błędu był identyczny we wszystkich siedmiu: zadanie zakończyło się wynikami częściowymi, części stron nie udało się pobrać po kilku ponowieniach, a strony, których nie zwrócono, nie zostały naliczone. To poprawne zachowanie dostawcy i zarazem powód, dla którego masowe sprawdzenie zaniża wynik, zamiast się wywalić. Strona, która zawiodła, to nie słowo kluczowe, na które się nie pozycjonujesz. To niewiadoma, a raport, który rysuje ją jako pustą komórkę, po cichu zamienił niewiadomą w zaprzeczenie.
Jeśli budujesz własną pętlę, rejestruj błędy jako pełnoprawny wynik, zamiast je wyrzucać, i ponów błędy raz przed raportem.
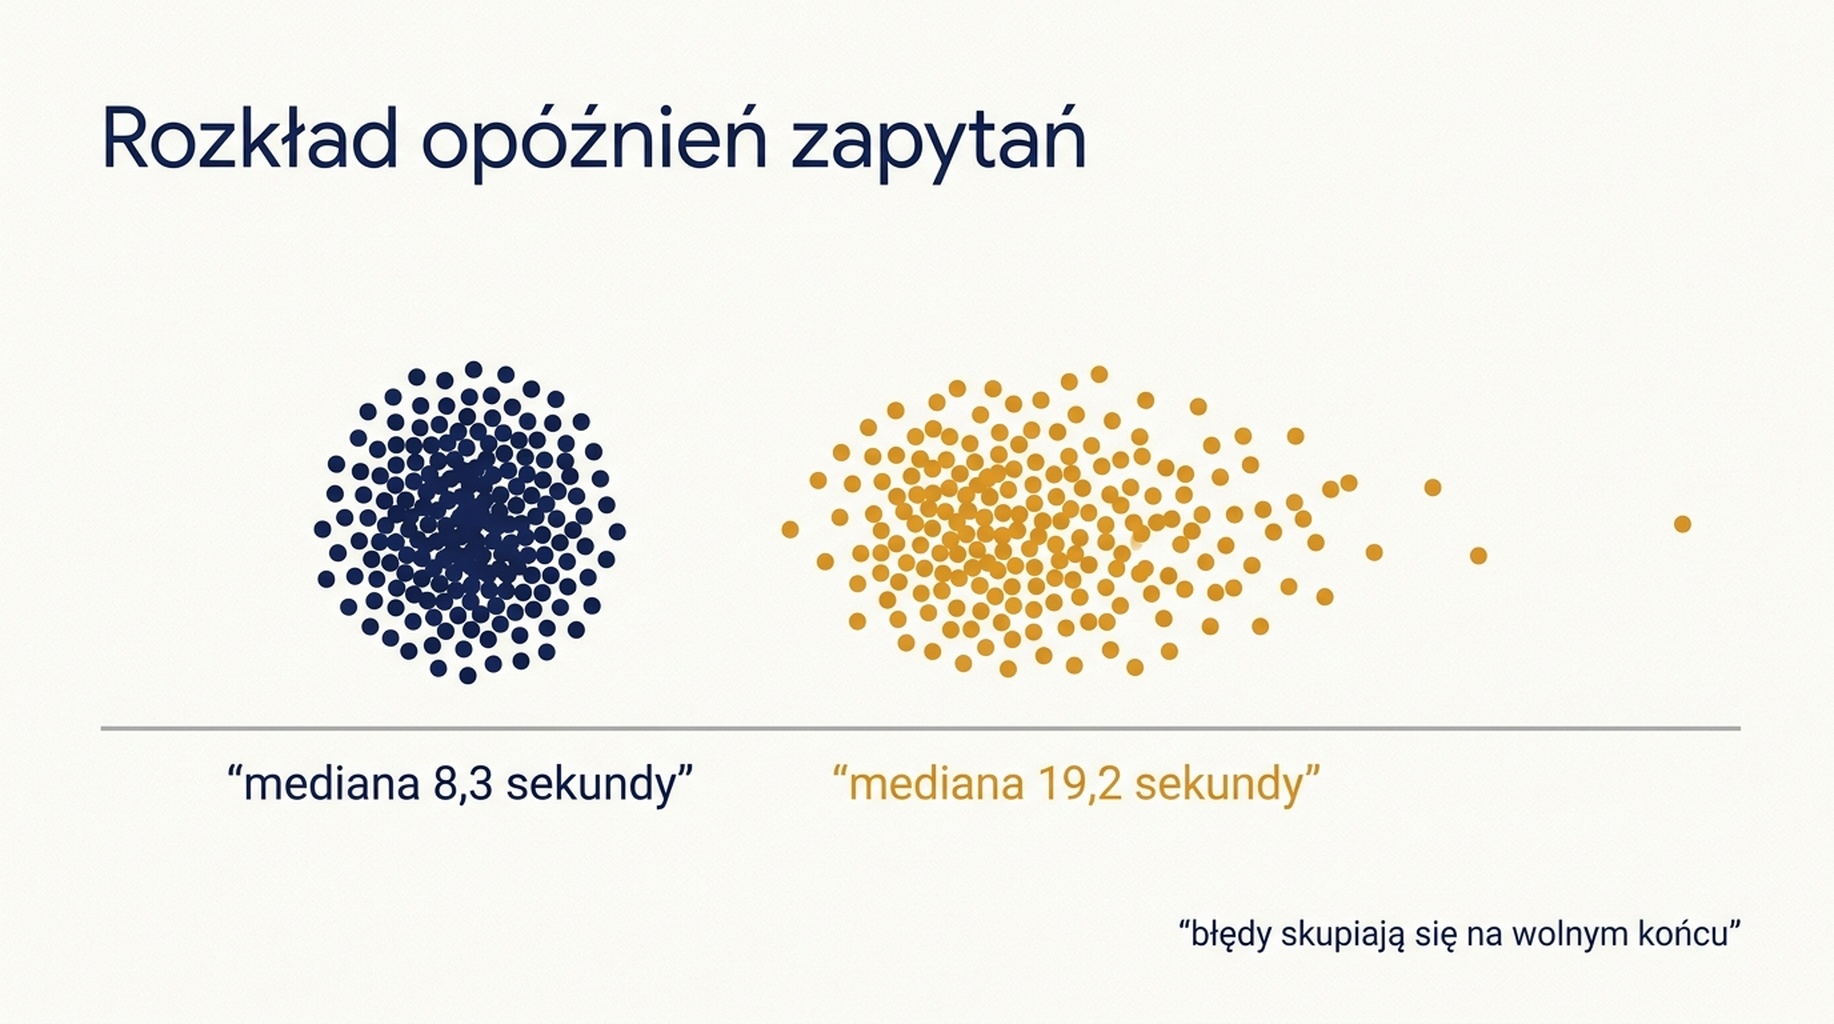
Głębsze zapytania trwają dłużej, a błędy skupiają się na wolnym końcu rozkładu.
Co to znaczy dla liczby na twoim pulpicie
Te same 50 słów kluczowych dało dwie obronne liczby widoczności, 2 procent i 44 procent, a dzieliło je tylko ustawienie głębokości. Ten rozrzut jest większy niż większość zmian rankingowych, na których wyjaśnienie poświęcisz cały kwartał.
Wynikają z tego trzy zasady.
Ustaw głębokość od tego, gdzie się pozycjonujesz, a nie od domyślnej wartości narzędzia. Wyciągnij najpierw własny rozkład pozycji. Jeśli większość twoich słów kluczowych jest między 20 a 60, głębokość 10 nie zaraportuje prawie nic i dojdziesz do wniosku, że masz problem z widocznością, którego nie masz.
Podawaj głębokość obok liczby. Raport rankingowy bez ustawienia głębokości nie jest odtwarzalny. Tak samo lokalizacja, język i urządzenie.
Traktuj „nie znaleziono” jako dane, nie jako błąd. Dwadzieścia osiem z 50 słów kluczowych nie zwróciło wyniku dla naszej domeny na głębokości 100 i to jest uczciwa odpowiedź. Checker, który ukrywa te wiersze, skraca twoją listę słów kluczowych w najmniej użytecznym kierunku.
Sprawdź, czy raport w ogóle zawiera elementy SERP. W tym zbiorze AI Overview był obecny w 96 procentach zapytań. Eksport samych pozycji tego nie pokaże i żadne ustawienie głębokości tego nie doda.
Jeśli celem jest liczba, której możesz bronić w czasie, pytanie o głębokość leży pod pytaniem o raportowanie. Nasze notatki o tym, jak głęboko Google naprawdę podaje wyniki, opisują, gdzie jest sufit, uruchamianie własnego źródła i źródła na żywo razem opisuje konfigurację, która trzyma cię w tym uczciwym, a co Search Console może powiedzieć, czego nie może sprawdzenie na żywo opisuje tę połowę, której ten przebieg w ogóle nie dotknął.
Ograniczenia
Dwa ograniczenia warte wskazania.
Pięćdziesiąt słów kluczowych z jednej usługi to mała próbka, a podział 2 procent przeciw 44 procentom jest charakterystyczny dla witryny, której słowa kluczowe siedzą głęboko. Usługa pozycjonująca się w pierwszej 10 na większości swojej listy prawie nie zobaczyłaby różnicy między przebiegami i przepłacałaby za głębokość.
Opóźnienie zależy od dostawcy, lokalizacji i momentu. Bezwzględne sekundy stąd się nie przeniosą, ale stosunek między dwiema głębokościami powinien się w przybliżeniu utrzymać, bo różnica to realna praca, a nie zmienność sieci.
Częste pytania
Jakiej głębokości powinien używać masowy checker pozycji? Ustaw ją od własnego rozkładu pozycji. Głębokość 10 wystarczy, jeśli jesteś w pierwszej 10. Głębokość 20 pokrywa większość praktycznego zakresu za $0,0035 za słowo kluczowe. Głębokość 100 kosztuje $0,014 i ma sens tylko wtedy, gdy naprawdę śledzisz pozycje poniżej 50.
Ile czasu zajmuje sprawdzenie 50 słów kluczowych? Około minuty przy ośmiu równoległych workerach dla sprawdzenia płytkiego i około 2,3 minuty dla głębokiego. Przy przebiegu sekwencyjnym te same sprawdzenia zajmą 7,5 i 16,6 minuty, więc współbieżność daje ośmiokrotność w czasie.
Dlaczego głębokie sprawdzenie zawodziło częściej? Głębsze zapytania dłużej się składają, z medianą 19,2 sekundy wobec 8,3 w przebiegu płytkim, więc częściej trafiają na limit klienta lub dostawcy. Rejestruj błędy i ponawiaj je, zamiast wyrzucać.
Czy masowy checker pozycji jest dokładny, gdy mówi, że mojego słowa kluczowego nie znaleziono? Zwykle tak. W naszym przebiegu 28 z 50 słów kluczowych naprawdę nie miało wyniku dla naszej domeny w obrębie 100 pozycji. Sprawdź ustawienie głębokości, zanim uznasz brakujący wiersz za problem z danymi.
Czy sprawdzanie większej liczby słów kluczowych kosztuje więcej niż głębsze sprawdzanie? Głębokość przesuwa fakturę za słowo kluczowe, ale słowa kluczowe mnożą sumę. Przejście z 50 na 500 słów kluczowych na głębokości 10 kosztuje dziesięć razy więcej i zajmuje dziesięć razy dłużej, podczas gdy głębokość 100 kosztuje siedem razy więcej za słowo kluczowe. Wyceń potrzebną głębokość, a potem kup tyle słów kluczowych, ile zdołasz przejrzeć.
Spojrzenie Auspia: zanim zmienisz choć jedną stronę, sprawdź ustawienie głębokości w swoim masowym checkerze. To najtańsze wyjaśnienie zaskakującej liczby widoczności, a w naszym teście odpowiadało za 22-krotną różnicę między dwoma przebiegami dzielonymi minutami. Ustaw głębokość od rozkładu pozycji, rejestruj błędy i zostaw ustawienie w raporcie, żeby liczba z następnego kwartału była porównywalna.
Autor: Bennett Hayes, analityk stosowanego GEO z ponad 400 przeglądami wdrożeń w Auspia. Pisze o praktycznym wykonywaniu wyszukiwania, pomiarach i szczegółach, które zmieniają raport.