批量排名检查器只承诺一件事:把许多关键词汇总成一份报告。而报告里有什么,几乎完全由一个大多数人从不改动的设置决定——检查往下探多深。
我们在 2026 年 9 月 12 日,把同一批 50 个关键词,针对同一个搜索引擎、同一个地区、同一台设备,背靠背跑了两遍。唯一不同的是深度。
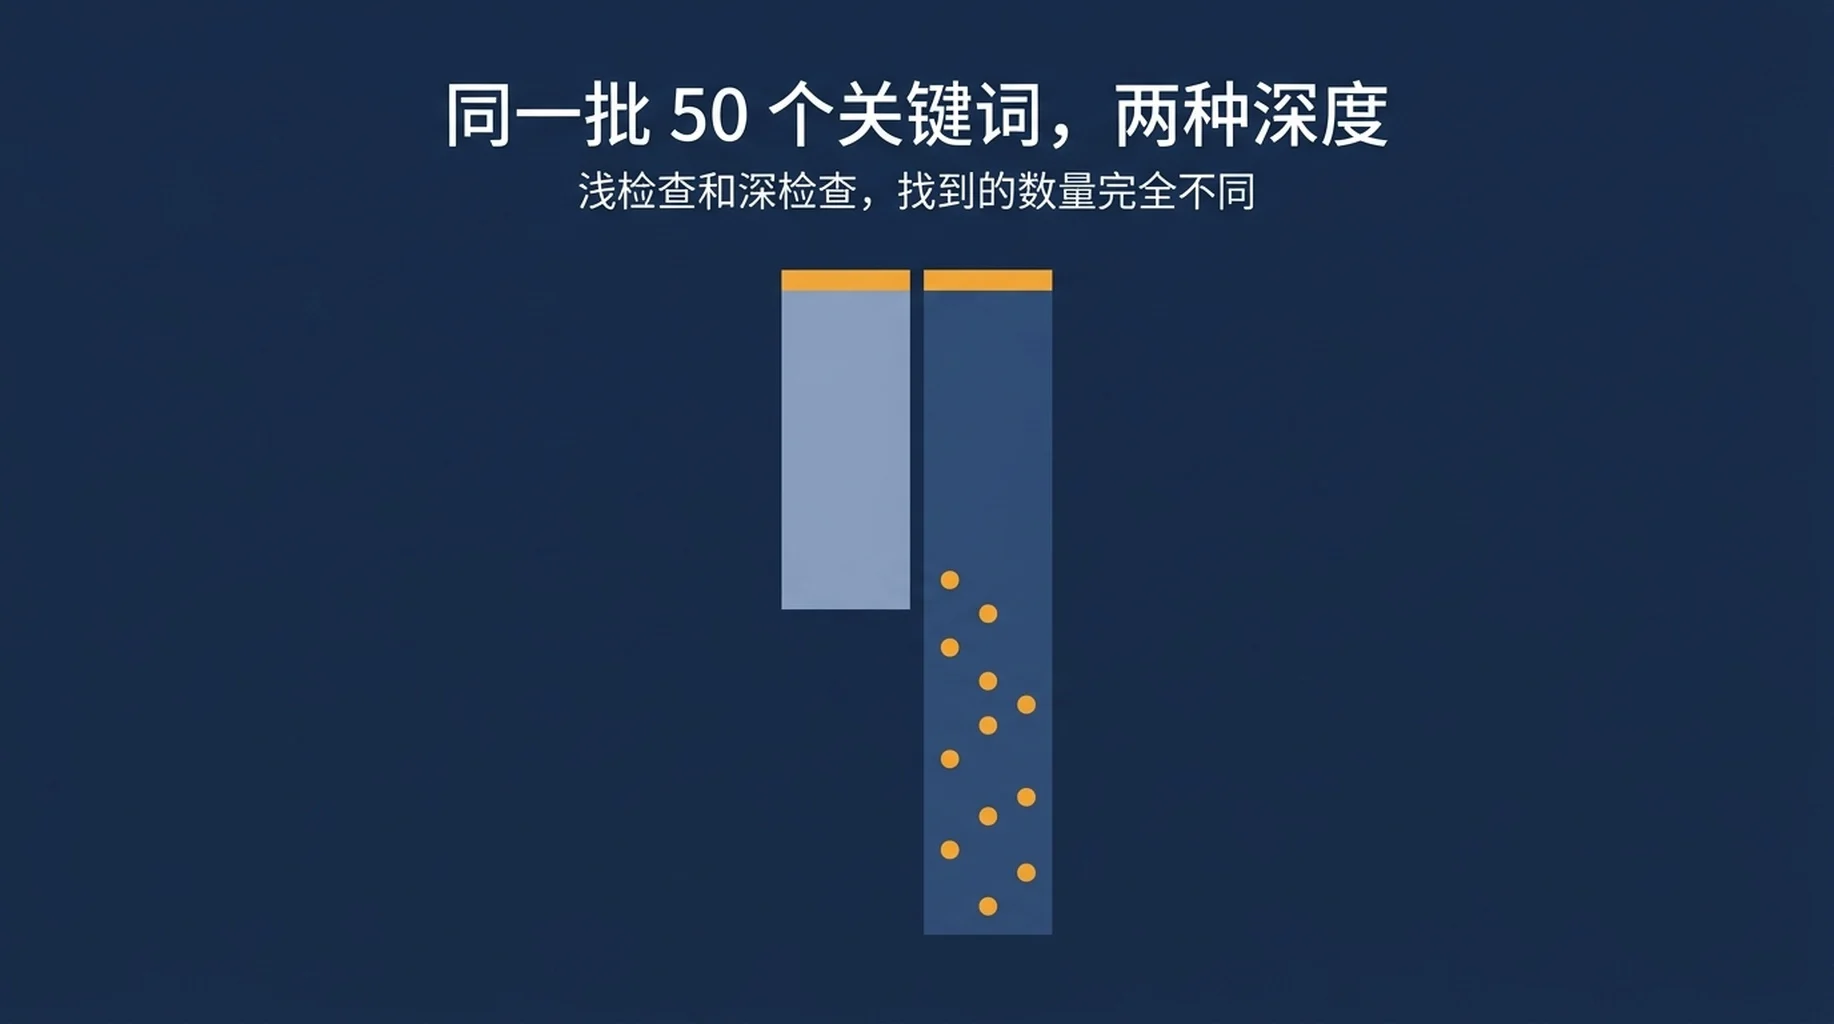
在深度 10 下,检查在 50 个关键词中的 1 个里找到了我们的域名。在深度 100 下,它在其中 22 个里找到了我们的域名。
同样的关键词。同一个小时。同一个 API。这个差别不是准确度,因为两次运行都是准确的。这是视野范围,而它把标题数字改变了 22 倍。
我们跑了什么
50 个关键词取自我们自己的 Search Console 查询列表,并筛选为拉丁字母查询,以便与美国、英语的结果集匹配。两次运行都使用桌面分辨率下的实时 Google 自然结果请求、8 个并发工作进程,以及每次请求 300 秒的超时。
设置 | 运行 A | 运行 B |
|---|---|---|
关键词 | 50 | 50 |
请求的深度 | 10 | 100 |
地区与语言 | 美国、英语 | 美国、英语 |
设备 | 桌面 | 桌面 |
并发数 | 8 | 8 |
我们记录了每次请求的延迟、计费成本、自然结果数量,以及我们的域名是否出现。
结果 1:同样的关键词,两个不同的答案
指标 | 深度 10 | 深度 100 |
|---|---|---|
检查的关键词 | 50 | 50 |
返回可用结果的请求 | 50 | 43 |
失败的请求 | 0 | 7 |
我们的域名出现的关键词 | 1 | 22 |
进入前 3 名 | 1 | 1 |
进入前 20 名 | 1 | 1 |
进入前 100 名 | 1 | 20 |
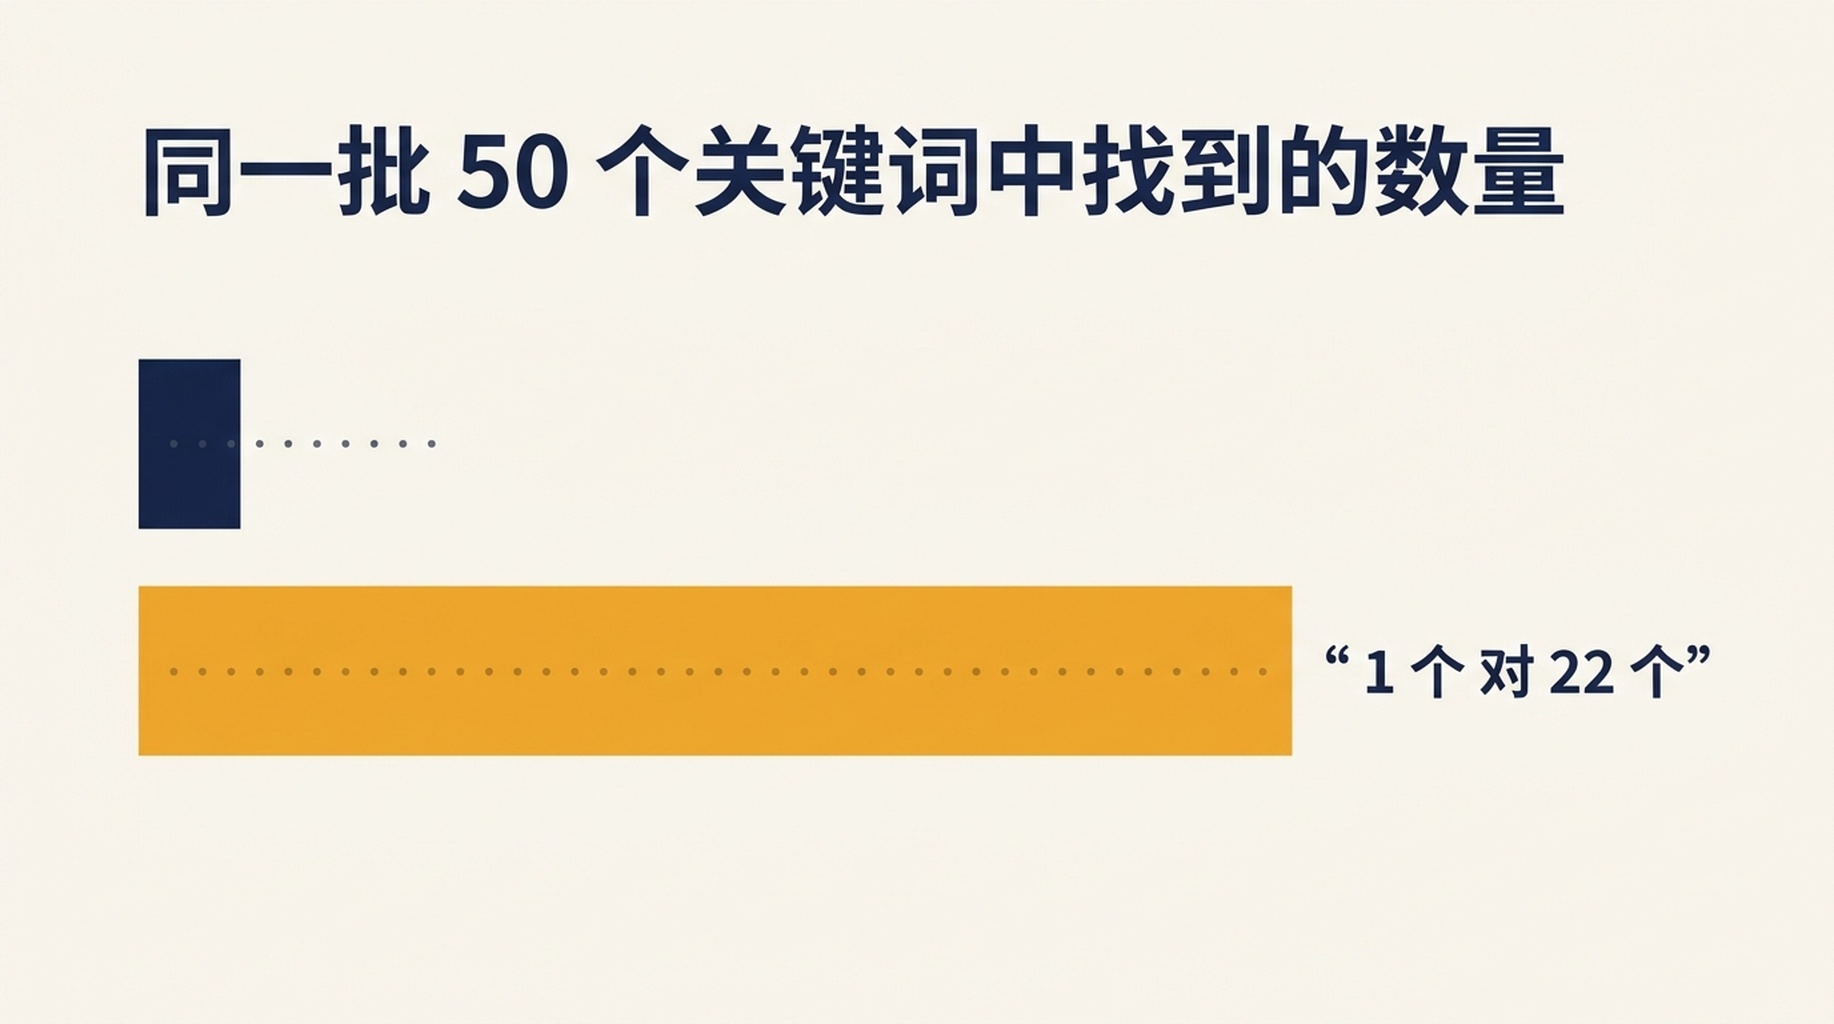
两次运行之间关键词集合没有变化,变的只是深度设置。
这一点要仔细读,因为它的形状本身就是全部的教训。在深度 10 下,我们在这批关键词上的可见度看起来是 2%。在深度 100 下看起来是 44%。两个数字都没错,而只有一个是可用的。
页面顶部的图景几乎没有变化。有 1 个关键词在两次运行中都落在前 10 名之内。更深的检查所增加的一切都位于第 20 名到第 100 名之间,而这正是默认设置的批量检查器所隐藏的区间。如果你的计划建立在把排名检查器设为首页之上,那你的基线就不是对可见度的测量,而是对首页之内可见度的测量,而在这批关键词上两者相差 21 个关键词。
一个小的补充细节:深跑找到的 22 个关键词中有 2 个位于绝对第 100 名之外。API 会略微超出所请求的深度返回,所以一份"前 100 名"报告可能包含 100 名之后的排名。如果这个标签对你重要,就把它们过滤掉。
结果 2:成本随深度增长,约为 7 比 1
指标 | 深度 10 | 深度 100 |
|---|---|---|
计费成本合计 | $0.1000 | $0.6230 |
每个关键词的成本 | $0.0020 | $0.0125 |
每个关键词返回的自然结果 | 约 12 | 约 97 |
深度 100 的运行对同样的 50 个关键词花掉了深度 10 的 6.2 倍成本,而这个差额买到了我们域名出现的另外 21 个关键词。
这个比率是对批量检查器最常见问题的诚实回答,即为更多结果付费是否值得。如果你排名在首页之后,那就值得。如果你的关键词停留在前 10 名,深跑返回的大多是你永远不会读的行。
有一个中间设置,而且通常它才是对的。深度 20 在我们早先的定价中是每个关键词 $0.0035,比深度 10 贵 75%,但相对深度 100 仍是 75% 的折扣。对于一个处在第 20 到第 50 名区间的站点,深度 20 能以很小的一部分成本捕捉到大部分有用的变化。
计费成本也比按关键词单价预测的更低,因为那 7 个失败的请求没有计费。这就是失败率出现在账单上的方式,我们马上就会讲到它。
结果 3:报告还隐藏了当时有没有 AI Overview
只给排名的报告漏掉的不只是深度。
我们在两次运行的每次请求上都记录了 SERP 元素类型。在深度 10 的运行中,50 个查询里有 48 个返回了 AI Overview。在深度 100 的运行中,43 个成功请求里有 42 个返回了。
运行 | 带有 AI Overview 的查询 | 检查的查询 |
|---|---|---|
深度 10 | 48 | 50 |
深度 100 | 42 | 43 个成功请求 |
对读过我们早先那份快照的人来说,这个数字看起来是错的——那份快照在 40 个 SEO 主题查询中的 4 个里发现了 AI Overview。两者都对,区别在查询集而不在方法。
那 40 个查询的集合是一份 SEO 主题清单:排名工具、审计、算法更新,以及 15 个点名某个工具或 API 的查询。这 50 个查询的集合来自我们自己的 Search Console 查询列表,其中以长尾的工具型和对比型措辞为主。一个站点真正获得展示的查询,与 SEO 团队记录下来的查询形状不同,而 AI Overview 的出现跟着这个形状走。
对批量检查来说,实务上的要点更窄也更烦人。批量排名检查器返回的是排名。它不返回如今坐在第 1 名之上的那个元素,而在我们真正拥有的这个查询集上,那个元素出现在 96% 的查询里。
结果 4:时间等于延迟除以并发数
批量检查不是瞬间完成的,原因是请求延迟,而不是你能控制的任何处理。
指标 | 深度 10 | 深度 100 |
|---|---|---|
8 个工作进程下的实际耗时 | 62.0 秒 | 135.9 秒 |
最快的请求 | 2.6 秒 | 8.1 秒 |
中位请求 | 8.3 秒 | 19.2 秒 |
最慢的请求 | 22.0 秒 | 40.3 秒 |
所有请求时间之和 | 451 秒 | 998 秒 |
由此得出两点。
延迟中位数随深度翻了一倍多,从 8.3 秒升到 19.2 秒。更深的搜索组装起来确实更慢,这正是客户端超时很短的批量检查器会在深跑上失败、而在浅跑上不会的原因。
实际耗时由并发数决定,而不是由 API 的速度决定。把 50 个关键词串行跑一遍,深度 10 的检查要花约 7.5 分钟;8 个工作进程下只要 1 分钟。如果你的批量检查器没有并发控制,那就是唯一值得去问的设置,因为在成本没有差别的情况下它值 8 倍的时间。
结果 5:深跑有 14% 的失败率
深度 100 的 50 次请求中有 7 次失败。深度 10 的请求一次都没有失败。
运行 | 失败数 | 失败率 |
|---|---|---|
深度 10 | 50 次中 0 次 | 0% |
深度 100 | 50 次中 7 次 | 14% |
由于失败的请求没有计费,深度 100 的运行也比按关键词单价预测的 $0.70 更便宜,这就是为什么有效单关键词成本落在 $0.0125 而不是 $0.014。
这是批量检查中报告很少展示的部分。一个默默重试的工具会把它盖过去。一个不重试的工具会悄悄少报你的排名,而失败集中在最慢的请求上——那正是你额外付费买来的深请求。
7 次请求的错误信息完全相同:任务带着部分结果完成,有些页面在多次重试后仍无法抓取,未返回的页面没有计费。这是服务方应有的行为,也正是批量检查会少报而不是崩溃的原因。一个失败的页面并不是你没有排名的关键词,它是一个未知;而把未知渲染成空白单元格的报告,已经悄悄把未知变成了否定。
如果你自己写循环,就把失败记录为一等结果而不是丢弃,并在出报告前把失败重试一次。
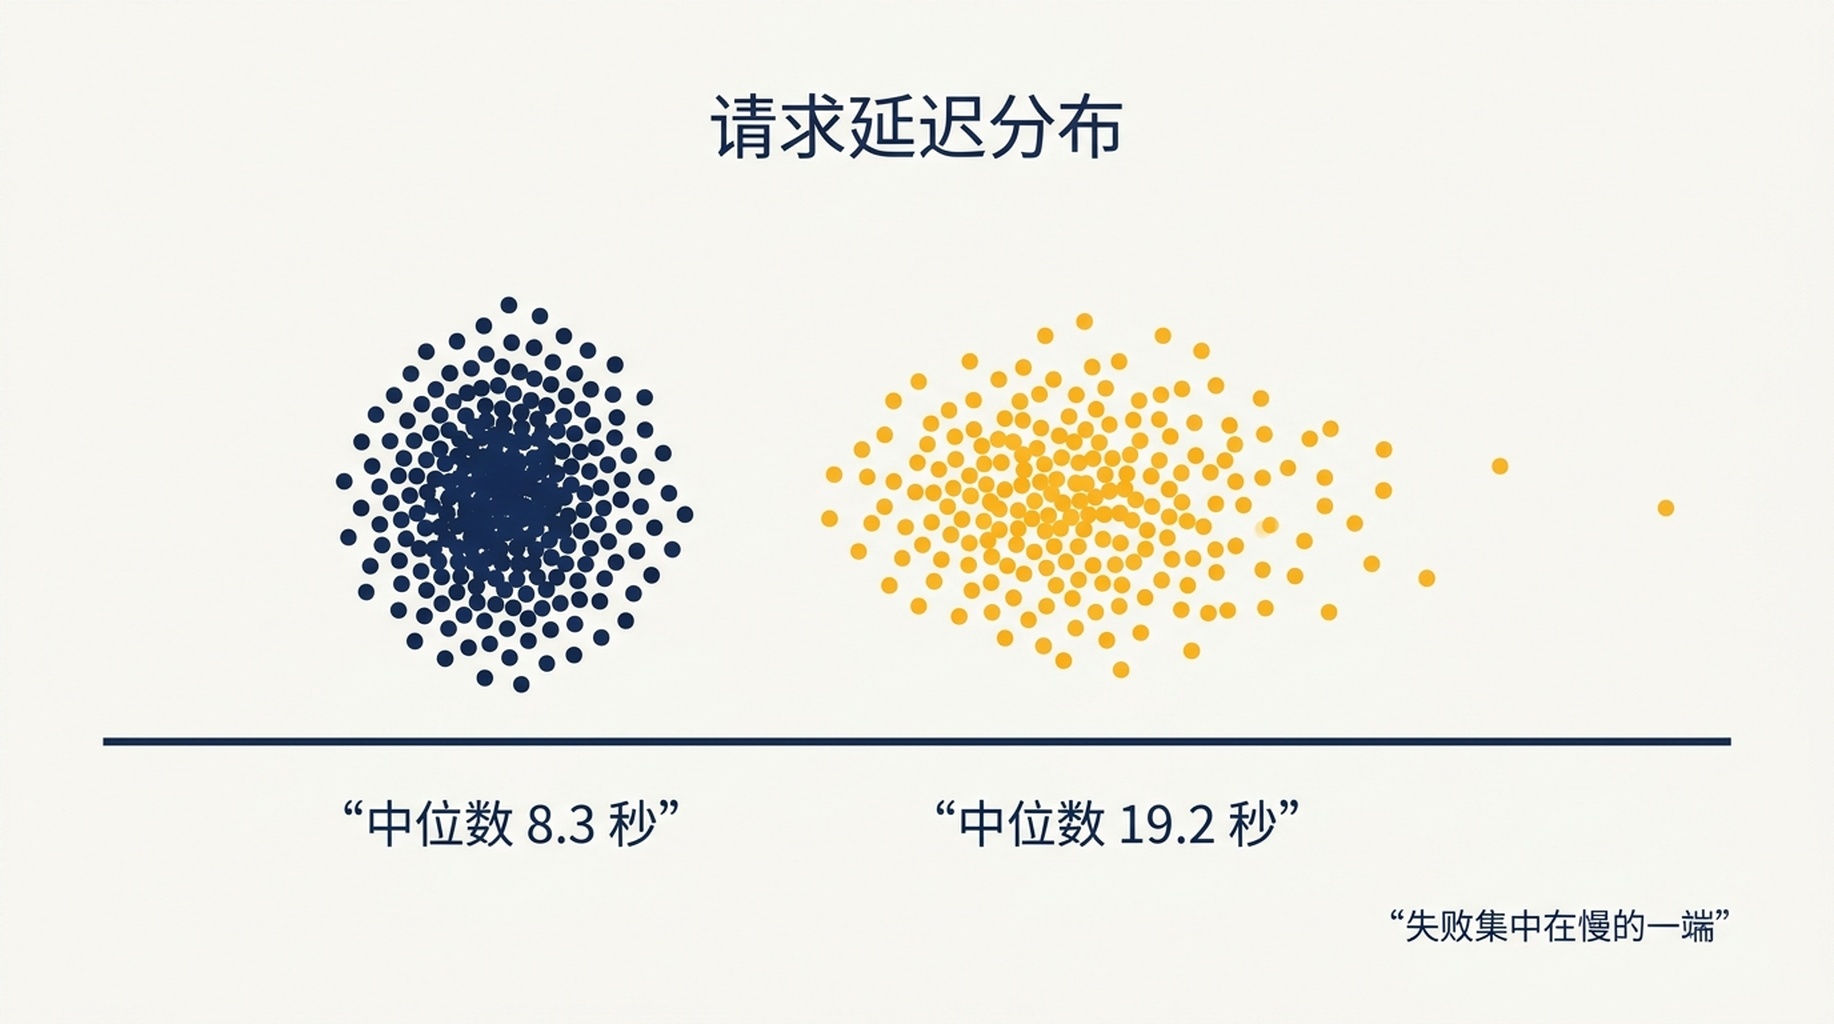
更深的请求耗时更长,而失败集中在分布的慢端。
这对你仪表盘上那个数字意味着什么
同样的 50 个关键词产生了两个都站得住脚的可见度数字,2% 和 44%,把它们分开的只是一个深度设置。这个摆动幅度比你花一个季度去解释的大多数排名变化都要大。
由此推出三条规则。
深度要按你的排名位置来定,而不是按工具的默认值来定。 先把你自己的排名分布拉出来。如果你大多数关键词位于第 20 名到第 60 名之间,深度 10 几乎什么都报不出来,而你会得出一个你其实并不存在的可见度问题。
把深度和数字一起报出来。 没有深度设置的排名报告不可复现。地区、语言和设备也一样。
把"未找到"当作数据,而不是错误。 50 个关键词里有 28 个在深度 100 下也没有返回我们域名的结果,而这就是诚实的答案。一个把这些行藏起来的检查器,是在朝最没用的方向缩短你的关键词列表。
确认报告到底有没有包含 SERP 功能。 在这批关键词上,AI Overview 出现在 96% 的查询里。只给排名的导出无法显示这一点,任何深度设置也不会把它补上。
如果目标是随时间推移站得住脚的数字,那么深度问题就在报告问题之下。我们关于 Google 实际会把结果提供到多深的笔记讲了上限在哪里,同时运行第一方来源和实时来源讲了让你对此保持诚实的配置,而 Search Console 能告诉你哪些实时检查做不到的事讲的则是这次运行完全没有触及的那一半。
局限
有两点局限值得说明。
来自一个站点的 50 个关键词是小样本,而 2% 对 44% 这个分裂,是关键词位置很深的站点所特有的。一个在列表大部分词上都排在前 10 名的站点,两次运行之间几乎看不到差别,而且是在为深度过度付费。
延迟取决于服务方、地区和当下时刻。这里的绝对秒数不会迁移,但两个深度之间的比率应当大致保持,因为差别是真实的工作量而不是网络波动。
常见问题
批量排名检查器应该用多深? 按你自己的排名分布来定。如果你排在前 10 名,深度 10 就够了。深度 20 以每个关键词 $0.0035 覆盖了大部分实用区间。深度 100 要花 $0.014,只有在你确实追踪第 50 名之后的排名时才值得。
检查 50 个关键词要多久? 8 个并发工作进程下,浅检查约 1 分钟,深检查约 2.3 分钟。串行运行时同样的检查要 7.5 分钟和 16.6 分钟,所以并发在实际耗时上值 8 倍。
为什么深检查失败得更频繁? 更深的请求组装起来更久,中位数 19.2 秒对浅跑的 8.3 秒,所以更容易撞上客户端或服务方的超时。要把失败记录下来并重试,而不是丢弃。
如果批量排名检查器说我的关键词未找到,它准确吗? 通常准确。在我们的运行中,50 个关键词里有 28 个在 100 名之内确实没有我们域名的结果。在把缺失的行当成数据问题之前,先检查深度设置。
检查更多关键词比检查得更深更贵吗? 深度改变的是每个关键词的账单,而关键词会成倍放大总额。在深度 10 下从 50 个增加到 500 个关键词,成本是 10 倍、耗时也是 10 倍,而深度 100 每个关键词贵 7 倍。先为你需要的深度定价,再买你审得过来的关键词数量。
Auspia 观点:在改动任何一个页面之前,先看你的批量检查器的深度设置。它是对一个令人意外的可见度数字最便宜的解释,在我们的测试中,它造成了相隔几分钟的两次运行之间 22 倍的差距。深度要按排名分布来定,记录失败,并把设置留在报告里,这样下个季度的数字才可比。
作者:Bennett Hayes,Auspia 应用 GEO 分析师,负责 400 多次实施评审。撰写关于实务性搜索执行、测量,以及那些会改变一份报告的细节的文章。