一括順位チェッカーが約束するのはひとつのこと、たくさんのキーワードを1つのレポートにまとめることだ。そのレポートに何が載るかは、ほとんど誰も変えないある設定でほぼ決まる。チェックがどこまで深く潜るか、である。
私たちは2026年9月12日、同じ50個のキーワードを、同じ検索エンジン、同じ地域、同じデバイスに対して続けて2回実行した。違っていたのは深さだけだ。
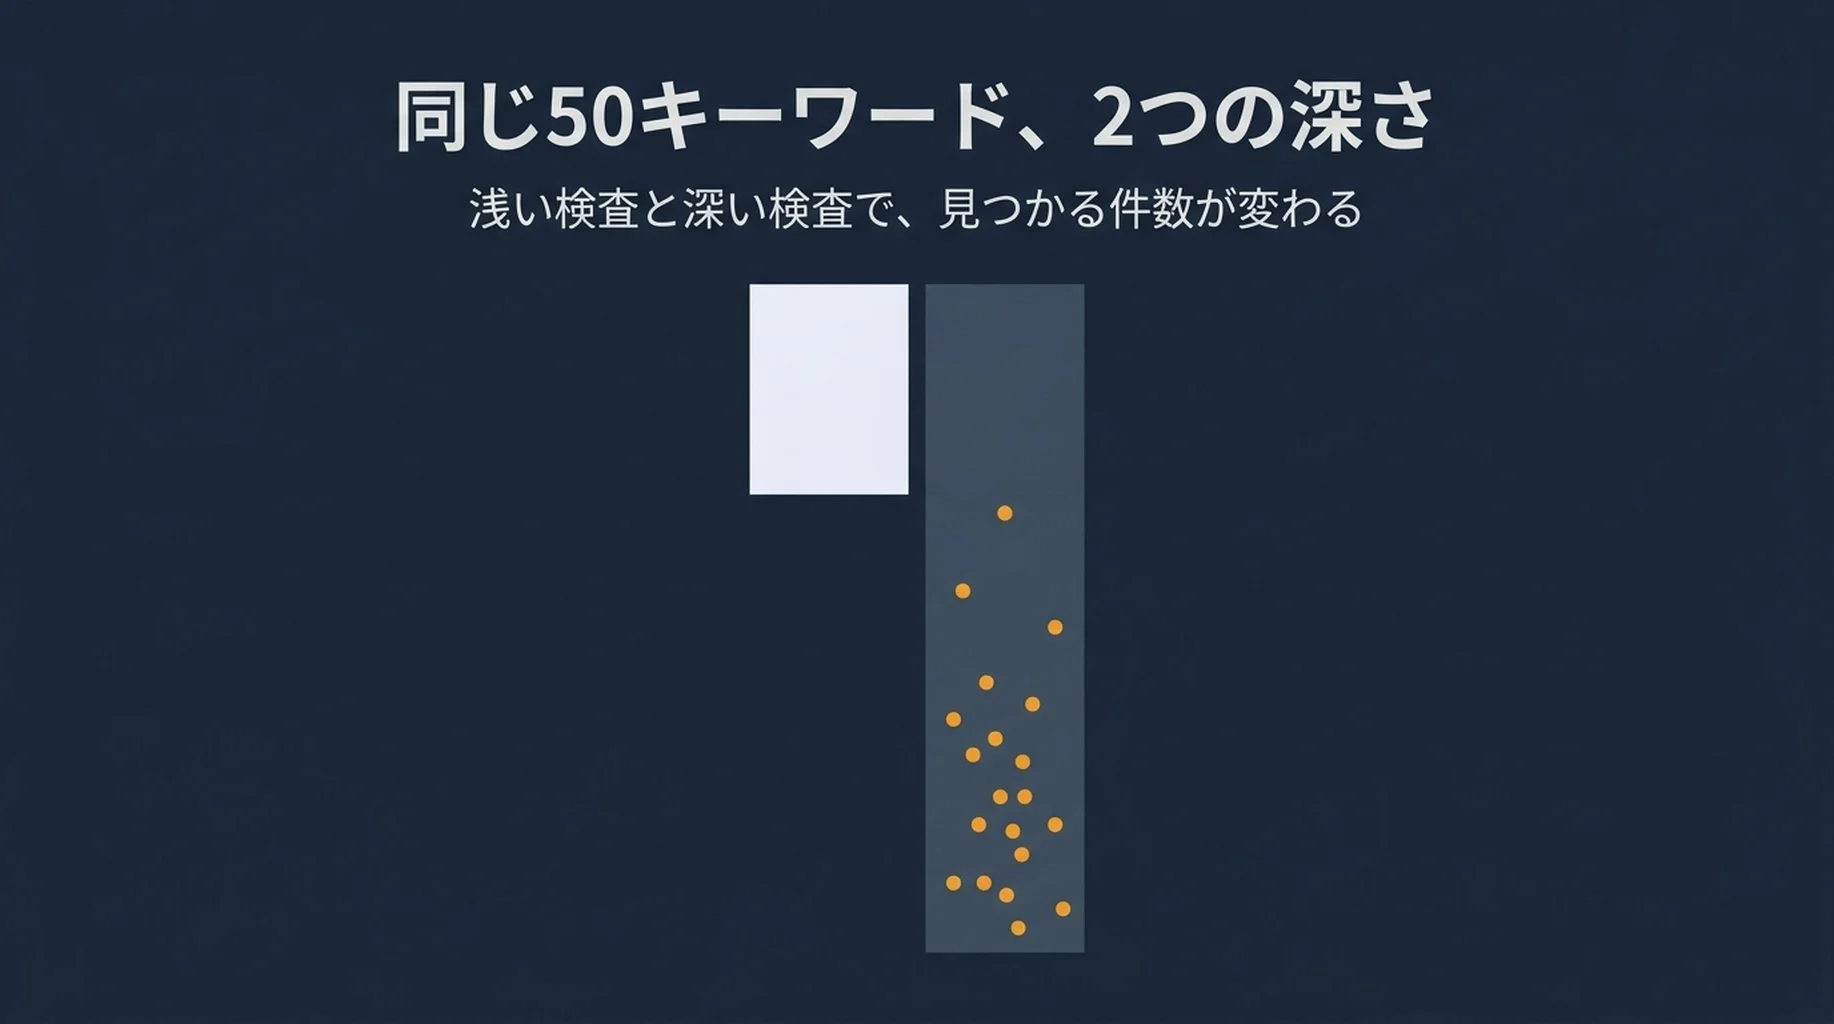
深さ10では、チェックは50個のうち1個のキーワードで私たちのドメインを見つけた。深さ100では、50個のうち22個で見つけた。
同じキーワード。同じ時間帯。同じAPI。この差は精度ではない。どちらの実行も正確だった。これは視野の広さであり、見出しの数字を22倍変えてしまう。
何を実行したか
50個のキーワードは私たち自身の Search Console のクエリ一覧から取り、米国・英語の結果セットと一致するようラテン文字のクエリに絞った。どちらの実行も、デスクトップ解像度でのライブ Google オーガニックリクエスト、並列ワーカー8、1リクエストあたり300秒のタイムアウトを使った。
設定 | 実行A | 実行B |
|---|---|---|
キーワード | 50 | 50 |
要求した深さ | 10 | 100 |
地域と言語 | 米国、英語 | 米国、英語 |
デバイス | デスクトップ | デスクトップ |
並列数 | 8 | 8 |
リクエストごとのレイテンシ、課金コスト、オーガニック結果件数、そして私たちのドメインが現れたかどうかを記録した。
結果1:同じキーワード、2つの答え
指標 | 深さ10 | 深さ100 |
|---|---|---|
チェックしたキーワード | 50 | 50 |
使用可能な結果を返したリクエスト | 50 | 43 |
失敗したリクエスト | 0 | 7 |
私たちのドメインが現れたキーワード | 1 | 22 |
上位3位以内 | 1 | 1 |
上位20位以内 | 1 | 1 |
上位100位以内 | 1 | 20 |
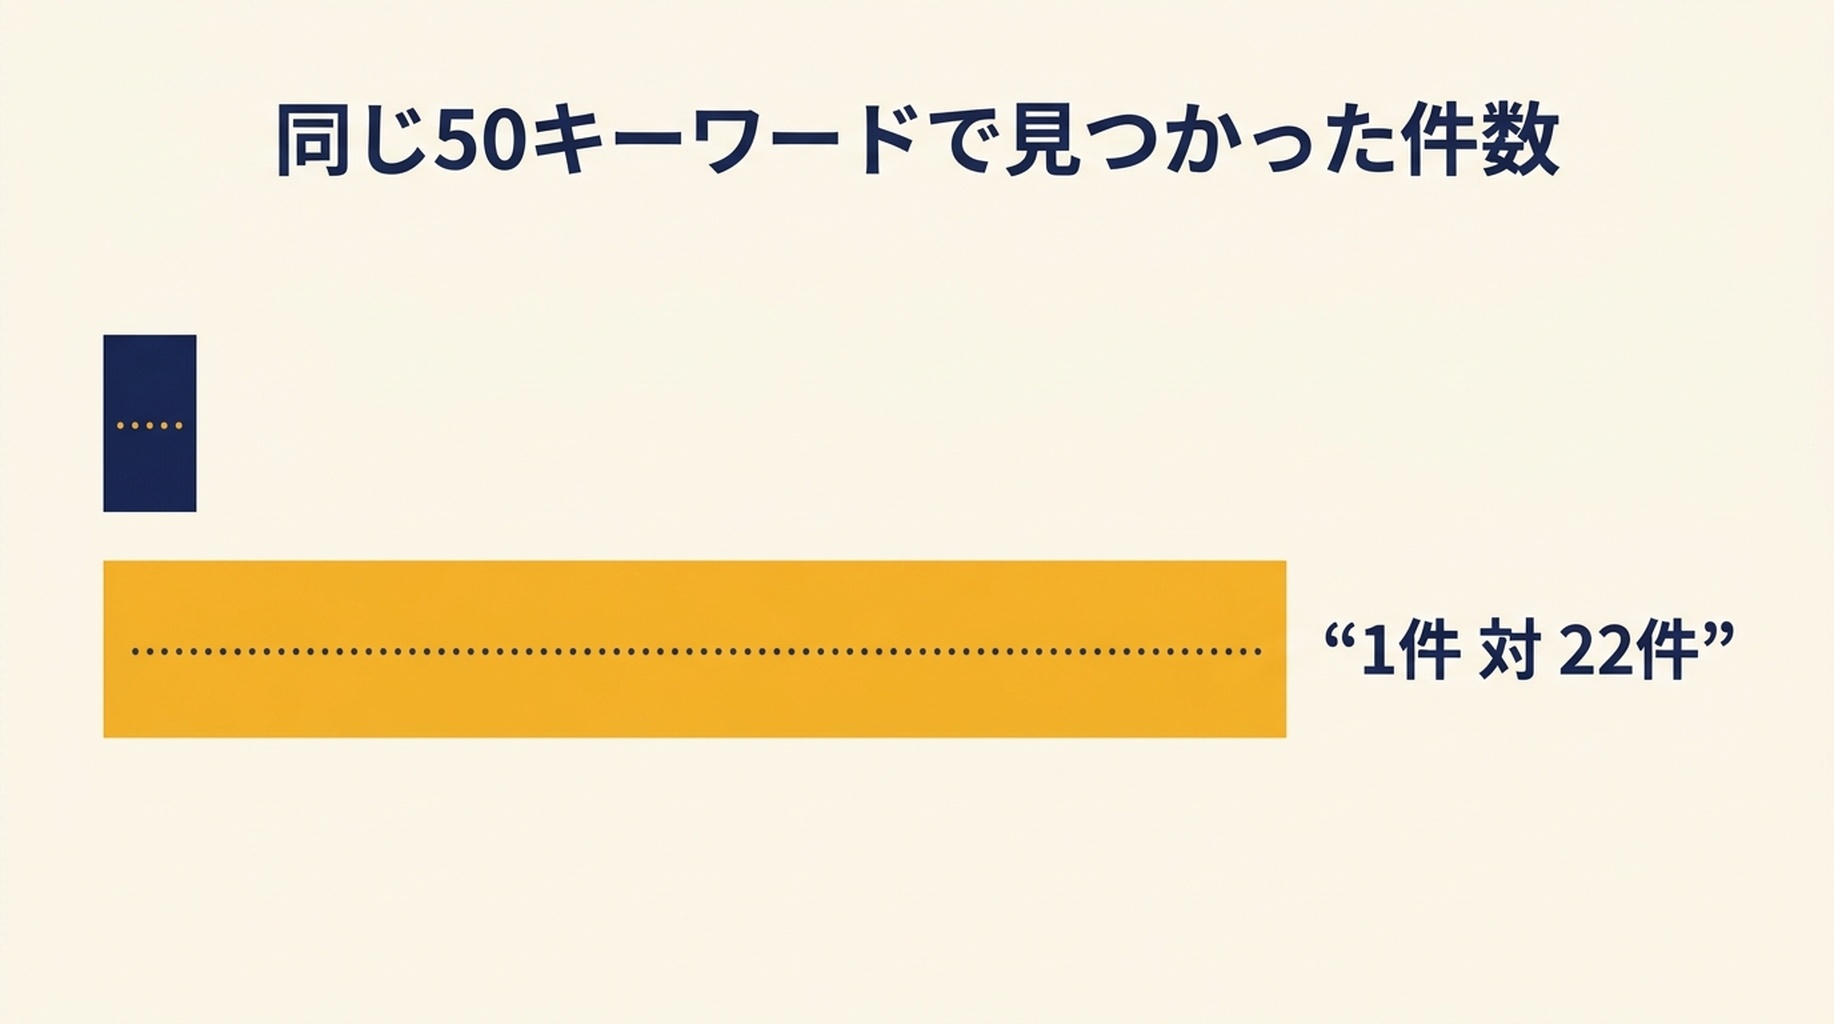
キーワードセットは実行の間で変わっていない。変わったのは深さの設定だけだ。
これは注意して読んでほしい。その形こそが教訓のすべてだからだ。深さ10では、このキーワードセットに対する私たちの可視性は2パーセントに見えた。深さ100では44パーセントに見えた。どちらの数字も間違っておらず、役に立つのは片方だけだ。
ページ上部の状況はほとんど動かなかった。1個のキーワードがどちらの実行でも上位10位以内に入っていた。深いチェックが加えたものはすべて20位から100位の間にあり、それはまさに既定の一括チェッカーが隠してしまう範囲だ。最初のページに設定された順位チェッカーの上に計画を立てているなら、そのベースラインは可視性の測定ではない。最初のページ内での可視性の測定であり、このキーワードセットではその差は21個分ある。
小さな補足をひとつ。深い実行で見つかった22個のうち2個は、絶対順位100位を超えていた。API は要求した深さを少し超えて返すので、「上位100位」のレポートに100位より下の順位が含まれることがある。ラベルが気になるなら除外しよう。
結果2:コストは深さに比例し、おおよそ7対1
指標 | 深さ10 | 深さ100 |
|---|---|---|
課金コスト合計 | $0.1000 | $0.6230 |
キーワードあたりのコスト | $0.0020 | $0.0125 |
キーワードあたりのオーガニック結果件数 | 約12 | 約97 |
深さ100の実行は、同じ50個のキーワードに対して深さ10の6.2倍のコストがかかり、その差が私たちのドメインの現れた21個分を買った。
この比率が、一括チェッカーについて最もよく聞かれる問いへの正直な答えだ。つまり、より多くの結果に金を払う価値があるのか。第1ページより下にランクしているなら価値がある。キーワードが上位10位に収まっているなら、深い実行はまず読まない行を返すだけだ。
中間の設定があり、たいていはそれが正解だ。深さ20は以前の価格でキーワードあたり$0.0035で、深さ10より75パーセント高いが、深さ100に対しては75パーセントの割引になる。20位から50位の帯にいるサイトなら、深さ20が有用な動きのほとんどをわずかなコストで捉える。
課金コストはキーワードあたりの価格が予測するより低くもあった。失敗した7件のリクエストは課金されなかったからだ。これは失敗率が請求書に現れたものであり、まもなくその話になる。
結果3:レポートは AI Overview があったかどうかも隠す
順位だけのレポートが省いてしまうのは深さだけではない。
私たちは両方の実行で、すべてのリクエストの SERP 要素タイプを記録した。深さ10の実行では、50件のクエリのうち48件が AI Overview を返した。深さ100の実行では、成功した43件のうち42件がそうだった。
実行 | AI Overview があったクエリ | チェックしたクエリ |
|---|---|---|
深さ10 | 48 | 50 |
深さ100 | 42 | 43件の成功 |
この数字は、以前のスナップショットを読んだ人には間違って見えるだろう。あれは40件の SEO トピックのクエリのうち4件で AI Overview を見つけていた。どちらも正しく、違いは手法ではなくクエリセットにある。
40件のセットは SEO トピックの一覧だった。順位ツール、監査、アルゴリズム更新、そしてツール名や API 名を含む15件のクエリだ。この50件のセットは私たち自身の Search Console のクエリ一覧から来ており、ロングテールのユーティリティ表現と比較表現が大半を占める。サイトが実際に表示回数を得るクエリは、SEO チームが書き出すクエリとは形が違い、AI Overview の出現はその形に従う。
一括チェックにとっての実務的な論点はもっと狭く、もっと厄介だ。一括順位チェッカーが返すのは順位である。いまや1位の上に座っている要素は返さない。そして私たちが実際に持つクエリセットでは、その要素は96パーセントのクエリに存在していた。
結果4:所要時間はレイテンシを並列数で割ったもの
一括チェックは即座には終わらない。その理由は、あなたが制御できる処理ではなくリクエストのレイテンシにある。
指標 | 深さ10 | 深さ100 |
|---|---|---|
ワーカー8での実時間 | 62.0秒 | 135.9秒 |
最速のリクエスト | 2.6秒 | 8.1秒 |
中央値のリクエスト | 8.3秒 | 19.2秒 |
最遅のリクエスト | 22.0秒 | 40.3秒 |
全リクエスト時間の合計 | 451秒 | 998秒 |
ここから2つのことが出てくる。
レイテンシの中央値は深さとともに2倍以上になり、8.3秒から19.2秒へ増えた。深い検索は組み立てに本当に時間がかかる。だから短いクライアントタイムアウトの一括チェッカーは、浅い実行では失敗せず深い実行で失敗する。
実時間を決めるのは API の速さではなく並列数だ。50個のキーワードを1件ずつ実行すると深さ10のチェックは約7.5分かかり、ワーカー8なら1分で終わる。あなたの一括チェッカーに並列制御がないなら、それは問い合わせる価値のある唯一の設定だ。コスト差なしで経過時間が8倍変わるからである。
結果5:深い実行は14パーセント失敗した
深さ100の50件のリクエストのうち7件が失敗した。深さ10のリクエストは1件も失敗しなかった。
実行 | 失敗 | 失敗率 |
|---|---|---|
深さ10 | 50件中0件 | 0パーセント |
深さ100 | 50件中7件 | 14パーセント |
失敗したリクエストは課金されなかったので、深さ100の実行はキーワードあたりの価格が予測した$0.70よりも安くつき、実効コストはキーワードあたり$0.014ではなく$0.0125になった。
これが、一括チェックのうちレポートがほとんど見せない部分だ。黙って再試行するツールはこれを覆い隠す。そうしないツールはランキングを静かに過少報告する。そして失敗は最も遅いリクエストに集中する。それはあなたが追加料金を払った深い方だ。
エラーメッセージは7件すべてで同じだった。タスクは部分的な結果で完了し、一部のページは数回の再試行の後も取得できず、返されなかったページは課金されなかった、というものだ。これはプロバイダーとして正しい振る舞いであり、一括チェックがクラッシュせずに過少報告する理由でもある。失敗したページは、あなたがランクしていないキーワードではない。それは不明であり、それを空欄セルとして描画するレポートは、不明を静かに否定に変換している。
自分でループを組むなら、失敗を一級の結果として記録し、捨てずに、報告の前に一度再試行しよう。
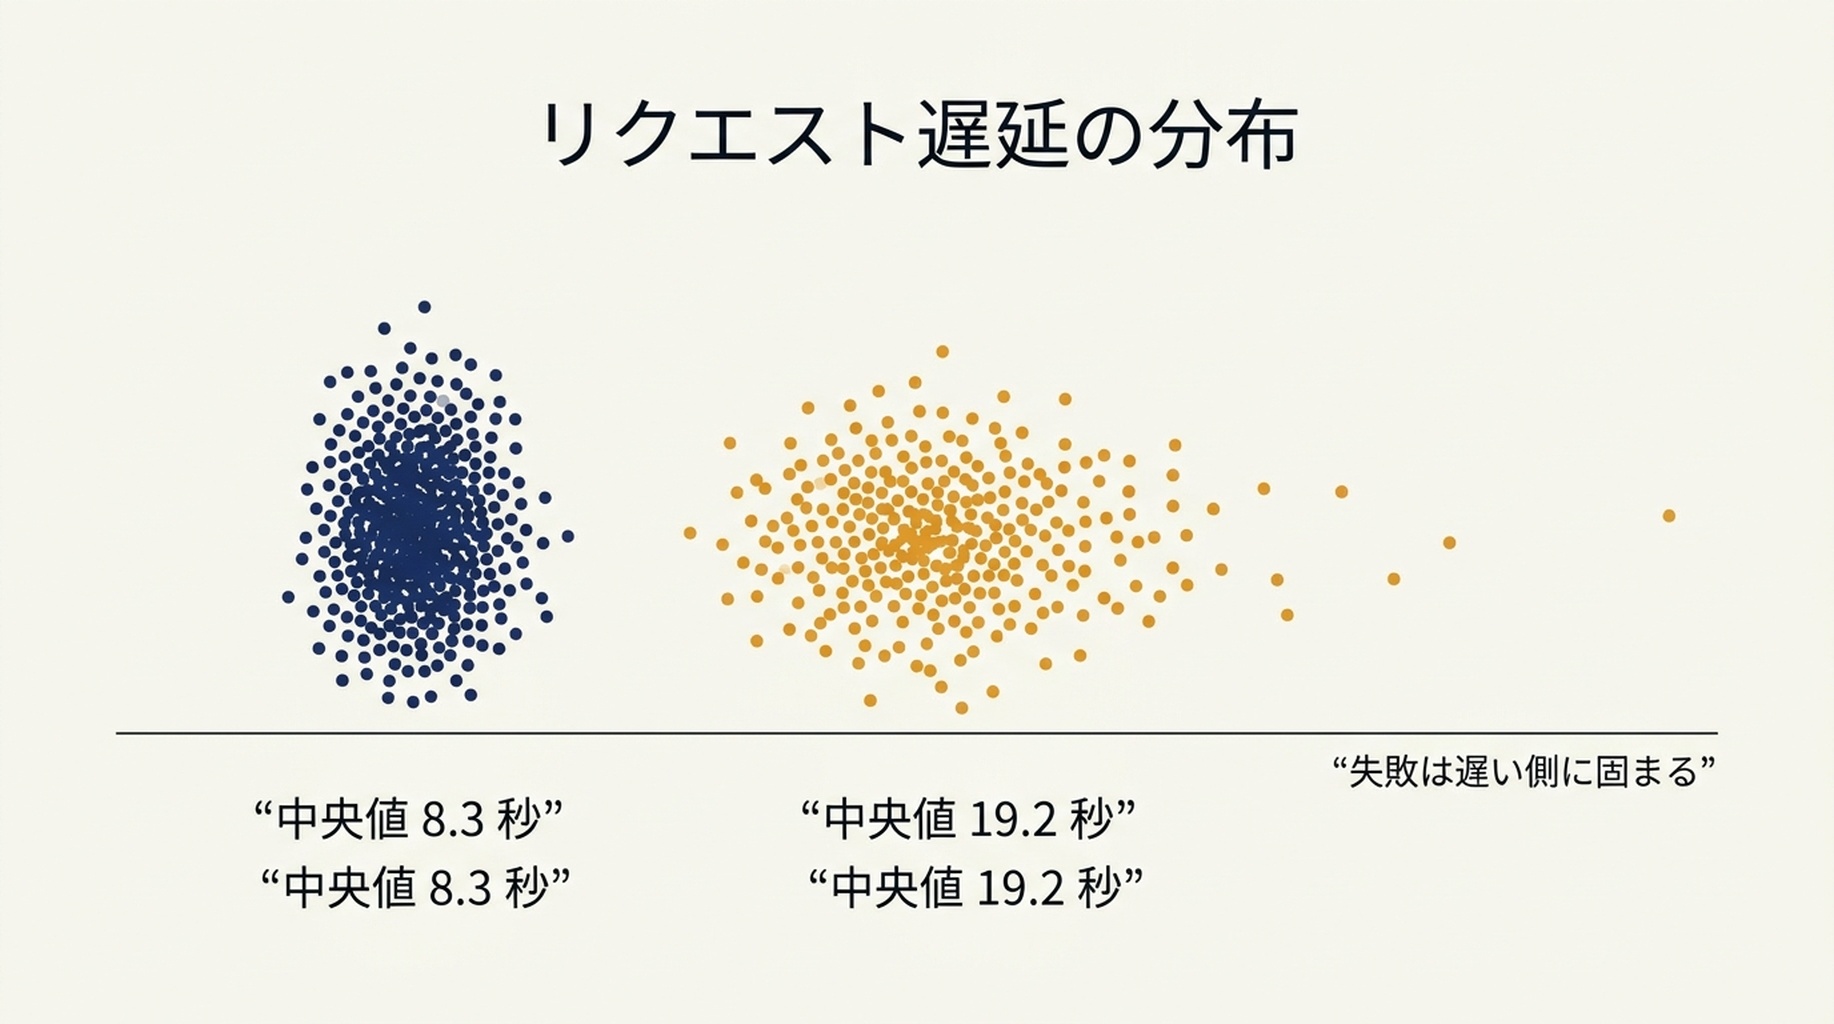
深いリクエストはより時間がかかり、失敗は分布の遅い端に集中する。
ダッシュボードの数字にとってこれが意味すること
同じ50個のキーワードが、2つの擁護できる可視性の数字、2パーセントと44パーセントを生み、それを分けたのは深さの設定だけだった。これは、四半期をかけて説明しようとするほとんどのランキング変動より大きな振れ幅だ。
そこから3つのルールが導かれる。
深さは、ツールの既定値ではなく、あなたがランクしている位置から決める。 まず自分の順位分布を引き出そう。キーワードの大半が20位から60位の間にあるなら、深さ10はほとんど何も報告せず、あなたは持ってもいない可視性の問題を抱えていると結論してしまう。
数字と一緒に深さを報告する。 深さの設定がないランキングレポートは再現できない。地域、言語、デバイスも同じだ。
「見つからない」をエラーではなくデータとして扱う。 50個のキーワードのうち28個は、深さ100でも私たちのドメインの結果を返さなかった。それが正直な答えだ。その行を隠すチェッカーは、あなたのキーワード一覧を最も役に立たない方向に短くしている。
レポートが SERP 機能をそもそも含むかを確認する。 このキーワードセットでは、AI Overview がクエリの96パーセントに存在した。順位だけのエクスポートはそれを示せないし、どんな深さ設定もそれを加えない。
時間をかけて擁護できる数字を目指すなら、深さの問いはレポートの問いの下にある。Google が実際どこまで結果を返すかに関する私たちのメモは上限がどこにあるかを扱い、ファーストパーティとライブの両方のソースを走らせることはそれについて正直であり続けるための構成を扱い、Search Console がライブチェックにできないことを何を教えるかはこの実行が触れなかった半分を扱っている。
限界
2つの限界を述べておく。
1つのプロパティからの50個のキーワードは小さなサンプルであり、2パーセント対44パーセントという分かれ方はキーワードが深い位置にあるサイトに固有のものだ。リストの大半で上位10位に入るプロパティなら、2回の実行にほとんど差は見えず、深さに過剰に払っていることになる。
レイテンシはプロバイダー、地域、その瞬間に依存する。ここでの絶対秒数は移らないが、2つの深さの比率はおおよそ保たれるはずだ。差はネットワークのばらつきではなく実際の作業だからである。
よくある質問
一括順位チェッカーはどの深さを使うべきか? 自分の順位分布から決める。上位10位にランクしているなら深さ10で十分だ。深さ20はキーワードあたり$0.0035で実用的な範囲のほとんどをカバーする。深さ100は$0.014かかり、50位より下を本当に追う場合にのみ価値がある。
50個のキーワードをチェックするのにどれくらいかかるか? 並列ワーカー8なら浅いチェックで約1分、深いチェックで約2.3分だ。直列で実行すると同じチェックに7.5分と16.6分かかるので、並列は経過時間で8倍の価値がある。
なぜ深いチェックの方がよく失敗したのか? 深いリクエストは組み立てに時間がかかり、中央値は浅い実行の8.3秒に対して19.2秒なので、クライアントやプロバイダーのタイムアウトに当たりやすい。失敗は捨てずに記録して再試行しよう。
キーワードが見つからないと言う一括順位チェッカーは正確か? たいていは正確だ。私たちの実行では、50個のうち28個は100位以内に私たちのドメインの結果が本当になかった。欠けた行をデータの問題として扱う前に深さの設定を確認しよう。
多くのキーワードをチェックする方が、深くチェックするより高くつくか? 深さはキーワードあたりの請求を動かすが、キーワードは合計を倍にする。50個から500個へ深さ10で増やすと10倍のコストと10倍の時間がかかり、深さ100はキーワードあたり7倍のコストだ。必要な深さに値段をつけ、それからレビューできるキーワード数を買おう。
Auspia の見解:1ページでも変更する前に、あなたの一括チェッカーの深さ設定を確認しよう。驚くような可視性の数字に対する最も安い説明であり、私たちのテストでは数分違いの2回の実行の間に22倍の差を生んでいた。深さは順位分布から決め、失敗を記録し、設定をレポートに残して、次の四半期の数字が比較可能になるようにしよう。
執筆: Bennett Hayes、Auspia で 400 件以上の実装レビューを担当する応用 GEO アナリスト。実務的な検索実行、測定、そしてレポートを変える細部について書いている。