Um verificador de posições em massa promete uma coisa: muitas palavras-chave, um relatório. E o que o relatório contém é determinado quase inteiramente por uma configuração que quase ninguém muda: até onde a verificação desce.
Rodamos as mesmas 50 palavras-chave duas vezes seguidas, em 12 de setembro de 2026, contra o mesmo mecanismo de busca, a mesma localidade e o mesmo dispositivo. A única diferença era a profundidade.
Na profundidade 10, a verificação encontrou nosso domínio em 1 das 50 palavras-chave. Na profundidade 100, encontrou em 22 delas.
As mesmas palavras-chave. A mesma hora. A mesma API. A diferença não é precisão, porque as duas execuções eram precisas. É campo de visão, e ele muda o número da manchete por um fator de 22.
O que rodamos
Cinquenta palavras-chave tiradas da nossa própria lista de consultas do Search Console, filtradas para consultas em alfabeto latino para que o conjunto de resultados dos Estados Unidos em inglês batesse. As duas execuções usaram requisições orgânicas ao vivo do Google em resolução de desktop, oito trabalhadores simultâneos e um tempo limite de 300 segundos por requisição.
Configuração | Execução A | Execução B |
|---|---|---|
Palavras-chave | 50 | 50 |
Profundidade solicitada | 10 | 100 |
Localidade e idioma | Estados Unidos, inglês | Estados Unidos, inglês |
Dispositivo | Desktop | Desktop |
Simultaneidade | 8 | 8 |
Registramos a latência por requisição, o custo cobrado, a contagem de resultados orgânicos e se o nosso domínio apareceu.
Resultado 1: as mesmas palavras-chave, duas respostas diferentes
Medida | Profundidade 10 | Profundidade 100 |
|---|---|---|
Palavras-chave verificadas | 50 | 50 |
Requisições que devolveram resultado utilizável | 50 | 43 |
Requisições que falharam | 0 | 7 |
Palavras-chave em que nosso domínio apareceu | 1 | 22 |
Dentro do top 3 | 1 | 1 |
Dentro do top 20 | 1 | 1 |
Dentro do top 100 | 1 | 20 |
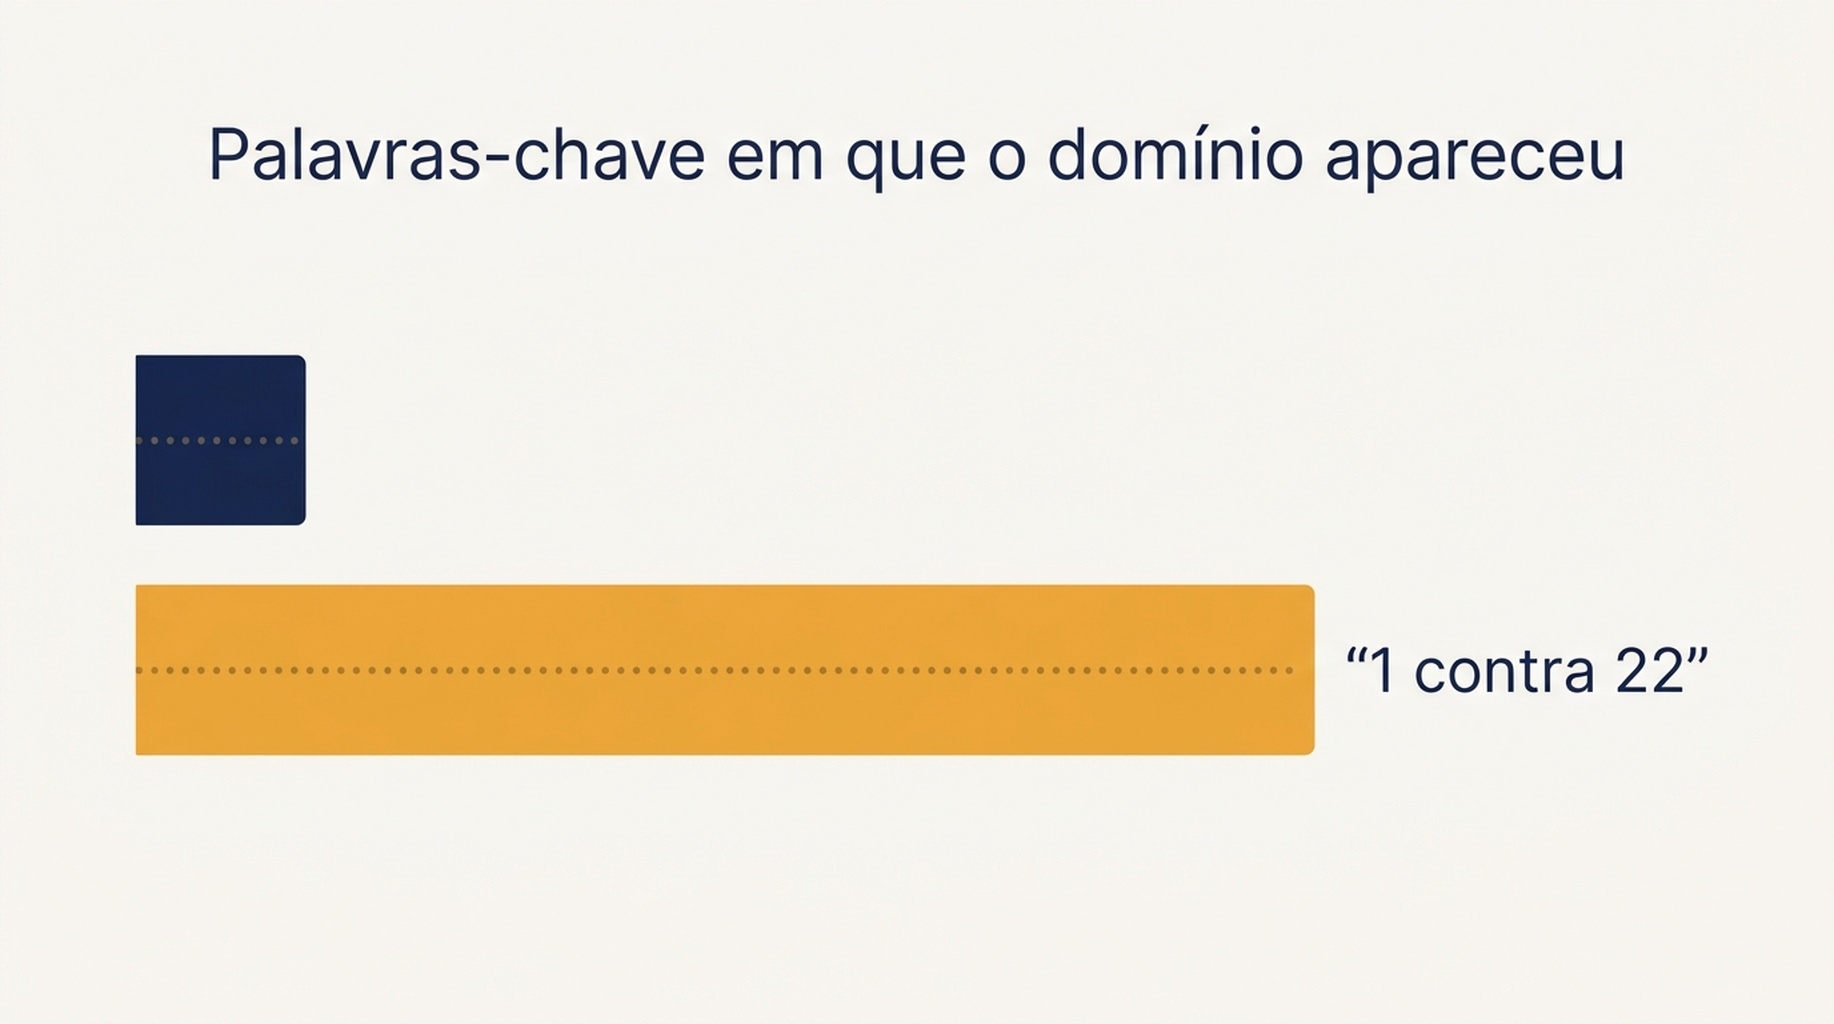
O conjunto de palavras-chave não mudou entre as execuções. A única configuração que mudou foi a profundidade.
Leia isso com atenção, porque o formato disso é a lição inteira. Na profundidade 10, a nossa visibilidade nesse conjunto parecia 2 por cento. Na profundidade 100, parecia 44 por cento. Nenhum dos números está errado, e só um deles é útil.
O quadro do topo da página quase não se moveu. Uma palavra-chave ficou dentro do top 10 nas duas execuções. Tudo o que a verificação mais profunda acrescentou estava entre a posição 20 e a posição 100, que é exatamente a faixa que um verificador em massa com configuração padrão esconde. Se o seu plano está montado sobre um verificador de posições ajustado para a primeira página, sua linha de base não é uma medição da sua visibilidade. É uma medição da sua visibilidade dentro da primeira página, e neste conjunto as duas diferem em 21 palavras-chave.
Um pequeno detalhe extra: duas das 22 palavras-chave encontradas na execução profunda estavam além da posição absoluta 100. A API devolve um pouco além da profundidade solicitada, então um relatório de "top 100" pode conter posições acima de 100. Filtre-as se o rótulo importa para você.
Resultado 2: o custo cresce com a profundidade, cerca de sete para um
Medida | Profundidade 10 | Profundidade 100 |
|---|---|---|
Custo total cobrado | $0,1000 | $0,6230 |
Custo por palavra-chave | $0,0020 | $0,0125 |
Resultados orgânicos devolvidos por palavra-chave | cerca de 12 | cerca de 97 |
A execução na profundidade 100 custou 6,2 vezes a execução na profundidade 10 pelas mesmas 50 palavras-chave, e a diferença comprou as 21 palavras-chave adicionais em que nosso domínio apareceu.
Essa proporção é a resposta honesta à pergunta mais comum sobre verificadores em massa: vale a pena pagar por mais resultados. Vale se você ranqueia abaixo da primeira página. Se as suas palavras-chave ficam no top 10, a execução mais profunda devolve em sua maioria linhas que você nunca vai ler.
Existe uma configuração intermediária, e normalmente é a certa. A profundidade 20 custa $0,0035 por palavra-chave na nossa tabela anterior, o que é 75 por cento mais caro que a profundidade 10 e ainda um desconto de 75 por cento contra a profundidade 100. Para um site na faixa da posição 20 à 50, a profundidade 20 captura a maior parte do movimento útil por uma fração do custo.
O custo cobrado também ficou abaixo do que o preço por palavra-chave previa, porque as sete requisições que falharam não foram cobradas. É a taxa de falha aparecendo na fatura, e já vamos chegar nela.
Resultado 3: o relatório também esconde se havia um AI Overview
Profundidade não é a única coisa que um relatório só de posições deixa de fora.
Registramos os tipos de elemento de SERP em cada requisição nas duas execuções. Na execução de profundidade 10, 48 das 50 consultas devolveram um AI Overview. Na de profundidade 100, 42 das 43 requisições bem-sucedidas devolveram.
Execução | Consultas com AI Overview | Consultas verificadas |
|---|---|---|
Profundidade 10 | 48 | 50 |
Profundidade 100 | 42 | 43 bem-sucedidas |
Esse número vai parecer errado para quem leu o nosso retrato anterior, que encontrou AI Overviews em 4 de 40 consultas sobre SEO. Os dois estão certos, e a diferença está no conjunto de consultas, não no método.
O conjunto de 40 consultas era uma lista sobre SEO: ferramentas de ranqueamento, auditorias, atualizações de algoritmo e 15 consultas citando uma ferramenta ou API. Este conjunto de 50 consultas veio da nossa própria lista do Search Console, dominada por formulações de utilidade e comparação de cauda longa. As consultas pelas quais um site realmente recebe impressões têm um formato diferente das consultas que um time de SEO anota, e a presença de AI Overview segue esse formato.
O ponto prático para a verificação em massa é mais estreito e mais incômodo. Um verificador de posições em massa devolve posições. Ele não devolve o elemento que agora fica acima da posição 1, e no conjunto de consultas que realmente temos esse elemento estava presente em 96 por cento delas.
Resultado 4: o tempo é a latência dividida pela simultaneidade
Uma verificação em massa não é instantânea, e a razão é a latência das requisições, não qualquer processamento que você controle.
Medida | Profundidade 10 | Profundidade 100 |
|---|---|---|
Tempo real com 8 trabalhadores | 62,0 segundos | 135,9 segundos |
Requisição mais rápida | 2,6 segundos | 8,1 segundos |
Requisição mediana | 8,3 segundos | 19,2 segundos |
Requisição mais lenta | 22,0 segundos | 40,3 segundos |
Soma de todos os tempos de requisição | 451 segundos | 998 segundos |
Duas coisas caem disso.
A latência mediana mais que dobrou com a profundidade, de 8,3 para 19,2 segundos. Uma busca mais profunda realmente demora mais para ser montada, e é por isso que um verificador em massa com tempo limite curto de cliente falha nas execuções profundas e não nas rasas.
O tempo real é definido pela simultaneidade, não pela velocidade da API. Rode as 50 palavras-chave uma por vez e a verificação de profundidade 10 leva cerca de 7,5 minutos; com oito trabalhadores leva um minuto. Se o seu verificador em massa não tem controle de simultaneidade, essa é a única configuração que vale a pena perguntar, porque vale um fator de oito no tempo decorrido sem nenhuma diferença de custo.
Resultado 5: a execução mais profunda falhou em 14 por cento das vezes
Sete das 50 requisições de profundidade 100 falharam. Nenhuma das requisições de profundidade 10 falhou.
Execução | Falhas | Taxa de falha |
|---|---|---|
Profundidade 10 | 0 de 50 | 0 por cento |
Profundidade 100 | 7 de 50 | 14 por cento |
Como as requisições que falharam não foram cobradas, a execução de profundidade 100 também custou menos que os $0,70 que o preço por palavra-chave previa, e é por isso que o custo efetivo por palavra-chave ficou em $0,0125 e não $0,014.
Essa é a parte da verificação em massa que os relatórios raramente mostram. Uma ferramenta que tenta de novo em silêncio vai encobrir isso. Uma ferramenta que não faz isso vai subnotificar suas posições discretamente, e as falhas se concentram nas requisições mais lentas, que são as profundas pelas quais você pagou a mais.
A mensagem de erro era idêntica nas sete: a tarefa foi concluída com resultados parciais, algumas páginas não puderam ser recuperadas após várias tentativas e as páginas que não foram devolvidas não foram cobradas. Esse é o comportamento correto de um provedor, e é também por isso que uma verificação em massa subnotifica em vez de travar. Uma página que falhou não é uma palavra-chave em que você não ranqueia. É um desconhecido, e um relatório que a desenha como célula vazia converteu discretamente um desconhecido em uma negativa.
Se você monta o seu próprio laço, registre as falhas como desfecho de primeira classe em vez de descartá-las, e tente as falhas mais uma vez antes de reportar.
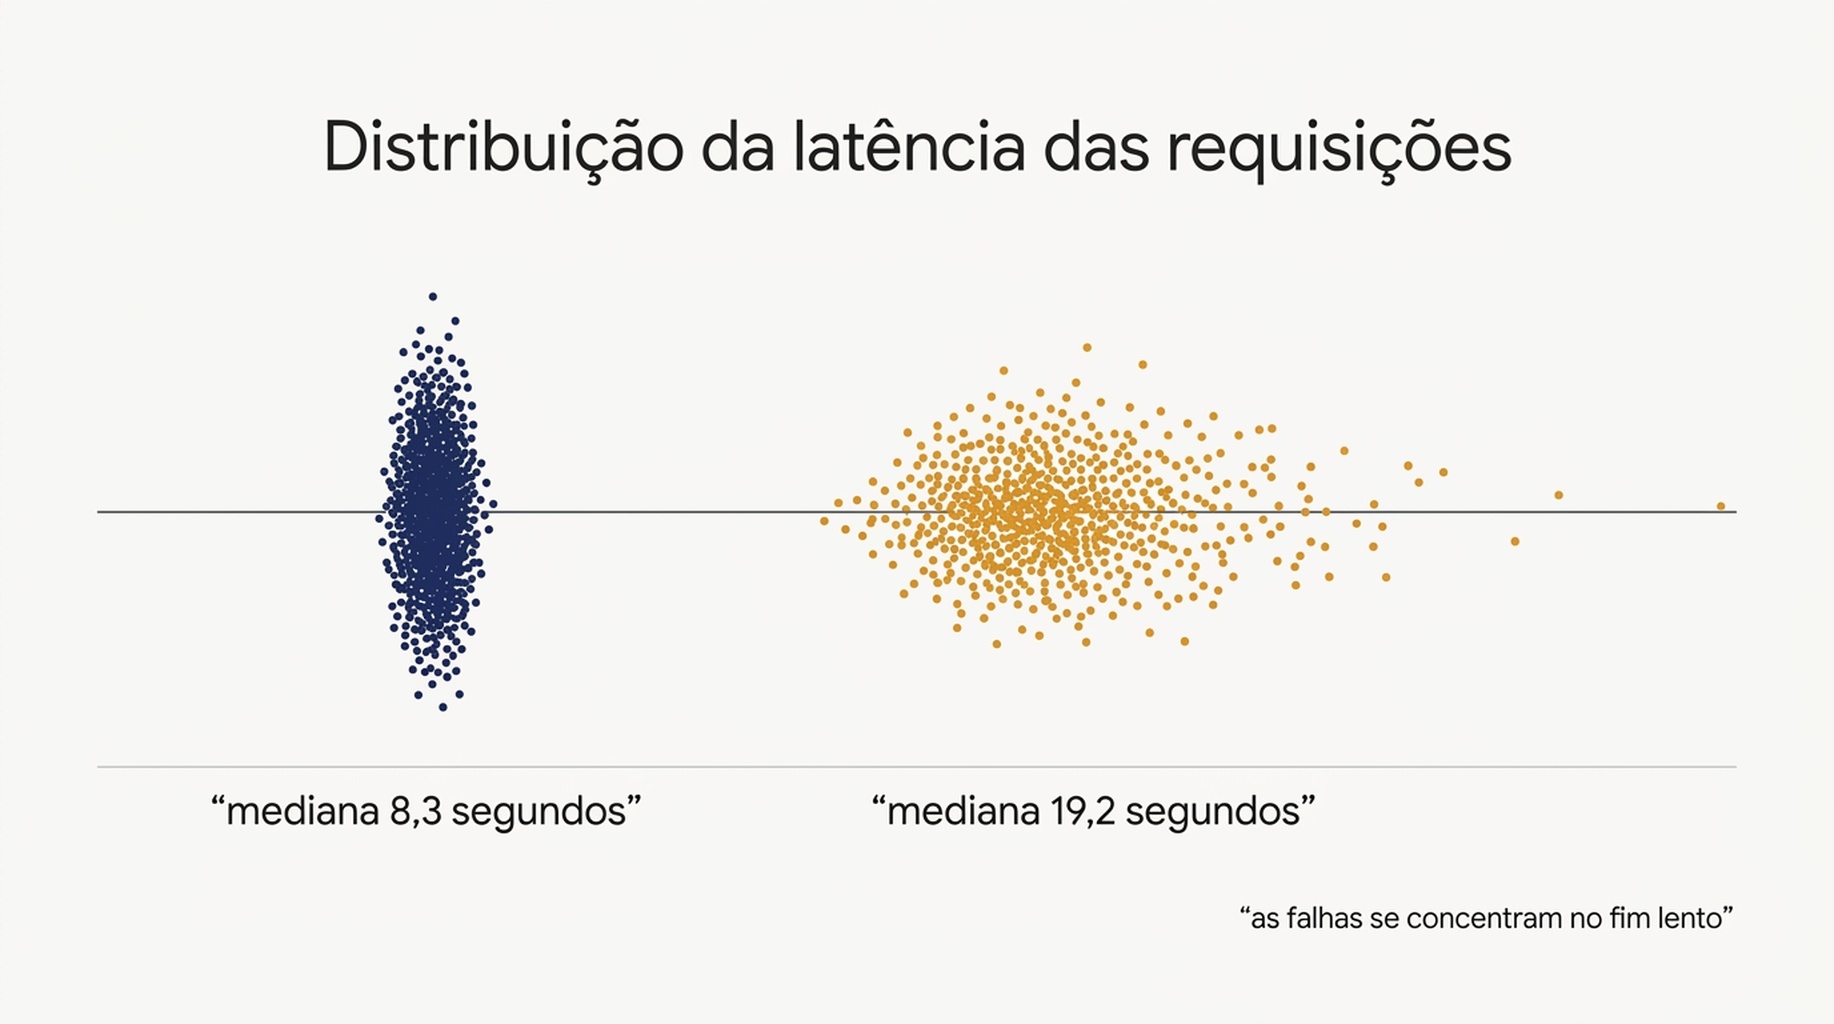
Requisições mais profundas demoram mais, e as falhas se concentram na ponta lenta da distribuição.
O que isso significa para o número no seu painel
As mesmas 50 palavras-chave produziram dois números de visibilidade defensáveis, 2 por cento e 44 por cento, separados apenas por uma configuração de profundidade. Essa oscilação é maior que a maioria das mudanças de ranqueamento que você vai passar um trimestre tentando explicar.
Seguem três regras.
Defina a profundidade a partir de onde você ranqueia, não a partir do padrão da ferramenta. Puxe primeiro a sua própria distribuição de posições. Se a maioria das suas palavras-chave está entre 20 e 60, a profundidade 10 não vai reportar quase nada e você vai concluir que tem um problema de visibilidade que não tem.
Reporte a profundidade junto com o número. Um relatório de ranqueamento sem configuração de profundidade não é reproduzível. O mesmo vale para localidade, idioma e dispositivo.
Trate "não encontrado" como dado, não como erro. Vinte e oito das 50 palavras-chave não devolveram resultado para o nosso domínio na profundidade 100, e essa é a resposta honesta. Um verificador que esconde essas linhas está encurtando a sua lista de palavras-chave na direção menos útil.
Confira se o relatório inclui recursos de SERP. Neste conjunto, um AI Overview estava presente em 96 por cento das consultas. Uma exportação só de posições não consegue mostrar isso, e nenhuma configuração de profundidade vai acrescentar.
Se o objetivo é um número que você consiga defender ao longo do tempo, a questão da profundidade fica por baixo da questão do relatório. As nossas notas sobre até onde o Google realmente entrega resultados cobrem onde fica o teto, rodar uma fonte própria e uma fonte ao vivo juntas cobre a configuração que mantém você honesto quanto a isso, e o que o Search Console pode dizer que uma verificação ao vivo não pode cobre a metade que esta execução não tocou.
Limites
Dois limites que vale declarar.
Cinquenta palavras-chave de uma única propriedade são uma amostra pequena, e a divisão de 2 por cento contra 44 por cento é específica de um site cujas palavras-chave ficam fundo. Uma propriedade ranqueando no top 10 na maior parte da sua lista veria quase nenhuma diferença entre as execuções e estaria pagando a mais pela profundidade.
A latência depende do provedor, da localidade e do momento. Os segundos absolutos daqui não vão se transferir, mas a proporção entre as duas profundidades deve se manter aproximadamente, porque a diferença é trabalho real e não variação de rede.
Perguntas frequentes
Que profundidade um verificador de posições em massa deve usar? Defina a partir da sua própria distribuição de posições. A profundidade 10 basta se você ranqueia no top 10. A profundidade 20 cobre a maior parte da faixa prática a $0,0035 por palavra-chave. A profundidade 100 custa $0,014 e só vale quando você acompanha de verdade posições abaixo de 50.
Quanto tempo leva para verificar 50 palavras-chave? Cerca de um minuto com oito trabalhadores simultâneos para uma verificação rasa, e cerca de 2,3 minutos para uma profunda. Rodando em série, as mesmas verificações levam 7,5 e 16,6 minutos, então a simultaneidade vale um fator de oito no tempo decorrido.
Por que a verificação mais profunda falhou mais vezes? Requisições mais profundas demoram mais para ser montadas, com mediana de 19,2 segundos contra 8,3 da execução rasa, então têm mais chance de bater em um tempo limite de cliente ou de provedor. Registre e tente de novo as falhas em vez de descartá-las.
Um verificador de posições em massa é preciso quando diz que a minha palavra-chave não foi encontrada? Normalmente sim. Na nossa execução, 28 das 50 palavras-chave realmente não tinham resultado para o nosso domínio dentro de 100 posições. Confira a configuração de profundidade antes de tratar uma linha ausente como problema de dados.
Verificar mais palavras-chave custa mais do que verificar mais fundo? A profundidade move a fatura por palavra-chave, mas as palavras-chave multiplicam o total. Ir de 50 para 500 palavras-chave na profundidade 10 custa dez vezes mais e leva dez vezes mais tempo, enquanto a profundidade 100 custa 7 vezes mais por palavra-chave. Precifique a profundidade que você precisa e depois compre a quantidade de palavras-chave que você consegue revisar.
Visão da Auspia: antes de mudar uma única página, confira a configuração de profundidade do seu verificador em massa. É a explicação mais barata para um número de visibilidade surpreendente, e no nosso teste ela respondeu por um fator de 22 entre duas execuções feitas com minutos de diferença. Defina a profundidade a partir da distribuição de posições, registre as falhas e mantenha a configuração no relatório para que o número do próximo trimestre seja comparável.
Autor: Bennett Hayes, analista de GEO aplicado com mais de 400 revisões de implementação na Auspia. Escreve sobre execução prática de busca, medição e os detalhes que mudam um relatório.